Manfaat Mengumpulkan Data dari Walmart
Sebagai salah satu ritel terbesar, Walmart mengoperasikan jaringan hipermarket, department store diskon, dan toko bahan makanan. Perusahaan ini memiliki kehadiran daring yang sangat luas dengan jutaan produk, mulai dari bahan makanan, pakaian, perlengkapan rumah tangga, elektronik, dan banyak lagi — menjadikan Walmart sebagai sumber data yang sangat berharga untuk pengumpulan data web.
Pengumpulan data dari Walmart dapat digunakan untuk berbagai tujuan, terutama bagi bisnis dan peneliti. Berikut adalah beberapa aplikasi praktis dari pengumpulan data dari Walmart:
• Riset Pasar. Penawaran produk Walmart yang sangat luas memberikan gambaran komprehensif tentang pasar di berbagai kategori. Dengan melakukan penggalian data ini, Anda dapat memperoleh wawasan mengenai tren produk, preferensi konsumen, dan strategi penetapan harga.
• Analisis Persaingan. Data yang digali dari Walmart dapat digunakan untuk memahami produk apa saja yang dijual, dengan harga berapa, dan bagaimana produk tersebut dipasarkan. Informasi ini dapat membantu Anda memposisikan produk Anda sendiri secara kompetitif.
• Pemantauan Harga. Anda dapat menggunakan data yang dikumpulkan untuk memantau harga produk Walmart secara real-time, sehingga Anda dapat menyesuaikan harga produk Anda sendiri dan tetap kompetitif.
• Optimasi Ragam Produk. Dengan menganalisis ragam produk yang ditawarkan Walmart, Anda dapat mengoptimalkan ragam produk Anda sendiri untuk lebih memenuhi permintaan konsumen.
• Analisis Sentimen. Ulasan dan penilaian di situs web Walmart memberikan banyak informasi mengenai sentimen konsumen terhadap produk. Data ini dapat digunakan untuk meningkatkan kualitas produk dan layanan pelanggan
Pengambilan Data Walmart yang Mudah dengan Geonode
API Pengambilan Data
Geonode
adalah alat yang canggih dan ramah pengguna yang dirancang untuk menyederhanakan tugas pengambilan data web. Dengan berbagai fitur utama, alat ini memungkinkan pengguna untuk secara efisien mengekstrak sejumlah besar data dari situs web seperti Walmart tanpa perlu menulis baris kode yang rumit.
Beberapa fitur unggulannya meliputi:
• Mode Debug. Menyediakan informasi terperinci dalam format respons JSON, membantu pengguna memahami cara situs web menangani permintaan pengambilan data serta menghemat waktu dan sumber daya.
• Rendering JavaScript. Memfasilitasi pengikisan Aplikasi Halaman Tunggal (SPA) dengan penangkapan elemen dinamis, memastikan ekstraksi data yang komprehensif.
• Eksekusi Potongan Kode JS Kustom. Memungkinkan pengembang berinteraksi dengan formulir, tombol, dan elemen lain yang dihasilkan JavaScript untuk kontrol yang lebih besar atas proses pengikisan.
• Proksi Berputar. Menggunakan kumpulan proxy yang besar untuk menghindari pemblokiran IP dan melewati pembatasan geografis, sehingga meningkatkan keandalan pengambilan data.
• Penargetan Geografis. Memastikan akses ke lebih banyak situs web tanpa terdeteksi sebagai scraper.
• API Tangkapan Layar. Memungkinkan pengambilan tangkapan layar halaman web dengan mudah untuk keperluan pengujian, pemecahan masalah, dan dokumentasi.
• Harga per GB. Menawarkan harga yang hemat biaya dan kontrol atas pengeluaran pengikis data.
• Format Respons. Menawarkan fleksibilitas dalam memilih antara format HTML atau JSON untuk penggunaan aplikasi terintegrasi.
• Pengumpulan Data dari Respons HTTP. Dengan mudah mengumpulkan data tertentu, seperti respons JSON, untuk mengekstrak informasi yang diperlukan.
• Mode Scraping. Menyediakan berbagai mode scraping untuk kinerja dan efisiensi optimal yang disesuaikan dengan kebutuhan scraping yang berbeda-beda.
Cara Mengambil Data Walmart MenggunakGeonode
Memahami Struktur Situs Web Walmart
Walmart adalah salah satu pengecer terbesar di dunia; situs webnya merupakan platform e-commerce yang luas dengan tata letak yang terstruktur dan terorganisir dengan baik, menampilkan miliaran halaman produk. Memahami strukturnya sangat penting untuk pengambilan data web yang efisien dan efektif. Berikut adalah gambaran umum tentang bagaimana data diorganisir di situs web Walmart:
• Halaman Beranda. Halaman beranda memberikan gambaran umum tentang apa yang ditawarkan Walmart. Halaman ini berisi berbagai kategori produk, penawaran promosi, dan lainnya.
• Halaman Kategori. Saat Anda mengklik suatu kategori dari halaman beranda atau menu navigasi, Anda akan diarahkan ke halaman kategori. Halaman-halaman ini mencantumkan produk-produk di bawah kategori tertentu, seperti Elektronik, Pakaian, atau Perlengkapan Rumah Tangga. Setiap halaman kategori memiliki beberapa subkategori untuk jenis produk yang lebih spesifik.
• Daftar Produk. Setiap halaman kategori atau subkategori berisi daftar produk. Setiap daftar produk mencakup informasi dasar seperti nama produk, harga, gambar, dan penilaian pelanggan.
• Halaman Produk. Mengklik suatu produk dari daftar tersebut akan membawa Anda ke halaman produk individual. Halaman-halaman ini berisi informasi terperinci tentang produk, termasuk deskripsi yang lebih rinci, atribut produk, gambar tambahan, ulasan pelanggan, dan sering kali daftar produk terkait.
• Fitur Pencarian. Situs web ini juga memiliki bilah pencarian yang memungkinkan pengguna mencari produk tertentu. Hasil pencarian ditampilkan dalam format yang mirip dengan daftar produk di halaman kategori.
Saat melakukan scraping pada situs web Walmart, penting untuk diperhatikan bahwa data terutama terdapat di area-area ini. Halaman produk, khususnya, kemungkinan besar merupakan yang paling berharga, karena berisi informasi paling terperinci.
Namun, situs web Walmart bersifat dinamis; beberapa konten dimuat menggunakan JavaScript setelah halaman HTML awal dimuat, yang dapat membuat proses pengikisan data menjadi lebih menantang. Untungnya, API Pengikisan Data dari Geonode dapat menangani rendering JavaScript dan menghindari masalah ini.
Mengidentifikasi Poin Data Utama yang Akan Di-scrape
Saat melakukan scraping pada situs web e-commerce seperti Walmart, poin data utama yang mungkin ingin Anda ekstrak akan bergantung pada persyaratan spesifik proyek Anda. Berikut adalah beberapa poin data umum yang sering kali berharga:
• Nama Produk. Judul produk adalah salah satu informasi paling dasar namun sangat penting. Informasi ini membantu mengidentifikasi beragam produk yang ditampilkan situs web.
• Harga. Harga produk merupakan titik data penting lainnya. Harga pesaing dapat digunakan untuk perbandingan harga, melacak perubahan harga dari waktu ke waktu, atau mengidentifikasi tren harga.
• Gambar. Gambar memberikan representasi visual dari produk. Gambar dapat berguna untuk berbagai tujuan, seperti tugas pengenalan gambar atau menyediakan visual dalam katalog produk.
• Deskripsi. Deskripsi produk memberikan informasi terperinci tentang produk, termasuk fitur, spesifikasi, dan detail relevan lainnya.
• Ulasan dan Peringkat Produk. Ulasan dan peringkat memberikan wawasan mengenai kepuasan pelanggan dan kualitas produk. Keduanya dapat digunakan untuk analisis sentimen atau untuk mengukur opini publik tentang suatu produk.
• Kategori Produk. Kategori atau subkategori produk dapat memberikan konteks mengenai jenis produk tersebut dan posisinya dalam jajaran produk yang lebih luas.
• SKU atau ID Produk. SKU atau ID merupakan pengenal unik untuk setiap produk. Hal ini dapat berguna untuk melacak produk tertentu.
• Status Ketersediaan. Informasi mengenai apakah produk tersedia, habis, atau dapat dipesan terlebih dahulu dapat menjadi data berharga untuk analisis rantai pasokan atau riset pasar.
• Informasi Pengiriman. Rincian mengenai opsi dan biaya pengiriman dapat menjadi faktor penting untuk memahami total biaya suatu produk.
• Informasi Penjual. Jika produk dijual oleh penjual pihak ketiga, informasi mengenai penjual tersebut mungkin relevan.
Menyiapkan Lingkungan
Berikut adalah panduan langkah demi langkah dalam menyiapkan lingkungan untuk API Scraping Geonode:
1. Buat Akun di Geonode. Langkah pertama adalah membuat akun di situs web Geonode. Ini akan memberi Anda akses ke API dan layanan lainnya.
2. Dapatkan Kunci API Anda. Setelah membuat akun dan masuk, Anda dapat menemukan kunci API Anda di pengaturan akun atau dasbor. Kunci ini digunakan untuk mengautentikasi permintaan Anda ke API.
3. Instal Pustaka yang Diperlukan. Tergantung pada bahasa pemrograman yang Anda gunakan, Anda mungkin perlu menginstal pustaka tertentu untuk mengirim permintaan HTTP dan menangani responsnya.
• Pustaka Klien HTTP: Untuk mengirim permintaan ke API Geonode dan menerima respons, Anda memerlukan pustaka klien HTTP. Pustaka spesifik yang akan Anda gunakan dapat bergantung pada bahasa pemrograman Anda. Misalnya, jika Anda menggunakan Python, Anda mungkin menggunakan pustaka Requests. Jika Anda menggunakan JavaScript, Anda mungkin menggunakan Axios atau Fetch.
• Pustaka Parsing JSON: API Geonode biasanya mengembalikan data dalam format JSON, sehingga Anda memerlukan pustaka untuk mem-parsing data ini. Sebagian besar bahasa pemrograman modern sudah memiliki dukungan bawaan untuk parsing JSON. Misalnya, di Python, Anda dapat menggunakan modul json, dan di JavaScript, Anda dapat menggunakan JSON.parse().
• Lingkungan Pengembangan: Anda memerlukan lingkungan pengembangan untuk menulis dan menjalankan kode Anda. Ini bisa berupa editor teks seperti Sublime Text atau Atom, atau lingkungan pengembangan terintegrasi (IDE) seperti PyCharm atau Visual Studio Code.
4. Siapkan Lingkungan Pengembangan Anda. Pastikan lingkungan pengembangan Anda sudah disiapkan untuk mengirim permintaan ke API dan menangani responsnya. Hal ini mungkin melibatkan pembuatan proyek baru di lingkungan pengembangan terintegrasi (IDE) atau editor teks pilihan Anda.
5. Uji API. Sebelum mulai membangun web scraper Anda, sebaiknya uji API terlebih dahulu untuk memastikan semuanya berfungsi dengan benar. Anda dapat melakukannya dengan mengirimkan permintaan GET sederhana ke API dan memeriksa responsnya.
6. Baca Dokumentasi API: Dokumentasi API Geonode akan memberikan informasi terperinci tentang cara menggunakan API, termasuk titik akhir (endpoint) yang tersedia, parameter permintaan, format respons, dan lainnya. Membaca dokumentasi ini akan membantu Anda memahami cara menggunakan API secara efektif.
Mengambil Halaman Produk Walmart
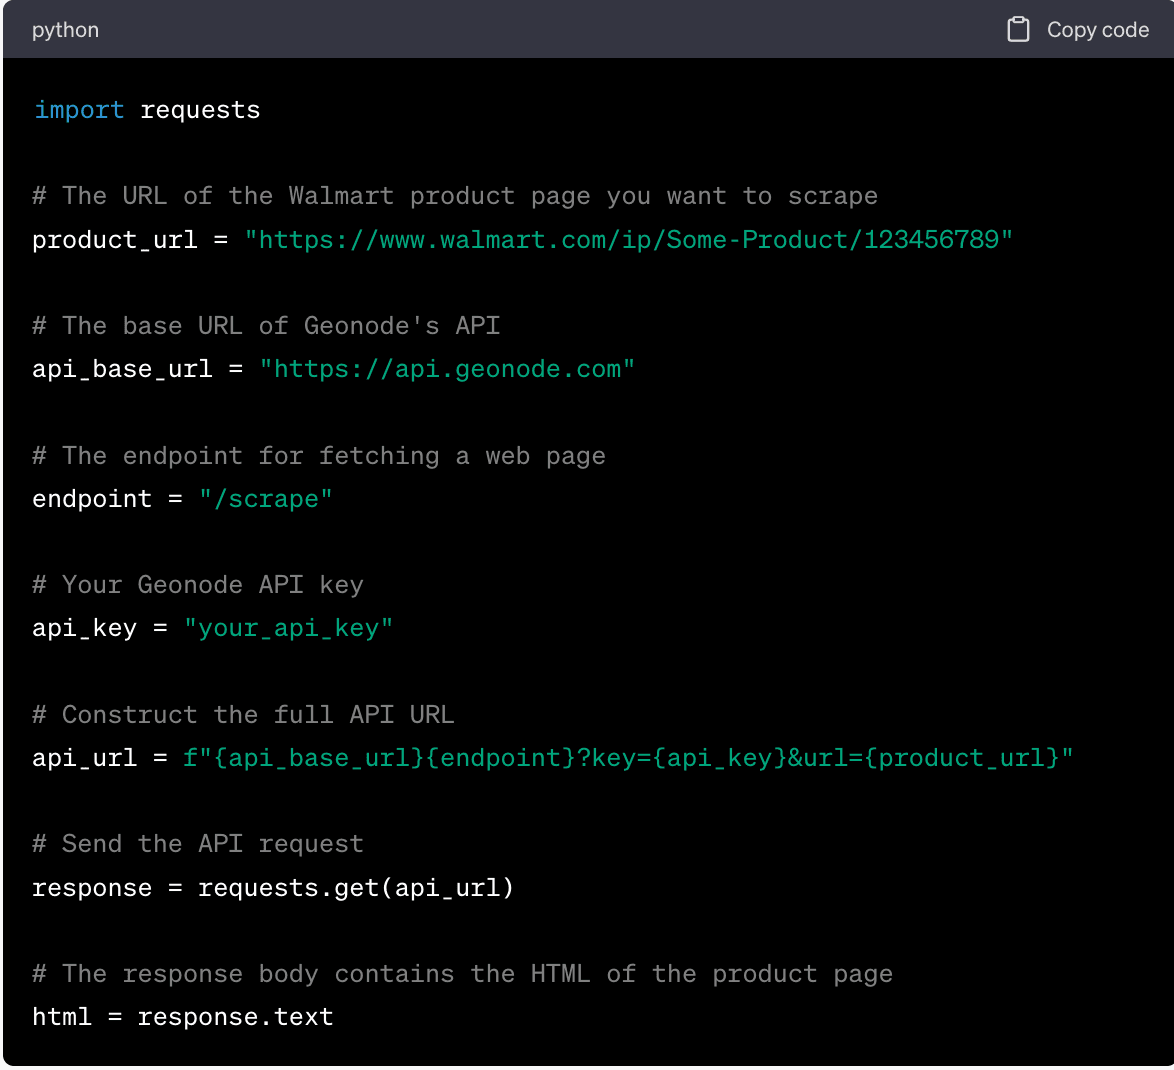
Mengambil halaman produk Walmart menggunakan API Scraping Geonode melibatkan pengiriman permintaan HTTP GET ke API dengan URL halaman produk yang ingin Anda ambil datanya. Berikut adalah garis besar umumnya:
1. Identifikasi URL Halaman Produk. Identifikasi URL halaman produk Walmart yang ingin Anda ambil datanya. Anda dapat melakukannya dengan membuka halaman produk tersebut di peramban web Anda dan menyalin URL dari bilah alamat.
2. Siapkan Permintaan API. Buat URL titik akhir API, yang mencakup URL dasar API Geonode, titik akhir untuk mengambil halaman web, dan parameter apa pun yang diperlukan. Salah satu parameternya adalah URL halaman produk Walmart yang ingin Anda ambil datanya.
3. Kirim Permintaan API. Kirim permintaan API menggunakan pustaka klien HTTP Anda. Hal ini melibatkan pemanggilan fungsi atau metode yang disediakan oleh pustaka tersebut, memasukkan URL titik akhir API, dan mengatur metodenya ke GET.
4. Tangani Respons API. Setelah Anda mengirimkan permintaan API, API akan mengembalikan respons. Respons ini akan berisi data dari halaman produk Walmart, biasanya dalam format HTML. Anda perlu menangani respons ini dalam kode Anda, yang mungkin melibatkan penguraian HTML dan pengambilan data yang Anda minati.
Berikut adalah contoh cara melakukannya di Python menggunakan pustaka Requests:
Mengekstrak Data dari Halaman Produk
Setelah Anda mengambil halaman produk Walmart menggunakan API Scraping Geonode, langkah selanjutnya adalah mengekstrak poin-poin data utama dari halaman tersebut. Hal ini biasanya melibatkan penguraian (parsing) HTML halaman dan memilih elemen-elemen yang berisi data yang Anda minati.
Berikut adalah gambaran umum tentang cara melakukannya:
1. Memparsing HTML. Langkah pertama adalah memparsing kode HTML halaman tersebut. Hal ini melibatkan konversi string HTML menjadi struktur yang dapat Anda jelajahi dan telusuri. Metode spesifik untuk melakukannya dapat bergantung pada bahasa pemrograman dan pustaka yang Anda gunakan. Misalnya, di Python, Anda dapat menggunakan pustaka BeautifulSoup untuk mengurai HTML.
2. Identifikasi Titik Data. Selanjutnya, Anda perlu mengidentifikasi elemen HTML yang berisi titik data yang Anda minati. Hal ini biasanya melibatkan pemeriksaan kode HTML halaman dan pencarian tag, kelas, atau ID dari elemen-elemen tersebut. Anda dapat melakukannya menggunakan alat pengembang (developer tools) di peramban web Anda.
3. Pilih Elemen-Elemen. Setelah mengidentifikasi elemen-elemen tersebut, Anda dapat memilihnya dari kode HTML yang telah diparsing. Hal ini biasanya melibatkan pemanggilan fungsi atau metode yang disediakan oleh pustaka pengurai HTML Anda, dengan memasukkan tag, kelas, atau ID elemen tersebut. Ini akan mengembalikan elemen beserta isinya.
4. Ekstrak Data. Setelah Anda memilih elemen-elemen tersebut, Anda dapat mengekstrak data darinya. Hal ini biasanya melibatkan pemanggilan fungsi atau metode yang disediakan oleh pustaka pengurai HTML Anda, dengan memasukkan elemen tersebut sebagai argumen. Hal ini akan mengembalikan data yang terdapat di dalam elemen tersebut.
Berikut adalah contoh cara mengurai HTML di Python menggunakan pustaka BeautifulSoup:
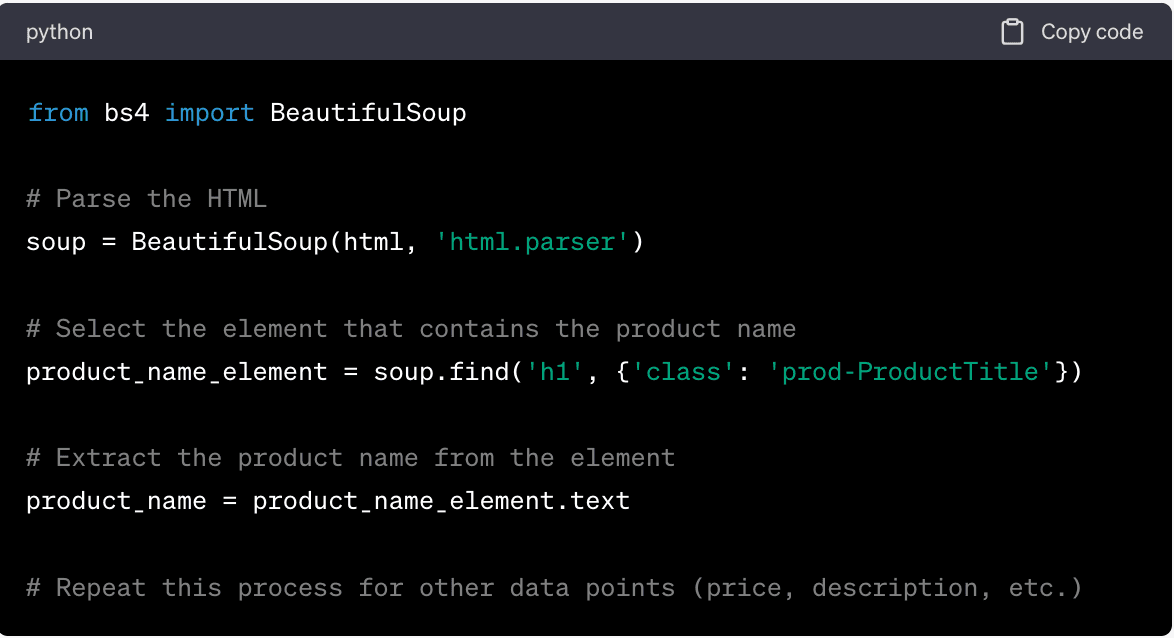
(Ini adalah contoh dasar dan implementasi sebenarnya dapat bervariasi tergantung pada struktur spesifik halaman produk Walmart serta fitur dan kemampuan pustaka pengurai HTML Anda. Selalu rujuk ke dokumentasi resmi pustaka Anda untuk informasi yang paling akurat dan terkini.)
Memparsing Data HTML dan JSON
Memparsing data HTML dan JSON merupakan tugas umum dalam web scraping. Memparsing adalah proses mengambil data mentah (dalam hal ini, teks HTML atau JSON) dan mengubahnya menjadi format yang lebih mudah diolah dalam bahasa pemrograman Anda.
Memparsing HTML
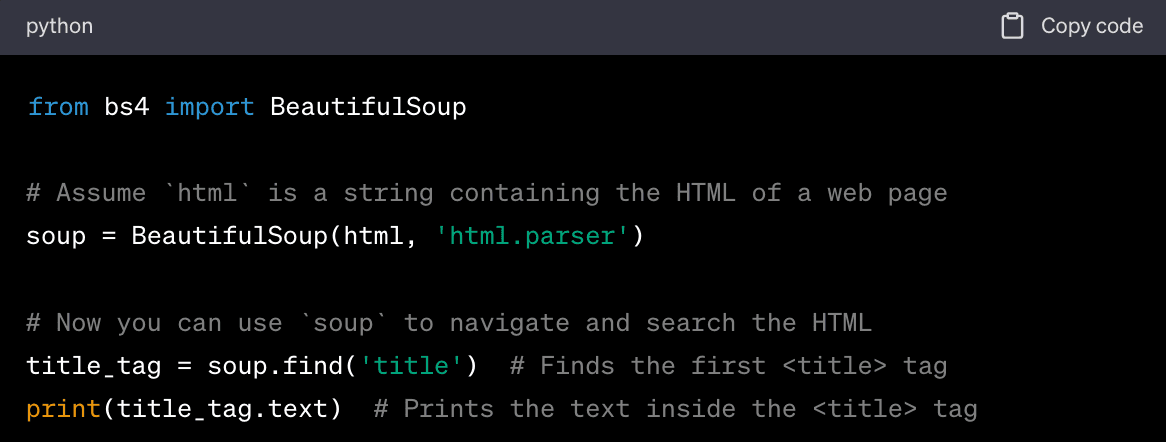
HTML adalah bahasa markup standar untuk membuat halaman web. HTML menggunakan tag untuk menandai berbagai jenis konten, sehingga relatif mudah untuk menavigasi dan mengekstrak data tertentu.
Berikut adalah contoh cara mem-parsing HTML di Python menggunakan pustaka BeautifulSoup:
Mem-parsing JSON
JSON (JavaScript Object Notation) adalah format pertukaran data yang ringan, mudah dibaca dan ditulis oleh manusia, serta mudah diparsing dan dihasilkan oleh mesin. Format ini sering digunakan oleh API untuk mengirim data.
Berikut adalah contoh cara mem-parsing JSON di Python:
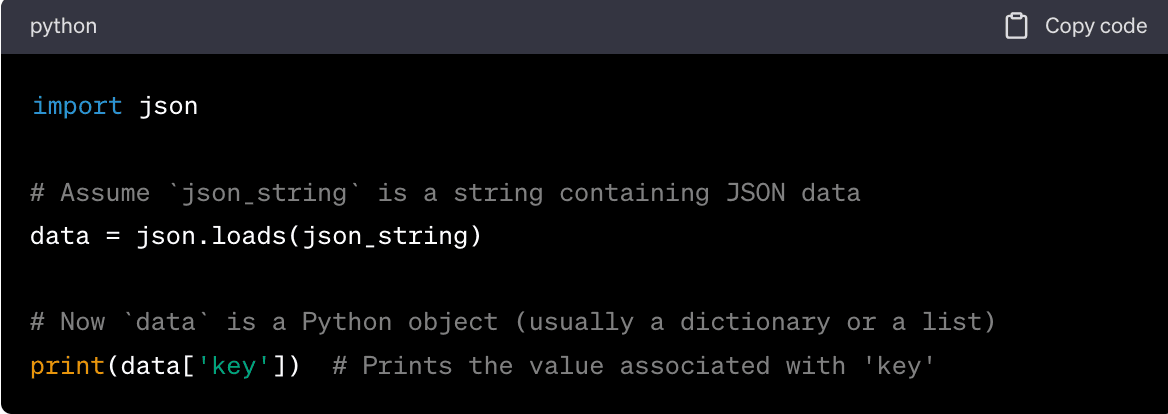
Dalam kedua kasus tersebut, tujuan dari proses parsing adalah mengubah data HTML atau JSON mentah menjadi format yang lebih mudah diolah dalam bahasa pemrograman Anda. Setelah data di-parsing, Anda dapat menelusurinya untuk menemukan bagian data tertentu yang Anda minati.
Tips Mengelola Data Secara Efisien
Mengelola data dalam jumlah besar secara efisien merupakan aspek penting dalam proses web scraping pada platform e-commerce besar seperti Walmart. Berikut beberapa tips tentang cara menangani kumpulan data besar:
• Gunakan Basis Data. Menyimpan data Anda dalam basis data dapat mempermudah pengelolaannya, terutama jika Anda berurusan dengan data dalam jumlah besar. Basis data dirancang untuk menangani kumpulan data yang besar dan dapat menyediakan fitur seperti pengindeksan, yang dapat mempercepat proses pencarian data Anda.
• Pemrosesan Berkelompok. Alih-alih memproses setiap titik data saat di-scrape, pertimbangkan untuk mengumpulkan data Anda ke dalam kelompok-kelompok dan memproses setiap kelompok sekaligus. Hal ini bisa lebih efisien dan dapat mengurangi beban pada sistem Anda.
• Kompresi Data. Jika ruang penyimpanan menjadi masalah, pertimbangkan untuk mengompresi data Anda. Banyak format data umum, seperti CSV dan JSON, dapat dikompresi hingga menjadi sebagian kecil dari ukuran aslinya.
• Pemrosesan Paralel. Jika Anda mengikis beberapa halaman atau situs web sekaligus, pertimbangkan untuk menggunakan pemrosesan paralel guna mempercepat proses tersebut. Hal ini melibatkan menjalankan beberapa tugas pengikisan secara bersamaan, yang dapat secara signifikan mengurangi total waktu pengikisan.
• Pengikisan Bertahap. Alih-alih mengikis semua data sekaligus, pertimbangkan untuk melakukannya secara bertahap. Hal ini melibatkan pemantauan data yang telah Anda ikis dan hanya mengikis data baru atau yang diperbarui. Cara ini bisa lebih efisien dan dapat mengurangi beban pada sistem Anda maupun situs web yang Anda ikis.
• Gunakan Solusi Berbasis Awan. Solusi berbasis awan dapat menyediakan penyimpanan dan daya pemrosesan yang dapat diskalakan, yang sangat berguna saat menangani data dalam jumlah besar. Layanan seperti Amazon Web Services (AWS), Google Cloud, dan Microsoft Azure menawarkan berbagai solusi penyimpanan dan pemrosesan data yang mampu menangani kumpulan data besar.
• Pembersihan dan Validasi Data. Bersihkan dan validasi data Anda sedini mungkin dalam alur data. Hal ini dapat mencakup penghapusan duplikat, penanganan nilai yang hilang, dan pemeriksaan konsistensi data. Membersihkan dan memvalidasi data sejak dini dapat mencegah kesalahan dan inefisiensi di kemudian hari.
Ingatlah, tujuannya adalah mengelola data Anda dengan cara yang efisien, skalabel, dan sesuai dengan kebutuhan spesifik Anda. Pendekatan terbaik dapat bergantung pada ukuran kumpulan data Anda, sumber daya yang tersedia, serta persyaratan spesifik proyek Anda.
Menghindari Pemblokiran
Meskipun web scraping merupakan alat yang ampuh untuk mengekstrak data dari situs web, Walmart tidak menyetujui praktik ini.
Berikut adalah beberapa alasan umum mengapa akun diblokir saat melakukan web scraping, beserta tips untuk menghindarinya:
• Terlalu Banyak Permintaan. Mengirimkan terlalu banyak permintaan dalam waktu singkat dapat membebani server Walmart dan berdampak negatif pada kinerja situs web. Sering dianggap sebagai bentuk penyalahgunaan, hal ini merupakan alasan umum untuk diblokir. Untuk menghindarinya, batasi frekuensi permintaan Anda dan tambahkan jeda di antara permintaan.
• Mengabaikan Berkas Robots.txt. Berkas robots.txt adalah cara bagi situs web untuk berkomunikasi dengan perayap web dan pengikis data. Berkas ini menentukan bagian mana dari situs web yang tidak boleh di-scraping. Mengabaikan aturan dalam berkas ini dapat menyebabkan pengikis data Anda diblokir. Selalu periksa dan patuhi berkas robots.txt dari situs web yang Anda scraping.
• Tidak Mengganti Alamat IP. Jika semua permintaan Anda berasal dari alamat IP yang sama, hal ini dapat menjadi tanda jelas bahwa Anda sedang melakukan scraping pada situs web tersebut. Walmart akan memblokir alamat IP Anda jika mengirimkan terlalu banyak permintaan. Untuk menghindari hal ini, pertimbangkan untuk menggunakan kumpulan proxy residensial yang bergantian guna mendistribusikan permintaan Anda ke berbagai alamat IP.
- API Scraping dari Geonode menggunakan kumpulan proxy yang bergantian. Setiap permintaan yang Anda kirim melalui API tersebut dilakukan dari alamat IP yang berbeda. Hal ini dapat membantu menghindari pemblokiran berbasis IP dan pembatasan laju, karena membuat situs web lebih sulit mengidentifikasi dan memblokir scraper Anda. Rotasi alamat IP juga membantu mendistribusikan permintaan Anda secara lebih merata, mengurangi beban pada server mana pun, dan membuat proses scraping Anda lebih efisien.
• Tidak Menggunakan String User-Agent atau Menggunakan yang Mencurigakan. String User-Agent memberi tahu situs web jenis perangkat dan browser apa yang melakukan permintaan. Situs web seperti Walmart akan memblokir permintaan yang tidak menyertakan string User-Agent, atau yang menggunakan string User-Agent yang diketahui terkait dengan scraper. Gunakan string User-Agent yang sah dan meniru browser asli.
• Mengikis Data yang Dilindungi. Beberapa data di situs web mungkin dilindungi oleh hak cipta atau perlindungan hukum lainnya. Mengikis data ini dapat mengakibatkan pemblokiran, dan juga dapat menimbulkan konsekuensi hukum. Pastikan selalu bahwa Anda memiliki hak untuk melakukan scraping dan menggunakan data yang menjadi sasaran Anda.
Tentu saja, cara terbaik untuk menghindari pemblokiran adalah dengan melakukan scraping secara bertanggung jawab. Patuhi aturan situs web, jangan membebani server secara berlebihan, dan pastikan selalu bahwa Anda memiliki hak untuk melakukan scraping dan menggunakan data yang menjadi sasaran Anda.

