Bayangkan Anda diberi sebuah kotak raksasa yang berisi ribuan potongan puzzle—itulah data yang kita kumpulkan di era digital ini. Jumlahnya sangat besar, membingungkan, dan sekilas mungkin tampak tidak masuk akal.
Di sinilah pemrosesan data berperan. Anggaplah pemrosesan data sebagai ahli pemecah teka-teki yang menyortir semua potongan teka-teki tersebut, mengelompokkannya sedemikian rupa sehingga gambarnya mulai masuk akal.
Pemrosesan data mengubah kumpulan informasi yang membingungkan itu menjadi data siap pakai yang dapat Anda jelajahi dan pelajari. Ini seperti kru di belakang panggung dalam sebuah produksi teater, yang sering kali tak terlihat namun sangat penting agar pertunjukan dapat berlangsung.
Dalam artikel ini, kami mencoba menunjukkan bagaimana pemrosesan data menjadi sorotan, mengubah kekacauan data mentah menjadi sebuah kisah yang penuh dengan wawasan berharga.
Memahami Pengolahan Data
Pengolahan data merupakan komponen penting dalam bidang analisis data. Proses ini mengubah data mentah dalam jumlah besar menjadi format data yang terstruktur agar dapat dibaca dan dipahami.
Transformasi ini sangat penting di era saat ini, di mana data dalam jumlah sangat besar dihasilkan setiap detik.
Pemrosesan data memungkinkan kita menyusun informasi sedemikian rupa sehingga dapat dipahami baik oleh mesin maupun manusia. Hasilnya: pemrosesan dan analisis data yang lebih lancar, yang menghasilkan wawasan berharga.
Pentingnya penguraian data terletak pada kemampuannya mengubah data tidak terstruktur menjadi format data yang dapat dibaca.
Baik untuk analitik bisnis, pengembangan perangkat lunak, maupun penelitian, data yang telah diuraikan memberikan kejelasan dan membantu dalam pengambilan keputusan yang terinformasi.
Contoh Nyata Pengolahan Data dalam Praktik
-
Web Scraping. Saat pengembang mengekstrak informasi dari situs web, data tersebut sering kali berbentuk HTML.
Pengolahan data mengubah data HTML ini menjadi format terstruktur seperti JSON atau XML, yang lebih mudah dianalisis dan disimpan.
-
Analisis Log. Administrator sistem sering kali mem-parsing berkas log untuk mengekstrak informasi tertentu.
Misalnya, jika sebuah server mengalami crash, mem-parsing log dapat membantu menentukan waktu pasti terjadinya crash dan peristiwa-peristiwa yang mendahuluinya.
-
Platform E-commerce. Saat Anda mencari produk di situs belanja online, platform tersebut memproses kueri pencarian Anda untuk menampilkan produk yang paling relevan.
Proses ini melibatkan pemecahan masukan Anda dan mencocokkannya dengan data produk.
-
Aplikasi Cuaca. Aplikasi cuaca mengurai data dari sumber-sumber meteorologi untuk menyajikannya dalam format yang ramah pengguna yang menampilkan suhu, kelembapan, prakiraan cuaca, dan lainnya.
-
Transaksi Keuangan. Aplikasi perbankan mengurai data transaksi untuk menampilkan aktivitas rekening Anda secara terorganisir. Aplikasi ini mengkategorikan pembelian, setoran, dan transaksi lainnya agar mudah dilacak.
Dalam setiap contoh ini, penguraian data memainkan peran penting dalam memastikan bahwa data disajikan secara bermakna dan terorganisir.
Penguraian data tidak hanya memfasilitasi analisis data yang efisien; hal ini juga meningkatkan pengalaman pengguna.
Mekanisme Penguraian Data
Mengubah data yang berantakan menjadi informasi yang jelas melibatkan langkah-langkah tertentu.
Langkah-langkah ini, atau mekanisme, membantu memecah dan mengatur data sedemikian rupa sehingga mudah dipahami.
Mari kita bahas jenis-jenis analisis utama yang digunakan dalam proses penguraian data:
Analisis Leksikal
Analisis leksikal merupakan landasan dasar dalam penguraian data.
Proses ini melibatkan pemindaian data mentah untuk mengidentifikasi dan mengkategorikan bagian-bagian individual, yang sering disebut sebagai token atau unit leksikal individual.
Bayangkan proses ini seperti memecah sebuah kalimat menjadi kata-kata. Setiap kata, atau token, memiliki peran tertentu.
Dalam penguraian data, analisis leksikal mengidentifikasi token-token ini dari data mentah, memastikan bahwa tahap-tahap penguraian berikutnya dapat memprosesnya dengan benar.
Misalkan kita memiliki string data mentah berikut:
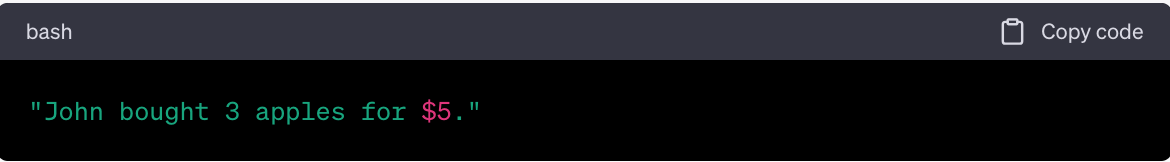
Rincian Analisis Leksikal
Pada fase analisis leksikal, string ini akan dipindai dan diuraikan menjadi token-token individual. Berikut gambaran prosesnya:
- "John" - Diidentifikasi sebagai kata benda khusus (dalam hal ini, sebuah nama).
- "bought" - Diidentifikasi sebagai kata kerja.
- "3" - Diidentifikasi sebagai angka.
- "apples" - Diidentifikasi sebagai kata benda.
- "for" - Diidentifikasi sebagai kata depan.
- "$" - Diidentifikasi sebagai simbol mata uang.
- "5" - Diidentifikasi sebagai angka.
Setiap token ini dikategorikan berdasarkan jenis dan perannya dalam string data.
Proses analisis leksikal tidak mempermasalahkan hubungan antar token ini atau makna keseluruhan dari string tersebut.
Sebaliknya, proses ini berfokus semata-mata pada pengenalan dan pengelompokan setiap bagian data dengan tujuan agar setiap data dapat dikenali dan dikelompokkan sehingga dapat digunakan pada tahap analisis berikutnya.
Analisis Sintaksis
Setelah data dipecah menjadi token, analisis sintaksis mulai berperan.
Fase ini bertujuan untuk menyusun token-token tersebut sedemikian rupa sehingga membentuk struktur yang koheren, seperti menyusun kata-kata untuk membentuk kalimat yang bermakna.
Dengan menciptakan struktur ini, analisis sintaksis memastikan bahwa data disusun sedemikian rupa sehingga dapat ditafsirkan baik oleh mesin maupun manusia.
Ingat string data yang kita gunakan di atas?
Analisis leksikal memecahnya menjadi token-token: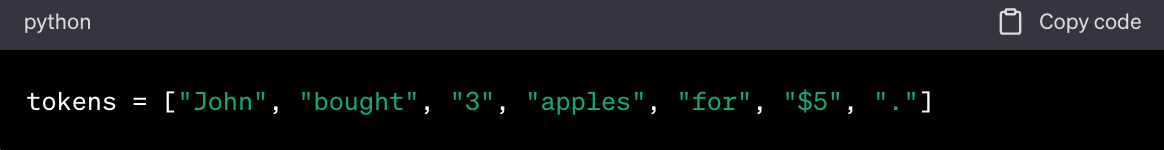
Ilustrasi Analisis Sintaksis
Dengan menggunakan token-token ini, analisis sintaksis akan menyusunnya menjadi urutan yang bermakna, yang direpresentasikan sebagai struktur pohon: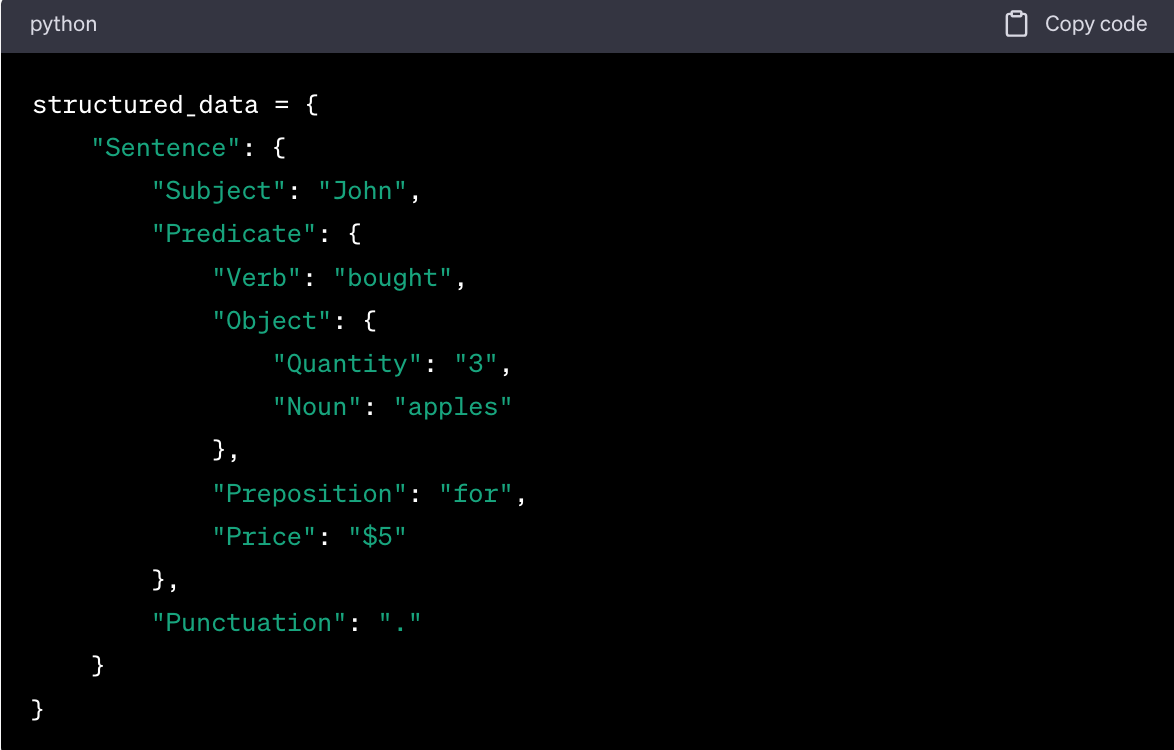
Dalam struktur pohon penguraian ini:
- "John" diidentifikasi sebagai subjek kalimat.
- "bought" adalah kata kerja utama atau tindakan.
- "3 apples" adalah objek, yang selanjutnya diuraikan menjadi kuantitas ("3") dan kata benda ("apples").
- "for" menunjukkan frasa preposisional.
- "$5" mewakili harga atau biaya yang terkait dengan tindakan tersebut.
- "." adalah tanda baca yang menandai akhir kalimat.
Representasi terstruktur ini, yang diperoleh melalui analisis sintaksis, memberikan hierarki dan hubungan yang jelas antara token-token tersebut, sehingga memungkinkan pemahaman yang lebih mendalam mengenai makna dari string data asli.
Analisis Semantik
Langkah selanjutnya adalah analisis semantik.
Langkah ini bertujuan untuk memahami makna di balik data terstruktur tersebut.
Hal ini memastikan bahwa hubungan antar bagian data yang berbeda jelas dan bahwa data secara keseluruhan masuk akal.
Ilustrasi Analisis Semantik
Setelah analisis sintaksis, kita memiliki representasi terstruktur dari data.
Kini, analisis semantik akan menafsirkan makna di balik struktur ini.
Hasil:
Dalam analisis semantik ini, data terstruktur ditafsirkan untuk mengekstrak informasi yang bermakna.
Nama pembeli, tindakan yang dilakukan, barang yang dibeli, jumlah barang, dan total biaya semuanya diperoleh dari data terstruktur.
Penafsiran ini memberikan pemahaman yang jelas mengenai peristiwa yang dijelaskan dalam string data asli.
Jenis-jenis Parsing Data
Saat membahas parsing data, penting untuk mengetahui dua jenis utama parsing data: parsing data berbasis tata bahasa dan parsing data berbasis data.
Masing-masing metode ini memiliki kelebihan dan kasus penggunaan yang sesuai.
Memahami hal ini dapat membantu Anda memilih metode yang tepat untuk kebutuhan spesifik Anda.
Pemrosesan Data Berbasis Tata Bahasa
Pemrosesan berbasis tata bahasa, seperti namanya, mengandalkan aturan tata bahasa yang telah ditentukan sebelumnya untuk menyusun struktur data.
Metode ini sangat teliti dan presisi, memastikan bahwa data yang diparsing benar-benar mematuhi pedoman yang telah ditetapkan.
Misalnya, bahasa pemrograman sering menggunakan parser berbasis tata bahasa untuk menafsirkan kode, memastikan bahwa pengembang mengikuti sintaksis bahasa dan aturan tata bahasa formal.
Meskipun pendekatan ini menawarkan akurasi tinggi, metode ini mungkin kurang fleksibel saat menghadapi pola data yang tidak dikenal atau tidak teratur.
Sebagai ilustrasi:
Bayangkan Anda sedang membangun kastil mainan menggunakan seperangkat petunjuk LEGO tertentu.
Setiap langkah dalam petunjuk tersebut memberi tahu Anda dengan tepat potongan mana yang harus digunakan dan di mana harus meletakkannya.
Jika Anda mengikuti petunjuk tersebut dengan tepat, Anda akan mendapatkan kastil yang sempurna.
Namun, jika Anda mencoba menggunakan potongan yang tidak disebutkan dalam petunjuk atau menempatkannya di lokasi yang tidak ditentukan, kastil tersebut tidak akan terbentuk dengan benar.
Dalam analogi ini, petunjuk LEGO mewakili aturan tata bahasa, dan proses membangun kastil itu seperti proses penguraian berbasis tata bahasa.
Sama seperti kastil LEGO yang membutuhkan potongan-potongan tertentu di tempat-tempat tertentu, penguraian berbasis tata bahasa (grammar-driven parsing) membutuhkan data yang sesuai secara tepat dengan aturan yang telah ditentukan sebelumnya.
Jika data tidak sesuai, sama seperti potongan LEGO yang salah, proses penguraian tidak dapat berjalan dengan benar.
Parsing Berbasis Data
Di sisi lain, parsing berbasis data menggunakan metode statistik untuk menafsirkan data.
Alih-alih hanya mengandalkan aturan tetap, metode ini memanfaatkan pola yang ditemukan dalam kumpulan data besar untuk membuat perkiraan yang masuk akal mengenai cara menyusun data baru.
Pendekatan ini sangat berguna saat menangani tugas pemrosesan bahasa alami atau ketika sumber data beragam dan tidak dapat diprediksi.
Dengan memanfaatkan data dalam jumlah besar, metode ini dapat beradaptasi dan memberikan cakupan yang lebih luas, sehingga lebih serbaguna dalam menangani masukan data yang bervariasi.
Sebagai ilustrasi:
Melanjutkan analogi LEGO, bayangkan Anda memiliki kotak campuran potongan LEGO tanpa petunjuk khusus.
Alih-alih panduan set, Anda telah mengamati banyak orang membangun berbagai struktur dengan set LEGO serupa dari waktu ke waktu.
Berdasarkan pengamatan ini, Anda mulai mengenali pola dan struktur umum yang sering dibangun orang, seperti dinding, menara, atau jembatan.
Saat Anda memutuskan untuk membangun sesuatu dari kotak campuran tersebut, Anda mengandalkan pola-pola yang telah diamati ini.
Jika Anda melihat jenis potongan tertentu yang sering digunakan sebagai jendela atau pintu dalam konstruksi sebelumnya, Anda mungkin memutuskan untuk menggunakannya dengan cara yang sama.
Anda tidak secara ketat mengikuti satu set instruksi saja, melainkan menggunakan pengetahuan yang diperoleh dari berbagai bangunan sebelumnya untuk memandu proses pembangunan Anda.
Dalam skenario ini, proses membangun berdasarkan pola yang diamati mirip dengan penguraian berbasis data.
Sama seperti Anda menggunakan konstruksi LEGO sebelumnya untuk memandu pembangunan Anda, penguraian berbasis data menggunakan pola dalam kumpulan data yang ada untuk menafsirkan dan menyusun data baru.
Proses ini fleksibel dan adaptif, memungkinkan kreativitas dan variasi, mirip seperti membangun dengan LEGO tanpa panduan yang baku.
Parsing Data vs. Penggoresan Data
Parsing data dan penggoresan data adalah dua istilah yang sering digunakan secara bergantian, namun keduanya merupakan proses analisis data yang berbeda.
Memahami perbedaan di antara keduanya, serta pentingnya masing-masing, sangat penting bagi siapa pun yang bekerja dengan data.
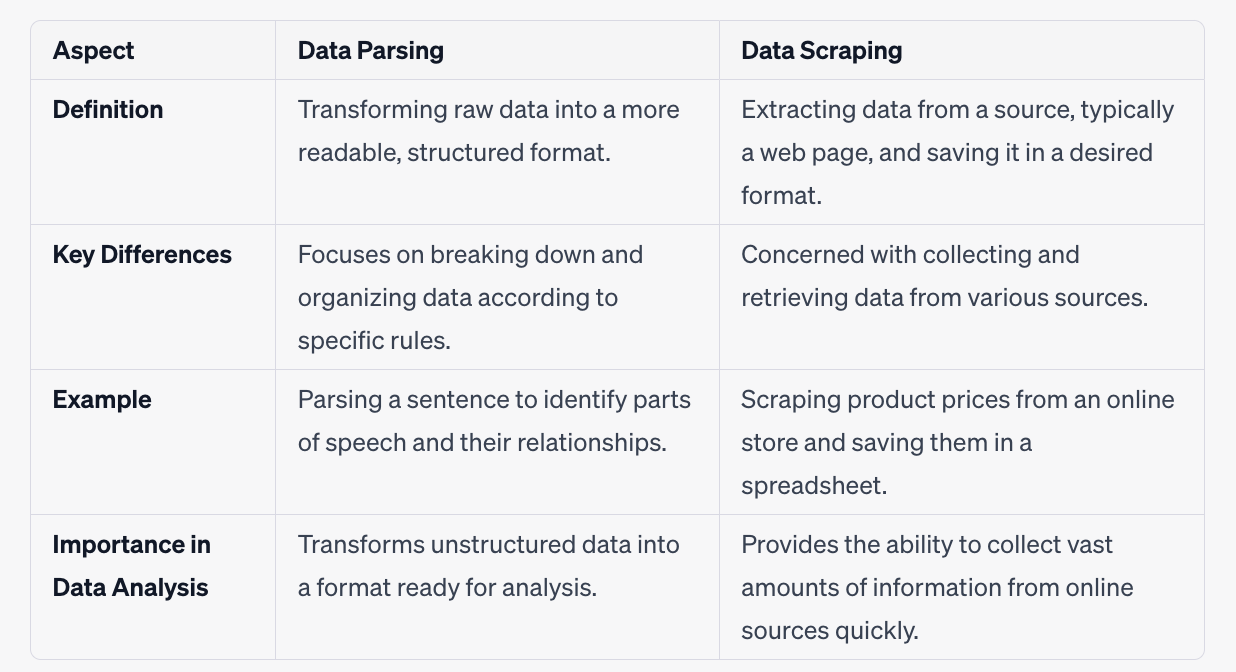
Parsing data dan scraping data adalah proses yang berbeda namun saling melengkapi dalam bidang analisis data.
Parsing berkaitan dengan mengubah dan menyusun data agar siap untuk dianalisis, sedangkan scraping berkaitan dengan mengumpulkan dan mengambil data dari berbagai sumber.
Keduanya merupakan tahap penting dalam mengubah informasi mentah menjadi wawasan yang dapat ditindaklanjuti.
Aplikasi Penguraian Data
Penguraian data berfungsi sebagai jembatan antara informasi yang berantakan dan wawasan yang dapat ditindaklanjuti, sehingga memungkinkan industri modern untuk menganalisis dan memanfaatkan data secara efektif.
Bagian ini membahas beragam aplikasi pemrosesan data, dengan menyoroti perannya yang esensial di berbagai bidang, mulai dari Pemrosesan Bahasa Alami (NLP) hingga e-commerce, layanan kesehatan, analisis keuangan, dan banyak lagi.
-
Pemrosesan Bahasa Alami (NLP). Parsing data dalam NLP melibatkan pemecahan bahasa manusia menjadi bagian-bagian yang lebih kecil, seperti kata dan frasa, serta memahami hubungan di antara keduanya.
Proses ini sangat penting untuk berbagai aplikasi seperti pengenalan ucapan, di mana kata-kata yang diucapkan diubah menjadi teks, dan terjemahan mesin, di mana teks diterjemahkan dari satu bahasa ke bahasa lain.
-
Transformasi Data dan Proses ETL (Extract, Transform, Load). Proses ETL menggunakan pemrosesan data untuk mengambil data dari berbagai sumber dan mengubahnya menjadi format yang seragam.
Keseragaman ini sangat penting untuk analisis data, karena memastikan bahwa data dari berbagai sumber dapat dibandingkan dan dianalisis secara bersamaan. Ini merupakan langkah kritis dalam data warehousing dan business intelligence.
-
Optimasi Kueri dalam Basis Data. Parsing data digunakan untuk menganalisis kueri basis data, memahami strukturnya, dan mengoptimalkan eksekusinya.
Dengan memilih cara paling efisien untuk mengambil data, parsing membantu mengurangi waktu yang dibutuhkan untuk menjawab kueri, sehingga meningkatkan kinerja sistem basis data.
-
Analisis Data Keuangan. Di sektor keuangan, pemrosesan data digunakan untuk menganalisis dan menafsirkan data keuangan yang kompleks.
Hal ini membantu mengubah laporan keuangan dan data tidak terstruktur serupa menjadi format yang mudah dibaca, yang dapat digunakan untuk berbagai analisis seperti mengidentifikasi tren, penilaian risiko, dan pengambilan keputusan investasi.
-
Standarisasi Data Kesehatan. Data kesehatan sering kali berasal dari berbagai sumber dan dalam format yang berbeda-beda. Pemrosesan data membantu industri kesehatan dalam menstandarkan informasi ini, sehingga menjadikannya konsisten di berbagai sistem.
Standarisasi ini sangat penting bagi perawatan pasien, karena memastikan bahwa tenaga medis memiliki data yang akurat dan seragam.
-
Analisis Optimasi Mesin Pencari (SEO). Pemrosesan data berperan dalam menganalisis halaman web serta memahami konten, struktur, dan metadata-nya.
Pemahaman ini membantu mengoptimalkan berbagai elemen halaman web dan meningkatkan visibilitasnya di internet.
-
Analisis Data Media Sosial. Platform media sosial menghasilkan sejumlah besar data tidak terstruktur. Pemrosesan data membantu dalam mengorganisasikan data ini, sehingga memungkinkan untuk menganalisis tren, sentimen, dan perilaku pengguna.
Analisis ini sangat berharga bagi bisnis yang ingin memahami audiens mereka dan menyesuaikan strategi pemasaran mereka.
-
Interpretasi Data Ilmiah. Penelitian ilmiah sering kali melibatkan data kompleks dalam berbagai format file yang perlu diinterpretasikan secara akurat.
Parsing data membantu mengorganisasikan data tersebut, baik itu informasi genomik dalam biologi maupun data meteorologi dalam ilmu iklim, sehingga memungkinkan para peneliti untuk memperoleh wawasan yang bermakna.
-
Pengolahan Data Sistem Informasi Geografis (SIG). SIG bergantung pada data spasial yang harus diparsing dan disusun secara akurat.
Parsing data memastikan bahwa koordinat, lapisan peta, dan informasi geografis lainnya ditangani dengan benar, sehingga memudahkan tugas-tugas seperti pemetaan, analisis spasial, dan pemantauan lingkungan.
-
Penyusunan Informasi Produk E-commerce. Platform e-commerce menangani sejumlah besar informasi produk. Pemrosesan data membantu dalam menyusun informasi ini, memastikan bahwa deskripsi produk, spesifikasi, dan harga konsisten di berbagai platform.
Konsistensi ini meningkatkan pengalaman berbelanja bagi konsumen, sehingga pencarian dan perbandingan produk menjadi lebih mudah.
Memahami Pengurai Data
Pengurai data adalah perangkat lunak atau algoritma khusus, yang sering disebut sebagai mekanisme penguraian, yang dirancang untuk mengubah format data yang tidak konsisten menjadi format yang terstruktur dan benar.
Parser ini membaca data mentah, mengenali elemen-elemen tertentu, dan mengaturnya sesuai dengan aturan atau pola yang telah ditentukan sebelumnya.
Prosedur parsing ini sangat penting untuk mengubah data berkualitas tinggi menjadi bentuk yang dapat dipahami dan digunakan untuk berbagai aplikasi.
Ada dua jenis utama parser data: parser buatan sendiri dan parser pihak ketiga.
Parser buatan sendiri dirancang khusus oleh suatu organisasi untuk memenuhi kebutuhan tertentu, sedangkan parser pihak ketiga adalah solusi siap pakai yang disediakan oleh vendor eksternal.
Pentingnya Parser Data
- Aksesibilitas. Dengan menyusun data ke dalam format yang benar, parser membuatnya dapat diakses untuk analisis, pelaporan, dan pengambilan keputusan.
- Interoperabilitas. Parser memungkinkan integrasi data di berbagai sistem, memastikan konsistensi dan kompatibilitas, bahkan dengan format data yang tidak seragam.
- Efisiensi. Parser data yang canggih mempercepat tugas parsing dengan mengotomatiskan transformasi, sehingga mengurangi upaya manual.
- Akurasi. Parser memastikan data ditafsirkan dengan benar, meminimalkan kesalahan, dan meningkatkan keandalan data berkualitas tinggi.
Parser Buatan Sendiri
Parser buatan sendiri dirancang khusus oleh suatu organisasi untuk memenuhi kebutuhan spesifik, menjadikannya alat yang ampuh untuk pemrosesan data.
Berbeda dengan solusi pihak ketiga, parser buatan sendiri memungkinkan pembuatan sistem parser khusus yang dapat disesuaikan untuk menangani solusi unik dan kompleks.
-
Parser Khusus. Membangun parser internal memungkinkan organisasi untuk menciptakan mekanisme parsing khusus yang selaras sempurna dengan struktur data dan persyaratannya.
Hal ini memastikan bahwa parser tersebut disesuaikan secara tepat dengan format dan pola data spesifik yang sering ditangani oleh organisasi, sehingga menghasilkan analisis yang akurat.
-
Solusi Ideal untuk Kebutuhan Kompleks. Untuk operasi bisnis yang menangani data yang sangat khusus atau kompleks, parser buatan sendiri sering kali muncul sebagai solusi ideal yang membantu pengambilan keputusan bisnis yang terinformasi.
Parser ini dapat dirancang untuk menangani struktur data yang rumit atau untuk mematuhi regulasi industri dan persyaratan bisnis yang ketat, memberikan tingkat penyesuaian yang mungkin tidak ditawarkan oleh parser pihak ketiga.
-
Alat yang Kuat untuk Optimalisasi. Parser yang dikembangkan sendiri bukan sekadar utilitas fungsional; melainkan alat yang kuat yang dapat dioptimalkan untuk memperoleh wawasan akurat demi kesuksesan bisnis jangka panjang.
Dengan mengendalikan setiap aspek prosedur penguraian, sebuah organisasi dapat memastikan bahwa parser beroperasi dengan efisiensi maksimal, menangani volume data yang besar tanpa hambatan.
-
Tantangan dan Pertimbangan. Meskipun parser buatan sendiri menawarkan banyak keuntungan, parser ini juga memiliki tantangan tersendiri.
Membangun parser khusus memerlukan pengetahuan khusus dan dapat memakan banyak sumber daya. Kompleksitas merancang parser yang mampu menangani solusi rumit juga dapat menyebabkan biaya pengembangan yang lebih tinggi dan jadwal implementasi yang lebih lama.
Parser Data Pihak Ketiga
Parser data pihak ketiga adalah solusi siap pakai yang disediakan oleh vendor eksternal, yang dirancang untuk membantu organisasi dalam proses pengumpulan data dan transformasinya ke dalam format terstruktur.
Beberapa parser pihak ketiga yang paling populer antara lain:
- Apache Commons CSV - Pustaka untuk membaca dan menulis berkas CSV.
- Jackson - Parser JSON untuk Java yang menawarkan kinerja tinggi dan fleksibilitas.
- Beautiful Soup - Pustaka Python untuk pengikisan web, yang memungkinkan penguraian HTML dan XML.
- TinyXML - Parser XML yang ringan, cocok untuk proyek-proyek kecil atau sistem tertanam.
- Pandas - Perpustakaan Python yang menyediakan struktur data untuk menyimpan kumpulan data besar secara efisien dan mencakup fungsi-fungsi untuk penguraian data.
Parser-parser ini dilengkapi dengan berbagai fungsi dan dapat digunakan untuk berbagai tujuan, seperti:
- Parsing XML. Parser pihak ketiga dapat menangani dokumen XML, menerjemahkan rangkaian perintah menjadi format yang mudah dibaca dan dikelola.
- Parsing Dokumen. Parser dokumen digunakan untuk mengekstrak informasi berharga dari berbagai format dokumen.
- Parsing Proxy. Saat menangani data web dan protokol komunikasi, parser proxy dapat digunakan untuk mengelola aliran data.
Manfaat
- Istilah Sederhana. Banyak parser pihak ketiga dirancang dengan istilah sederhana, sehingga dapat diakses oleh pengguna tanpa keahlian teknis yang mendalam. Kesederhanaan ini sering kali mempercepat proses pengumpulan data.
- Kontrol Terperinci: Meskipun tidak sefleksibel parser buatan sendiri, banyak parser canggih menawarkan kontrol terperinci, yang memungkinkan analisis mendalam dan penanganan data yang spesifik.
- Opsi Server Khusus: Beberapa parser pihak ketiga menyediakan opsi server khusus, memastikan kontrol penuh atas lingkungan parsing dan meningkatkan kinerja.
- Pemeliharaan Berkelanjutan: Vendor sering kali menyediakan pemeliharaan berkelanjutan, memastikan bahwa parser selalu diperbarui sesuai dengan protokol dan standar komunikasi terbaru.
Tantangan
- Kustomisasi Terbatas. Tidak seperti skrip khusus pada parser buatan sendiri, solusi pihak ketiga mungkin tidak menawarkan kendali penuh untuk kebutuhan yang sangat spesifik.
- Potensi Masalah Keamanan. Tergantung pada parser yang digunakan, mungkin ada kekhawatiran terkait keamanan data dan kepatuhan terhadap regulasi industri.
- Lisensi dan Biaya. Menggunakan parser yang tepat dari pihak ketiga mungkin memerlukan biaya lisensi serta biaya berkelanjutan untuk pemeliharaan dan dukungan.
Masa Depan Pemrosesan Data
Masa depan pemrosesan data ditandai oleh evolusi dan inovasi yang berkelanjutan, yang didorong oleh teknologi dan metodologi terbaru.
Integrasi dengan komputasi awan, kemampuan pemrosesan data secara real-time, langkah-langkah keamanan yang ditingkatkan, serta solusi yang dapat disesuaikan membuka jalan bagi alat pemrosesan data yang lebih skalabel, fleksibel, dan efisien.
Kecerdasan Buatan (AI) dan Pembelajaran Mesin (ML) memainkan peran penting dalam transformasi ini.
Parser yang didukung AI tidak hanya dapat mengorganisasikan data, tetapi juga menafsirkan maknanya, sehingga menambahkan lapisan pemahaman semantik yang memungkinkan analisis yang lebih canggih.
Selain itu, permintaan akan analisis real-time dan meningkatnya kepedulian terhadap privasi data mendorong pengembangan solusi parsing yang lebih tangguh dan gesit.
Kemampuan untuk mem-parsing data secara langsung dan penerapan langkah-langkah keamanan yang kokoh menjadi fitur esensial dari alat parsing modern.
Masa depan pemrosesan data terlihat menjanjikan, dengan kemajuan teknologi serta integrasi AI dan ML yang membuat pemrosesan data menjadi lebih otomatis, adaptif, dan memberikan wawasan yang lebih mendalam.
Perkembangan ini diprediksi akan menjadikan pemrosesan data sebagai komponen yang lebih vital dan dinamis dalam proses pengambilan keputusan berbasis data di masa depan.
Kesimpulan
Parsing data bukan sekadar kebutuhan teknis; ini adalah aset strategis yang dapat mengungkap wawasan bisnis yang dapat ditindaklanjuti.
Dengan mengubah data mentah dan tidak terstruktur menjadi format yang terstruktur dan mudah dipahami, pemrosesan data memungkinkan bisnis menganalisis dan menafsirkan informasi yang dapat mendorong pengambilan keputusan dan inovasi.
Baik itu memahami perilaku pelanggan, meningkatkan efisiensi operasional, atau mengungkap peluang pasar baru, pemrosesan data berfungsi sebagai alat yang ampuh untuk mengekstrak wawasan yang bermakna.
Dengan berinvestasi pada mekanisme pemrosesan data yang tepat, baik yang dikembangkan sendiri maupun melalui solusi pihak ketiga, bisnis dapat meningkatkan kemampuannya untuk mengambil keputusan yang terinformasi dan didorong oleh data.
Kami mendorong Anda untuk berpikir melampaui angka-angka dan melihat kisah serta peluang yang tersembunyi di balik data. Dengan pemrosesan data, Anda dapat mengeksplorasi, memahami, dan memanfaatkan informasi dengan cara yang dapat mentransformasi bisnis Anda menuju pertumbuhan dan kesuksesan

