WebHarvy é um raspador de dados que pode recolher todo o tipo de informação de websites e guardar essa informação em diferentes formatos. Isto inclui texto, HTML, imagens, URLs, e e-mails de qualquer website que os utilizadores desejem. WebHarvy é fácil de usar, pois simplifica muitos processos para que até os principiantes o possam utilizar facilmente.
Se quiser extrair uma grande quantidade de dados, precisa de utilizar um proxy WebHarvy quando utilizar o WebHarvy. A maioria dos websites tem restrições rigorosas contra a utilização de bots no seu site e proibirá imediatamente qualquer conta que seja detectada utilizando um.
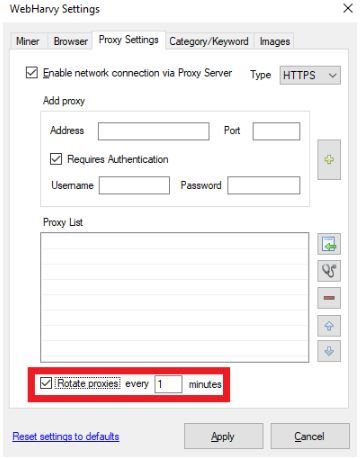
Um proxy WebHarvy impedirá qualquer proibição porque tratará de todos os seus pedidos da Web para si. Ao utilizar proxies residenciais e IPs de rotação contínua, WebHarvy teria um IP diferente num intervalo de tempo definido. Isto engana qualquer website a pensar que o WebHarvy bot é na realidade um utilizador diferente cada vez que envia um pedido.
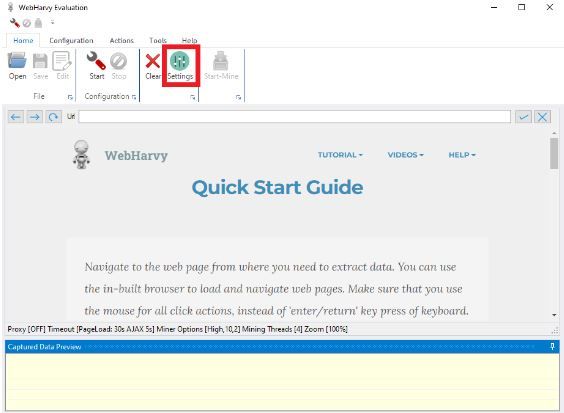
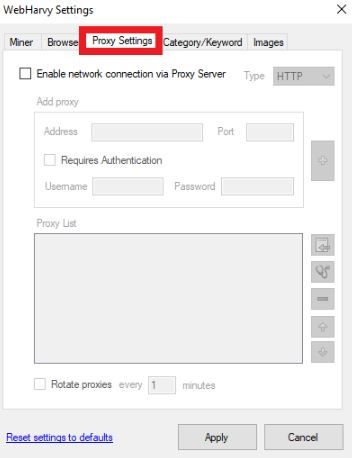
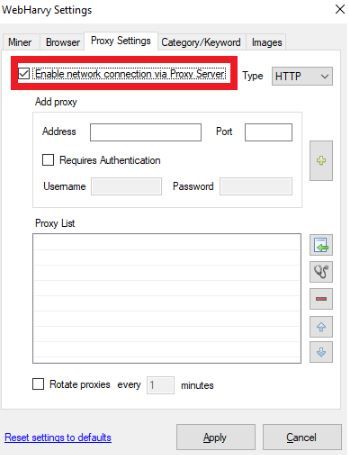
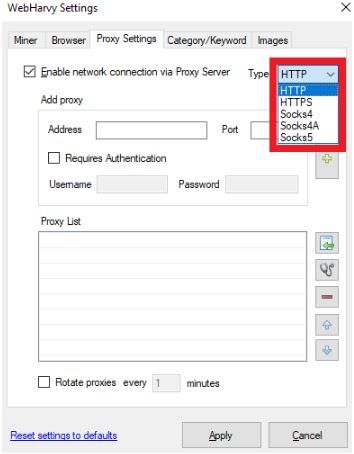
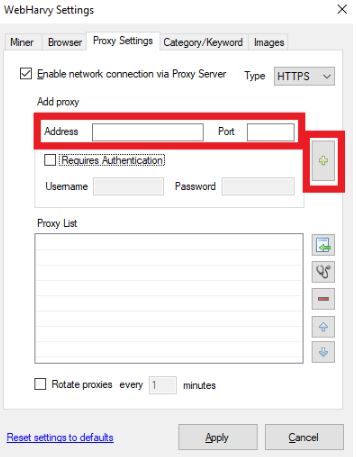
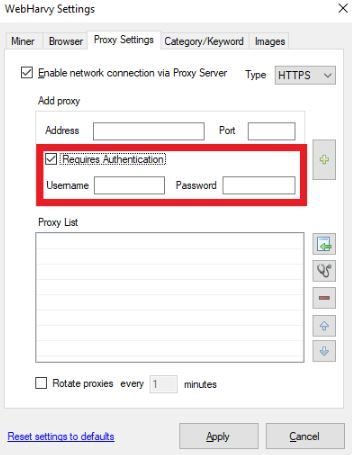
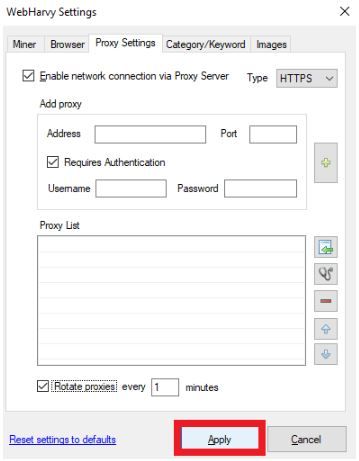
Vamos criar um servidor proxy WebHarvy.