A Immobiliare.it é uma das principais plataformas imobiliárias online de Itália.
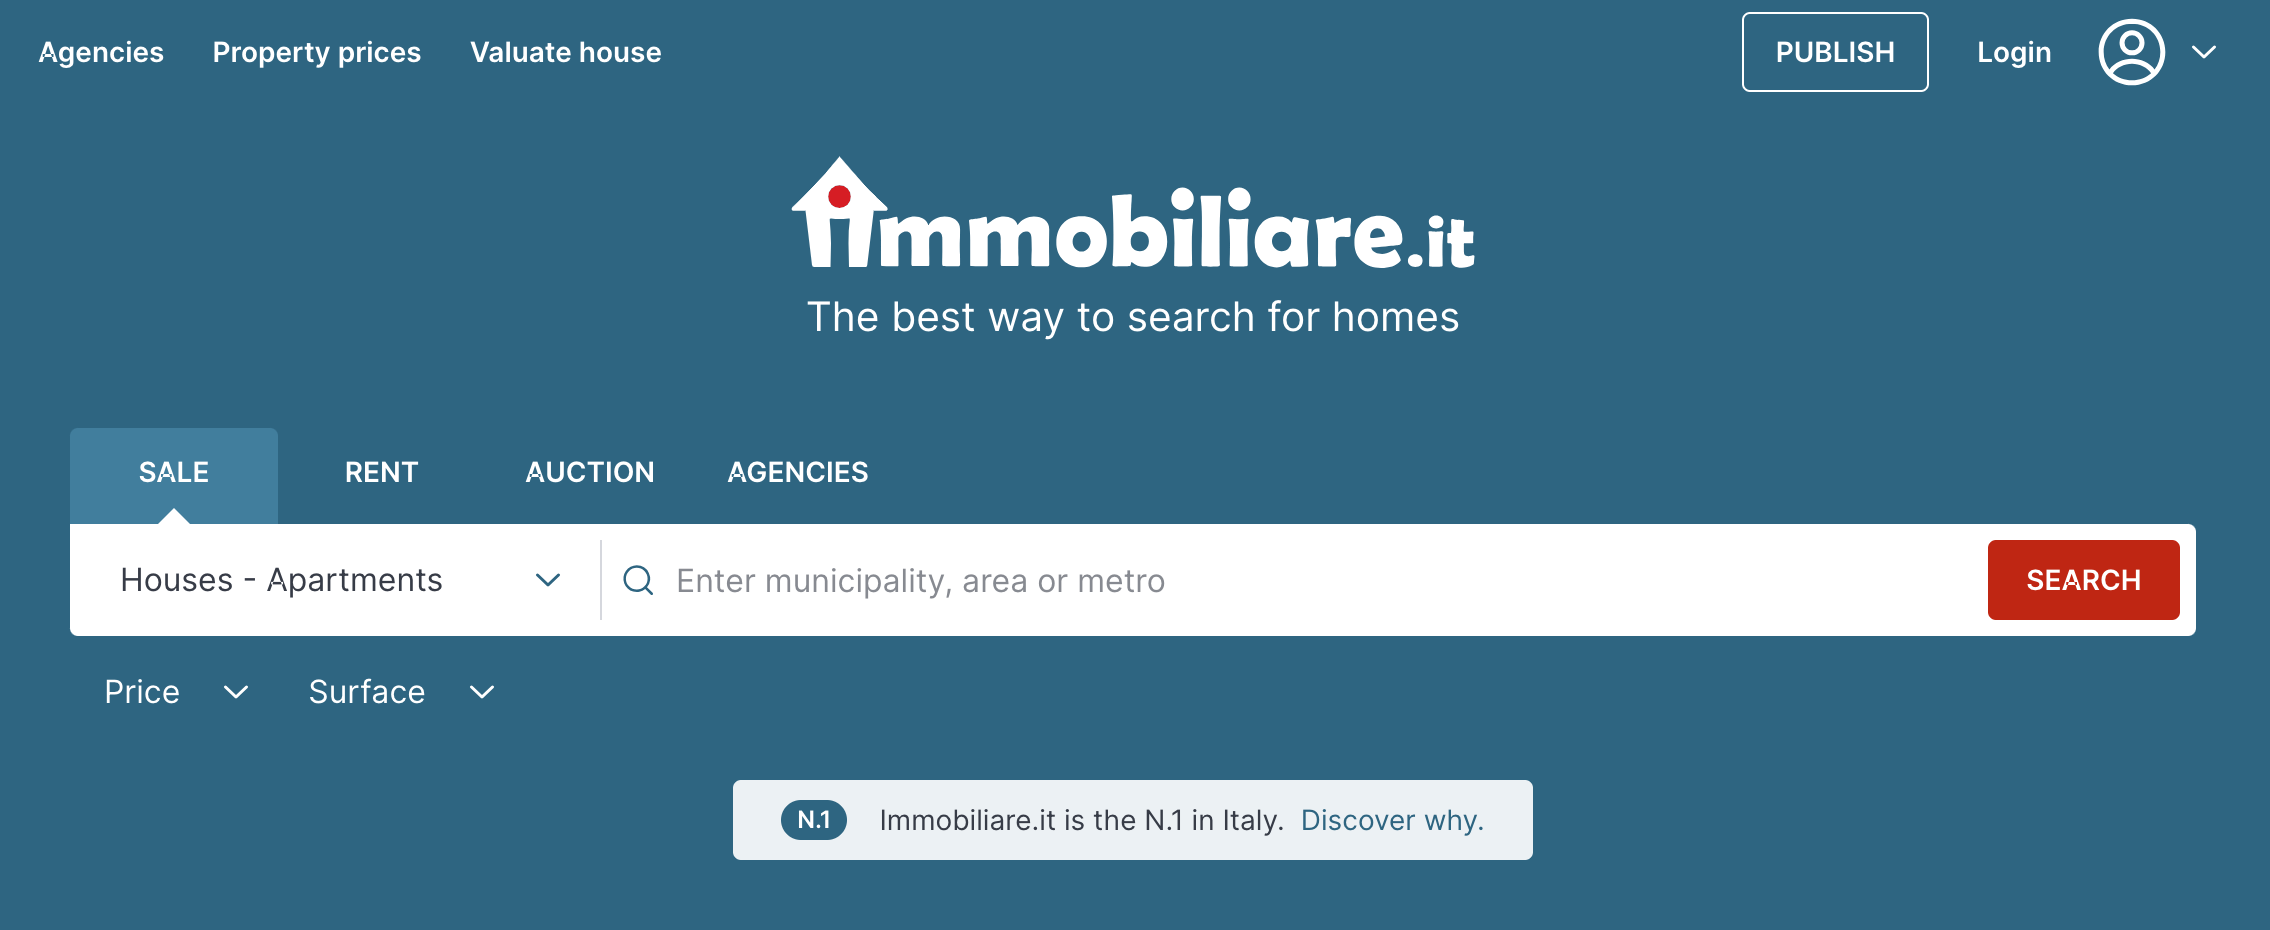
Com uma vasta gama de anúncios que incluem imóveis residenciais, comerciais e de férias, o site constitui um recurso abrangente para quem pretende investir no mercado imobiliário italiano.
Para os agentes imobiliários e compradores de imóveis norte-americanos, o Immobiliare.it oferece uma oportunidade única de aceder a um mercado diversificado que, de outra forma, poderia ser difícil de explorar a partir do estrangeiro.
A importância dos dados imobiliários
No setor imobiliário, os dados são fundamentais. Informações precisas e atempadas podem fazer a diferença entre um investimento bem-sucedido e um erro dispendioso.
Para os agentes imobiliários e compradores de imóveis americanos, compreender o mercado italiano requer uma fonte de dados fiável.
O Immobiliare.it fornece isso sob a forma de listagens de imóveis, tendências de preços, informações sobre bairros e muito mais.
Os robustos filtros de pesquisa da plataforma permitem aos utilizadores restringir as suas opções com base em vários critérios, tais como localização, tipo de imóvel e gama de preços, facilitando a localização de imóveis que correspondam a objetivos de investimento específicos.
Casos de utilização dos dados imobiliários do Immobiliare.it
-
Estudo de mercado. Os agentes imobiliários americanos podem utilizar os dados para compreender melhor o mercado imobiliário italiano, identificando tendências e oportunidades que possam beneficiar os seus clientes.
-
Decisões de investimento. Os compradores de imóveis dos Estados Unidos podem utilizar a Immobiliare.it para tomar decisões de investimento informadas. Os
Os dados da plataforma podem ajudar a identificar imóveis subvalorizados, bairros em ascensão ou arrendamentos para férias lucrativos.
-
Análise comparativa. Os dados podem ser utilizados para comparar o mercado italiano com o mercado americano.
Isto é particularmente útil para investidores que pretendem diversificar o seu portfólio a nível internacional.
-
Serviços ao Cliente. Os agentes imobiliários podem oferecer serviços adicionais aos seus clientes americanos interessados no mercado italiano, tais como relatórios e análises personalizados com base nos dados do Immobiliare.it.
-
Estratégia de marketing. Ao extrair dados do Immobiliare.it, as empresas podem identificar as tendências atuais em termos de características e localizações dos imóveis, o que ajuda na formulação de uma estratégia de mercado mais eficaz.
Esta abordagem pode tornar os sites imobiliários mais competitivos no mercado.
-
Análise de preços. A extração de dados e do histórico de preços do Immobiliare.it permite uma análise abrangente dos preços.
Compreender a flutuação dos preços de mercado, os preços mais recentes e os preços atuais do mercado pode ajudar as empresas e os consumidores a tomar decisões mais informadas.
-
Informações jurídicas e regulamentares. O Immobiliare.it apresenta frequentemente artigos e recursos que explicam as leis e regulamentos imobiliários italianos, o que pode ser inestimável para investidores americanos que não estão familiarizados com o panorama jurídico italiano.
Ao tirar partido dos dados e recursos disponíveis no Immobiliare.it, os agentes imobiliários e compradores de imóveis americanos podem obter uma vantagem competitiva num mercado que é simultaneamente desafiante e gratificante.
Considerações legais
No que diz respeito à recolha de dados a partir de plataformas online, é fundamental compreender o panorama jurídico e ético para garantir que se está a agir dentro dos limites da lei e a respeitar os direitos dos titulares dos dados.
É legal fazer scraping no Immobiliare.it?
Antes de fazer scraping em qualquer site, é fundamental consultar o seu ficheiro robots.txt, que define as regras para os rastreadores da Web.
O ficheiro robots.txt do Immobiliare.it inclui várias diretivas «Disallow», indicando as áreas do site que não devem ser objeto de scraping.
Por exemplo, proíbe o scraping de mapas de pesquisa, áreas de utilizador e tipos específicos de anúncios, entre outros.
A violação destas regras pode resultar no banimento do site ou em ações judiciais.
Por conseguinte, é essencial respeitar as diretrizes estabelecidas no ficheiro robots.txt ao considerar quaisquer atividades de recolha de dados no Immobiliare.it.
Considerações éticas
Para além dos aspetos legais, as considerações éticas também entram em jogo ao extrair dados de sites.
A extração ética de dados respeita tanto a letra como o espírito da lei, bem como o ficheiro robots.txt do site, que define as áreas do site que não devem ser alvo de extração.
Além disso, a extração ética implica não sobrecarregar os servidores do site, respeitar a privacidade dos utilizadores e utilizar os dados de forma responsável.
O incumprimento destas diretrizes éticas pode prejudicar a sua reputação e também ter repercussões legais.
Perspetivas sobre a legalidade da extração de dados da Web
Aqui estão três artigos que abordam a legalidade da extração de dados da Web, juntamente com os respetivos resumos:
O Nono Circuito de Apelação dos EUA decidiu que a recolha de dados acessíveis ao público não constitui uma violação da Lei contra a Fraude e o Abuso Informático (CFAA). Esta decisão é significativa para arquivistas, académicos, investigadores e jornalistas que utilizam ferramentas de web scraping.
No entanto, o artigo também menciona que houve casos em que o web scraping suscitou preocupações em matéria de privacidade e segurança. O processo foi inicialmente interposto pelo LinkedIn contra a Hiq Labs, uma empresa que extraía perfis de utilizadores do LinkedIn. O LinkedIn perdeu o processo em 2019, e o Nono Circuito reafirmou a sua decisão original.
Este artigo afirma que não existem leis federais contra o web scraping nos Estados Unidos, desde que os dados extraídos estejam disponíveis publicamente.
No entanto, salienta a importância das considerações éticas e aconselha os praticantes de web scraping a operarem dentro dos limites dos termos de serviço e dos ficheiros robots.txt dos sites.
O artigo aborda o facto de, ao abrigo da maioria das leis, ser ilegal recolher, utilizar ou armazenar informações de identificação pessoal (PII) sem o consentimento explícito do titular.
Menciona também que o web scraping pode, por vezes, entrar em zonas cinzentas do ponto de vista jurídico, especialmente quando envolve a recolha de informações sensíveis.
Ferramentas e tecnologias utilizadas na recolha de dados
No âmbito do web scraping, existe uma variedade de ferramentas e tecnologias disponíveis para satisfazer diferentes necessidades. Quer seja um principiante ou um cientista de dados experiente, é provável que exista uma ferramenta que se adapte aos requisitos do seu projeto. Abaixo, exploramos algumas das ferramentas mais utilizadas. 
Bibliotecas Python (BeautifulSoup, Selenium)
O Python é uma linguagem popular para o web scraping e oferece várias bibliotecas para facilitar o processo:
-
BeautifulSoup: Esta é uma biblioteca Python para extrair dados de ficheiros HTML e XML. Fornece expressões típicas do Python para iterar, pesquisar e modificar a árvore de análise.
O BeautifulSoup é frequentemente utilizado para fins de web scraping, para extrair dados de páginas web, e é relativamente fácil de aprender para principiantes.
-
Selenium: Ao contrário do BeautifulSoup, que apenas extrai o código-fonte, o Selenium interage com a página web tal como um utilizador humano.
É frequentemente utilizado para a extração de dados de sites dinâmicos, onde o conteúdo é carregado através de JavaScript, e também pode ser utilizado para testes automatizados.
Ambas as bibliotecas podem ser utilizadas em conjunto, proporcionando um conjunto de ferramentas poderoso para qualquer projeto de web scraping.
Serviços de Web Scraping
Os serviços de web scraping oferecem uma alternativa prática para quem prefere não se aprofundar na programação.
Estes serviços vêm frequentemente com interfaces de utilizador intuitivas que permitem especificar quais os dados que pretende extrair, sem necessidade de escrever qualquer código.
Eles tratam de tudo, desde a extração até ao armazenamento dos dados, facilitando-lhe a tarefa de se concentrar na análise e utilização dos dados. P
Repositórios do GitHub para referência
O GitHub é um verdadeiro tesouro de recursos para o web scraping. É possível encontrar inúmeros repositórios que oferecem scripts de scraping pré-escritos, frameworks e tutoriais.
Eis alguns tipos de repositórios que poderá achar úteis:
-
Repositórios de tutoriais. Estes repositórios fornecem guias passo a passo e trechos de código para o ajudar a dar os primeiros passos na extração de dados da Web.
-
Repositórios de frameworks. Estes contêm frameworks pré-construídos, concebidos para extrair tipos específicos de sites ou dados.
-
Repositórios de projetos. Trata-se de projetos completos que demonstram tarefas de scraping mais complexas, envolvendo frequentemente vários sites ou tecnologias.
Ao estudar estes repositórios, poderá obter informações sobre as melhores práticas e técnicas avançadas para o web scraping.
Guia passo a passo
Esta secção fornece um guia abrangente sobre como recolher dados do Immobiliare.it utilizando bibliotecas Python e outras ferramentas.
Siga estes passos para configurar o seu ambiente, escrever o código e encontrar exemplos no GitHub para aprofundar os seus conhecimentos.
Configurar o ambiente
-
Instalar o Python. Se ainda não o fez, descarregue e instale o Python a partir do site oficial.
-
Instalar bibliotecas. Abra o seu terminal e instale o BeautifulSoup e o Selenium executando os seguintes comandos: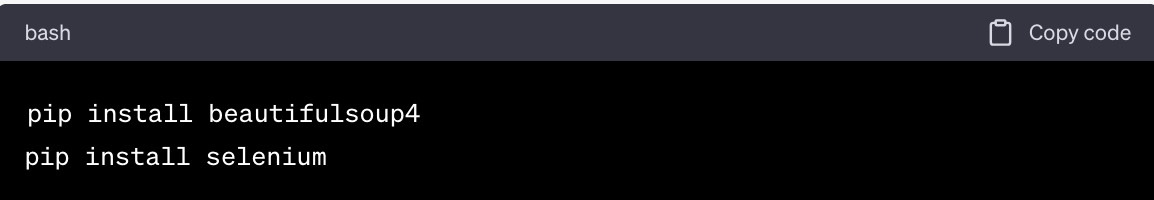
-
Web Driver. Descarregue o web driver compatível com o seu navegador (por exemplo, o ChromeDriver para o Chrome) e coloque-o no diretório do seu projeto.
-
Chave API para Geonode. Se estiver a utilizar o Scraper Pay-As-You-Go do site Geonode, registe-se para obter uma chave API no site deles.
Escrever o código para recolher dados do Immobiliare.it
-
Importar bibliotecas. Importe as bibliotecas Python necessárias no início do seu script.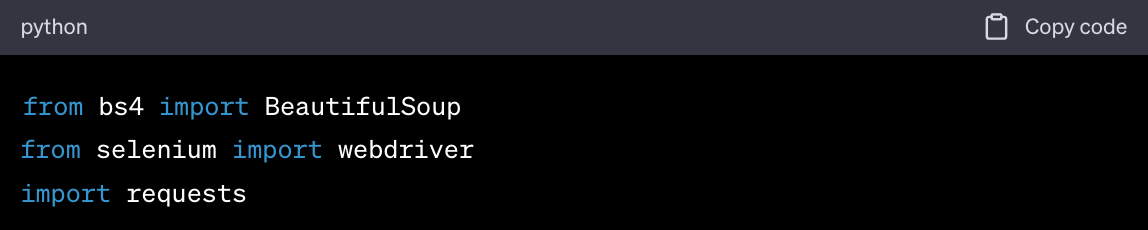
-
Inicializar o WebDriver. Inicialize o Selenium WebDriver. 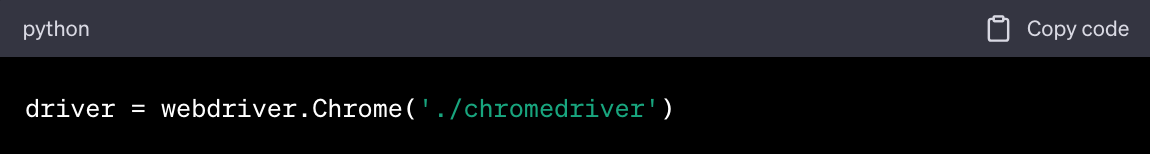
-
Navegar até ao Immobiliare.it. Utilize o WebDriver para aceder à página do Immobiliare.it que pretende extrair. 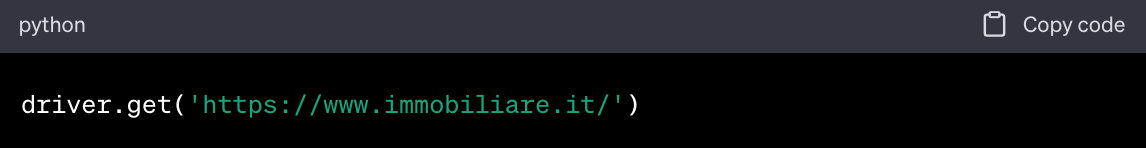
-
Localizar elementos. Utilize o BeautifulSoup ou as funções do Selenium para localizar os elementos HTML que contêm os dados que pretende extrair.
-
Extraia os dados. Extraia os dados e guarde-os numa variável ou num ficheiro.
-
API doGeonode. Se estiver a utilizar o Geonode, efetue uma chamada à API para gerir proxies, navegadores e captchas.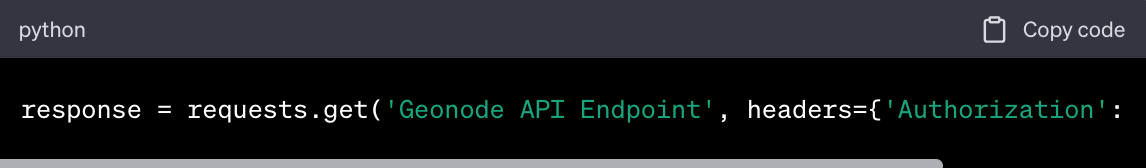
-
Feche o WebDriver. Não se esqueça de fechar o WebDriver assim que terminar.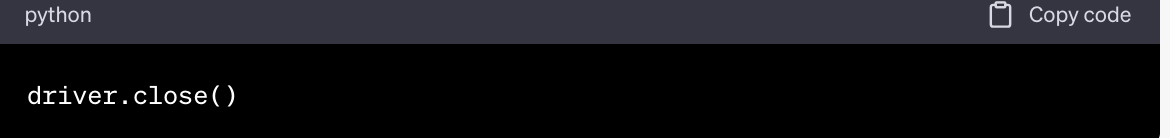
Exemplos e tutoriais no GitHub
-
Pesquise repositórios. Utilize a funcionalidade de pesquisa do GitHub para encontrar repositórios relacionados com a extração de dados da Web com Python, BeautifulSoup e Selenium.
-
Estude o código. Procure exemplos concebidos especificamente para sites imobiliários ou para o Immobiliare.it.
-
Siga os tutoriais. Alguns repositórios do GitHub oferecem tutoriais passo a passo que podem ajudá-lo a compreender melhor o código.
-
Clone e experimente. Não hesite em clonar repositórios e ajustar o código de acordo com as suas necessidades específicas.
Técnicas avançadas
À medida que se for familiarizando com as técnicas básicas de web scraping, poderá sentir a necessidade de enfrentar desafios mais complexos. Esta secção descreve algumas técnicas avançadas que o podem ajudar a lidar com estes cenários mais complicados.
Lidar com sites dinâmicos
Os sites dinâmicos carregam o conteúdo de forma assíncrona, recorrendo frequentemente ao JavaScript. Isto pode tornar o scraping mais desafiante. Aqui estão algumas técnicas avançadas para lidar com sites dinâmicos:
-
Selenium WebDriver. Conforme mencionado anteriormente, o Selenium pode interagir com páginas web dinâmicas, permitindo-lhe extrair dados carregados através de JavaScript.
-
Navegação sem interface gráfica. Utilize navegadores sem interface gráfica, como o PhantomJS, ou execute o Selenium no modo sem interface gráfica para extrair dados de sites sem abrir uma janela de navegador real.
-
Pedidos AJAX. Alguns sites carregam dados através de pedidos AJAX. Pode utilizar ferramentas de desenvolvimento para inspecionar esses pedidos e replicá-los utilizando a biblioteca requests do Python.
-
Comandos de espera. Utilize comandos de espera explícitos e implícitos no Selenium para garantir que a página web foi totalmente carregada antes de proceder à extração.
Extração de dados de agentes imobiliários
A extração de dados relacionados com agentes imobiliários pode ser um pouco mais complexa devido à necessidade de precisão e às considerações éticas envolvidas. Aqui ficam algumas dicas:
-
Focar-se em secções específicas. Utilize o BeautifulSoup ou expressões XPath para se concentrar em secções específicas de um site onde os dados dos agentes estão armazenados.
-
Paginação. Muitos sites listam agentes em várias páginas. Certifique-se de que o seu código consegue navegar pela paginação.
-
Limitação de taxa. Respeite os termos e condições do site. Implemente a limitação de taxa no seu código para evitar sobrecarregar os servidores deles.
-
Validação de dados. Valide sempre os dados que extraiu para garantir que estão corretos e completos.
Dicas do StackOverflow sobre como lidar com alterações no código
Os sites atualizam frequentemente a sua estrutura HTML, o que pode comprometer o seu código de extração. Eis como se pode adaptar:
-
Atualizações regulares: Fique atento aos tópicos do StackOverflow relacionados com o site que está a extrair. Os utilizadores partilham frequentemente atualizações sobre alterações nas estruturas dos sites.
-
Tratamento de erros: Implemente um tratamento de erros robusto no seu código para ser alertado quando a extração falhar, permitindo-lhe atualizar o seu código em conformidade.
-
Dicas da comunidade: O StackOverflow é um excelente local para encontrar soluções alternativas ou métodos alternativos de extração quando um site altera a sua estrutura de código.
Ao dominar estas técnicas avançadas, estará mais bem preparado para enfrentar uma vasta gama de desafios relacionados com a extração de dados da Web. Quer esteja a lidar com conteúdo dinâmico, dados especializados ou estruturas de sites em constante mudança, estes métodos irão dotá-lo das competências necessárias para uma recolha de dados eficaz.
Análise e Utilização de Dados
Depois de ter recolhido os dados com sucesso, o próximo passo consiste em analisá-los e utilizá-los de forma eficaz.
Esta secção irá guiá-lo ao longo do processo de análise dos dados recolhidos, construção do seu próprio modelo de preços e criação e atualização de perfis de ofertas.
Como analisar os dados recolhidos
-
Limpeza de dados. O primeiro passo em qualquer processo de análise de dados é limpar os dados. Remova quaisquer duplicados, trate os valores em falta e converta os tipos de dados, se necessário.
-
Visualização de dados. Utilize bibliotecas como o Matplotlib ou o Seaborn para visualizar os dados. Isto pode ajudá-lo a identificar tendências, valores atípicos ou padrões.
-
Análise estatística. Utilize métodos estatísticos para resumir os dados. Calcule médias, medianas, desvios-padrão, etc., para compreender melhor a distribuição dos dados.
-
Análise de texto. Se tiver recolhido dados textuais, considere a utilização de técnicas de Processamento de Linguagem Natural (NLP) para extrair insights.
-
Análise de correlação. Identifique variáveis que estejam fortemente correlacionadas entre si. Isto pode ser particularmente útil no setor imobiliário para compreender como diferentes fatores afetam os preços dos imóveis.
Desafios comuns e soluções
A extração de dados da Web não está isenta de desafios. Desde CAPTCHAs e limites de taxa até preocupações com a qualidade e fiabilidade dos dados, esta secção tem como objetivo prepará-lo para alguns dos obstáculos que poderá enfrentar e oferecer soluções para os superar.
CAPTCHAs
-
- Problema: Muitos sites utilizam CAPTCHAs para impedir o scraping automatizado.
- Solução: Pode utilizar serviços como o 2Captcha ou o Anti-Captcha para resolver CAPTCHAs automaticamente. Em alternativa, o Selenium pode ser utilizado para resolver manualmente o CAPTCHA durante o processo de extração de dados.
Limites de taxa
-
- Problema: Os sites têm frequentemente limites de taxa para restringir o número de pedidos provenientes de um único endereço IP.
- Solução: Implemente a limitação de taxa no seu código para respeitar os termos do site. Também pode utilizar serviços de proxy para alternar entre endereços IP. Os proxies residenciais da Geonode são um excelente serviço para este fim.
Dados incompletos
-
- Problema: Por vezes, os dados extraídos podem estar incompletos devido ao carregamento dinâmico ou a outros problemas.
- Solução: Utilize o Selenium para garantir que a página está totalmente carregada antes de proceder à extração. Também pode utilizar as suas funções de espera para pausar o código até que determinados elementos sejam carregados.
Dados inconsistentes
-
- Problema: A estrutura do site pode mudar ao longo do tempo, levando a dados inconsistentes.
- Solução: Atualize regularmente o seu código de extração para se adaptar a quaisquer alterações na estrutura do site. Implemente um tratamento de erros robusto para o alertar quando a extração falhar.
Validação de dados
-
- Problema: Os dados extraídos podem conter erros ou imprecisões.
- Solução: Valide sempre os seus dados comparando-os com várias fontes ou utilize somas de verificação para garantir a integridade dos dados.
Questões legais e éticas
-
- Problema: A recolha de dados pode, por vezes, violar os termos de serviço do site.
- Solução: Leia sempre e cumpra os termos de serviço do site e o ficheiro robots.txt. Respeite as regras e políticas do site.
Ao estar ciente destes desafios comuns e das respetivas soluções, estará melhor preparado para lidar com quaisquer problemas que surjam durante os seus esforços de web scraping.
Perguntas frequentes
Como posso extrair dados de sites imobiliários sem programar?
Pode utilizar ferramentas de extração de dados da Web que não requerem programação, como o WebHarvy, o Octoparse ou o Import.io. Estas ferramentas oferecem interfaces intuitivas para a extração de dados através de «apontar e clicar».
Quais são as melhores bibliotecas Python para a extração de dados da Web?
As bibliotecas Python mais utilizadas para a extração de dados da Web são a BeautifulSoup, para analisar HTML e XML, e o Selenium, para interagir com sites que utilizam muito JavaScript. O Scrapy é outra opção para projetos mais complexos.
O web scraping é legal?
A legalidade do web scraping depende dos termos de serviço do site e da forma como utiliza os dados. Consulte sempre os termos e condições do site e considere procurar aconselhamento jurídico para garantir a conformidade.
Recursos adicionais
Depois de percorrer os vários aspetos do web scraping, desde a configuração do ambiente até à superação de desafios, é altura de concluir e analisar o que se segue.
Documentação oficial. É sempre um bom ponto de partida. O BeautifulSoup, o Selenium e outras bibliotecas dispõem de documentação extensa para o ajudar a compreender melhor as suas funcionalidades.
Cursos online. Sites como o Udemy, o Coursera e o edX oferecem cursos sobre web scraping e análise de dados.
Tutoriais no YouTube. Existem inúmeros tutoriais disponíveis que abrangem tudo, desde os conceitos básicos até às técnicas avançadas.
Fóruns e comunidades. Sites como o StackOverflow e o Reddit têm comunidades ativas onde pode fazer perguntas e partilhar conhecimentos.
Livros. Existem também vários livros disponíveis que se centram no web scraping e nas técnicas de recolha de dados.
Conclusão
Agora que já dispõe dos conhecimentos e das ferramentas necessárias para uma extração eficaz de dados da Web, está na hora de os colocar em prática.
Comece por pequenos projetos, experimente e não hesite em aventurar-se em projetos mais complexos à medida que for ganhando confiança.
Lembre-se de que a chave para o sucesso na extração de dados da Web não é apenas recolher dados, mas transformá-los em insights úteis.

