A Media.net é uma empresa líder em tecnologia publicitária que oferece uma vasta gama de soluções para editores, anunciantes e agências. 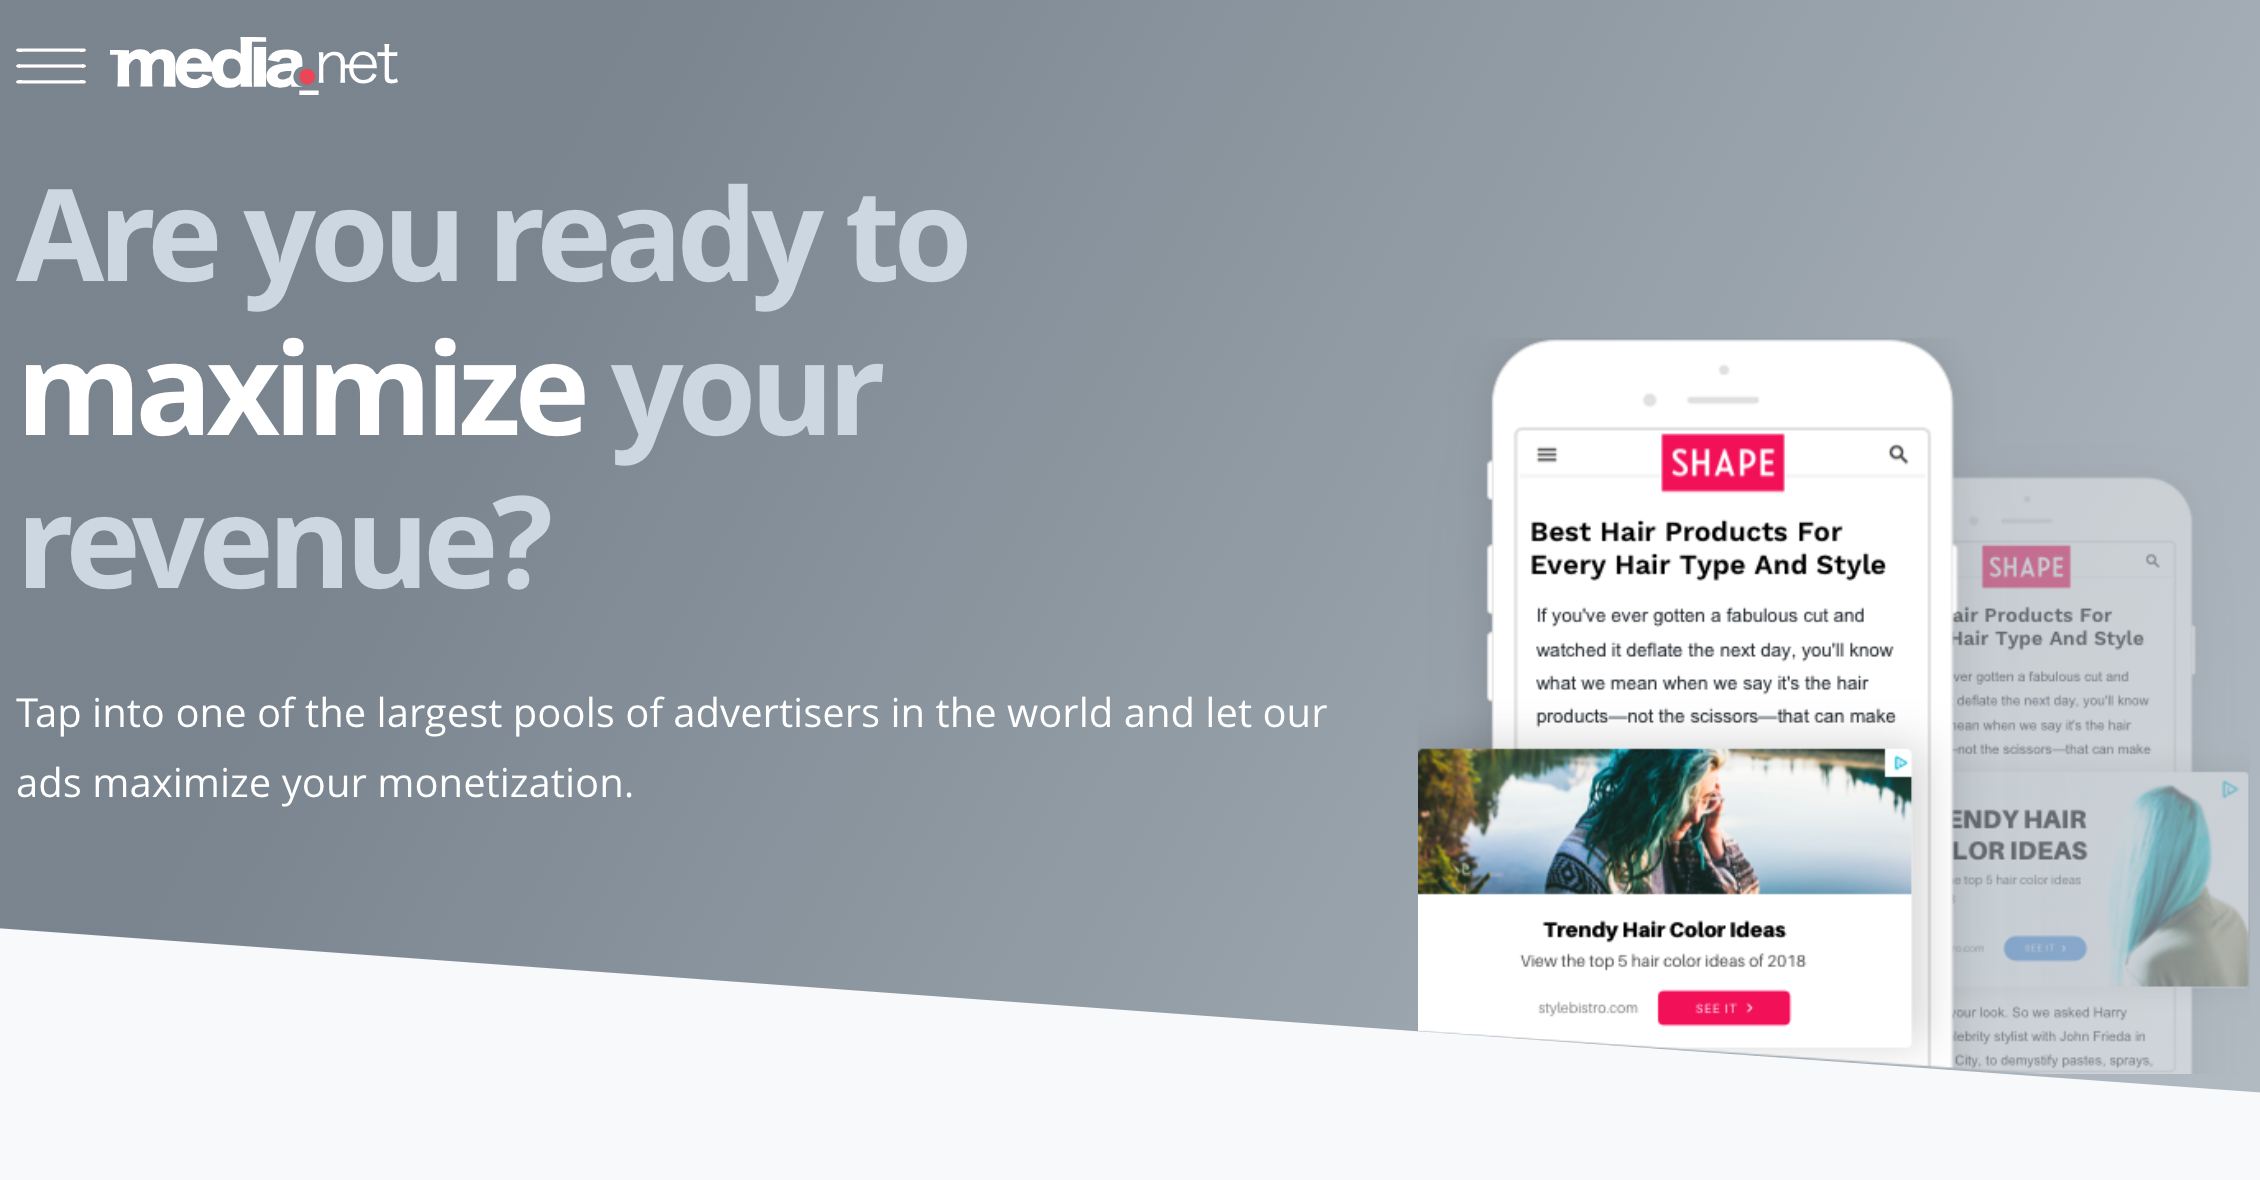
Com foco na publicidade contextual, a Media.net consolidou-se como um interveniente fundamental no ecossistema da publicidade digital.
Fornece uma plataforma que permite a monetização do conteúdo de websites através de anúncios altamente relevantes, criando assim uma situação vantajosa tanto para os editores como para os anunciantes.
Por que extrair dados do Media.net?
Maximização das receitas
A recolha de dados da Media.net permite que editores e anunciantes compreendam os tipos de anúncios e os modelos de preços disponíveis, ajudando na formulação de estratégias de marketing e planos de negócios mais eficazes para a maximização das receitas.
Inteligência competitiva
A Media.net é líder global no setor da tecnologia publicitária. A recolha de dados desta plataforma oferece inteligência competitiva que pode ser crucial para compreender as tendências do mercado e definir a sua estratégia de negócio.
Métricas de envolvimento
A Media.net dá prioridade à experiência do utilizador, oferecendo anúncios nativos personalizados. A análise de métricas de envolvimento, tais como as taxas de envolvimento de utilizadores reais, pode ajudar a otimizar as suas próprias estratégias de envolvimento do utilizador.
Perspetivas tecnológicas
A Media.net utiliza tecnologias de ponta, como o header bidding entre formatos. Compreender estas tecnologias pode proporcionar-lhe uma vantagem competitiva na utilização de tecnologias semelhantes.
Conformidade legal e ética
É essencial cumprir os termos de serviço e as políticas de qualidade da Media.net. A recolha de dados deve ser realizada de forma a respeitar estas diretrizes, para garantir práticas éticas.
Casos de utilização do scraping da Media.net
Análise da concorrência
A extração de dados do Media.net fornece informações sobre as suas ofertas publicitárias, modelos de preços e posicionamento no mercado. Esta informação competitiva é inestimável para as empresas que pretendem compreender a sua posição no setor.
Estudo de mercado
Os dados do Media.net podem revelar tendências de mercado e preferências dos consumidores, ajudando as empresas a criar um perfil de cliente ideal e a adaptar as suas ofertas em conformidade.
Estratégias de Preços
A extração de dados de preços da Media.net pode servir de base para estratégias de preços mais competitivas, proporcionando uma compreensão clara das tarifas de mercado para vários tipos de anúncios.
Análise de Sentimento
Se disponíveis, as avaliações ou comentários dos utilizadores na Media.net podem oferecer informações sobre o sentimento do mercado e a satisfação dos clientes. Estes dados podem orientar tanto a Media.net como os seus concorrentes na identificação de áreas a melhorar ou no aproveitamento dos pontos fortes.
Ao incorporar a recolha de dados nas suas operações empresariais, pode otimizar todo o processo de obtenção de informações úteis para a tomada de decisões estratégicas.
Considerações legais e éticas
Navegar pelo panorama jurídico e ético do processo de recolha de dados é crucial para quem pretende recolher dados da Media.net.
Embora a extração de dados da Web possa oferecer informações inestimáveis, é importante abordá-la de forma responsável para evitar quaisquer repercussões legais.
Respeitar o ficheiro robots.txt
O ficheiro robots.txt é um padrão utilizado pelos sites para orientar os bots de rastreamento e extração de dados sobre quais as páginas que podem ou não ser recuperadas.
Antes de iniciar qualquer projeto de extração de dados na Media.net, é imperativo consultar o ficheiro robots.txt do site.
Este ficheiro indica as áreas do site que estão fora dos limites e aquelas que podem ser acedidas para a extração de dados.
Ignorar as diretivas deste ficheiro pode não só levar ao bloqueio do seu endereço IP, como também expô-lo a riscos legais.
Compreender os Termos de Serviço do Media.net
Os Termos de Serviço (ToS) do Media.net constituem um acordo legal que define as regras, os termos e as diretrizes para a utilização da sua plataforma.
É fundamental ler e compreender estes termos antes de começar a extrair dados do site.
A violação dos TOS pode resultar numa série de consequências, desde a suspensão temporária da sua conta até a instauração de uma ação judicial.
Procure secções nos TOS que abordem especificamente a extração de dados ou o acesso automatizado à plataforma.
Se os TOS proibirem explicitamente a extração de dados da Web, terá de obter autorização por escrito da Media.net para prosseguir.
Diretrizes éticas para a extração de dados da Web
Para além das considerações legais, o comportamento ético é fundamental ao extrair dados de qualquer site, incluindo o Media.net. Aqui estão algumas diretrizes éticas a ter em conta:
Minimizar a carga no servidor
Certifique-se de que as suas atividades de extração de dados não sobrecarregam nem perturbam os serviços do Media.net.
Utilize a limitação de taxa e efetue pedidos com uma frequência que imite o comportamento de navegação humana.
Utilização de dados
Seja transparente quanto às suas intenções relativamente à utilização dos dados extraídos. Se os dados forem publicados ou utilizados para fins comerciais, solicite autorização à Media.net.
Privacidade do utilizador
Se estiver a extrair conteúdo gerado por utilizadores, tenha cuidado para não recolher quaisquer informações pessoais, a menos que seja absolutamente necessário para o seu projeto.
Se forem recolhidos dados pessoais, estes devem ser anonimizados e armazenados de forma segura.
Atribuição
Se pretender publicar os dados ou quaisquer conclusões deles derivadas, indique devidamente a Media.net como fonte dos dados.
Ao respeitar estas diretrizes legais e éticas, poderá realizar as suas atividades de web scraping de forma responsável e respeitosa. Isto não só minimiza os riscos, como também contribui para a integridade e credibilidade da sua análise de dados ou do seu projeto de inteligência empresarial.
Ferramentas e tecnologias
O sucesso de um projeto de web scraping depende frequentemente das ferramentas e tecnologias utilizadas.
Ao tirar partido destas ferramentas e tecnologias, pode criar um fluxo de trabalho robusto de web scraping para recolher dados do Media.net.
Quer seja um principiante ou um especialista, a combinação certa destes recursos pode melhorar significativamente a eficiência e a eficácia dos seus esforços de web scraping.
Linguagens de programação
Python
O Python é uma linguagem versátil amplamente utilizada para web scraping devido à sua facilidade de utilização e às suas extensas bibliotecas.
Permite o desenvolvimento e a implementação rápidos de scripts de web scraping, tornando-a ideal tanto para principiantes como para especialistas com muita experiência em programação.
JavaScript
O JavaScript, particularmente o Node.js, é outra linguagem poderosa para o web scraping.
É especialmente útil ao lidar com sites que dependem fortemente do JavaScript para carregar conteúdos, uma vez que pode interagir diretamente com o DOM (Document Object Model).
Bibliotecas e Frameworks
BeautifulSoup
O BeautifulSoup é uma biblioteca Python excelente para principiantes em web scraping.
Permite uma navegação e manipulação fáceis de documentos HTML e XML, tornando a extração de dados simples.
Scrapy
O Scrapy é um framework Python mais avançado, concebido para web scraping e crawling.
Oferece suporte integrado para lidar com vários formatos de dados e exportar dados extraídos, tornando-o adequado para projetos em grande escala.
Selenium
O Selenium é frequentemente utilizado para extrair dados de sites com grande quantidade de JavaScript. Automatiza a interação com o navegador, permitindo-lhe extrair dados que são carregados dinamicamente.
Serviços de proxy
Importância da utilização de proxies para a extração de dados
A utilização de proxies é crucial para a extração de dados em grande escala, a fim de evitar a deteção e o bloqueio de IP. Os proxies também permitem a extração de dados com segmentação geográfica, o que pode ser essencial para a recolha de dados específicos de uma localização.
Proxies Geonode
Os proxies Geonode oferecem uma camada de anonimato e segurança, tornando-os ideais para projetos de extração de dados da Web.
Ajudam a contornar bloqueios de IP e limites de taxa impostos por sites como o Media.net.
Integrar os proxies Geonode no seu código de extração
A configuração dos proxies Geonode envolve a criação de uma conta e, em seguida, a sua integração no seu código.
A maioria das linguagens de programação e bibliotecas de scraping oferece formas simples de definir as configurações de proxy.
Por exemplo, em Python, pode utilizar a biblioteca Requests para integrar facilmente os proxies Geonode.
Extensões de navegador
Web Scraper
O Web Scraper é uma extensão de navegador que permite a extração de dados da Web de forma simples, bastando apontar e clicar.
É excelente para projetos de pequena escala e para quem está a dar os primeiros passos na extração de dados da Web.
Data Miner
O Data Miner é outra extensão de navegador que oferece «receitas» pré-definidas para a extração de dados.
É útil para extrair dados de sites sem escrever qualquer código, embora possa não ser adequado para necessidades de extração mais complexas.
Configurar o ambiente
Antes de avançarmos para o processo propriamente dito de web scraping, é fundamental configurar um ambiente de desenvolvimento adequado.
Isto envolve a instalação de software e bibliotecas essenciais que serão utilizados ao longo do projeto.
Instalação do Python e do pip
-
Descarregue o Python. Visite o site oficial do Python e descarregue a versão mais recente adequada ao seu sistema operativo.
-
Instalação. Execute o programa de instalação e siga as instruções no ecrã. Certifique-se de que marca a caixa que diz «Adicionar Python ao PATH» durante a instalação.
-
Verificar a instalação. Abra a linha de comandos ou o terminal e escreva python--version para se certificar de que o Python foi instalado corretamente.
-
Instalar o pip. O pip (Package Installer for Python) geralmente vem pré-instalado com o Python.
Pode verificar a sua instalação digitando pip --version no prompt de comandos ou no terminal.
Configurar um editor de código
- Descarregue o Visual Studio Code. Visite o site do Visual Studio Code e descarregue a versão compatível com o seu sistema operativo.
- Instalação. Execute o instalador e siga as instruções de configuração.
- Extensões. Depois de instalado, pode adicionar extensões como Python, Beautify e IntelliSense para melhorar a sua experiência de programação.
Instalação das bibliotecas e frameworks necessários
Abra o seu terminal e instale as seguintes bibliotecas Python:
- BeautifulSoup:
pip install beautifulsoup4
- Scrapy:
pip install scrapy
- Selenium:
pip install selenium
Identificação de pontos de dados
Navegar pelo site da Media.net
Antes de escrever qualquer código, dedique algum tempo a navegar pelo site da Media.net para compreender a sua estrutura e identificar os pontos de dados que pretende extrair.
Compreender a estrutura do site da Media.net
O site da Media.net funciona como uma plataforma de publicidade contextual e soluções programáticas. Destina-se tanto a anunciantes como a editores, oferecendo uma variedade de serviços para maximizar as receitas. O site está organizado em várias secções principais, incluindo:
- Página inicial. Introdução à Media.net e aos seus serviços.
- Marketplace. Informações sobre a procura competitiva proveniente de várias fontes para maximizar o rendimento.
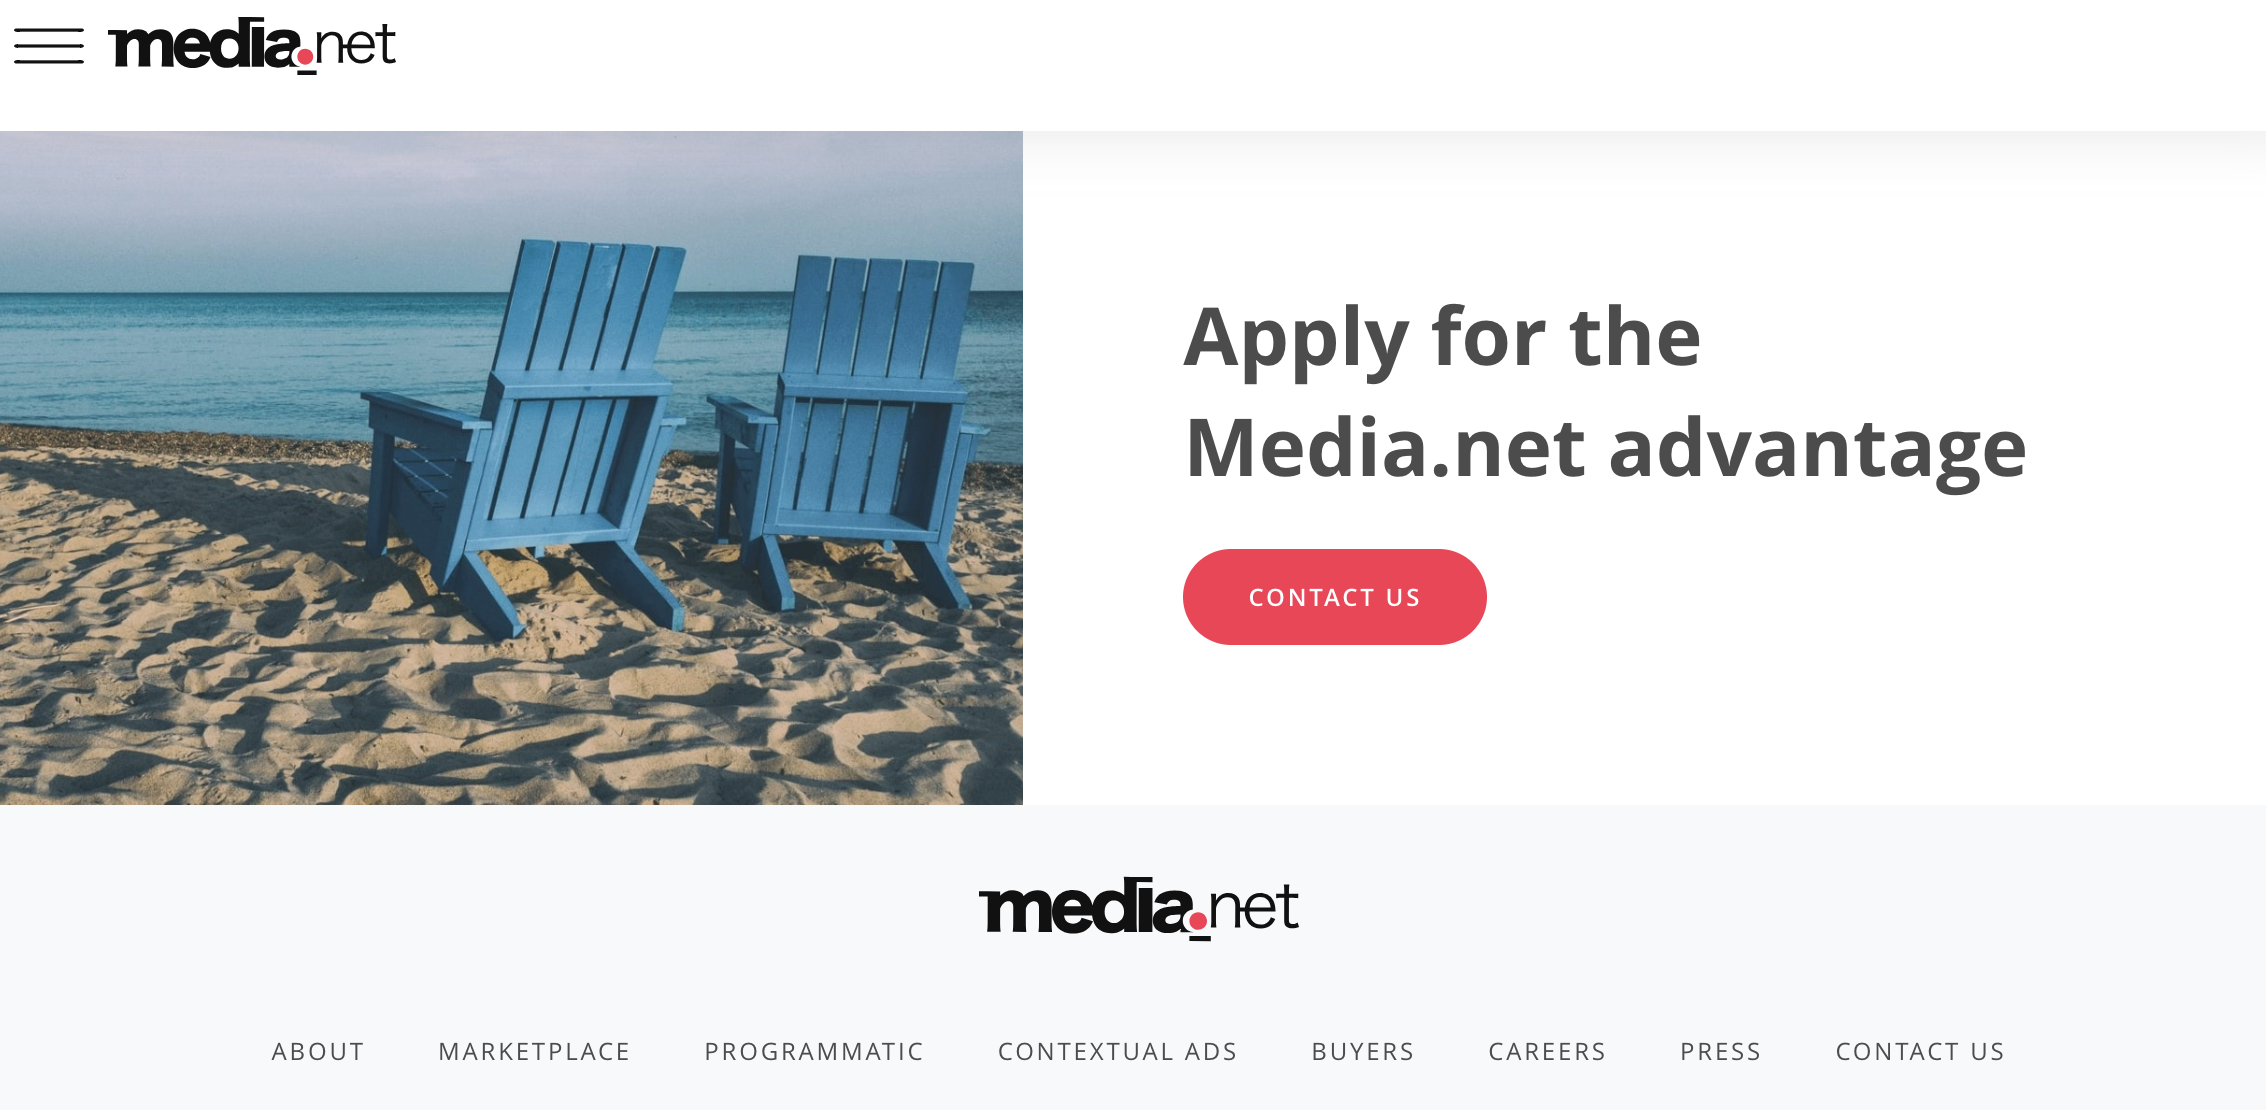
- Anúncios contextuais. Detalhes sobre o formato de anúncio exclusivo da Media.net que aproveita palavras-chave de pesquisa para publicidade direcionada.
- Programática. Informações sobre a sua plataforma de header bidding de última geração, compatível com vários formatos.
- Compradores. Uma secção provavelmente dedicada a potenciais anunciantes.
- Sobre. Informações gerais sobre a Media.net.
- Iniciar sessão. Para que os utilizadores existentes iniciem sessão nas suas contas.
- Contacte-nos. Para questões e apoio.
O site também fornece informações adicionais sobre anúncios de display e anúncios nativos, explicando como estes podem beneficiar os editores.
Identificar os dados-chave a extrair
Determine quais os dados específicos que pretende extrair da Media.net. Estes podem variar desde os tipos de anúncios oferecidos e modelos de preços até publicações em blogs e artigos. Faça uma lista destes pontos de dados, uma vez que irão orientar a sua lógica de extração.
Escrever o código
Depois de configurar o seu ambiente e de identificar os pontos de dados que pretende extrair, o próximo passo é escrever o código.
A extração de dados da Web pode ser feita manualmente ou através de métodos automatizados. A seguir, exploraremos ambas as abordagens e forneceremos exemplos de trechos de código para cada uma.
Extração manual
Passos e limitações
A extração manual envolve navegar pelo site e copiar os dados manualmente para uma folha de cálculo ou um meio de armazenamento semelhante.
Embora este método seja simples, é demorado e pouco prático para conjuntos de dados de grande dimensão.
Extragir dados de forma automatizada
A extração automatizada é a forma mais eficiente de recolher dados, especialmente para projetos de grande escala. Vamos ver como extrair dados utilizando o BeautifulSoup, o Scrapy e o Selenium.
Utilizar o BeautifulSoup
Exemplos de trechos de código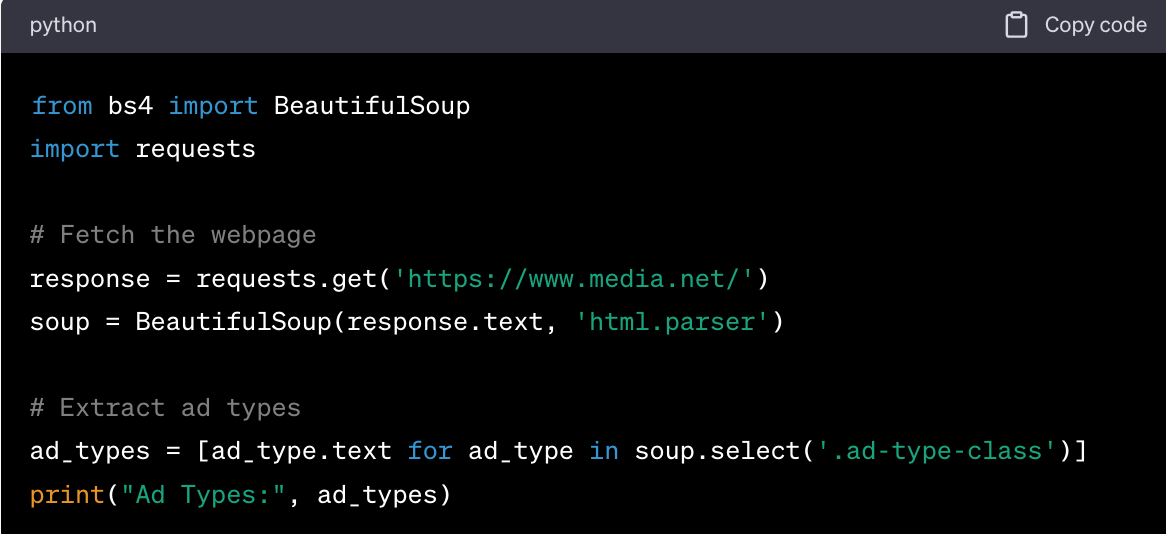
Explicação do código
- Importar a biblioteca BeautifulSoup e o módulo requests.
- Recolher o conteúdo da página web utilizando
requests.get().
- Analisar o conteúdo HTML utilizando o BeautifulSoup.
- Extrair os tipos de anúncios utilizando o método
.select(), visando a classe específica que contém esta informação.
Utilização do Scrapy
Exemplos de trechos de código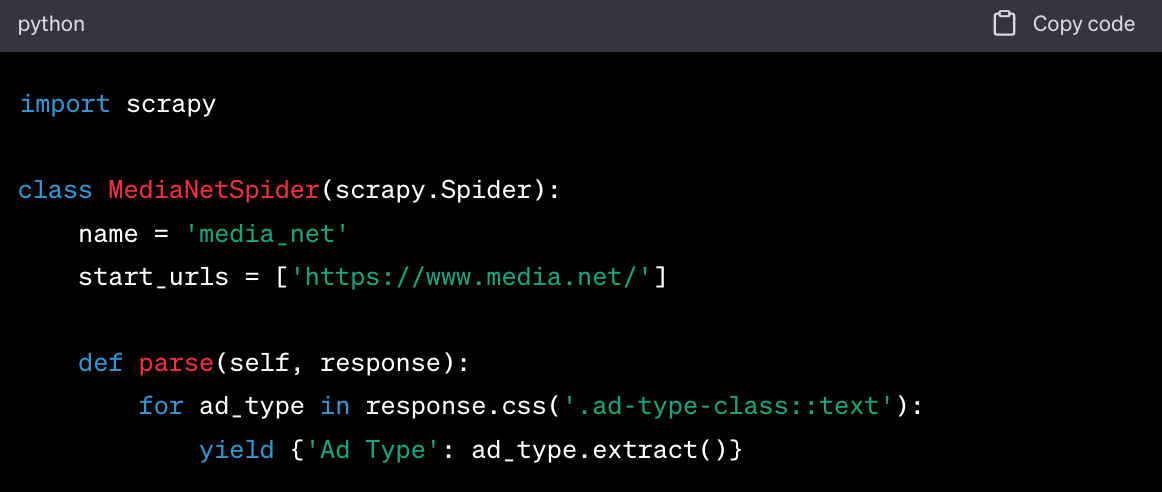
Explicação do código
- Importar a biblioteca Scrapy.
- Defina uma classe «spider» que herde d
scrapy.Spider.
- Especifique o URL a rastrear em
start_urls.
- Defina o método «
parse» para extrair os tipos de anúncios utilizando o método «.css()».
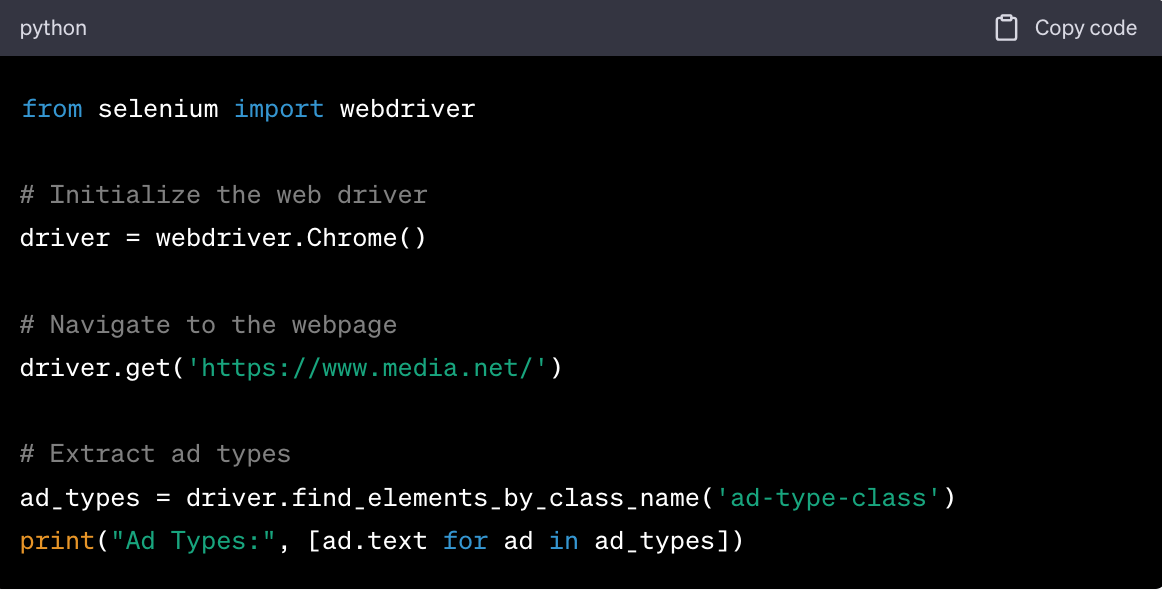
Utilizando o Selenium
Exemplos de trechos de código
CSV
Pode utilizar a biblioteca csv, integrada no Python, para armazenar os dados extraídos num ficheiro CSV.
Base de dados
Para projetos mais complexos, é aconselhável armazenar os dados numa base de dados como o MySQL ou o MongoDB.
Seguindo estes passos e utilizando estes excertos de código como guia, pode criar um fluxo de trabalho robusto de extração de dados da Web para recolher dados do Media.net.
Utilização de extratores de dados criados por si
Os extratores de dados da Web criados por si oferecem um maior grau de personalização e controlo sobre os dados que recolhe.
Com conhecimentos de programação, pode escrever linhas de código específicas para visar elementos únicos no site da Media.net, permitindo uma recolha de dados mais detalhada.
Os modelos de scrapers personalizados são ideais para quem tem necessidades específicas de dados que as ferramentas genéricas de scraping podem não ser capazes de satisfazer.
Utilização de serviços de extração de dados
Os serviços de extração de dados vêm frequentemente com APIs de scrapers pré-construídas e ferramentas concebidas para a extração aprofundada de conteúdos da Web.
Os serviços de scraping conseguem lidar com cenários complexos de extração de dados sem que seja necessário escrever linhas de código.
São particularmente úteis para empresas que não possuem conhecimentos de programação, mas que, mesmo assim, pretendem recolher informações valiosas de plataformas como a Media.net.
Resolução de problemas e perguntas frequentes
O web scraping é uma ferramenta poderosa, mas apresenta os seus próprios desafios.
Erros comuns e soluções
IP bloqueado
Solução: Utilizar proxies é uma boa forma de evitar que o seu IP seja bloqueado. O site
Geonode oferece uma variedade de serviços de proxy que podem ajudá-lo a extrair dados de forma anónima, reduzindo assim as hipóteses de o seu IP ser bloqueado.
Limite de taxa excedido
Solução: Implemente um limite de taxa no seu código para controlar a frequência dos seus pedidos.
Também pode utilizar os proxies do Geonode para alternar entre endereços IP, o que pode ajudá-lo a evitar atingir os limites de taxa.
Dados incompletos ou imprecisos
Solução: Isto acontece normalmente quando a estrutura do site muda.
Certifique-se sempre de atualizar o seu código de acordo com o layout mais recente do site.
Erros de tempo limite
Solução: Aumente o limite de tempo no seu código.
Além disso, considere utilizar proxies Geonode para uma conectividade mais fiável.
As pessoas também perguntam
Como fazer scraping do Media.net sem ser bloqueado?
A utilização de proxies Geonode pode ajudá-lo a fazer scraping do Media.net sem ser bloqueado.
Estes proxies ocultam o seu endereço IP, dificultando que os sites detetem a atividade de scraping.
É legal fazer scraping no Media.net?
Consulte sempre os Termos de Serviço do Media.net para compreender a sua política em relação ao scraping na Web. Geralmente, se a política de «robots.txt» de um site o permitir e não estiver a violar quaisquer termos, é normalmente permitido.
Como posso extrair dados do Media.net mais rapidamente?
Utilizar uma biblioteca mais eficiente, como o Scrapy, pode acelerar o processo de extração de dados.
Além disso, os proxies Geonode podem proporcionar ligações mais rápidas.
Quais são as melhores bibliotecas para fazer scraping do Media.net?
BeautifulSoup, Scrapy e Selenium são bibliotecas frequentemente utilizadas para o scraping da Web, cada uma com o seu próprio conjunto de vantagens.
Como é que os proxies dGeonode. melhoram a extração de dados da Web?
Os proxies dGeonode oferecem rotação de IP, proxies de centros de dados de alta velocidade e proxies residenciais, tornando-os ideais para a extração de dados da Web.
Ajudam a contornar bloqueios de IP e limites de taxa, melhorando assim a eficiência das suas tarefas de extração de dados da Web.
Melhores práticas
Limitação de taxa
Implemente sempre a limitação de taxa no seu código para evitar sobrecarregar o servidor. Isto não é apenas uma questão de cortesia, mas também ajuda a evitar que seja bloqueado.
Rotação de IP
Utilize os proxies dGeonode para a rotação de IP. Isto permite-lhe efetuar pedidos através de diferentes endereços IP, reduzindo a probabilidade de ser bloqueado.
Armazenamento e utilização de dados
Armazene os dados extraídos num formato estruturado, como CSV ou uma base de dados. Respeite sempre os termos de utilização dos dados, especialmente se pretender publicá-los.
Atribuição
Se estiver a utilizar os dados para investigação ou elaboração de relatórios, indique sempre a Media.net como fonte dos dados.
Ao seguir estas melhores práticas e dicas de resolução de problemas, poderá tornar o seu projeto de web scraping mais eficaz e menos suscetível a problemas comuns.
Conclusão
O web scraping é uma ferramenta inestimável para a recolha de dados da Media.net, oferecendo informações que podem ser fundamentais para várias aplicações empresariais, tais como a análise da concorrência, a investigação de mercado e as estratégias de preços.
Ao longo deste artigo, abordámos os passos essenciais para configurar o seu ambiente de scraping, escrever o código e resolver problemas comuns.
Também salientámos a importância de respeitar as diretrizes legais e éticas, com uma menção especial à forma como os proxies Geonode podem melhorar os seus esforços de scraping, proporcionando anonimato e contornando os limites de taxa.
Próximos passos
Limpeza e análise de dados
Depois de ter extraído os dados com sucesso, o próximo passo é limpá-los e analisá-los. A limpeza de dados envolve a remoção de duplicados, o tratamento de valores em falta e a conversão de tipos de dados.
Após a limpeza, pode avançar para a análise dos dados utilizando métodos estatísticos, a fim de obter insights úteis.
Implementação estratégica
Os insights obtidos a partir dos dados podem ser implementados estrategicamente no seu negócio.
Quer se trate de ajustar os seus modelos de preços ou de identificar novas oportunidades de mercado, os dados que recolheu podem servir como um recurso valioso para a tomada de decisões.
Monitorização e atualização
A extração de dados da Web não é uma atividade pontual. Os sites atualizam regularmente o seu conteúdo e estrutura, pelo que é essencial manter o seu código de extração atualizado.
Monitorizar o seu processo de extração irá ajudá-lo a identificar e resolver rapidamente quaisquer problemas que surjam.
Recursos adicionais
Tutoriais
- Web scraping com Python: um guia completo
- Como utilizar proxies para web scraping
Documentação
- Documentação do BeautifulSoup
- Documentação do Scrapy
- Serviços de proxy do Geonode
Fóruns de apoio da comunidade
- Stack Overflow
- Comunidade de Web Scraping do Reddit
- Fórum da Comunidade Geonode
Ao seguir as orientações e as melhores práticas descritas neste artigo, estará no bom caminho para se tornar um especialista em web scraping. Os dados que recolher da Media.net podem oferecer-lhe uma vantagem competitiva, desde que os utilize de forma responsável e ética.

