Benefícios da extração de dados do Walmart
O Walmart, um dos maiores retalhistas, opera uma rede de hipermercados, lojas de departamento com descontos e mercearias. Possui uma vasta presença online com milhões de produtos que vão desde produtos alimentares, vestuário, artigos para o lar, eletrónica e muito mais — o que torna o Walmart uma fonte de dados incrivelmente valiosa para a extração de dados da Web.
A extração de dados do Walmart pode servir a uma variedade de fins, particularmente para empresas e investigadores. Aqui estão algumas aplicações práticas da extração de dados do Walmart:
• Estudo de mercado. A vasta oferta de produtos do Walmart proporciona uma visão abrangente do mercado em inúmeras categorias. Ao extrair estes dados, pode obter informações sobre tendências de produtos, preferências dos consumidores e estratégias de preços.
• Análise da concorrência. Os dados extraídos do Walmart podem ser utilizados para compreender quais os produtos que estão a ser vendidos, a que preço e como estão a ser comercializados. Esta informação pode ajudá-lo a posicionar os seus próprios produtos de forma competitiva.
• Monitorização de preços. Pode utilizar os dados extraídos para monitorizar os preços dos produtos do Walmart em tempo real, para que possa ajustar os seus próprios preços em conformidade e manter-se competitivo.
• Otimização do sortido de produtos. Ao analisar a gama de produtos oferecida pelo Walmart, pode otimizar o seu próprio sortido de produtos para melhor satisfazer a procura dos consumidores.
• Análise de opinião. As avaliações e classificações no site do Walmart fornecem uma grande quantidade de informação sobre a opinião dos consumidores em relação aos produtos. Pode utilizar estes dados para melhorar a qualidade dos produtos e o serviço ao cliente
Extração de dados do Walmart sem esforço com o Geonode
A API de extração de dados do
Geonode
é uma ferramenta poderosa e intuitiva, concebida para simplificar as tarefas de extração de dados da Web. Com um conjunto de funcionalidades essenciais, permite aos utilizadores extrair eficientemente grandes quantidades de dados de sites como o Walmart, sem necessidade de escrever linhas de código complexas.
Algumas das suas funcionalidades mais destacadas incluem:
• Modo de depuração. Oferece informações detalhadas num formato de resposta JSON, ajudando os utilizadores a compreender como os sites lidam com os pedidos de extração de dados e poupando tempo e recursos.
• Renderização JavaScript. Facilita a extração de dados de aplicações de página única com captura dinâmica de elementos, garantindo uma extração de dados abrangente.
• Execução de trechos de código JS personalizados. Permite que os programadores interajam com formulários, botões e outros elementos gerados por JavaScript, para um maior controlo sobre o processo de extração de dados.
• Proxies rotativos. Utiliza um vasto conjunto de proxies para evitar bloqueios de IP e contornar restrições geográficas, aumentando a fiabilidade da recuperação de dados.
• Segmentação geográfica. Garante o acesso a mais sites sem ser detetado como um scraper.
• API de capturas de ecrã. Permite a captura fácil de capturas de ecrã de páginas web para fins de teste, resolução de problemas e documentação.
• Preços por GB. Oferece preços económicos e controlo sobre as despesas com o scraper.
• Formatos de resposta. Oferece flexibilidade na escolha entre os formatos HTML ou JSON para utilização em aplicações integradas.
• Recolha de dados a partir de respostas HTTP. Recolhe sem esforço dados específicos, tais como respostas JSON, para extrair a informação necessária.
• Modo de scraping. Oferece vários modos de scraping para um desempenho e eficiência ótimos, adaptados às diferentes necessidades de scraping.
Como extrair dados do Walmart com o Geonode
Compreender a estrutura do site do Walmart
O Walmart é um dos maiores retalhistas do mundo; o seu site é uma ampla plataforma de comércio eletrónico com um layout bem estruturado e organizado, que apresenta milhares de milhões de páginas de produtos. Compreender a sua estrutura é fundamental para uma extração de dados eficiente e eficaz. Eis uma visão geral básica de como os dados estão organizados no site do Walmart:
• Página inicial. A página inicial fornece uma visão geral do que o Walmart oferece. Contém várias categorias de produtos, ofertas promocionais e muito mais.
• Páginas de categorias. Ao clicar numa categoria a partir da página inicial ou do menu de navegação, é redirecionado para uma página de categoria. Estas páginas apresentam produtos de uma categoria específica, como Eletrónica, Vestuário ou Artigos para o Lar. Cada página de categoria possui várias subcategorias para tipos de produtos mais específicos.
• Listas de produtos. Cada página de categoria ou subcategoria contém uma lista de produtos. Cada lista de produtos inclui informações básicas, tais como o nome do produto, o preço, a imagem e a avaliação dos clientes.
• Páginas de produtos. Ao clicar num produto da lista, é redirecionado para a página individual do produto. Estas páginas contêm informações detalhadas sobre o produto, incluindo uma descrição mais pormenorizada, atributos do produto, imagens adicionais, avaliações dos clientes e, frequentemente, uma lista de produtos relacionados.
• Funcionalidade de pesquisa. O site também dispõe de uma barra de pesquisa que permite aos utilizadores procurar produtos específicos. Os resultados da pesquisa são apresentados num formato semelhante ao das listas de produtos nas páginas de categorias.
Ao extrair dados do site do Walmart, é importante ter em conta que os dados se encontram principalmente nestas áreas. As páginas de produtos, em particular, são provavelmente as mais valiosas, uma vez que contêm as informações mais detalhadas.
No entanto, o site do Walmart é dinâmico; alguns conteúdos são carregados através de JavaScript após o carregamento da página HTML inicial, o que pode tornar a extração de dados mais desafiante. Felizmente, a API de extração de dados do Geonode consegue lidar com a renderização de JavaScript e evitar este problema.
Identificação dos principais dados a extrair
Ao extrair dados de um site de comércio eletrónico como o do Walmart, os principais dados que poderá querer extrair dependerão dos requisitos específicos do seu projeto. Aqui estão alguns dados comuns que costumam ser valiosos:
• Nome do produto. O título do produto é uma das informações mais básicas, mas também cruciais. Ajuda a identificar a variedade de produtos que o site apresenta.
• Preço. O preço do produto é outro ponto de dados essencial. Os preços da concorrência podem ser utilizados para comparar preços, acompanhar alterações de preços ao longo do tempo ou identificar tendências de preços.
• Imagens. As imagens fornecem uma representação visual do produto. Podem ser úteis para vários fins, tais como tarefas de reconhecimento de imagens ou para fornecer elementos visuais num catálogo de produtos.
• Descrição. A descrição do produto fornece informações detalhadas sobre o mesmo, incluindo as suas características, especificações e outros detalhes relevantes.
• Avaliações e classificações do produto. As avaliações e classificações dão uma ideia da satisfação do cliente e da qualidade do produto. Podem ser utilizadas para análise de sentimento ou para avaliar a opinião pública sobre um produto.
• Categoria do produto. A categoria ou subcategoria do produto pode fornecer contexto sobre que tipo de produto é e onde se enquadra na gama mais ampla de produtos.
• SKU ou ID do produto. O SKU ou ID é um identificador único para cada produto. Isto pode ser útil para rastrear produtos específicos.
• Estado de disponibilidade. Informações sobre se o produto está em stock, esgotado ou disponível para pré-encomenda podem ser valiosas para a análise da cadeia de abastecimento ou para estudos de mercado.
• Informações de envio. Detalhes sobre as opções e custos de envio podem ser importantes para compreender o custo total de um produto.
• Informações do vendedor. Se o produto for vendido por um vendedor terceiro, as informações sobre o vendedor podem ser relevantes.
Configurar o ambiente
Eis um guia passo a passo para configurar o ambiente para a API de scraping do Geonode:
1. Crie uma conta em Geonode. O primeiro passo é criar uma conta no site da Geonode. Isto dar-lhe-á acesso à API e a outros serviços.
2. Obtenha a sua chave API. Depois de criar uma conta e iniciar sessão, pode encontrar a sua chave API nas definições da conta ou no painel de controlo. Esta chave é utilizada para autenticar os seus pedidos à API.
3. Instale as bibliotecas necessárias. Dependendo da linguagem de programação que estiver a utilizar, poderá ser necessário instalar determinadas bibliotecas para enviar pedidos HTTP e tratar as respostas.
• Biblioteca de cliente HTTP: Para enviar pedidos à API do Geonode e receber respostas, vai precisar de uma biblioteca de cliente HTTP. A biblioteca específica que irá utilizar pode depender da sua linguagem de programação. Por exemplo, se estiver a utilizar Python, poderá utilizar a biblioteca Requests. Se estiver a utilizar JavaScript, poderá utilizar o Axios ou o Fetch.
• Biblioteca de análise de JSON: A API do Geonode normalmente devolve dados no formato JSON, pelo que precisará de uma biblioteca para analisar esses dados. A maioria das linguagens de programação modernas tem suporte integrado para a análise de JSON. Por exemplo, em Python, pode utilizar o módulo json e, em JavaScript, pode utilizar o JSON.parse().
• Ambiente de desenvolvimento: Vai precisar de um ambiente de desenvolvimento para escrever e executar o seu código. Pode ser um editor de texto como o Sublime Text ou o Atom, ou um ambiente de desenvolvimento integrado (IDE) como o PyCharm ou o Visual Studio Code.
4. Configure o seu ambiente de desenvolvimento. Certifique-se de que o seu ambiente de desenvolvimento está configurado para enviar pedidos à API e tratar as respostas. Isto pode envolver a criação de um novo projeto no seu ambiente de desenvolvimento integrado (IDE) ou editor de texto preferido.
5. Teste a API. Antes de começar a criar o seu web scraper, é uma boa ideia testar a API para se certificar de que tudo está a funcionar corretamente. Pode fazê-lo enviando uma simples solicitação GET para a API e verificando a resposta.
6. Leia a documentação da API: A documentação da API do Geonode fornecerá informações detalhadas sobre como utilizar a API, incluindo os endpoints disponíveis, parâmetros de pedido, formatos de resposta e muito mais. Ler esta documentação irá ajudá-lo a compreender como utilizar a API de forma eficaz.
Obter uma página de produto do Walmart
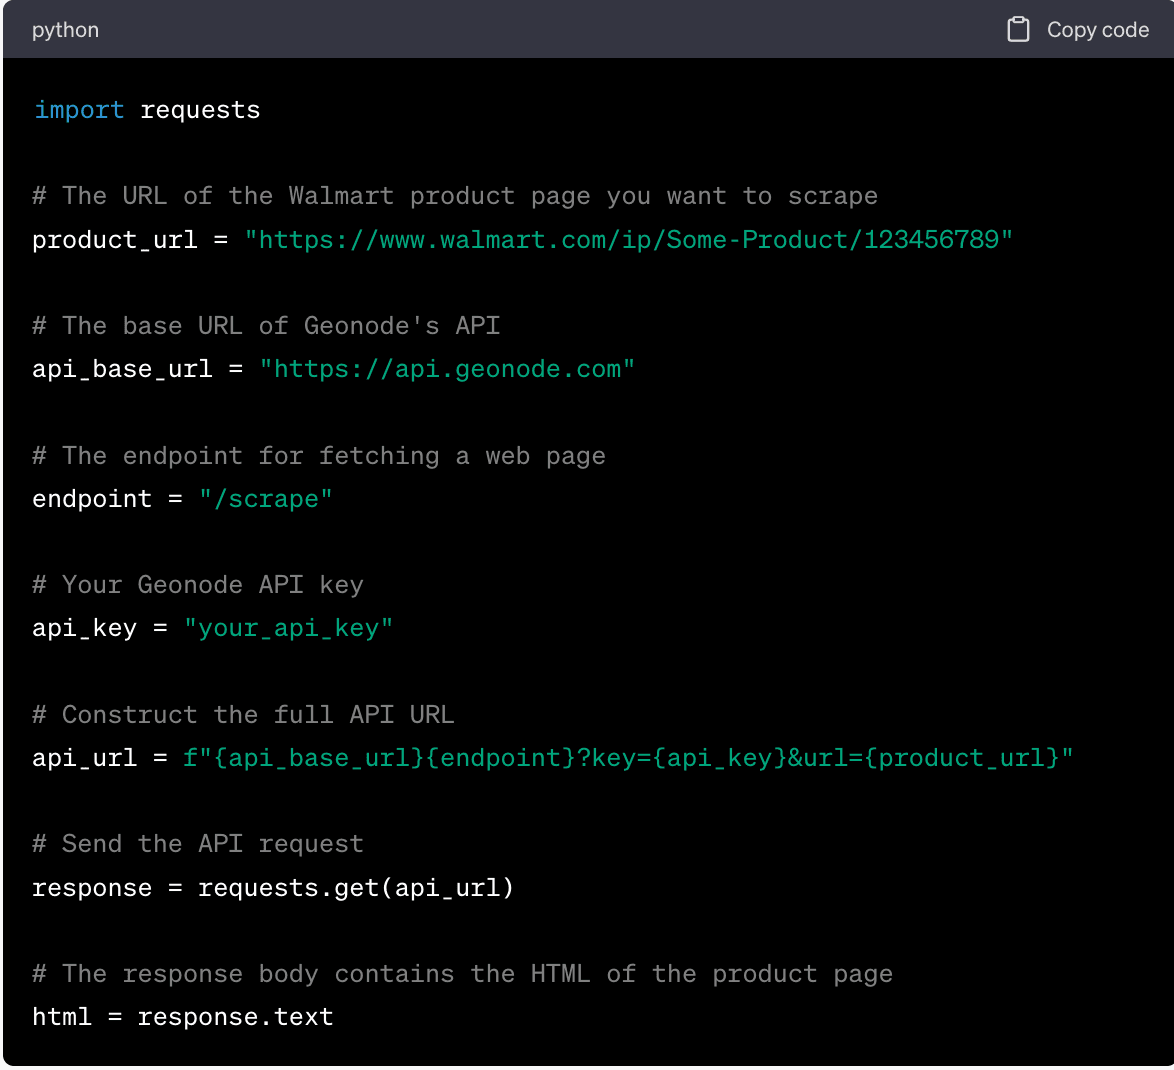
Para obter uma página de produto do Walmart utilizando a API de scraping do Geonode, é necessário enviar uma solicitação HTTP GET à API com o URL da página de produto que pretende extrair. Aqui está um resumo geral:
1. Identifique o URL da página de produto. Identifique o URL da página de produto do Walmart que pretende extrair. Pode fazê-lo navegando até à página do produto no seu navegador da Web e copiando a URL da barra de endereços.
2. Prepare a solicitação à API. Construa a URL do ponto final da API, que inclui a URL base da API do Geonode, o ponto final para obter uma página Web e quaisquer parâmetros necessários. Um dos parâmetros será a URL da página do produto do Walmart que pretende extrair.
3. Envie a solicitação à API. Envie a solicitação à API utilizando a sua biblioteca de cliente HTTP. Isto envolverá chamar uma função ou método fornecido pela biblioteca, passar a URL do ponto final da API e definir o método como GET.
4. Processar a resposta da API. Depois de enviar a solicitação à API, esta irá devolver uma resposta. Esta resposta conterá os dados da página do produto do Walmart, normalmente em formato HTML. Terá de processar esta resposta no seu código, o que poderá envolver analisar o HTML e extrair os dados que lhe interessam.
Eis um exemplo de como pode fazer isto em Python utilizando a biblioteca Requests:
Extrair dados da página do produto
Depois de obter uma página de produto do Walmart utilizando a API de scraping dGeonode, o próximo passo é extrair os principais dados da página. Normalmente, isto envolve analisar o HTML da página e selecionar os elementos que contêm os dados que lhe interessam.
Eis um esboço geral de como pode fazer isto:
1. Analisar o HTML. O primeiro passo é analisar o código HTML da página. Isto envolve converter a cadeia de caracteres HTML numa estrutura que possa ser percorrida e pesquisada. O método específico para o fazer pode depender da sua linguagem de programação e das bibliotecas que estiver a utilizar. Por exemplo, em Python, pode utilizar a biblioteca BeautifulSoup para analisar o HTML.
2. Identificar os pontos de dados. Em seguida, terá de identificar os elementos HTML que contêm os pontos de dados que lhe interessam. Isto envolve, normalmente, inspecionar o HTML da página e localizar as tags, classes ou IDs desses elementos. Pode fazê-lo utilizando as ferramentas de programador do seu navegador da Web.
3. Selecionar os elementos. Depois de identificar os elementos, pode selecioná-los a partir do HTML analisado. Isto envolve, normalmente, chamar uma função ou método fornecido pela sua biblioteca de análise de HTML, passando a tag, a classe ou o ID do elemento. Isto irá devolver o elemento e o seu conteúdo.
4. Extrair os dados. Depois de selecionar os elementos, pode extrair os dados deles. Isto envolve normalmente chamar uma função ou método fornecido pela sua biblioteca de análise de HTML, passando o elemento como parâmetro. Isto irá devolver os dados contidos no elemento.
Eis um exemplo de como pode analisar HTML em Python utilizando a biblioteca BeautifulSoup:
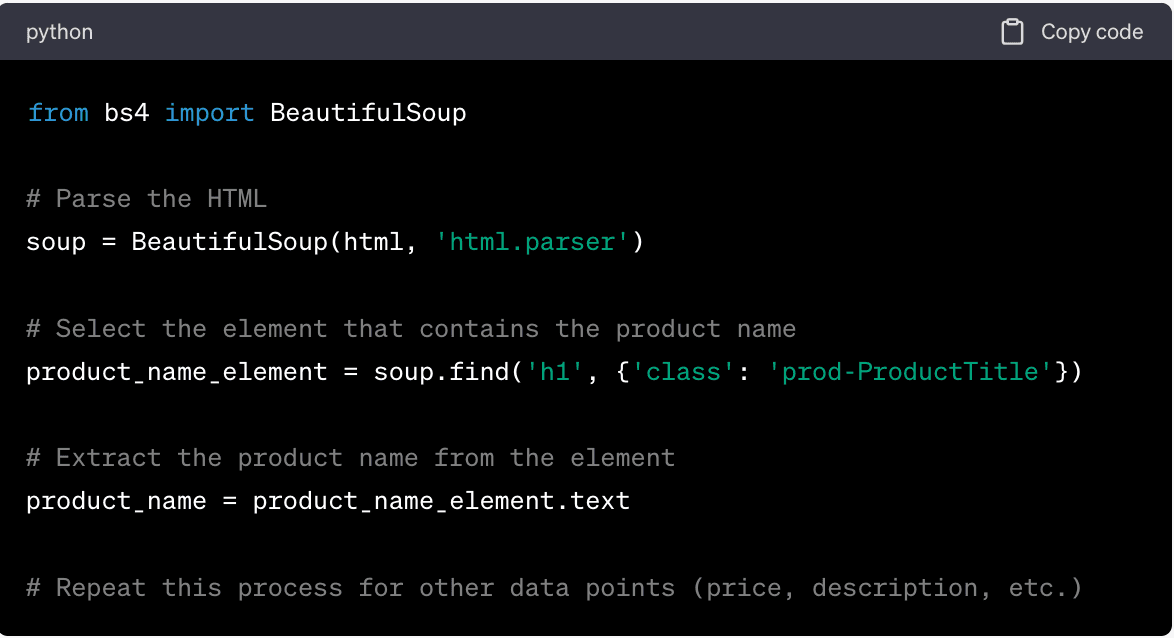
(Este é um exemplo básico e a implementação real pode variar consoante a estrutura específica das páginas de produtos do Walmart e as funcionalidades e capacidades da sua biblioteca de análise de HTML. Consulte sempre a documentação oficial da sua biblioteca para obter as informações mais precisas e atualizadas.)
Análise dos dados HTML e JSON
A análise de dados HTML e JSON é uma tarefa comum na extração de dados da Web. A análise consiste no processo de pegar em dados brutos (neste caso, texto HTML ou JSON) e convertê-los num formato mais fácil de trabalhar na sua linguagem de programação.
Análise de HTML
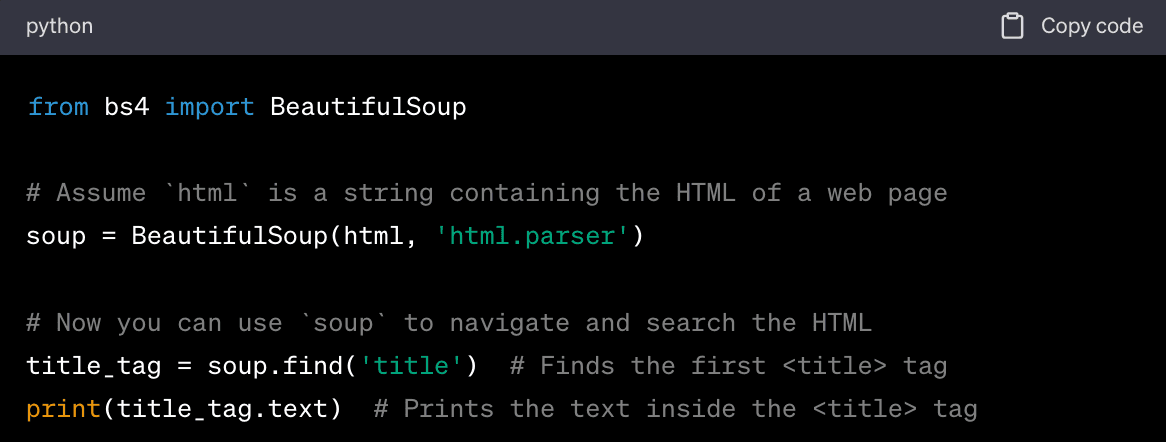
O HTML é a linguagem de marcação padrão para a criação de páginas web. Utiliza etiquetas para indicar diferentes tipos de conteúdo, tornando relativamente fácil navegar e extrair dados específicos.
Eis um exemplo de como pode analisar HTML em Python utilizando a biblioteca BeautifulSoup:
Análise de JSON
O JSON (JavaScript Object Notation) é um formato leve de intercâmbio de dados, fácil de ler e escrever para os utilizadores e fácil de analisar e gerar para as máquinas. É frequentemente utilizado por APIs para enviar dados.
Eis um exemplo de como se pode analisar JSON em Python:
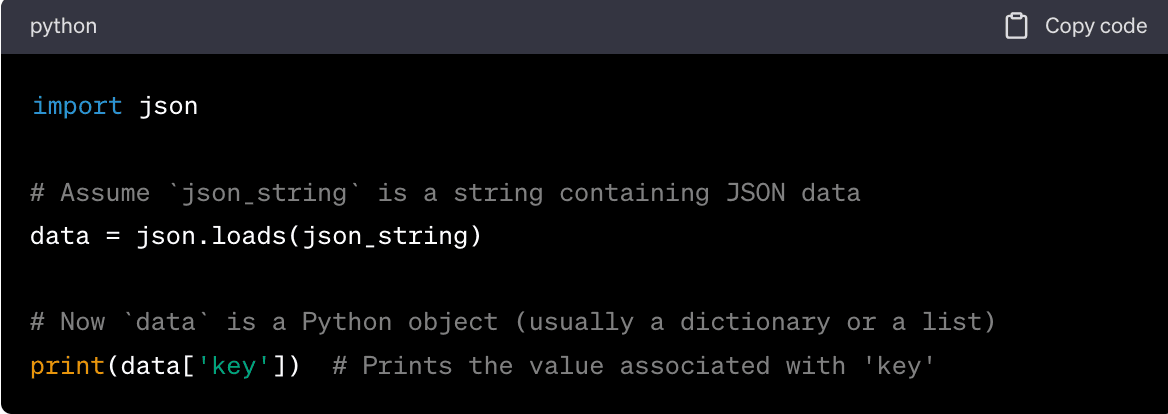
Em ambos os casos, o objetivo da análise é converter os dados HTML ou JSON em bruto num formato mais fácil de trabalhar na sua linguagem de programação. Depois de os dados serem analisados, pode percorrê-los para encontrar os elementos específicos que lhe interessam.
Dicas para uma gestão eficiente dos dados
A gestão eficiente de grandes quantidades de dados é um aspeto crucial do web scraping em grandes plataformas de comércio eletrónico, como o Walmart. Aqui ficam algumas dicas sobre como lidar com grandes conjuntos de dados:
• Utilize uma base de dados. Armazenar os seus dados numa base de dados pode facilitar a sua gestão, especialmente se estiver a lidar com grandes quantidades de dados. As bases de dados são concebidas para lidar com grandes conjuntos de dados e podem oferecer funcionalidades como a indexação, o que pode tornar as consultas aos seus dados mais rápidas.
• Processamento em lotes. Em vez de processar cada ponto de dados à medida que é extraído, considere reunir os seus dados em lotes e processar cada lote de uma só vez. Isto pode ser mais eficiente e reduzir a carga no seu sistema.
• Compressão de dados. Se o espaço de armazenamento for uma preocupação, considere comprimir os seus dados. Muitos formatos de dados comuns, como CSV e JSON, podem ser comprimidos para uma fração do seu tamanho original.
• Processamento paralelo. Se estiver a extrair dados de várias páginas ou sites ao mesmo tempo, considere utilizar o processamento paralelo para acelerar o processo. Isto envolve a execução simultânea de várias tarefas de extração, o que pode reduzir significativamente o tempo total de extração.
• Extracção incremental. Em vez de extrair todos os dados de uma só vez, considere fazê-lo de forma incremental. Isto implica manter um registo dos dados que já foram extraídos e extrair apenas os dados novos ou atualizados. Esta abordagem pode ser mais eficiente e reduzir a carga tanto no seu sistema como no site que está a extrair.
• Utilize uma solução baseada na nuvem. As soluções baseadas na nuvem podem fornecer armazenamento e capacidade de processamento escaláveis, o que pode ser especialmente útil ao lidar com grandes quantidades de dados. Serviços como a Amazon Web Services (AWS), o Google Cloud e o Microsoft Azure oferecem várias soluções de armazenamento e processamento de dados capazes de lidar com grandes conjuntos de dados.
• Limpeza e validação de dados. Limpe e valide os seus dados o mais cedo possível no fluxo de dados. Isto pode incluir a remoção de duplicados, o tratamento de valores em falta e a verificação da consistência dos dados. Limpar e validar os seus dados numa fase inicial pode evitar erros e ineficiências mais tarde.
Lembre-se de que o objetivo é gerir os seus dados de forma eficiente, escalável e adequada às suas necessidades específicas. A melhor abordagem pode depender da dimensão do seu conjunto de dados, dos recursos de que dispõe e dos requisitos específicos do seu projeto.
Como evitar ser bloqueado
Embora o web scraping seja uma ferramenta poderosa para extrair dados de sites, o Walmart não vê com bons olhos esta prática.
Eis algumas razões comuns para se ser bloqueado ao fazer web scraping, juntamente com dicas sobre como evitá-las:
• Demasiadas solicitações. O envio de demasiadas solicitações num curto período de tempo pode sobrecarregar os servidores do Walmart e afetar negativamente o desempenho do site. Frequentemente considerado uma forma de abuso, é um motivo comum para ser bloqueado. Para evitar isto, limite a sua taxa de solicitações e insira intervalos entre as mesmas.
• Ignorar o ficheiro robots.txt. O ficheiro robots.txt é uma forma de os sites comunicarem com os rastreadores e os scrapers. Especifica quais as partes do site que não devem ser extraídas. Ignorar as regras deste ficheiro pode levar ao bloqueio do seu scraper. Verifique sempre e respeite o ficheiro robots.txt do site que está a extrair.
• Não alternar endereços IP. Se todas as suas solicitações provierem do mesmo endereço IP, isso pode ser um sinal claro de que está a extrair dados do site. O Walmart bloqueará o seu endereço IP se este estiver a enviar demasiadas solicitações. Para evitar isso, considere utilizar um conjunto de proxies residenciais rotativos para distribuir as suas solicitações por vários endereços IP.
- A API de scraping da Geonode utiliza um conjunto de proxies rotativos. Cada solicitação que enviar através da API é feita a partir de um endereço IP diferente. Isto pode ajudar a evitar o bloqueio baseado no IP e a limitação de taxa, uma vez que torna mais difícil para os sites identificarem e bloquearem o seu scraper. A rotação de IPs também ajuda a distribuir as suas solicitações de forma mais uniforme, reduzindo a carga em qualquer servidor individual e tornando o seu scraping mais eficiente.
• Não utilizar uma string User-Agent ou utilizar uma suspeita. A string User-Agent indica ao site que tipo de dispositivo e navegador está a efetuar a solicitação. Sites como o Walmart bloqueiam solicitações que não incluam uma string User-Agent ou que utilizem uma string User-Agent conhecida por estar associada a scrapers. Utilize uma string de User-Agent legítima que imite um navegador real.
• Extrair dados protegidos. Alguns dados num site podem estar protegidos por direitos de autor ou outras proteções legais. A extração destes dados pode levar ao bloqueio e também pode ter consequências legais. Certifique-se sempre de que tem o direito de extrair e utilizar os dados que pretende.
É claro que a melhor forma de evitar ser bloqueado é extrair dados de forma responsável. Respeite as regras do site, não sobrecarregue o servidor e certifique-se sempre de que tem o direito de extrair e utilizar os dados que pretende.

