Os pipelines ETL são essenciais porque proporcionam uma abordagem simplificada ao processamento de dados, permitindo que as empresas obtenham insights sobre as suas operações e tomem decisões informadas.
Um exemplo de um pipeline ETL é a sua utilização por uma empresa de retalho para extrair dados de vendas de uma base de dados, transformá-los num formato adequado para análise e carregá-los num armazém de dados para fins de inteligência empresarial.
O pipeline pode utilizar uma ferramenta como o Apache NiFi ou o Talend para extrair os dados, transformá-los utilizando ferramentas como o Apache Spark ou o Python e carregá-los num armazém de dados como o Amazon Redshift ou o Google BigQuery.
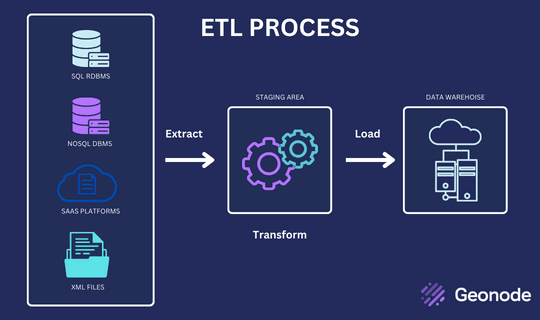
3 Os componentes de um pipeline ETL
Uma operação de pipeline ETL tem três componentes principais: extração, transformação e carregamento.
Extração
A fase de extração envolve a recolha de dados de várias fontes, tais como bases de dados, armazenamento na nuvem, APIs e ficheiros simples. Os dados extraídos podem estar em diferentes formatos, como JSON, CSV ou XML.
Transformação
A fase de transformação envolve a conversão dos dados extraídos para um formato utilizável, a sua limpeza e o seu enriquecimento com informação adicional. Esta fase envolve a aplicação de várias técnicas de processamento de dados, tais como filtragem, agregação, junção e ordenação.
Carregamento
A fase de carregamento envolve o armazenamento dos dados transformados num destino final, como uma base de dados, um data warehouse ou um data lake. Os dados carregados podem ser utilizados para diversos fins, tais como a elaboração de relatórios, a análise ou a aprendizagem automática.
Pipeline de dados vs. pipeline ETL
Um pipeline de dados é um termo geral que se refere a uma série de etapas ou processos utilizados para transferir dados de um sistema ou aplicação para outro. Pode incluir vários componentes, tais como a ingestão, o processamento, o armazenamento e a análise de dados.
Um pipeline ETL (Extract, Transform, Load) é um tipo específico de pipeline de dados utilizado para extrair dados de uma ou mais fontes, transformá-los num formato mais útil ou estruturado e carregá-los num sistema ou aplicação de destino. Os pipelines ETL são frequentemente utilizados em aplicações de armazenamento de dados, inteligência empresarial e análise de dados.
Embora os pipelines ETL sejam um tipo específico de pipeline de dados, na prática os dois termos são frequentemente utilizados de forma intercambiável. Um pipeline de dados é, em geral, qualquer conjunto de processos ou ferramentas utilizados para transferir, processar e analisar dados. Em contrapartida, um pipeline ETL refere-se especificamente à extração de dados, transformação e carregamento.
Tipos de pipeline ETL
Os dois tipos distintos de pipelines ETL (Extract, Transform, Load) são:
Processamento em lote: Este tipo de pipeline envolve o processamento de grandes volumes de dados em lotes, normalmente diariamente ou semanalmente. Os dados são extraídos dos sistemas de origem, transformados para o formato pretendido e carregados num sistema de destino num processo em lote. O ETL em lote é útil para aplicações de armazenamento de dados, inteligência empresarial e análise de dados.
Processamento em tempo real: Este tipo de pipeline envolve o processamento de dados quase em tempo real, à medida que são gerados ou recebidos pelo sistema de origem. Os dados são extraídos dos sistemas de origem, transformados em tempo real e carregados num sistema de destino num processo contínuo.
As vantagens de utilizar um pipeline ETL
Os pipelines ETL oferecem várias vantagens, incluindo:
Processamento de dados otimizado
Os pipelines ETL proporcionam uma abordagem otimizada ao processamento de dados, permitindo que as empresas processem grandes quantidades de dados de forma rápida e eficiente.
Melhoria da qualidade dos dados
Os pipelines ETL permitem que as empresas melhorem a qualidade dos seus dados, eliminando registos duplicados, corrigindo erros e aplicando normas de dados.
Redução da complexidade
Os pipelines ETL reduzem a complexidade do processamento de dados, fornecendo uma interface única para a gestão de tarefas de integração de dados.
Melhoria na tomada de decisões
Os pipelines ETL proporcionam às empresas informações oportunas, precisas e úteis sobre as suas operações, permitindo-lhes tomar decisões informadas.
Linguagens ETL
Os pipelines ETL podem ser implementados utilizando uma variedade de linguagens de programação e ferramentas, dependendo dos requisitos específicos do pipeline e das tecnologias utilizadas. Algumas das linguagens e ferramentas ETL mais utilizadas incluem:
SQL (Structured Query Language): O SQL é uma linguagem padrão utilizada para gerir e consultar dados em bases de dados relacionais. Os pipelines ETL utilizam-no frequentemente para extrair e transformar dados de bases de dados.
Python: O Python é uma linguagem de programação popular utilizada para uma vasta gama de tarefas de processamento e análise de dados, incluindo pipelines ETL. O Python dispõe de muitas bibliotecas e frameworks para a manipulação, transformação e carregamento de dados, tais como o Pandas, o NumPy e o Apache Airflow.
Java: O Java é uma linguagem de programação amplamente utilizada que pode ser empregada na construção de pipelines ETL. Estão disponíveis várias ferramentas ETL baseadas em Java, tais como o Apache NiFi, o Talend e o Apache Beam.
R: O R é uma linguagem de programação frequentemente utilizada para análise estatística e visualização de dados. Dispõe de muitas bibliotecas e pacotes disponíveis para a manipulação e transformação de dados e pode ser utilizada para a criação de pipelines ETL.
Ferramentas ETL: Existem também muitas ferramentas ETL disponíveis que fornecem uma interface gráfica de utilizador para a criação e gestão de pipelines ETL, tais como o Talend, o Informatica e o Microsoft SSIS. Estas ferramentas suportam frequentemente uma variedade de linguagens de programação e fontes de dados e podem simplificar o processo de criação e manutenção de pipelines ETL.
Melhores práticas para a conceção e implementação de pipelines ETL
As empresas devem seguir determinadas melhores práticas para garantir o sucesso de um pipeline ETL, incluindo:
Definir as fontes de dados e os requisitos
Antes de conceber um pipeline ETL, as empresas devem definir as suas fontes de dados e os seus requisitos. Isto envolve identificar as fontes de dados que precisam de integrar, os seus formatos de dados e os padrões de qualidade de dados que devem cumprir.
Escolher as ferramentas certas
A escolha das ferramentas certas é crucial para a conceção e implementação de um pipeline ETL. Além disso, as empresas devem ter em conta a escalabilidade, a flexibilidade e a relação custo-benefício das ferramentas escolhidas.
Crie um fluxo de dados claro
Um fluxo de dados claro é essencial para conceber um pipeline ETL eficiente e eficaz. Além disso, o fluxo de dados deve ser fácil de compreender e as diferentes etapas do pipeline devem estar claramente definidas.
Implemente um tratamento robusto de erros
Um tratamento robusto de erros é essencial para garantir a fiabilidade de um pipeline ETL. Por conseguinte, as empresas devem implementar mecanismos de tratamento de erros capazes de detetar e resolver erros.
Teste e monitorize regularmente o seu pipeline
Testar e monitorizar regularmente um pipeline ETL é essencial para garantir a sua eficácia e identificar potenciais problemas antes que estes causem dificuldades.
Desafios comuns dos pipelines ETL e como superá-los
Apesar das suas vantagens, os pipelines ETL também podem apresentar certos desafios, incluindo:
Inconsistências nos dados
Podem ocorrer inconsistências nos dados quando as fontes de dados utilizadas num pipeline ETL contêm erros ou inconsistências. É necessário realizar verificações de qualidade dos dados e aplicar mecanismos de limpeza para resolver esta questão.
Problemas de qualidade dos dados
Podem surgir problemas de qualidade dos dados quando os dados utilizados num pipeline ETL são de má qualidade ou contêm imprecisões. As empresas devem implementar verificações de qualidade dos dados e mecanismos de validação para garantir a precisão e a consistência dos dados.
Estrangulamentos de desempenho
Podem ocorrer estrangulamentos de desempenho quando um pipeline ETL está sobrecarregado ou quando não consegue escalar para lidar com volumes de dados crescentes. Para evitar este problema, as empresas devem otimizar os seus pipelines ETL em termos de desempenho e escalabilidade.
Escalabilidade limitada
Pode ocorrer escalabilidade limitada quando um pipeline ETL não consegue lidar com grandes volumes de dados. Os pipelines ETL devem ser concebidos para serem escaláveis e utilizar tecnologias de computação distribuída para resolver este problema.
Conclusão
Em conclusão, um pipeline ETL é um componente crucial de um sistema abrangente de processamento de dados. Permite às empresas recolher, transformar e carregar grandes quantidades de dados provenientes de várias fontes e obter informações úteis sobre as suas operações. No entanto, para conceber e implementar um pipeline ETL eficaz, as empresas devem seguir determinadas práticas recomendadas, tais como definir as suas fontes de dados e requisitos, escolher as ferramentas adequadas, criar um fluxo de dados claro, implementar um tratamento robusto de erros e testar e monitorizar regularmente o seu pipeline.
Perguntas frequentes
-
O que é ETL em comparação com o pipeline de dados?
ETL e pipeline de dados são dois conceitos relacionados, mas distintos. ETL significa Extract, Transformar e Carregar, que se refere a um processo específico de extrair dados de várias fontes, transformá-los num formato utilizável e carregá-los num destino final. Por outro lado, um pipeline de dados refere-se a um conceito mais abrangente de movimentação de dados entre diferentes sistemas e aplicações, o que pode incluir o ETL como um subconjunto do processo global.
-
O SQL é uma ferramenta ETL?
O SQL não é, por si só, uma ferramenta ETL, mas é frequentemente utilizado em processos ETL para manipular e transformar dados. O SQL pode ser utilizado para realizar várias transformações de dados, tais como filtragem, agregação e junção, que são componentes essenciais da fase de transformação num pipeline ETL.
-
Como se cria um pipeline ETL?
A criação de um pipeline ETL envolve várias etapas, incluindo a definição de fontes de dados e requisitos, a escolha das ferramentas adequadas, a criação de um fluxo de dados claro, a implementação de um tratamento robusto de erros e o teste e monitorização regulares do pipeline. As ferramentas comuns para criar pipelines ETL incluem o Apache Kafka, o Apache Spark e o Talend Open Studio.
-
O que é o ETL no DevOps?
No DevOps, ETL refere-se ao processo de integração de dados de várias fontes no pipeline de DevOps. Isto pode incluir a extração de dados de repositórios de código-fonte, ferramentas de compilação e estruturas de automatização de testes, a sua transformação num formato utilizável e o seu carregamento num destino final, como um armazém de dados ou uma ferramenta de inteligência empresarial. O ETL em DevOps é essencial para proporcionar às equipas informações em tempo real sobre os seus processos de desenvolvimento de software e permitir-lhes tomar decisões baseadas em dados.
Referências
Sharma, V. (13 de junho de 2022). Um guia completo sobre a criação de um pipeline ETL para principiantes. Analytics Vidhya. Consultado em 10 de março de 2023, em https://www.analyticsvidhya.com/blog/2022/06/a-complete-guide-on-building-an-etl-pipeline-for-beginners/
O que é um pipeline ETL? (s.d.). Snowflake. Consultado em 10 de março de 2023, em https://www.snowflake.com/guides/etl-pipeline
O que é um pipeline ETL? Comparação entre pipeline de dados e ETL. (s.d.). Qlik. Consultado em 10 de março de 2023, em https://www.qlik.com/us/etl/etl-pipeline

