Immobiliare.it ist eine der führenden Online-Immobilienplattformen Italiens.
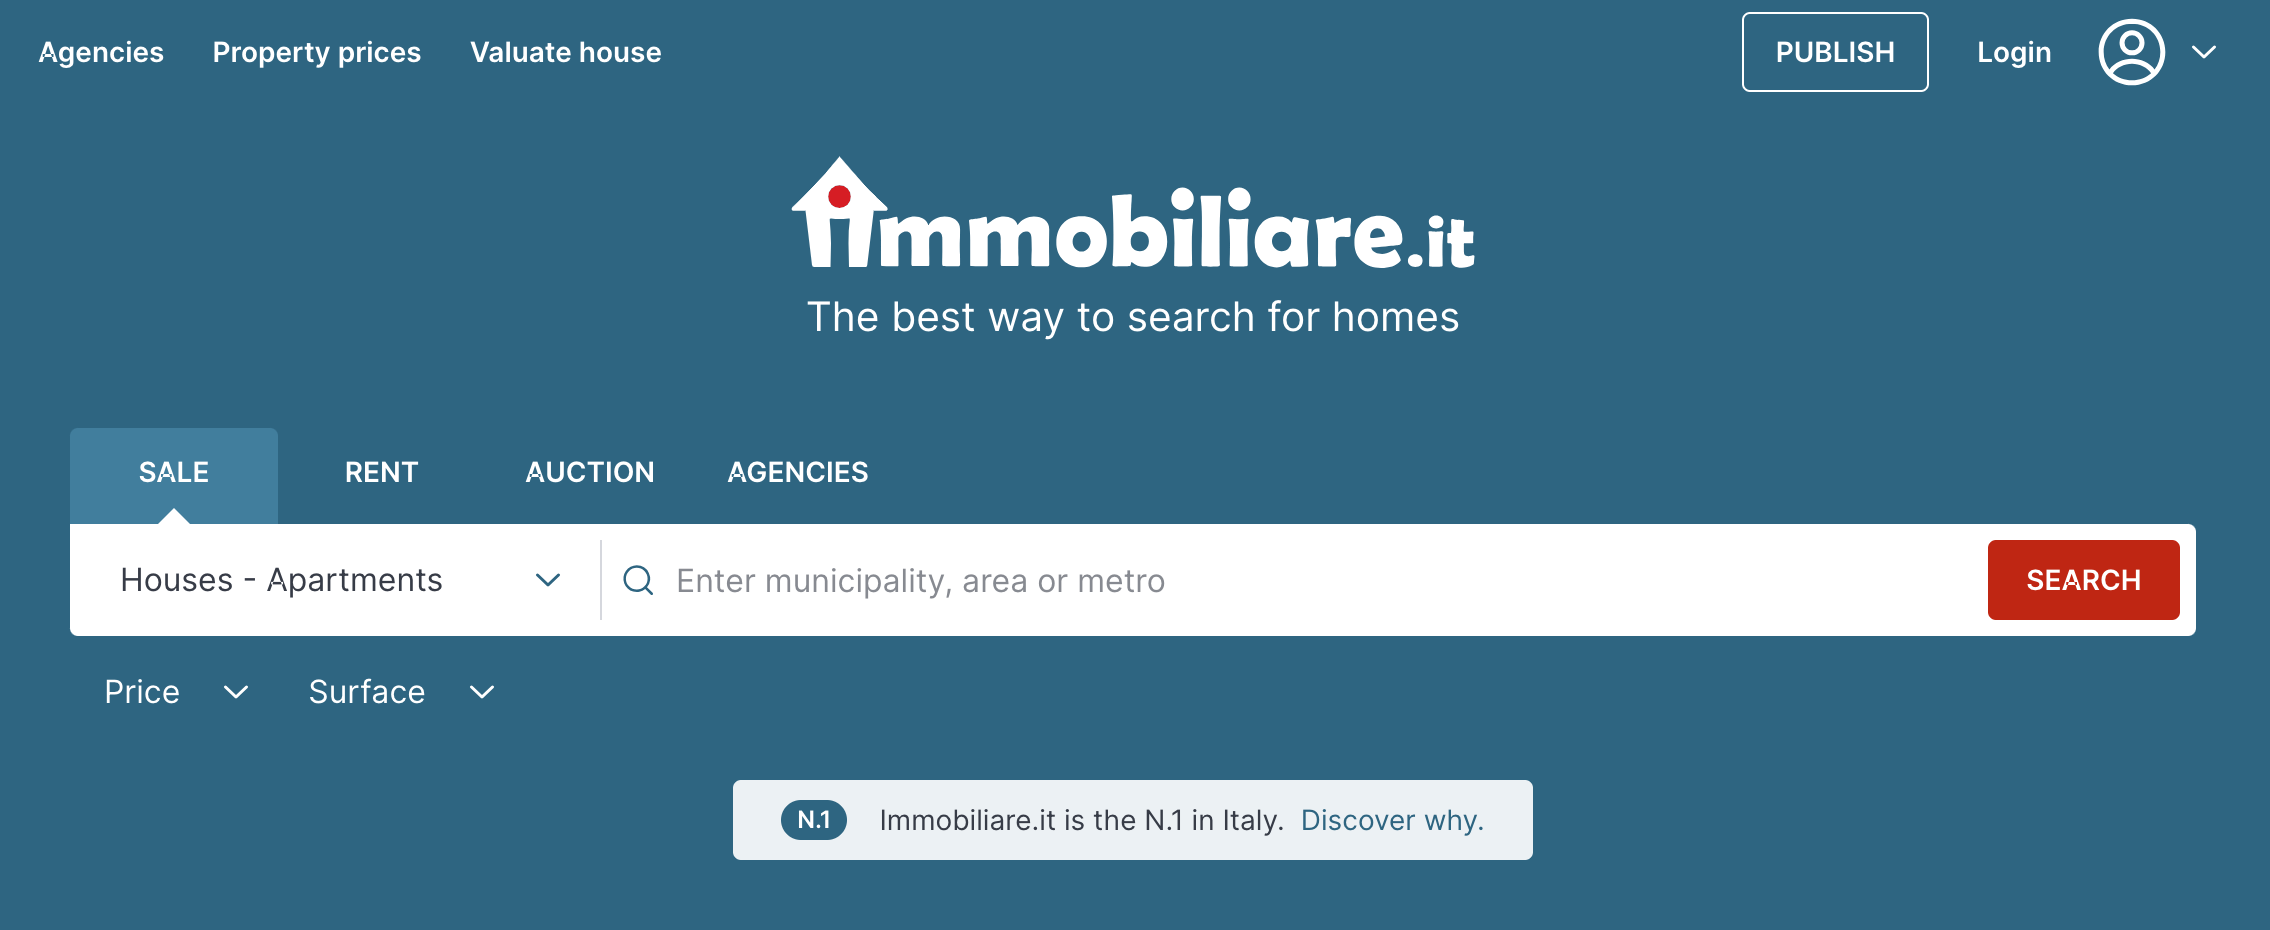
Mit einem umfangreichen Angebot an Immobilien, darunter Wohn-, Gewerbe- und Ferienimmobilien, dient die Website als umfassende Informationsquelle für alle, die in italienische Immobilien investieren möchten.
Für amerikanische Immobilienmakler und Immobilienkäufer bietet Immobiliare.it eine einzigartige Gelegenheit, Zugang zu einem vielfältigen Markt zu erhalten, der aus dem Ausland heraus sonst nur schwer zu erschließen ist.
Die Bedeutung von Immobiliendaten
In der Immobilienbranche sind Daten das A und O. Genaue und aktuelle Informationen können den Unterschied zwischen einer erfolgreichen Investition und einem kostspieligen Fehler ausmachen.
Für amerikanische Immobilienmakler und Immobilienkäufer ist eine zuverlässige Datenquelle unerlässlich, um den italienischen Markt zu verstehen.
Immobiliare.it bietet diese in Form von Immobilienangeboten, Preistrends, Einblicken in die Nachbarschaft und vielem mehr.
Die leistungsstarken Suchfilter der Plattform ermöglichen es Nutzern, ihre Auswahl anhand verschiedener Kriterien wie Lage, Immobilienart und Preisklasse einzugrenzen, wodurch es einfacher wird, Objekte zu finden, die bestimmten Anlagezielen entsprechen.
Anwendungsfälle für Immobiliendaten von Immobiliare.it
-
Marktforschung. US-amerikanische Immobilienmakler können die Daten nutzen, um den italienischen Immobilienmarkt besser zu verstehen und Trends sowie Chancen zu erkennen, von denen ihre Kunden profitieren könnten.
-
Investitionsentscheidungen. Immobilienkäufer aus den Vereinigten Staaten können Immobiliare.it nutzen, um fundierte Investitionsentscheidungen zu treffen. D
Die Daten der Plattform können dabei helfen, unterbewertete Immobilien, aufstrebende Stadtteile oder lukrative Ferienvermietungen zu identifizieren.
-
Vergleichende Analyse. Die Daten können genutzt werden, um den italienischen Markt mit dem amerikanischen Markt zu vergleichen.
Dies ist besonders nützlich für Investoren, die ihr Portfolio international diversifizieren möchten.
-
Kundenservice. Immobilienmakler können ihren amerikanischen Kunden, die sich für den italienischen Markt interessieren, zusätzliche Dienstleistungen anbieten, wie beispielsweise maßgeschneiderte Berichte und Analysen auf der Grundlage von Daten von Immobiliare.it.
-
Marketingstrategie. Durch das Scraping von Daten von Immobiliare.it können Unternehmen aktuelle Trends bei Immobilienmerkmalen und Standorten erkennen, was zur Entwicklung einer effektiveren Marktstrategie beiträgt.
Dieser Ansatz kann die Wettbewerbsfähigkeit von Immobilienwebsites auf dem Markt steigern.
-
Preisanalyse. Das Auslesen von Preisdaten und Preisverläufen von Immobiliare.it ermöglicht eine umfassende Preisanalyse.
Das Verständnis von Marktpreisschwankungen, aktuellen Preisangaben und aktuellen Marktpreisen kann Unternehmen und Verbrauchern helfen, fundiertere Entscheidungen zu treffen.
-
Einblicke in rechtliche und regulatorische Rahmenbedingungen. Immobiliare.it bietet häufig Artikel und Ressourcen, die die italienischen Immobiliengesetze und -vorschriften erläutern, was für amerikanische Investoren, die mit der italienischen Rechtslandschaft nicht vertraut sind, von unschätzbarem Wert sein kann.
Durch die Nutzung der auf Immobiliare.it verfügbaren Daten und Ressourcen können amerikanische Immobilienmakler und Immobilienkäufer sich einen Wettbewerbsvorteil in einem Markt verschaffen, der sowohl herausfordernd als auch lohnend ist.
Rechtliche Aspekte
Wenn es um die Erfassung von Daten aus Online-Plattformen geht, ist es entscheidend, die rechtlichen und ethischen Rahmenbedingungen zu verstehen, um sicherzustellen, dass Sie im Rahmen der gesetzlichen Bestimmungen handeln und die Rechte der Dateneigentümer wahren.
Ist das Scraping von Immobiliare.it legal?
Bevor Sie eine Website scrapen, sollten Sie unbedingt deren „robots.txt“-Datei konsultieren, in der die Regeln für Webcrawler festgelegt sind.
Die „robots.txt“-Datei von Immobiliare.it enthält mehrere „Disallow“-Anweisungen, die die Bereiche der Website angeben, die nicht gecrawlt werden dürfen.
So ist beispielsweise unter anderem das Crawlen von Suchkarten, Benutzerbereichen und bestimmten Arten von Inseraten untersagt.
Ein Verstoß gegen diese Regeln kann zu einem Ausschluss von der Website oder zu rechtlichen Schritten führen.
Daher ist es unerlässlich, sich an die in der „robots.txt“-Datei festgelegten Richtlinien zu halten, wenn man Datenerfassungsaktivitäten auf Immobiliare.it in Betracht zieht.
Ethische Überlegungen
Über die rechtlichen Aspekte hinaus spielen auch ethische Überlegungen eine Rolle, wenn Daten von Websites gescrapt werden.
Ethisches Web-Scraping respektiert sowohl den Wortlaut als auch den Geist des Gesetzes sowie die robots.txt-Datei der Website, in der die Bereiche der Website aufgeführt sind, die nicht gescrapt werden dürfen.
Darüber hinaus bedeutet ethisches Web-Scraping, die Server der Website nicht zu überlasten, die Privatsphäre der Nutzer zu respektieren und die Daten verantwortungsbewusst zu nutzen.
Die Nichteinhaltung dieser ethischen Richtlinien kann Ihrem Ruf schaden und auch rechtliche Konsequenzen nach sich ziehen.
Einblicke in die Rechtmäßigkeit des Web-Scrapings
Hier sind drei Artikel, die sich mit der Rechtmäßigkeit des Web-Scrapings befassen, zusammen mit ihren Zusammenfassungen:
Das US-Berufungsgericht des Neunten Bezirks hat entschieden, dass das Scraping öffentlich zugänglicher Daten keinen Verstoß gegen den „Computer Fraud and Abuse Act“ (CFAA) darstellt. Dieses Urteil ist von Bedeutung für Archivare, Wissenschaftler, Forscher und Journalisten, die Web-Scraping-Tools nutzen.
Der Artikel erwähnt jedoch auch, dass es Fälle gab, in denen Web-Scraping Bedenken hinsichtlich Datenschutz und Sicherheit aufgeworfen hat. Der Fall wurde ursprünglich von LinkedIn gegen Hiq Labs angestrengt, ein Unternehmen, das LinkedIn-Nutzerprofile gescrapt hatte. LinkedIn verlor den Prozess im Jahr 2019, und das Berufungsgericht des Neunten Bezirks bestätigte seine ursprüngliche Entscheidung.
Dieser Artikel stellt fest, dass es in den Vereinigten Staaten keine Bundesgesetze gegen Web-Scraping gibt, solange die gescrapten Daten öffentlich zugänglich sind.
Allerdings betont er die Bedeutung ethischer Überlegungen und rät Web-Scrapern, sich an die Nutzungsbedingungen und die „robots.txt“-Dateien der Websites zu halten.
Der Artikel erläutert, dass es nach den meisten Gesetzen illegal ist, personenbezogene Daten (PII) ohne die ausdrückliche Zustimmung des Eigentümers zu erheben, zu nutzen oder zu speichern.
Außerdem wird erwähnt, dass Web-Scraping manchmal in rechtliche Grauzonen fallen kann, insbesondere wenn es um die Erhebung sensibler Informationen geht.
Tools und Technologien zur Datenerfassung
Im Bereich des Web-Scrapings stehen eine Vielzahl von Tools und Technologien zur Verfügung, die unterschiedlichen Anforderungen gerecht werden. Ganz gleich, ob Sie Anfänger oder erfahrener Datenwissenschaftler sind – es gibt wahrscheinlich ein Tool, das zu den Anforderungen Ihres Projekts passt. Im Folgenden stellen wir einige der am häufigsten verwendeten Tools vor. 
Python-Bibliotheken (BeautifulSoup, Selenium)
Python ist eine beliebte Sprache für das Web-Scraping und bietet mehrere Bibliotheken, die den Prozess vereinfachen:
-
BeautifulSoup: Dies ist eine Python-Bibliothek zum Extrahieren von Daten aus HTML- und XML-Dateien. Sie bietet Python-typische Konstrukte zum Durchlaufen, Suchen und Bearbeiten des Parse-Baums.
BeautifulSoup wird häufig zum Web-Scraping verwendet, um Daten aus Webseiten zu extrahieren, und ist für Anfänger relativ leicht zu erlernen.
-
Selenium: Im Gegensatz zu BeautifulSoup, das lediglich den Quellcode ausliest, interagiert Selenium mit der Webseite genau wie ein menschlicher Nutzer.
Es wird häufig zum Scraping dynamischer Websites verwendet, bei denen der Inhalt über JavaScript geladen wird, und kann auch für automatisierte Tests eingesetzt werden.
Beide Bibliotheken können zusammen verwendet werden und bieten so ein leistungsstarkes Toolkit für jedes Web-Scraping-Projekt.
Web-Scraping-Dienste
Web-Scraping-Dienste bieten eine bequeme Alternative für diejenigen, die sich nicht mit Programmierung befassen möchten.
Diese Dienste verfügen oft über intuitive Benutzeroberflächen, über die Sie festlegen können, welche Daten Sie auslesen möchten, ohne selbst Code schreiben zu müssen.
Sie übernehmen alles von der Datenextraktion bis zur Speicherung, sodass Sie sich leichter auf die Analyse und Nutzung der Daten konzentrieren können. P
GitHub-Repositorys als Referenz
GitHub ist eine wahre Fundgrube an Ressourcen für das Web-Scraping. Dort finden Sie zahlreiche Repositorys, die vorgefertigte Scraping-Skripte, Frameworks und Tutorials anbieten.
Hier sind einige Arten von Repositorys, die für Sie nützlich sein könnten:
-
Tutorial-Repos. Diese Repos bieten Schritt-für-Schritt-Anleitungen und Code-Schnipsel, die Ihnen den Einstieg in das Web-Scraping erleichtern.
-
Framework-Repos. Diese enthalten vorgefertigte Frameworks, die für das Scraping bestimmter Arten von Websites oder Daten konzipiert sind.
-
Projekt-Repos. Hierbei handelt es sich um vollwertige Projekte, die komplexere Scraping-Aufgaben veranschaulichen, bei denen oft mehrere Websites oder Technologien zum Einsatz kommen.
Durch das Studium dieser Repositories können Sie Einblicke in Best Practices und fortgeschrittene Techniken für das Web-Scraping gewinnen.
Schritt-für-Schritt-Anleitung
Dieser Abschnitt enthält eine umfassende Anleitung dazu, wie Sie mithilfe von Python-Bibliotheken und anderen Tools Daten von Immobiliare.it abrufen können.
Befolgen Sie diese Schritte, um Ihre Umgebung einzurichten, den Code zu schreiben und GitHub-Beispiele zum weiteren Lernen zu finden.
Einrichten der Umgebung
-
Python installieren. Falls noch nicht geschehen, laden Sie Python von der offiziellen Website herunter und installieren Sie es.
-
Bibliotheken installieren. Öffnen Sie Ihr Terminal und installieren Sie BeautifulSoup und Selenium, indem Sie die folgenden Befehle ausführen: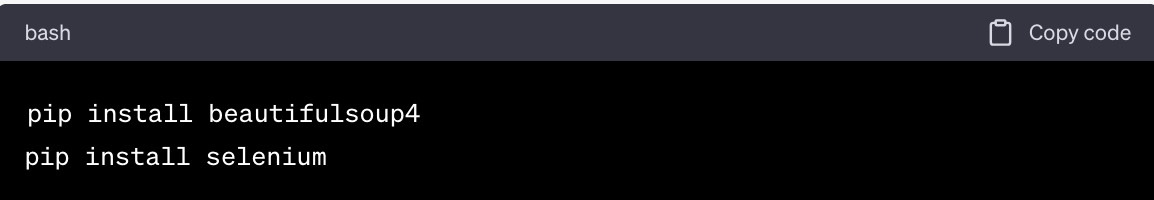
-
Web-Driver. Lade den mit deinem Browser kompatiblen Web-Driver herunter (z. B. ChromeDriver für Chrome) und speichere ihn in deinem Projektverzeichnis.
-
API-Schlüssel für Geonode. Wenn Sie den „Pay-As-You-Go“-Scraper von Geonode verwenden, beantragen Sie einen API-Schlüssel auf deren Website.
Erstellen des Codes zum Abrufen von Daten von Immobiliare.it
-
Bibliotheken importieren. Importieren Sie zu Beginn Ihres Skripts die erforderlichen Python-Bibliotheken.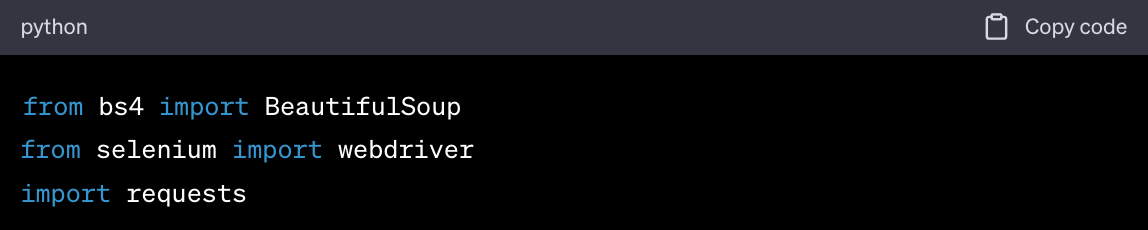
-
WebDriver initialisieren. Initialisieren Sie den Selenium WebDriver. 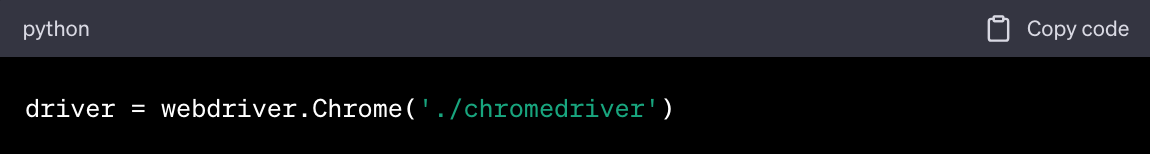
-
Navigieren Sie zu Immobiliare.it. Navigieren Sie mithilfe des WebDrivers zu der Webseite von Immobiliare.it, die Sie scrapen möchten. 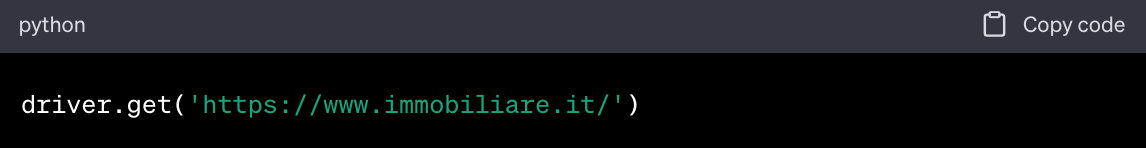
-
Elemente lokalisieren. Verwenden Sie BeautifulSoup oder Selenium-Funktionen, um die HTML-Elemente zu lokalisieren, die die Daten enthalten, die Sie scrapen möchten.
-
Daten scrapen. Extrahieren Sie die Daten und speichern Sie sie in einer Variablen oder einer Datei.
-
** „Geonode“-API.** Wenn Sie „Geonode“ verwenden, führen Sie einen API-Aufruf durch, um Proxys, Browser und Captchas zu handhaben.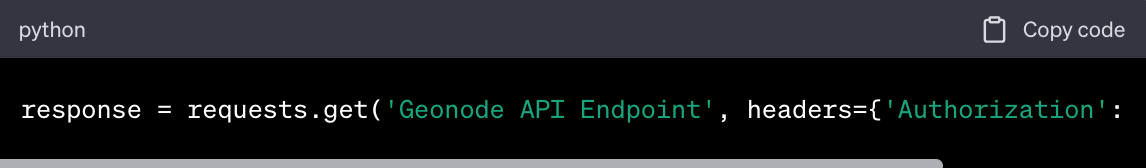
-
WebDriver schließen. Vergessen Sie nicht, den WebDriver zu schließen, sobald Sie fertig sind.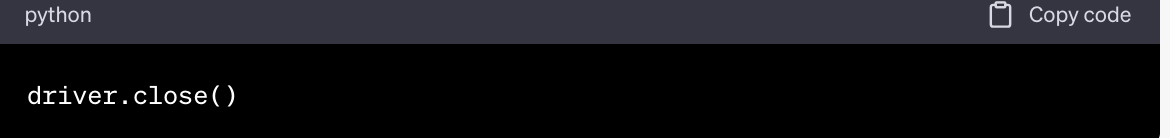
GitHub-Beispiele und Tutorials
-
Nach Repos suchen. Nutzen Sie die Suchfunktion von GitHub, um Repositories zum Thema Web-Scraping mit Python, BeautifulSoup und Selenium zu finden.
-
Studieren Sie den Code. Suchen Sie nach Beispielen, die speziell für Immobilien-Websites oder Immobiliare.it entwickelt wurden.
-
Folgen Sie den Tutorials. Einige GitHub-Repositorys bieten Schritt-für-Schritt-Anleitungen, die Ihnen helfen können, den Code besser zu verstehen.
-
Klonen und experimentieren. Zögern Sie nicht, Repositories zu klonen und den Code an Ihre spezifischen Anforderungen anzupassen.
Fortgeschrittene Techniken
Wenn Sie sich mit den grundlegenden Techniken des Web-Scrapings vertraut gemacht haben, werden Sie möglicherweise vor komplexeren Herausforderungen stehen. In diesem Abschnitt werden einige fortgeschrittene Techniken vorgestellt, die Ihnen helfen können, diese komplizierteren Szenarien zu meistern.
Umgang mit dynamischen Websites
Dynamische Websites laden Inhalte asynchron, häufig mithilfe von JavaScript. Dies kann das Scraping erschweren. Hier sind einige fortgeschrittene Techniken für den Umgang mit dynamischen Websites:
-
Selenium WebDriver. Wie bereits erwähnt, kann Selenium mit dynamischen Webseiten interagieren, sodass Sie Daten scrapen können, die über JavaScript geladen werden.
-
Headless-Browsing. Verwenden Sie Headless-Browser wie PhantomJS oder führen Sie Selenium im Headless-Modus aus, um Websites zu scrapen, ohne ein tatsächliches Browserfenster zu öffnen.
-
AJAX-Anfragen. Manche Websites laden Daten über AJAX-Anfragen. Sie können Entwicklertools nutzen, um diese Anfragen zu untersuchen und sie mithilfe der Python-Bibliothek „requests“ nachzubilden.
-
Wartebefehle. Verwenden Sie explizite und implizite Wartebefehle in Selenium, um sicherzustellen, dass die Webseite vollständig geladen ist, bevor Sie mit dem Scraping beginnen.
Scraping von Daten zu Immobilienmaklern
Das Scraping von Daten zu Immobilienmaklern kann aufgrund der erforderlichen Genauigkeit und der damit verbundenen ethischen Überlegungen etwas komplexer sein. Hier sind einige Tipps:
-
Spezifische Bereiche anvisieren. Verwenden Sie BeautifulSoup oder XPath-Ausdrücke, um bestimmte Bereiche einer Website anzusteuern, in denen Maklerdaten gespeichert sind.
-
Paginierung. Viele Websites listen Makler auf mehreren Seiten auf. Stellen Sie sicher, dass Ihr Code die Paginierung verarbeiten kann.
-
Ratenbegrenzung. Halten Sie sich an die Nutzungsbedingungen der Website. Implementieren Sie eine Ratenbegrenzung in Ihrem Code, um eine Überlastung der Server zu vermeiden.
-
Datenvalidierung. Überprüfen Sie die gescrapten Daten stets auf Richtigkeit und Vollständigkeit.
Einblicke von StackOverflow zum Umgang mit sich ändernden Codes
Websites aktualisieren häufig ihre HTML-Struktur, was dazu führen kann, dass Ihr Scraping-Code nicht mehr funktioniert. So können Sie sich darauf einstellen:
-
Regelmäßige Updates: Behalten Sie StackOverflow-Threads im Auge, die sich auf die von Ihnen gescrapte Website beziehen. Nutzer teilen dort oft Informationen zu Änderungen an der Website-Struktur.
-
Fehlerbehandlung: Implementieren Sie eine robuste Fehlerbehandlung in Ihren Code, die Sie benachrichtigt, wenn das Scraping fehlschlägt, sodass Sie Ihren Code entsprechend anpassen können.
-
Erkenntnisse aus der Community: StackOverflow ist eine hervorragende Anlaufstelle, um Workarounds oder alternative Methoden für das Scraping zu finden, wenn eine Website ihre Codestruktur ändert.
Wenn Sie diese fortgeschrittenen Techniken beherrschen, sind Sie besser darauf vorbereitet, eine Vielzahl von Herausforderungen beim Web-Scraping zu meistern. Ganz gleich, ob Sie es mit dynamischen Inhalten, speziellen Daten oder sich ändernden Website-Strukturen zu tun haben – diese Methoden vermitteln Ihnen die Fähigkeiten, die Sie für eine effektive Datenerfassung benötigen.
Datenanalyse und -nutzung
Nachdem Sie die Daten erfolgreich erfasst haben, besteht der nächste Schritt darin, diese zu analysieren und effektiv zu nutzen.
Dieser Abschnitt führt Sie durch den Prozess der Analyse der gesammelten Daten, der Erstellung Ihres eigenen Preismodells sowie der Erstellung und Aktualisierung von Angebotsprofilen.
So analysieren Sie die gesammelten Daten
-
Datenbereinigung. Der erste Schritt bei jeder Datenanalyse ist die Bereinigung der Daten. Entfernen Sie Duplikate, behandeln Sie fehlende Werte und konvertieren Sie gegebenenfalls Datentypen.
-
Datenvisualisierung. Verwenden Sie Bibliotheken wie Matplotlib oder Seaborn, um die Daten zu visualisieren. Dies kann Ihnen helfen, Trends, Ausreißer oder Muster zu erkennen.
-
Statistische Analyse. Verwenden Sie statistische Methoden, um die Daten zusammenzufassen. Berechnen Sie Mittelwerte, Mediane, Standardabweichungen usw., um ein besseres Verständnis der Datenverteilung zu erhalten.
-
Textanalyse. Wenn Sie Textdaten gescrapt haben, sollten Sie den Einsatz von Techniken der Natürlichen Sprachverarbeitung (NLP) in Betracht ziehen, um Erkenntnisse zu gewinnen.
-
Korrelationsanalyse. Identifizieren Sie Variablen, die stark miteinander korrelieren. Dies kann insbesondere im Immobilienbereich hilfreich sein, um zu verstehen, wie sich verschiedene Faktoren auf die Immobilienpreise auswirken.
Häufige Herausforderungen und Lösungen
Web-Scraping ist nicht ohne Herausforderungen. Von CAPTCHAs und Ratenbeschränkungen bis hin zu Bedenken hinsichtlich Datenqualität und -zuverlässigkeit – dieser Abschnitt soll Sie auf einige der Hürden vorbereiten, denen Sie möglicherweise begegnen, und Lösungen zu deren Überwindung anbieten.
CAPTCHAs
-
- Problem: Viele Websites setzen CAPTCHAs ein, um automatisiertes Scraping zu verhindern.
- Lösung: Sie können Dienste wie 2Captcha oder Anti-Captcha nutzen, um CAPTCHAs automatisch zu lösen. Alternativ kann Selenium verwendet werden, um das CAPTCHA während des Scraping-Vorgangs manuell zu lösen.
Ratenbegrenzungen
-
- Problem: Websites verfügen oft über Ratenbegrenzungen, um die Anzahl der Anfragen von einer einzelnen IP-Adresse zu beschränken.
- Lösung: Implementieren Sie eine Ratenbegrenzung in Ihrem Code, um die Nutzungsbedingungen der Website einzuhalten. Sie können auch Proxy-Dienste nutzen, um IP-Adressen zu wechseln. Die Residential-Proxys von Geonode sind hierfür ein hervorragender Dienst.
Unvollständige Daten
-
- Problem: Manchmal können die gescrapten Daten aufgrund von dynamischem Laden oder anderen Problemen unvollständig sein.
- Lösung: Verwenden Sie Selenium, um sicherzustellen, dass die Seite vollständig geladen ist, bevor Sie mit dem Scraping beginnen. Sie können auch die Wartefunktionen nutzen, um den Code anzuhalten, bis bestimmte Elemente geladen sind.
Inkonsistente Daten
-
- Problem: Die Struktur der Website kann sich im Laufe der Zeit ändern, was zu inkonsistenten Daten führt.
- Lösung: Aktualisieren Sie Ihren Scraping-Code regelmäßig, um ihn an etwaige Änderungen in der Struktur der Website anzupassen. Implementieren Sie eine robuste Fehlerbehandlung, die Sie benachrichtigt, wenn das Scraping fehlschlägt.
Datenvalidierung
-
- Problem: Die gescrapten Daten können Fehler oder Ungenauigkeiten enthalten.
- Lösung: Überprüfen Sie Ihre Daten stets anhand mehrerer Quellen oder verwenden Sie Prüfsummen, um die Datenintegrität sicherzustellen.
Rechtliche und ethische Bedenken
-
- Problem: Das Scraping von Daten kann unter Umständen gegen die Nutzungsbedingungen der Website verstoßen.
- Lösung: Lesen und befolgen Sie stets die Nutzungsbedingungen der Website sowie die „robots.txt“-Datei. Halten Sie sich an die Regeln und Richtlinien der Website.
Wenn Sie sich dieser häufigen Herausforderungen und ihrer Lösungen bewusst sind, sind Sie besser darauf vorbereitet, alle Probleme zu bewältigen, die bei Ihren Web-Scraping-Aktivitäten auftreten können.
Häufig gestellte Fragen
Wie kann ich Immobilien-Websites ohne Programmierkenntnisse auswerten?
Sie können No-Code-Web-Scraping-Tools wie WebHarvy, Octoparse oder Import.io verwenden. Diese Tools bieten benutzerfreundliche Oberflächen für die Datenextraktion per Mausklick.
Was sind die besten Python-Bibliotheken für das Web-Scraping?
Die am häufigsten verwendeten Python-Bibliotheken für das Web-Scraping sind BeautifulSoup zum Parsen von HTML und XML sowie Selenium für die Interaktion mit JavaScript-lastigen Websites. Scrapy ist eine weitere Option für komplexere Projekte.
Ist Web-Scraping legal?
Die Rechtmäßigkeit von Web-Scraping hängt von den Nutzungsbedingungen der Website und der Art und Weise ab, wie Sie die Daten verwenden. Lesen Sie stets die Nutzungsbedingungen der Website und ziehen Sie gegebenenfalls rechtlichen Rat ein, um die Einhaltung der Vorschriften sicherzustellen.
Weitere Ressourcen
Nachdem wir uns nun mit den verschiedenen Aspekten des Web-Scrapings befasst haben – von der Einrichtung Ihrer Umgebung bis hin zur Bewältigung von Herausforderungen –, ist es an der Zeit, ein Fazit zu ziehen und einen Blick auf die nächsten Schritte zu werfen.
Offizielle Dokumentation. Immer ein guter Ausgangspunkt. BeautifulSoup, Selenium und andere Bibliotheken verfügen über umfangreiche Dokumentationen, die Ihnen helfen, ihre Funktionen besser zu verstehen.
Online-Kurse. Websites wie Udemy, Coursera und edX bieten Kurse zum Thema Web-Scraping und Datenanalyse an.
YouTube-Tutorials. Es gibt unzählige Tutorials, die alles von den Grundlagen bis hin zu fortgeschrittenen Techniken abdecken.
Foren und Communities. Websites wie StackOverflow und Reddit verfügen über aktive Communities, in denen Sie Fragen stellen und Wissen austauschen können.
Bücher. Es gibt auch mehrere Bücher, die sich mit Web-Scraping und Techniken zur Datenerfassung befassen.
Zusammenfassung
Nun, da Sie über das nötige Wissen und die erforderlichen Werkzeuge für effektives Web-Scraping verfügen, ist es an der Zeit, diese in die Praxis umzusetzen.
Fangen Sie klein an, experimentieren Sie und scheuen Sie sich nicht, sich an komplexere Projekte zu wagen, sobald Sie mehr Sicherheit gewonnen haben.
Denken Sie daran: Der Schlüssel zum erfolgreichen Web-Scraping liegt nicht nur im Sammeln von Daten, sondern darin, diese in verwertbare Erkenntnisse umzuwandeln.

