Geonode logo

Crawl. Kostenloser Beta-Zugang

Crawlen Sie eine gesamte Website und erhalten Sie saubere Daten von jeder Seite
URL senden
Crawlt die gesamte Website oder einen Bereich davon
Pauschal monatlich oder pro Request
Kostenlos1.500 Requests/Monat
Saubere Daten pro Seite
  • HTML
  • Markdown

Unbegrenzt oder pro Request bezahlen

Ein Tarif deckt Scraper, Map, Crawl und Search ab. Keine Credits, keine Multiplikatoren, keine Überraschungen auf der Rechnung.

  • Kostenloser Tarif

    $0/ Monat

    1,500 Requests / Monat

    • Parallelität1
    • Batch-Größe5 URLs
    • Seiten pro Crawl10
    • Setzt sich monatlich zurück
    • Keine Kreditkarte erforderlich
    • Fehlgeschlagene Requests werden nie berechnet – an jedem Endpunkt
  • Tarife pro Request

    $62.50/ Monat

    250,000 Requests / Monat

    Requests:
    • Parallelität50
    • Batch-Größe100 URLs
    • Seiten pro Crawl200
    • Ungenutzte Requests werden übertragen
    • Fehlgeschlagene Requests werden nie berechnet – an jedem Endpunkt
  • Unbegrenzte Tarife

    $1,000/ Monat

    Unbegrenztes Request-Volumen

    Threads:
    • Ideal für bis zu7M Requests/Mon.
    • Batch-Größe1,000 URLs
    • Seiten pro Crawl1,000
    • Unbegrenzte Requests, Pauschalpreis
    • Alle Endpunkte enthalten
  • Pay As You Go

    ab $0.40/ 1.000 Requests

    Individuelle Request-Menge

    • Parallelität100
    • Batch-Größe500 URLs
    • Seiten pro Crawl500
    • Ungenutzte Requests werden übertragen
    • $50 Mindestbestellung
    • Fehlgeschlagene Requests werden nie berechnet – an jedem Endpunkt

So bieten wir niedrige Preise bei erstklassiger Qualität

Die meisten Scraping-APIs laufen auf gemieteter Infrastruktur mit credit-basierten Preisen. Deshalb ist Ihre Rechnung unvorhersehbar. Wir haben den umgekehrten Weg gewählt, und die Rechnung geht auf.
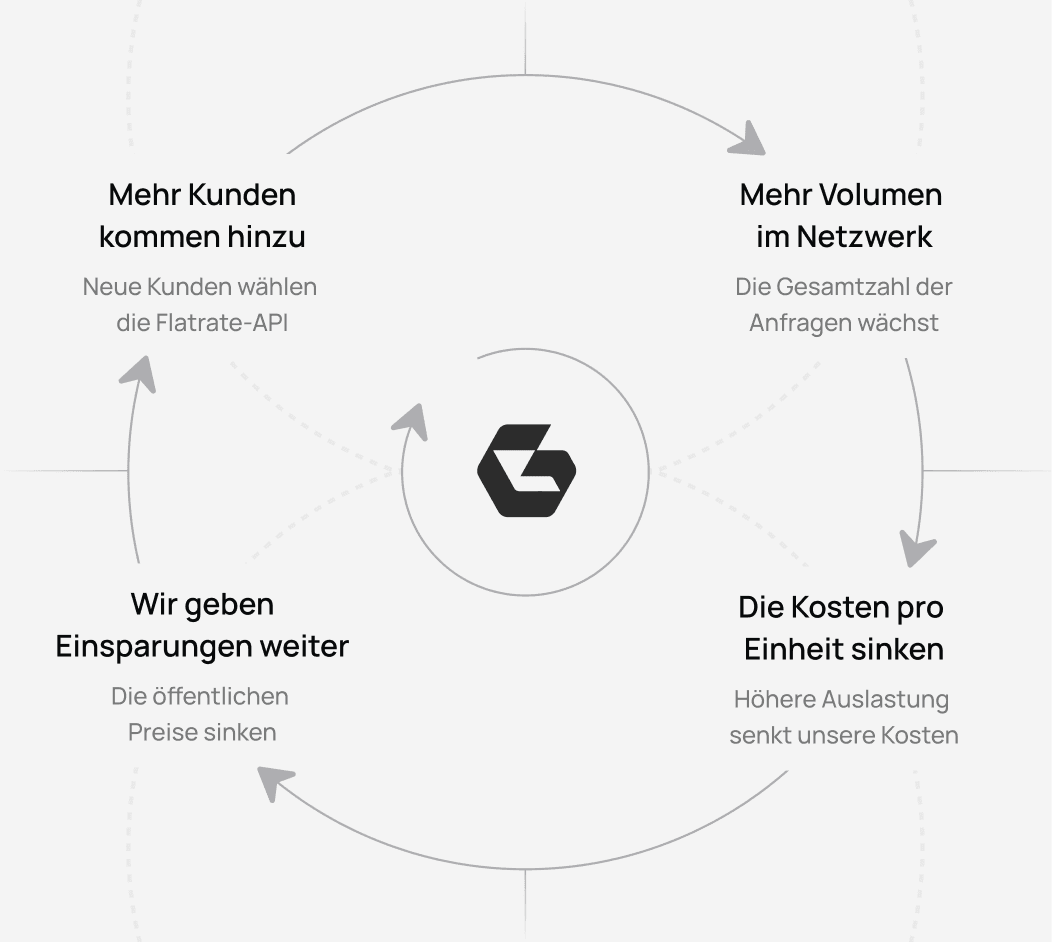
Wie mehr Kunden, der Betrieb unseres eigenen Netzwerks, Wholesale-Preise und niedrigere Kosten sich gegenseitig verstärken

Code-Schnellstart

Fügen Sie die Geonode Crawl API zu Ihrer App hinzu und erfassen Sie eine ganze Website in einem Job

import requests

r = requests.post(
  "https://scraper.geonode.io/v1/extract",
  headers={"X-Api-Key": "YOUR_API_KEY", "Content-Type": "application/json"},
  json={"url": "https://example.com", "formats": ["markdown"], "processing_mode": "sync"},
)
print(r.json())

In Sekunden mit dem Scraping starten

Konto erstellen

Registrieren Sie sich und erhalten Sie 1.500 kostenlose Anfragen zum Start. Keine Kreditkarte erforderlich
Anmeldeformular mit Feldern für E-Mail und Passwort im Dashboard

Request senden

Senden Sie jede beliebige URL mit einem einfachen API-Call an den Scraping-Endpoint

Steuerung für Gateway-Land und Sitzungstyp im Dashboard

Saubere Daten erhalten

Erhalten Sie geparstes HTML oder Markdown

Format des Proxy-Endpoints und Verbindungsdetails

Bei Skalierung zu Unlimited wechseln

Wechseln Sie zu einem Pauschaltarif nach Parallelität oder bleiben Sie bei pro Request. Keine Credits, keine Überraschungen bei der Messung.

Codebeispiele und Integrationsausschnitte im Dashboard

FAQ

Senden Sie eine POST-Anfrage an /v1/crawl mit Ihrem Geonode-API-Schlüssel und der URL, die Sie crawlen möchten. Die URL ist das einzige Pflichtfeld; Crawl-Einstellungen wie Tiefe, Seitenlimit, Ausgabeformat und JavaScript-Rendering sind optional.

Jeder Crawl liefert eine eindeutige job_id. Damit rufen Sie den Crawl-Status ab und überwachen die Gesamt-, abgeschlossenen und fehlgeschlagenen Seitenzahlen, bis der Job fertig ist.

Ja. Sie können den Crawl so konfigurieren, dass extrahierter Seiteninhalt in den unterstützten Ausgabeformaten zurückgegeben wird, einschließlich Markdown. Das gewählte Format gilt für die vom Crawl verarbeiteten Seiten.

Ja. Crawl-Anfragen unterstützen Proxy-Konfiguration inklusive Länder-Targeting, sodass Sie Inhalte so abrufen können, wie sie von einem ausgewählten Standort aus erscheinen – sofern unterstützt.

Ja. Für dynamische Websites können Sie JavaScript-Rendering zusammen mit wait_config nutzen, um zu steuern, wann eine Seite zur Extraktion bereit ist – z. B. bis Netzwerkaktivität endet oder ein bestimmtes Element erscheint.

Ja. Mit GET /v1/crawl/jobs können Sie frühere Crawl-Jobs auflisten. Die Antwort enthält Job-Status, Crawl-Statistiken, Konfigurationsdetails und Paginierungsinformationen.

Schluss mit Credit-Mathematik. Fangen Sie an zu crawlen.

1.500 Requests/Monat kostenlos. Keine Kreditkarte.