Media.net ist ein führendes Unternehmen im Bereich Werbetechnologie, das eine breite Palette an Lösungen für Publisher, Werbetreibende und Agenturen anbietet. 
Mit seinem Schwerpunkt auf kontextbezogener Werbung hat sich Media.net als wichtiger Akteur im Ökosystem der digitalen Werbung etabliert.
Das Unternehmen bietet eine Plattform, die die Monetarisierung von Website-Inhalten durch hochrelevante Anzeigen ermöglicht und so eine Win-Win-Situation für Publisher und Werbetreibende schafft.
Warum Daten von Media.net scrapen?
Umsatzmaximierung
Das Scraping von Media.net ermöglicht es Publishern und Werbetreibenden, die verfügbaren Anzeigenformate und Preismodelle zu verstehen, was zur Entwicklung effektiverer Marketingstrategien und Geschäftspläne zur Umsatzmaximierung beiträgt.
Wettbewerbsanalyse
Media.net ist ein weltweit führendes Unternehmen in der Ad-Tech-Branche. Das Sammeln von Daten dieser Plattform liefert Wettbewerbsinformationen, die entscheidend sein können, um Markttrends zu verstehen und Ihre Geschäftsstrategie zu gestalten.
Engagement-Kennzahlen
Media.net legt großen Wert auf die Nutzererfahrung und bietet maßgeschneiderte Native-Ads an. Die Analyse von Engagement-Kennzahlen wie den Interaktionsraten echter Nutzer kann Ihnen helfen, Ihre eigenen Strategien zur Nutzerbindung zu optimieren.
Technologische Einblicke
Media.net setzt modernste Technologien wie formatübergreifendes Header-Bidding ein. Das Verständnis dieser Technologien kann Ihnen einen Wettbewerbsvorteil bei der Nutzung ähnlicher Technologien verschaffen.
Rechtliche und ethische Compliance
Die Einhaltung der Nutzungsbedingungen und Qualitätsrichtlinien von Media.net ist unerlässlich. Das Data Scraping muss in einer Weise erfolgen, die diesen Richtlinien entspricht, um ethische Praktiken zu gewährleisten.
Anwendungsfälle für das Scraping von Media.net
Wettbewerbsanalyse
Das Scraping von Media.net liefert Einblicke in deren Werbeangebote, Preismodelle und Marktpositionierung. Diese Wettbewerbsinformationen sind von unschätzbarem Wert für Unternehmen, die ihre Position in der Branche besser verstehen möchten.
Marktforschung
Daten von Media.net können Markttrends und Verbraucherpräferenzen aufzeigen und Unternehmen dabei helfen, ein ideales Kundenprofil zu erstellen und ihre Angebote entsprechend anzupassen.
Preisstrategien
Das Scraping von Preisdaten von Media.net kann zu wettbewerbsfähigeren Preisstrategien beitragen, indem es ein klares Verständnis der Marktpreise für verschiedene Anzeigentypen vermittelt.
Stimmungsanalyse
Sofern verfügbar, können Nutzerbewertungen oder Kommentare auf Media.net Einblicke in die Marktstimmung und die Kundenzufriedenheit bieten. Diese Daten können sowohl Media.net als auch seinen Wettbewerbern dabei helfen, Verbesserungsmöglichkeiten zu identifizieren oder Stärken auszuschöpfen.
Durch die Einbindung des Data Scraping in Ihre Geschäftsabläufe können Sie den gesamten Prozess der Gewinnung umsetzbarer Erkenntnisse für strategische Entscheidungen optimieren.
Rechtliche und ethische Überlegungen
Die Beherrschung der rechtlichen und ethischen Rahmenbedingungen des Datenerfassungsprozesses ist für jeden entscheidend, der Daten von Media.net sammeln möchte.
Web-Scraping kann zwar unschätzbare Einblicke liefern, doch ist es wichtig, verantwortungsbewusst damit umzugehen, um rechtliche Konsequenzen zu vermeiden.
Beachtung der robots.txt
Die robots.txt-Datei ist ein Standard, den Websites verwenden, um Webcrawling- und Scraping-Bots anzuleiten, welche Seiten abgerufen werden dürfen und welche nicht.
Bevor Sie ein Web-Scraping-Projekt auf Media.net starten, müssen Sie unbedingt die robots.txt-Datei der Website konsultieren.
Diese Datei gibt an, welche Bereiche der Website gesperrt sind und welche für das Data Scraping zugänglich sind.
Das Ignorieren der Anweisungen in dieser Datei kann nicht nur dazu führen, dass Ihre IP-Adresse gesperrt wird, sondern Sie auch rechtlichen Risiken aussetzen.
Die Nutzungsbedingungen von Media.net verstehen
Die Nutzungsbedingungen (ToS) von Media.net sind eine rechtliche Vereinbarung, die die Regeln, Bedingungen und Richtlinien für die Nutzung der Plattform festlegt.
Es ist unerlässlich, diese Bedingungen zu lesen und zu verstehen, bevor Sie mit dem Scraping von Daten von der Website beginnen.
Ein Verstoß gegen die Nutzungsbedingungen kann eine Reihe von Konsequenzen nach sich ziehen, die von einer vorübergehenden Sperrung Ihres Kontos bis hin zu rechtlichen Schritten reichen können.
Achten Sie in den Nutzungsbedingungen auf Abschnitte, die sich speziell mit dem Datenscraping oder dem automatisierten Zugriff auf die Plattform befassen.
Wenn das Web-Scraping in den Nutzungsbedingungen ausdrücklich verboten ist, müssen Sie eine schriftliche Genehmigung von Media.net einholen, um fortfahren zu können.
Ethische Richtlinien für das Web-Scraping
Über rechtliche Aspekte hinaus ist ethisches Verhalten von größter Bedeutung, wenn Daten von einer Website, einschließlich Media.net, gescrapt werden. Hier sind einige ethische Richtlinien, die Sie beachten sollten:
Serverauslastung minimieren
Stellen Sie sicher, dass Ihre Web-Scraping-Aktivitäten die Dienste von Media.net nicht überlasten oder stören.
Verwenden Sie Ratenbegrenzungen und stellen Sie Anfragen in einer Häufigkeit, die dem menschlichen Surfverhalten entspricht.
Datennutzung
Seien Sie transparent hinsichtlich Ihrer Absichten bei der Verwendung der gescrapten Daten. Wenn die Daten veröffentlicht oder für kommerzielle Zwecke genutzt werden sollen, holen Sie die Genehmigung von Media.net ein.
Datenschutz
Wenn Sie nutzergenerierte Inhalte scrapen, achten Sie darauf, keine personenbezogenen Daten zu erheben, es sei denn, dies ist für Ihr Projekt unbedingt erforderlich.
Werden personenbezogene Daten erhoben, sollten diese anonymisiert und sicher gespeichert werden.
Quellenangabe
Wenn Sie beabsichtigen, die Daten oder daraus abgeleitete Erkenntnisse zu veröffentlichen, geben Sie Media.net ordnungsgemäß als Quelle der Daten an.
Durch die Einhaltung dieser rechtlichen und ethischen Richtlinien können Sie Ihre Web-Scraping-Aktivitäten auf verantwortungsvolle und respektvolle Weise durchführen. Dies minimiert nicht nur Risiken, sondern trägt auch zur Integrität und Glaubwürdigkeit Ihrer Datenanalyse oder Ihres Business-Intelligence-Projekts bei.
Tools und Technologien
Der Erfolg eines Web-Scraping-Projekts hängt oft von den eingesetzten Tools und Technologien ab.
Durch den Einsatz dieser Tools und Technologien können Sie eine robuste Web-Scraping-Pipeline zum Sammeln von Daten aus Media.net aufbauen.
Ganz gleich, ob Sie Anfänger oder Experte sind – die richtige Kombination dieser Ressourcen kann die Effizienz und Effektivität Ihrer Web-Scraping-Projekte erheblich steigern.
Programmiersprachen
Python
Python ist eine vielseitige Sprache, die aufgrund ihrer Benutzerfreundlichkeit und umfangreichen Bibliotheken häufig für das Web-Scraping eingesetzt wird.
Sie ermöglicht die schnelle Entwicklung und Bereitstellung von Web-Scraping-Skripten und eignet sich daher ideal sowohl für Anfänger als auch für Experten mit viel Programmiererfahrung.
JavaScript
JavaScript, insbesondere Node.js, ist eine weitere leistungsstarke Sprache für das Web-Scraping.
Sie ist besonders nützlich im Umgang mit Websites, die zum Laden von Inhalten stark auf JavaScript angewiesen sind, da sie direkt mit dem DOM (Document Object Model) interagieren kann.
Bibliotheken und Frameworks
BeautifulSoup
BeautifulSoup ist eine Python-Bibliothek, die sich hervorragend für Einsteiger in das Web-Scraping eignet.
Sie ermöglicht eine einfache Navigation und Bearbeitung von HTML- und XML-Dokumenten und macht die Datenextraktion unkompliziert.
Scrapy
Scrapy ist ein fortgeschritteneres Python-Framework, das für Web-Scraping und Crawling entwickelt wurde.
Es bietet integrierte Unterstützung für die Verarbeitung verschiedener Datenformate und den Export von gescrapten Daten, wodurch es sich für groß angelegte Projekte eignet.
Selenium
Selenium wird häufig zum Scraping von Websites verwendet, die reich an JavaScript sind. Es automatisiert die Interaktion mit dem Browser und ermöglicht es Ihnen, dynamisch geladene Daten zu scrapen.
Proxy-Dienste
Die Bedeutung der Verwendung von Proxys beim Scraping
Die Verwendung von Proxys ist beim groß angelegten Scraping entscheidend, um eine Erkennung und IP-Sperrung zu vermeiden. Proxys ermöglichen zudem geotargetetes Scraping, was für die Erfassung standortspezifischer Daten unerlässlich sein kann.
„Geonode“-Proxys
„Geonode“-Proxys bieten ein Maß an Anonymität und Sicherheit und eignen sich daher ideal für Web-Scraping-Projekte.
Sie helfen dabei, IP-Sperren und Ratenbeschränkungen zu umgehen, die von Websites wie Media.net verhängt werden.
Integration von „Geonode“-Proxys in Ihren Scraping-Code
Um „Geonode“-Proxys einzurichten, müssen Sie zunächst ein Konto erstellen und dieses anschließend in Ihren Code integrieren.
Die meisten Programmiersprachen und Scraping-Bibliotheken bieten einfache Möglichkeiten zur Einrichtung von Proxy-Konfigurationen.
In Python können Sie beispielsweise die „Requests“-Bibliothek verwenden, um „Geonode“-Proxys problemlos zu integrieren.
Browser-Erweiterungen
Web Scraper
Web Scraper ist eine Browser-Erweiterung, die einfaches Web-Scraping per Mausklick ermöglicht.
Sie eignet sich hervorragend für kleinere Projekte und für Einsteiger in das Web-Scraping.
Data Miner
Data Miner ist eine weitere Browser-Erweiterung, die vorgefertigte „Rezepte“ für das Data Scraping bietet.
Sie ist nützlich, um Daten von Websites zu extrahieren, ohne Code schreiben zu müssen, ist jedoch möglicherweise nicht für komplexere Scraping-Anforderungen geeignet.
Einrichten der Entwicklungsumgebung
Bevor wir uns mit dem eigentlichen Web-Scraping-Prozess befassen, ist es unerlässlich, eine geeignete Entwicklungsumgebung einzurichten.
Dazu gehört die Installation der notwendigen Software und Bibliotheken, die im Laufe des Projekts verwendet werden.
Python und pip installieren
-
Python herunterladen. Besuchen Sie die offizielle Python-Website und laden Sie die für Ihr Betriebssystem geeignete aktuelle Version herunter.
-
Installation. Führen Sie das Installationsprogramm aus und folgen Sie den Anweisungen auf dem Bildschirm. Achten Sie darauf, während der Installation das Kontrollkästchen „Python zum PATH hinzufügen“ zu aktivieren.
-
Installation überprüfen. Öffnen Sie die Eingabeaufforderung oder das Terminal und geben Sie python --version ein, um sicherzustellen, dass Python korrekt installiert wurde.
-
Installieren Sie pip. Pip (Package Installer for Python) ist in der Regel bereits mit Python vorinstalliert.
Sie können die Installation überprüfen, indem Sie in der Eingabeaufforderung oder im Terminal „pip --version“ eingeben.
Einrichten eines Code-Editors
- Laden Sie Visual Studio Code herunter. Besuchen Sie die Visual Studio Code-Website und laden Sie die mit Ihrem Betriebssystem kompatible Version herunter.
- Installation. Führen Sie das Installationsprogramm aus und befolgen Sie die Anweisungen zur Einrichtung.
- Erweiterungen. Nach der Installation können Sie Erweiterungen wie Python, Beautify und IntelliSense hinzufügen, um Ihr Programmiererlebnis zu verbessern.
Installation der erforderlichen Bibliotheken und Frameworks
Öffnen Sie Ihr Terminal und installieren Sie die folgenden Python-Bibliotheken:
- BeautifulSoup:
pip install beautifulsoup4
- Scrapy:
pip install scrapy
- Selenium:
pip install selenium
Datenpunkte identifizieren
Navigation auf der Website von Media.net
Bevor Sie mit dem Programmieren beginnen, sollten Sie sich etwas Zeit nehmen, um sich auf der Website von Media.net umzuschauen, um deren Struktur zu verstehen und die Datenpunkte zu identifizieren, die Sie auslesen möchten.
Die Struktur der Media.net-Website verstehen
Die Media.net-Website dient als Plattform für kontextbezogene Werbung und programmatische Lösungen. Sie richtet sich sowohl an Werbetreibende als auch an Publisher und bietet eine Vielzahl von Diensten zur Umsatzmaximierung. Die Website ist in mehrere Hauptbereiche unterteilt, darunter:
- Startseite. Einführung in Media.net und seine Dienste.
- Marktplatz. Informationen zur wettbewerbsorientierten Nachfrage aus verschiedenen Quellen zur Ertragsmaximierung.
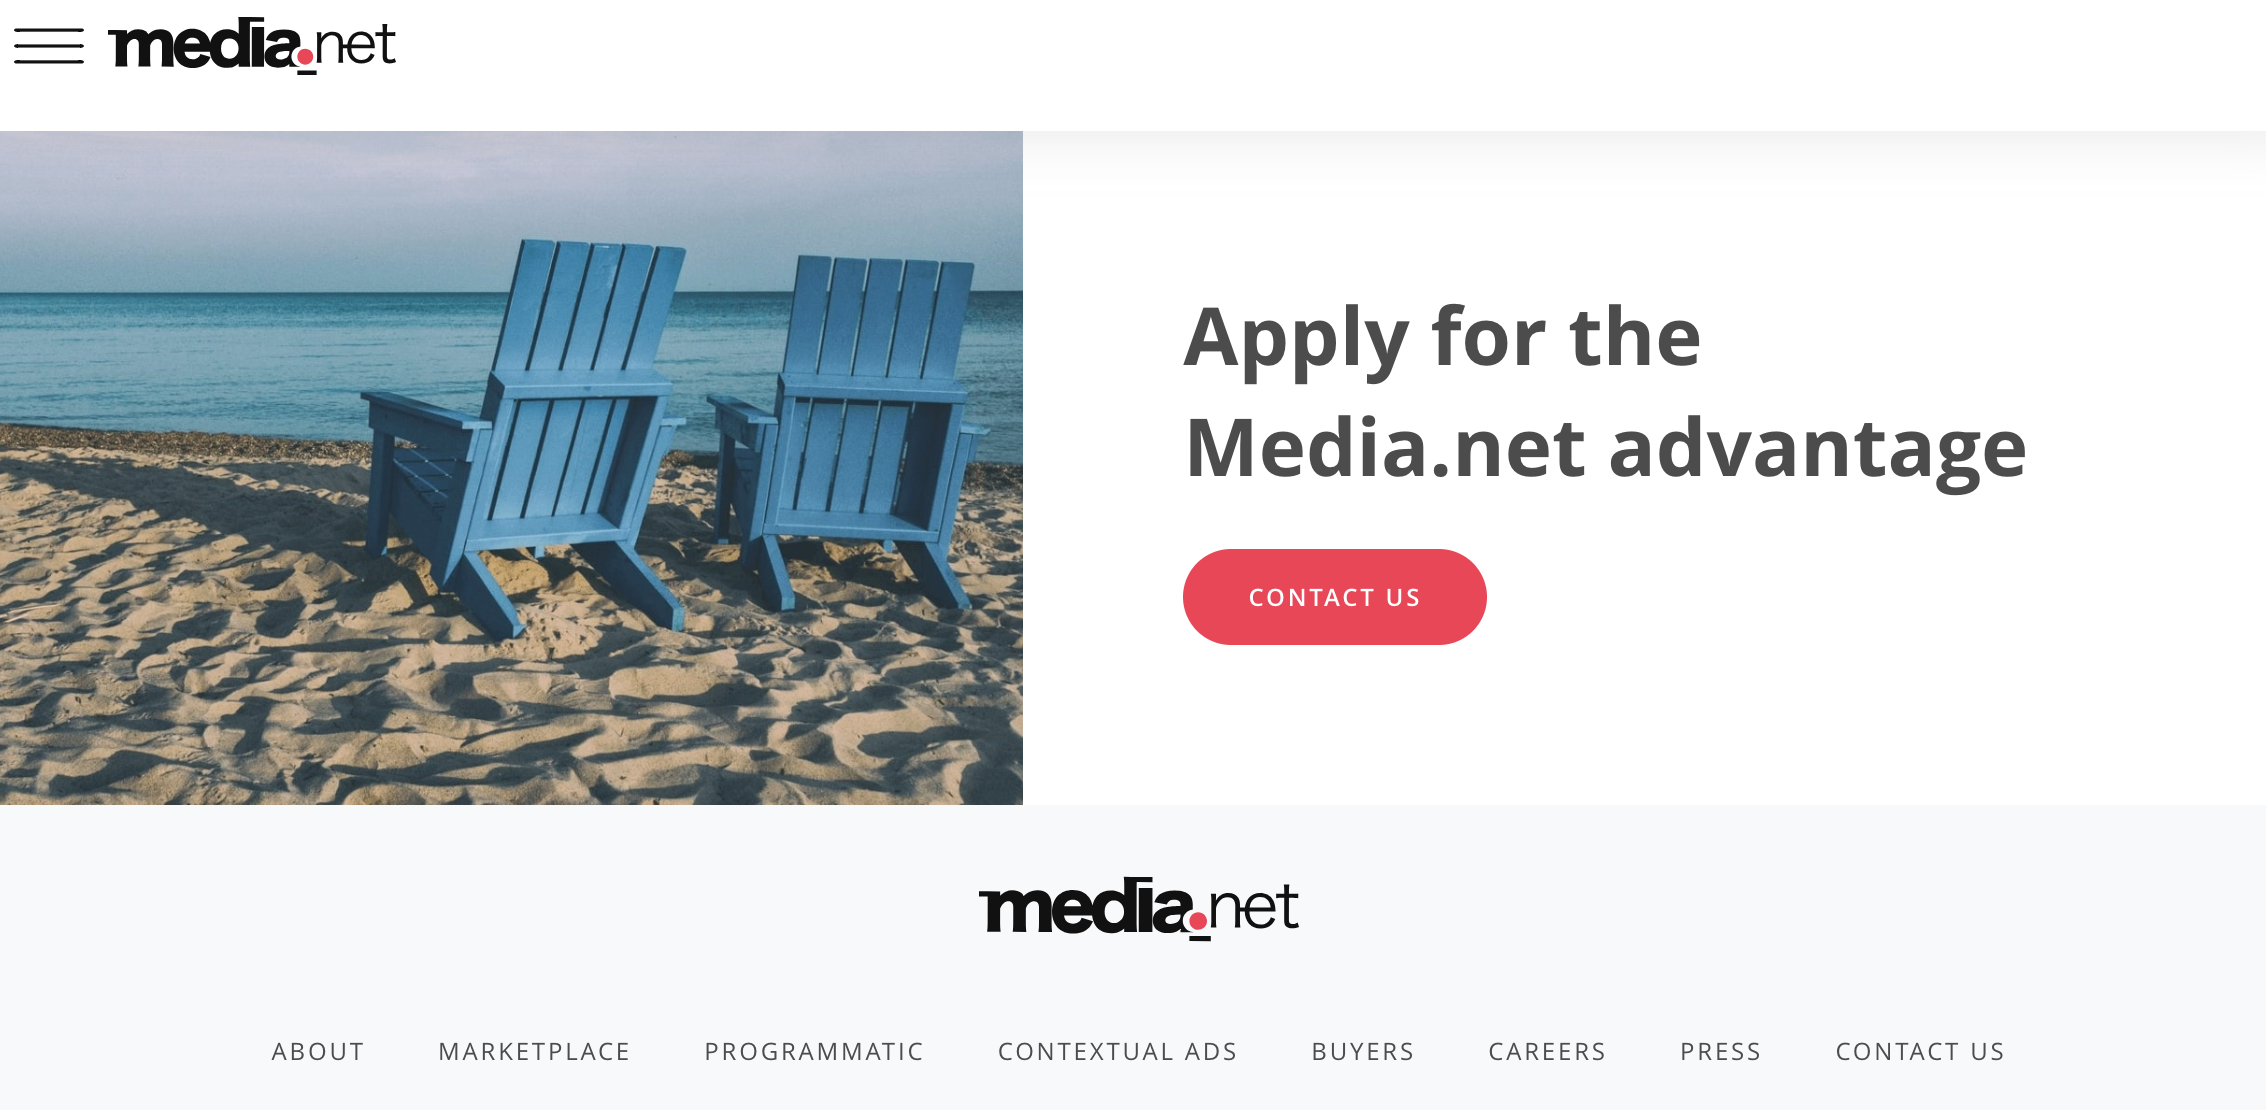
- Kontextbezogene Anzeigen. Details zum proprietären Anzeigenformat von Media.net, das Suchbegriffe für gezielte Werbung nutzt.
- Programmatic. Informationen zu ihrer formatübergreifenden Header-Bidding-Plattform der nächsten Generation.
- Käufer. Ein Bereich, der wahrscheinlich potenziellen Werbekunden gewidmet ist.
- Über uns. Hintergrundinformationen zu Media.net.
- Anmelden. Für bestehende Nutzer, um sich in ihr Konto einzuloggen.
- Kontakt. Für Anfragen und Support.
Die Website bietet außerdem zusätzliche Informationen zu Display-Anzeigen und Native-Anzeigen und erläutert, wie Publisher davon profitieren können.
Identifizierung der wichtigsten zu extrahierenden Daten
Legen Sie fest, welche konkreten Daten Sie von Media.net extrahieren möchten. Dies kann von den angebotenen Anzeigenformaten über Preismodelle bis hin zu Blogbeiträgen und Artikeln reichen. Erstellen Sie eine Liste dieser Datenpunkte, da diese als Grundlage für Ihre Scraping-Logik dienen.
Den Code schreiben
Sobald Ihre Umgebung eingerichtet ist und Sie die Datenpunkte identifiziert haben, die Sie auslesen möchten, besteht der nächste Schritt darin, den Code zu schreiben.
Web-Scraping kann manuell oder mithilfe automatisierter Methoden erfolgen. Im Folgenden werden wir beide Ansätze näher betrachten und jeweils Beispielcode-Schnipsel bereitstellen.
Manuelles Scraping
Schritte und Einschränkungen
Beim manuellen Scraping navigiert man durch die Website und kopiert die Daten manuell in eine Tabellenkalkulation oder ein ähnliches Speichermedium.
Diese Methode ist zwar unkompliziert, aber zeitaufwendig und für große Datensätze nicht praktikabel.
Automatisiertes Scraping
Automatisiertes Scraping ist die effizienteste Methode zur Datenerfassung, insbesondere bei groß angelegten Projekten. Wir werden uns ansehen, wie man Daten mit BeautifulSoup, Scrapy und Selenium ausliest.
Verwendung von BeautifulSoup
Beispiel-Codeausschnitte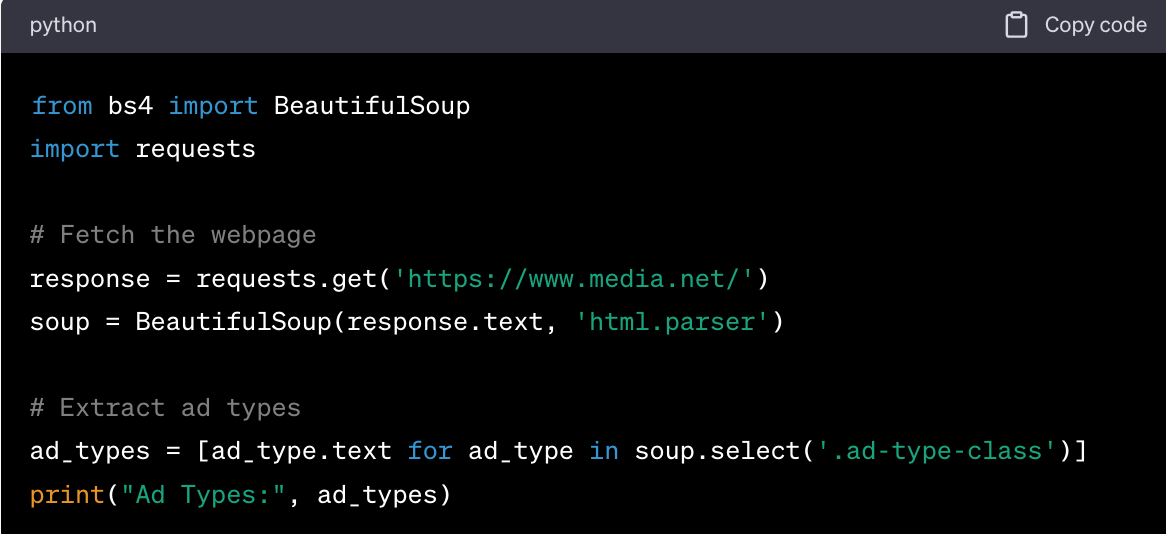
Erläuterung des Codes
- Importiere die BeautifulSoup-Bibliothek und das „requests“-Modul.
- Rufe den Inhalt der Webseite mit „
requests.get()“ ab.
- Analysiere den HTML-Inhalt mit BeautifulSoup.
- Extrahieren Sie die Anzeigentypen mithilfe der Methode „
.select()“, wobei Sie auf die spezifische Klasse abzielen, die diese Informationen enthält.
Verwendung von Scrapy
Beispiel-Codeausschnitte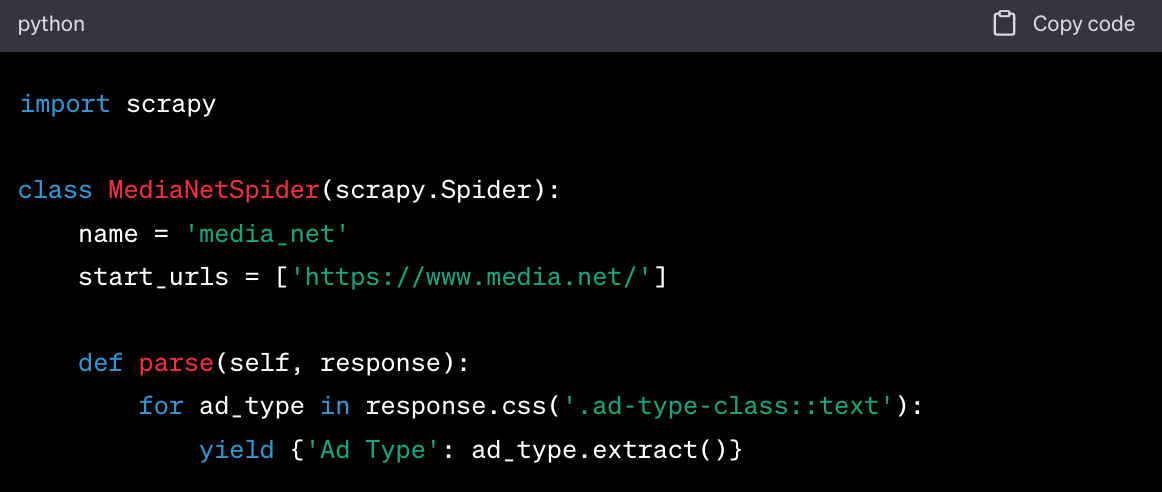
Erläuterung des Codes
- Importieren Sie die Scrapy-Bibliothek.
- Definieren Sie eine Spider-Klasse, die von
scrapy.Spider erbt.
- Geben Sie die zu scrapende URL in
start_urls an.
- Definieren Sie die Methode
parse, um die Anzeigentypen mithilfe der Methode .css() zu extrahieren.
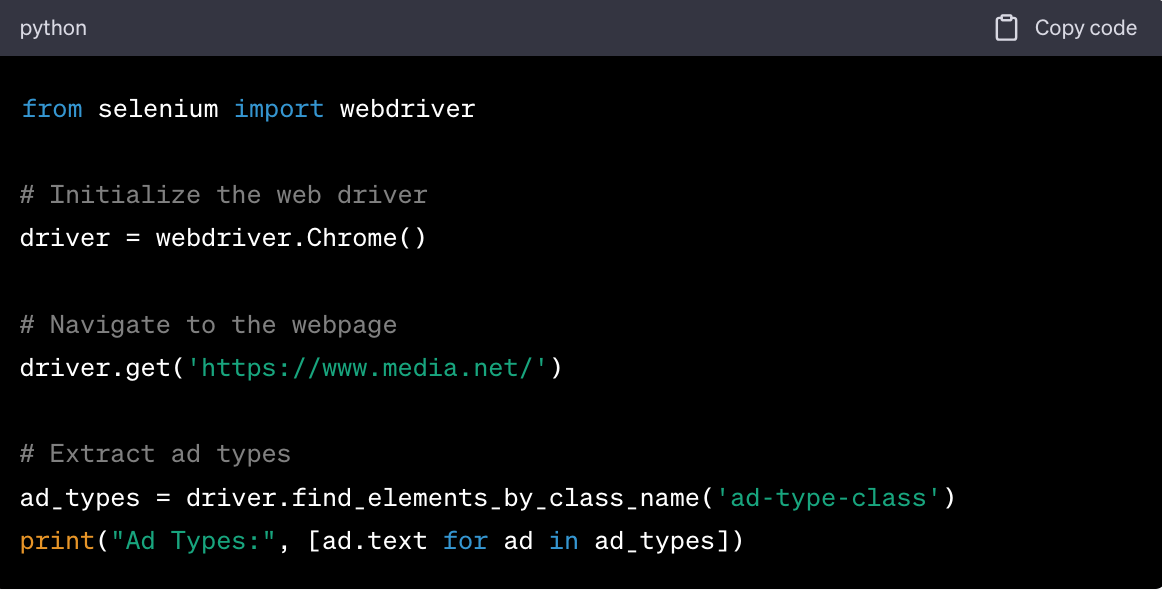
Verwendung von Selenium
Beispiel-Codeausschnitte
CSV
Sie können die in Python integrierte Bibliothek „csv“ verwenden, um die gescrapten Daten in einer CSV-Datei zu speichern.
Datenbank
Bei komplexeren Projekten empfiehlt es sich, die Daten in einer Datenbank wie MySQL oder MongoDB zu speichern.
Wenn Sie diese Schritte befolgen und diese Code-Schnipsel als Leitfaden nutzen, können Sie eine robuste Web-Scraping-Pipeline zum Sammeln von Daten von Media.net aufbauen.
Verwendung selbst erstellter Scraper
Selbst erstellte Web-Scraper bieten ein höheres Maß an Anpassungsmöglichkeiten und Kontrolle über die von Ihnen gesammelten Daten.
Mit Programmierkenntnissen können Sie spezifische Codezeilen schreiben, um bestimmte Elemente auf der Website von Media.net gezielt anzusprechen, was eine differenziertere Datenerfassung ermöglicht.
Maßgeschneiderte Scraper-Modelle sind ideal für diejenigen, die spezifische Datenanforderungen haben, die generische Scraper-Tools möglicherweise nicht erfüllen können.
Nutzung von Datenextraktionsdiensten
Datenextraktionsdienste verfügen oft über vorgefertigte Scraper-APIs und Tools, die für das tiefgehende Scraping von Webinhalten ausgelegt sind.
Scraping-Dienste können komplexe Datenextraktionsszenarien bewältigen, ohne dass Sie Codezeilen schreiben müssen.
Sie sind besonders nützlich für Unternehmen, denen Programmierkenntnisse fehlen, die aber dennoch wertvolle Erkenntnisse aus Plattformen wie Media.net gewinnen möchten.
Fehlerbehebung und häufig gestellte Fragen
Web-Scraping ist ein leistungsstarkes Werkzeug, birgt jedoch auch einige Herausforderungen.
Häufige Fehler und Lösungen
IP-Adresse wird blockiert
Lösung: Die Verwendung von Proxys ist eine gute Möglichkeit, um zu verhindern, dass Ihre IP-Adresse blockiert wird.
Geonode bietet eine Vielzahl von Proxy-Diensten an, mit denen Sie Daten anonym scrapen können und so das Risiko einer IP-Blockierung verringern.
Ratenbegrenzung überschritten
Lösung: Implementieren Sie eine Ratenbegrenzung in Ihren Code, um die Häufigkeit Ihrer Anfragen zu steuern.
Sie können auch Proxys von Geonode verwenden, um IP-Adressen zu wechseln, was Ihnen helfen kann, Ratenbegrenzungen zu vermeiden.
Unvollständige oder ungenaue Daten
Lösung: Dies tritt in der Regel auf, wenn sich die Struktur der Website ändert.
Achten Sie stets darauf, Ihren Code entsprechend dem aktuellen Layout der Website anzupassen.
Timeout-Fehler
Lösung: Erhöhen Sie das Timeout-Limit in Ihrem Code.
Ziehen Sie außerdem die Verwendung von Geonode-Proxys in Betracht, um eine zuverlässigere Verbindung zu gewährleisten.
Häufig gestellte Fragen
Wie kann man Media.net scrapen, ohne blockiert zu werden?
Die Verwendung von Geonode-Proxys kann Ihnen helfen, Media.net zu scrapen, ohne blockiert zu werden.
Diese Proxys verbergen Ihre IP-Adresse, wodurch es für Websites schwieriger wird, Scraping-Aktivitäten zu erkennen.
Ist das Scraping von Media.net legal?
Lesen Sie immer die Nutzungsbedingungen von Media.net, um deren Richtlinien zum Web-Scraping zu verstehen. Im Allgemeinen ist es zulässig, sofern die „robots.txt“ der Website dies erlauben und Sie gegen keine Bestimmungen verstoßen.
Wie kann ich Media.net schneller scrapen?
Die Verwendung einer effizienteren Bibliothek wie Scrapy kann den Scraping-Prozess beschleunigen.
Zudem können Proxys von Geonode schnellere Verbindungen bieten.
Was sind die besten Bibliotheken für das Scraping von Media.net?
BeautifulSoup, Scrapy und Selenium sind häufig verwendete Bibliotheken für das Web-Scraping, die jeweils ihre eigenen Vorteile haben.
Wie verbessern die Proxys von Geonode das Web-Scraping?
Die Proxys von Geonode bieten IP-Rotation, Hochgeschwindigkeits-Rechenzentrums-Proxys und Residential-Proxys und eignen sich daher ideal für das Web-Scraping.
Sie helfen dabei, IP-Sperren und Ratenbeschränkungen zu umgehen und steigern so die Effizienz Ihrer Web-Scraping-Aufgaben.
Best Practices
Ratenbegrenzung
Implementieren Sie in Ihrem Code stets eine Ratenbegrenzung, um eine Überlastung des Servers zu vermeiden. Dies ist nicht nur höflich, sondern hilft Ihnen auch dabei, eine Sperrung zu vermeiden.
IP-Rotation
Verwenden Sie „Geonode“-Proxys für die IP-Rotation. So können Sie Anfragen über verschiedene IP-Adressen stellen und verringern die Wahrscheinlichkeit, blockiert zu werden.
Datenspeicherung und -nutzung
Speichern Sie die gescrapten Daten in einem strukturierten Format wie CSV oder in einer Datenbank. Halten Sie sich stets an die Nutzungsbedingungen der Daten, insbesondere wenn Sie planen, diese zu veröffentlichen.
Quellenangabe
Wenn Sie die Daten für Forschungszwecke oder Berichte verwenden, geben Sie stets Media.net als Quelle der Daten an.
Indem Sie sich an diese Best Practices und Tipps zur Fehlerbehebung halten, können Sie Ihr Web-Scraping-Projekt effektiver gestalten und die Anfälligkeit für häufige Probleme verringern.
Zusammenfassung
Web-Scraping ist ein unschätzbares Werkzeug zum Sammeln von Daten aus Media.net und liefert Erkenntnisse, die für verschiedene geschäftliche Anwendungen wie Wettbewerbsanalysen, Marktforschung und Preisstrategien von entscheidender Bedeutung sein können.
In diesem Artikel haben wir die wesentlichen Schritte zum Einrichten Ihrer Scraping-Umgebung, zum Schreiben des Codes und zur Behebung häufiger Probleme behandelt.
Wir haben außerdem betont, wie wichtig die Einhaltung rechtlicher und ethischer Richtlinien ist, und dabei besonders hervorgehoben, wie Proxys von Geonode Ihre Scraping-Aktivitäten verbessern können, indem sie Anonymität gewährleisten und Ratenbeschränkungen umgehen.
Nächste Schritte
Datenbereinigung und -analyse
Sobald Sie die Daten erfolgreich extrahiert haben, besteht der nächste Schritt darin, diese zu bereinigen und zu analysieren. Die Datenbereinigung umfasst das Entfernen von Duplikaten, den Umgang mit fehlenden Werten und die Konvertierung von Datentypen.
Nach der Bereinigung können Sie die Daten mithilfe statistischer Methoden analysieren, um umsetzbare Erkenntnisse zu gewinnen.
Strategische Umsetzung
Die aus den Daten gewonnenen Erkenntnisse lassen sich strategisch in Ihrem Unternehmen umsetzen.
Ob es darum geht, Ihre Preismodelle anzupassen oder neue Marktchancen zu identifizieren – die von Ihnen gesammelten Daten können als wertvolle Ressource für die Entscheidungsfindung dienen.
Überwachung und Aktualisierung
Web-Scraping ist keine einmalige Angelegenheit. Websites aktualisieren ihre Inhalte und ihre Struktur regelmäßig, daher ist es unerlässlich, Ihren Scraping-Code auf dem neuesten Stand zu halten.
Die Überwachung Ihres Scraping-Prozesses hilft Ihnen dabei, auftretende Probleme schnell zu erkennen und zu beheben.
Weitere Ressourcen
Tutorials
- Web-Scraping mit Python: Ein umfassender Leitfaden
- So verwenden Sie Proxys für das Web-Scraping
Dokumentation
- BeautifulSoup-Dokumentation
- Scrapy-Dokumentation
- Proxy-Dienste von Geonode
Foren für Community-Support
- Stack Overflow
- Reddit-Community zum Thema Web-Scraping
- Geonode-Community-Forum
Wenn Sie die in diesem Artikel beschriebenen Richtlinien und Best Practices befolgen, sind Sie auf dem besten Weg, Web-Scraping-Kenntnisse zu erwerben. Die Daten, die Sie von Media.net sammeln, können Ihnen einen Wettbewerbsvorteil verschaffen – vorausgesetzt, Sie nutzen sie verantwortungsbewusst und ethisch einwandfrei.

