Vorteile des Web-Scrapings von Walmart-Daten
Als einer der größten Einzelhändler betreibt Walmart eine Kette von Hypermärkten, Discountern und Lebensmittelgeschäften. Das Unternehmen verfügt über eine umfangreiche Online-Präsenz mit Millionen von Produkten, die von Lebensmitteln über Bekleidung und Haushaltswaren bis hin zu Elektronik und vielem mehr reichen – was Walmart zu einer unglaublich wertvollen Datenquelle für das Web-Scraping macht.
Das Scraping von Walmart-Daten kann einer Vielzahl von Zwecken dienen, insbesondere für Unternehmen und Forscher. Hier sind einige praktische Anwendungsbeispiele für das Scraping von Daten bei Walmart:
• Marktforschung. Das umfangreiche Produktangebot von Walmart bietet einen umfassenden Überblick über den Markt in zahlreichen Kategorien. Durch das Scraping dieser Daten können Sie Einblicke in Produkttrends, Verbraucherpräferenzen und Preisstrategien gewinnen.
• Wettbewerbsanalyse. Aus Walmart gescrapte Daten können genutzt werden, um zu verstehen, welche Produkte zu welchem Preis verkauft und wie sie vermarktet werden. Diese Informationen können Ihnen helfen, Ihre eigenen Produkte wettbewerbsfähig zu positionieren.
• Preisüberwachung. Mit den gescrapten Daten können Sie die Produktpreise bei Walmart in Echtzeit überwachen, um Ihre eigenen Preise entsprechend anzupassen und wettbewerbsfähig zu bleiben.
• Optimierung des Produktsortiments. Durch die Analyse des von Walmart angebotenen Produktsortiments können Sie Ihr eigenes Sortiment optimieren, um der Verbrauchernachfrage besser gerecht zu werden.
• Stimmungsanalyse. Bewertungen und Rezensionen auf der Walmart-Website liefern eine Fülle von Informationen über die Stimmung der Verbraucher gegenüber den Produkten. Anhand dieser Daten können Sie die Produktqualität und den Kundenservice verbessern.
Müheloses Scraping bei Walmart mit Geonode
Die Scraping-API von
Geonode
ist ein leistungsstarkes und benutzerfreundliches Tool, das entwickelt wurde, um Web-Scraping-Aufgaben zu vereinfachen. Mit einer Reihe wichtiger Funktionen ermöglicht sie es Nutzern, große Datenmengen effizient von Websites wie Walmart zu extrahieren, ohne komplexe Codezeilen schreiben zu müssen.
Zu den herausragenden Funktionen gehören:
• Debug-Modus. Bietet detaillierte Informationen im JSON-Antwortformat und hilft Nutzern so zu verstehen, wie Websites mit Scraping-Anfragen umgehen, wodurch Zeit und Ressourcen gespart werden.
• JavaScript-Rendering. Erleichtert das Scraping von Single-Page-Anwendungen durch die Erfassung dynamischer Elemente und gewährleistet so eine umfassende Datenextraktion.
• Ausführung benutzerdefinierter JS-Snippets. Ermöglicht Entwicklern die Interaktion mit Formularen, Schaltflächen und anderen JavaScript-generierten Elementen und bietet so mehr Kontrolle über den Scraping-Prozess.
• Rotierende Proxys. Nutzt einen großen Proxy-Pool, um IP-Sperren zu vermeiden und geografische Beschränkungen zu umgehen, wodurch die Zuverlässigkeit der Datenabfrage verbessert wird.
• Geotargeting. Gewährleistet den Zugriff auf mehr Websites, ohne als Scraper erkannt zu werden.
• Screenshot-API. Ermöglicht die einfache Erstellung von Screenshots von Webseiten zu Test-, Fehlerbehebungs- und Dokumentationszwecken.
• Preisgestaltung pro GB. Bietet eine kostengünstige Preisgestaltung und Kontrolle über die Scraper-Kosten.
• Antwortformate. Bietet Flexibilität bei der Wahl zwischen HTML- und JSON-Formaten für den Einsatz in integrierten Anwendungen.
• Datenerfassung aus HTTP-Antworten. Erfasst mühelos spezifische Daten, wie z. B. JSON-Antworten, um die benötigten Informationen zu extrahieren.
• Scraping-Modus. Bietet verschiedene Scraping-Modi für optimale Leistung und Effizienz, zugeschnitten auf unterschiedliche Scraping-Anforderungen.
So scrapen Sie Walmart-Daten mit „Geonode“
Die Struktur der Walmart-Website verstehen
Walmart ist einer der größten Einzelhändler der Welt; seine Website ist eine umfangreiche E-Commerce-Plattform mit einem gut strukturierten und übersichtlichen Layout, das Milliarden von Produktseiten umfasst. Das Verständnis dieser Struktur ist entscheidend für effizientes und effektives Web-Scraping. Hier ist ein grundlegender Überblick darüber, wie die Daten auf der Walmart-Website organisiert sind:
• Startseite. Die Startseite bietet einen allgemeinen Überblick über das Angebot von Walmart. Sie enthält verschiedene Produktkategorien, Sonderangebote und vieles mehr.
• Kategorieseiten. Wenn Sie auf der Startseite oder im Navigationsmenü auf eine Kategorie klicken, gelangen Sie zu einer Kategorieseite. Auf diesen Seiten werden Produkte einer bestimmten Kategorie aufgelistet, beispielsweise Elektronik, Bekleidung oder Haushaltswaren. Jede Kategorieseite verfügt über mehrere Unterkategorien für spezifischere Produkttypen.
• Produktlisten. Jede Kategorie- oder Unterkategorieseite enthält eine Liste von Produkten. Jede Produktliste umfasst grundlegende Informationen wie den Produktnamen, den Preis, ein Bild und die Kundenbewertung.
• Produktseiten. Wenn Sie auf ein Produkt in der Liste klicken, gelangen Sie zur jeweiligen Produktseite. Diese Seiten enthalten detaillierte Informationen zum Produkt, darunter eine ausführlichere Beschreibung, Produktmerkmale, weitere Bilder, Kundenbewertungen und oft eine Liste verwandter Produkte.
• Suchfunktion. Die Website verfügt außerdem über eine Suchleiste, über die Nutzer nach bestimmten Produkten suchen können. Die Suchergebnisse werden in einem ähnlichen Format wie die Produktlisten auf den Kategorieseiten angezeigt.
Beim Scraping der Walmart-Website ist zu beachten, dass sich die Daten hauptsächlich in diesen Bereichen befinden. Insbesondere die Produktseiten sind wahrscheinlich am wertvollsten, da sie die detailliertesten Informationen enthalten.
Die Website von Walmart ist jedoch dynamisch; einige Inhalte werden nach dem Laden der ursprünglichen HTML-Seite mithilfe von JavaScript geladen, was das Scraping erschweren kann. Glücklicherweise kann die Scraping-API von „Geonode“ die JavaScript-Darstellung verarbeiten und dieses Problem umgehen.
Identifizierung wichtiger Datenpunkte für das Scraping
Beim Scraping einer E-Commerce-Website wie Walmart hängen die wichtigsten Datenpunkte, die Sie extrahieren möchten, von den spezifischen Anforderungen Ihres Projekts ab. Hier sind einige gängige Datenpunkte, die oft wertvoll sind:
• Produktname. Der Produkttitel ist eine der grundlegendsten und zugleich wichtigsten Informationen. Er hilft dabei, die Vielfalt der auf der Website angebotenen Produkte zu erfassen.
• Preis. Der Preis des Produkts ist ein weiterer entscheidender Datenpunkt. Die Preise von Mitbewerbern können für Preisvergleiche, zur Verfolgung von Preisänderungen im Zeitverlauf oder zur Ermittlung von Preistrends herangezogen werden.
• Bilder. Bilder liefern eine visuelle Darstellung des Produkts. Sie können für verschiedene Zwecke nützlich sein, beispielsweise für Bilderkennungsaufgaben oder zur Bereitstellung von Bildmaterial in einem Produktkatalog.
• Beschreibung. Die Produktbeschreibung liefert detaillierte Informationen über das Produkt, einschließlich seiner Funktionen, Spezifikationen und anderer relevanter Details.
• Produktbewertungen und -rezensionen. Bewertungen und Rezensionen geben Aufschluss über die Kundenzufriedenheit und die Produktqualität. Sie können für die Stimmungsanalyse oder zur Einschätzung der öffentlichen Meinung über ein Produkt genutzt werden.
• Produktkategorie. Die Kategorie oder Unterkategorie des Produkts kann Aufschluss darüber geben, um welche Art von Produkt es sich handelt und wo es in das breitere Produktsortiment passt.
• Produkt-SKU oder -ID. Die SKU oder ID ist eine eindeutige Kennung für jedes Produkt. Dies kann für die Nachverfolgung bestimmter Produkte nützlich sein.
• Verfügbarkeitsstatus. Informationen darüber, ob das Produkt vorrätig, nicht vorrätig oder zur Vorbestellung verfügbar ist, können für die Analyse der Lieferkette oder für Marktforschung wertvoll sein.
• Versandinformationen. Details zu Versandoptionen und -kosten können wichtig sein, um die Gesamtkosten eines Produkts zu verstehen.
• Verkäuferinformationen. Wird das Produkt von einem Drittanbieter verkauft, können Informationen über den Verkäufer relevant sein.
Einrichten der Umgebung
Hier finden Sie eine Schritt-für-Schritt-Anleitung zum Einrichten der Umgebung für die Scraping-API von „Geonode“:
1. Erstellen Sie ein Konto auf Geonode. Der erste Schritt besteht darin, ein Konto auf der Website von Geonode zu erstellen. Dadurch erhalten Sie Zugriff auf deren API und andere Dienste.
2. API-Schlüssel abrufen. Sobald Sie ein Konto erstellt und sich angemeldet haben, finden Sie Ihren API-Schlüssel in Ihren Kontoeinstellungen oder im Dashboard. Dieser Schlüssel wird zur Authentifizierung Ihrer Anfragen an die API verwendet.
3. Installieren Sie die erforderlichen Bibliotheken. Je nach der von Ihnen verwendeten Programmiersprache müssen Sie möglicherweise bestimmte Bibliotheken installieren, um HTTP-Anfragen zu senden und die Antworten zu verarbeiten.
• HTTP-Client-Bibliothek: Um Anfragen an die API von Geonode zu senden und Antworten zu empfangen, benötigen Sie eine HTTP-Client-Bibliothek. Welche Bibliothek Sie konkret verwenden, hängt von Ihrer Programmiersprache ab. Wenn Sie beispielsweise Python verwenden, könnten Sie die „Requests“-Bibliothek nutzen. Bei JavaScript kommen möglicherweise Axios oder Fetch zum Einsatz.
• JSON-Parsing-Bibliothek: Die API von „Geonode“ gibt Daten in der Regel im JSON-Format zurück, daher benötigen Sie eine Bibliothek, um diese Daten zu parsen. Die meisten modernen Programmiersprachen bieten integrierte Unterstützung für das JSON-Parsing. In Python können Sie beispielsweise das „json“-Modul verwenden, in JavaScript die Funktion „JSON.parse()“.
• Entwicklungsumgebung: Sie benötigen eine Entwicklungsumgebung, um Ihren Code zu schreiben und auszuführen. Dies kann ein Texteditor wie Sublime Text oder Atom sein oder eine integrierte Entwicklungsumgebung (IDE) wie PyCharm oder Visual Studio Code.
4. Richten Sie Ihre Entwicklungsumgebung ein. Stellen Sie sicher, dass Ihre Entwicklungsumgebung so eingerichtet ist, dass sie Anfragen an die API senden und die Antworten verarbeiten kann. Dazu gehört möglicherweise das Einrichten eines neuen Projekts in Ihrer bevorzugten integrierten Entwicklungsumgebung (IDE) oder Ihrem Texteditor.
5. Testen Sie die API. Bevor Sie mit der Erstellung Ihres Web-Scrapers beginnen, sollten Sie die API testen, um sicherzustellen, dass alles korrekt funktioniert. Dazu können Sie eine einfache GET-Anfrage an die API senden und die Antwort überprüfen.
6. Lesen Sie die API-Dokumentation: Die API-Dokumentation von Geonode enthält detaillierte Informationen zur Nutzung der API, einschließlich der verfügbaren Endpunkte, Anfrageparameter, Antwortformate und mehr. Das Lesen dieser Dokumentation hilft Ihnen dabei, die API effektiv zu nutzen.
Abrufen einer Walmart-Produktseite
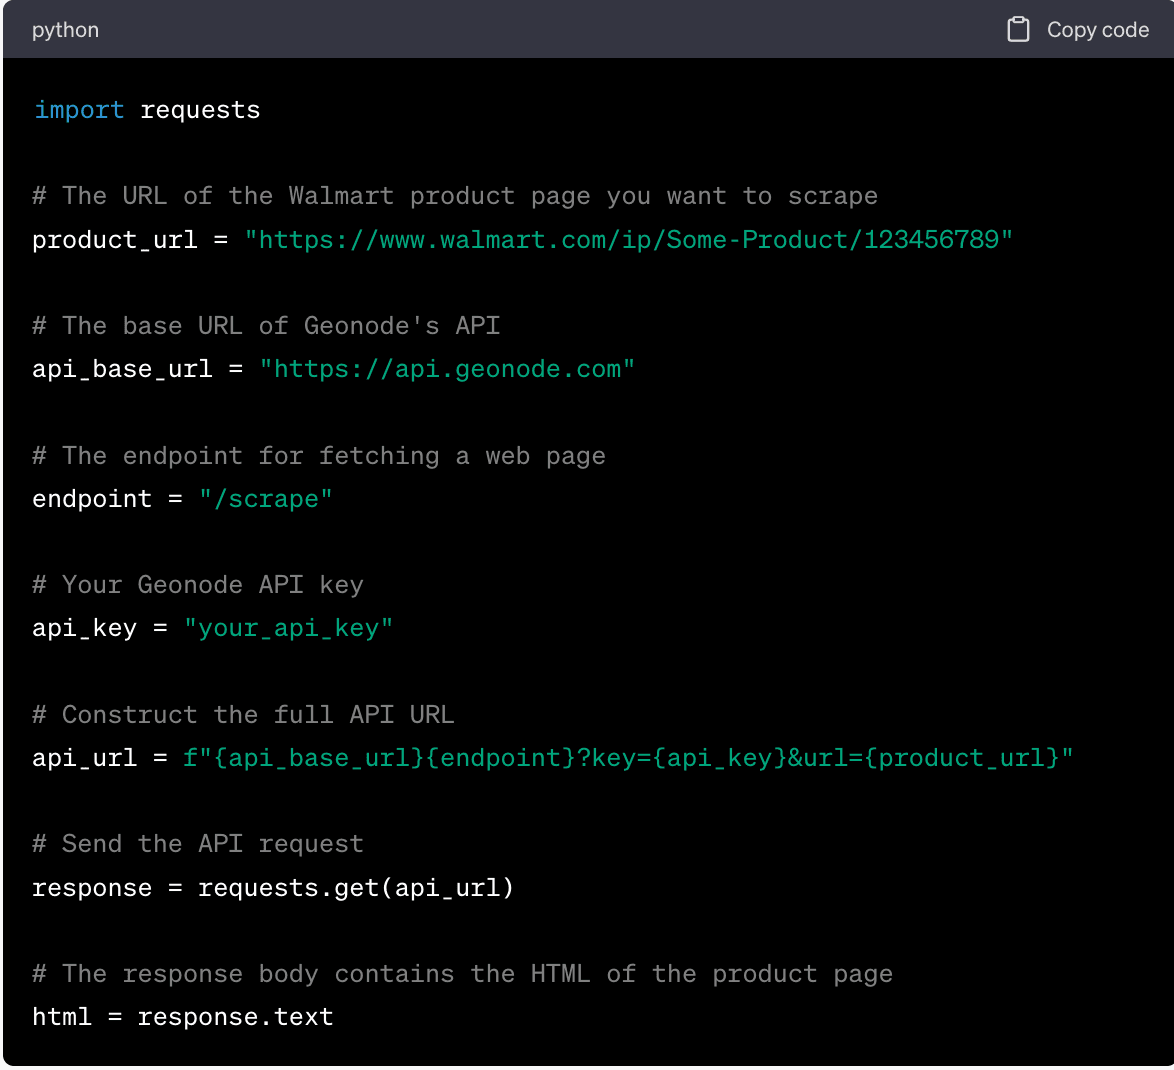
Um eine Walmart-Produktseite mithilfe der Scraping-API von Geonode abzurufen, müssen Sie eine HTTP-GET-Anfrage an die API senden, die die URL der Produktseite enthält, die Sie scrapen möchten. Hier ist ein allgemeiner Überblick:
1. Ermitteln Sie die URL der Produktseite. Ermitteln Sie die URL der Walmart-Produktseite, die Sie scrapen möchten. Dazu navigieren Sie in Ihrem Webbrowser zur Produktseite und kopieren die URL aus der Adressleiste.
2. Bereiten Sie die API-Anfrage vor. Stellen Sie die URL des API-Endpunkts zusammen, die die Basis-URL der API von „“, den Endpunkt zum Abrufen einer Webseite sowie alle erforderlichen Parameter enthält. Einer der Parameter ist die URL der Walmart-Produktseite, die Sie scrapen möchten.
3. Senden Sie die API-Anfrage. Senden Sie die API-Anfrage mithilfe Ihrer HTTP-Client-Bibliothek. Dazu müssen Sie eine von der Bibliothek bereitgestellte Funktion oder Methode aufrufen, die URL des API-Endpunkts übergeben und die Methode auf „GET“ setzen.
4. Verarbeiten Sie die API-Antwort. Nachdem Sie die API-Anfrage gesendet haben, gibt die API eine Antwort zurück. Diese Antwort enthält die Daten der Walmart-Produktseite, in der Regel im HTML-Format. Sie müssen diese Antwort in Ihrem Code verarbeiten, was unter anderem das Parsen des HTML-Codes und das Extrahieren der für Sie relevanten Daten beinhalten kann.
Hier ist ein Beispiel, wie Sie dies in Python mithilfe der „Requests“-Bibliothek umsetzen könnten:
Extrahieren von Daten aus der Produktseite
Sobald Sie eine Walmart-Produktseite mithilfe der Scraping-API von Geonode abgerufen haben, besteht der nächste Schritt darin, die wichtigsten Datenpunkte aus der Seite zu extrahieren. Dazu müssen Sie in der Regel den HTML-Code der Seite analysieren und die Elemente auswählen, die die Daten enthalten, die Sie interessieren.
Hier ist ein allgemeiner Überblick darüber, wie Sie dabei vorgehen könnten:
1. Den HTML-Code analysieren. Der erste Schritt besteht darin, den HTML-Code der Seite zu analysieren. Dabei wird die HTML-Zeichenkette in eine Struktur umgewandelt, in der Sie navigieren und suchen können. Die konkrete Vorgehensweise hängt von Ihrer Programmiersprache und den von Ihnen verwendeten Bibliotheken ab. In Python könntest du beispielsweise die Bibliothek „BeautifulSoup“ verwenden, um den HTML-Code zu analysieren.
2. Die Datenpunkte identifizieren. Als Nächstes musst du die HTML-Elemente identifizieren, die die Datenpunkte enthalten, die dich interessieren. Dazu müssen Sie in der Regel den HTML-Code der Seite untersuchen und die Tags, Klassen oder IDs dieser Elemente ermitteln. Dies können Sie mithilfe der Entwicklertools Ihres Webbrowsers tun.
3. Wählen Sie die Elemente aus. Sobald Sie die Elemente identifiziert haben, können Sie sie aus dem analysierten HTML-Code auswählen. Dazu rufen Sie in der Regel eine Funktion oder Methode Ihrer HTML-Parsing-Bibliothek auf und übergeben dabei das Tag, die Klasse oder die ID des Elements. Dadurch werden das Element und sein Inhalt zurückgegeben.
4. Die Daten extrahieren. Nachdem Sie die Elemente ausgewählt haben, können Sie die Daten daraus extrahieren. Dazu rufen Sie in der Regel eine von Ihrer HTML-Parsing-Bibliothek bereitgestellte Funktion oder Methode auf und übergeben das Element als Argument. Dadurch werden die im Element enthaltenen Daten zurückgegeben.
Hier ist ein Beispiel dafür, wie Sie HTML in Python mithilfe der BeautifulSoup-Bibliothek parsen können:
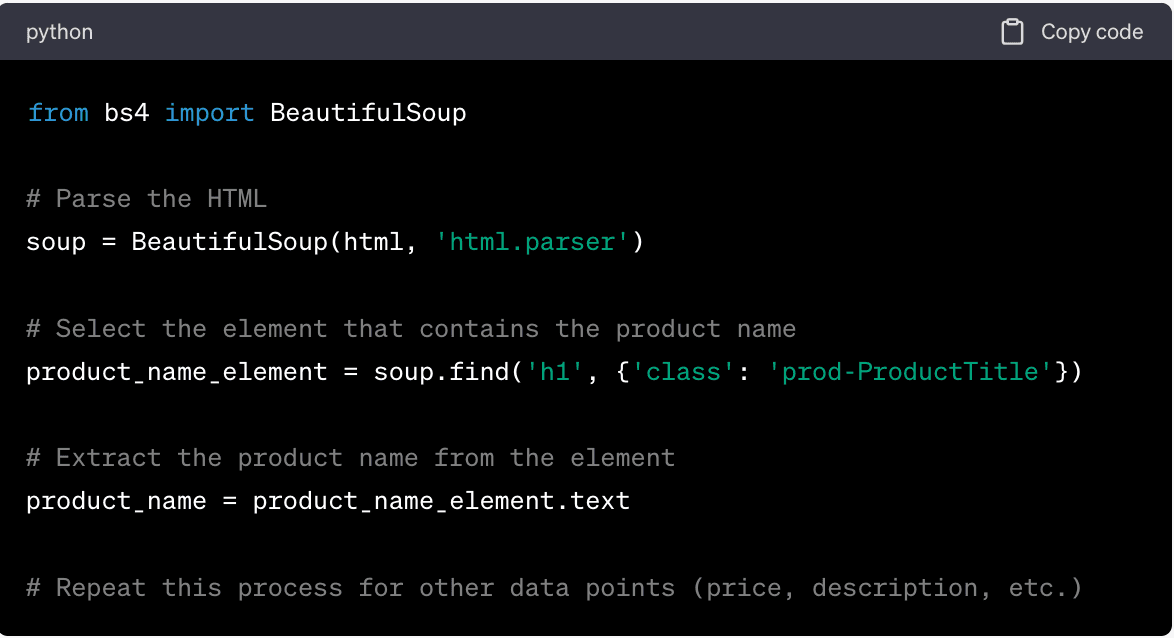
(Dies ist ein einfaches Beispiel; die tatsächliche Umsetzung kann je nach der spezifischen Struktur der Walmart-Produktseiten sowie den Funktionen und Möglichkeiten Ihrer HTML-Parsing-Bibliothek variieren. Beziehen Sie sich stets auf die offizielle Dokumentation Ihrer Bibliothek, um die genauesten und aktuellsten Informationen zu erhalten.)
Parsen von HTML- und JSON-Daten
Das Parsen von HTML- und JSON-Daten ist eine gängige Aufgabe beim Web-Scraping. Beim Parsen werden Rohdaten (in diesem Fall HTML- oder JSON-Text) in ein Format umgewandelt, das in Ihrer Programmiersprache leichter zu verarbeiten ist.
HTML-Parsing
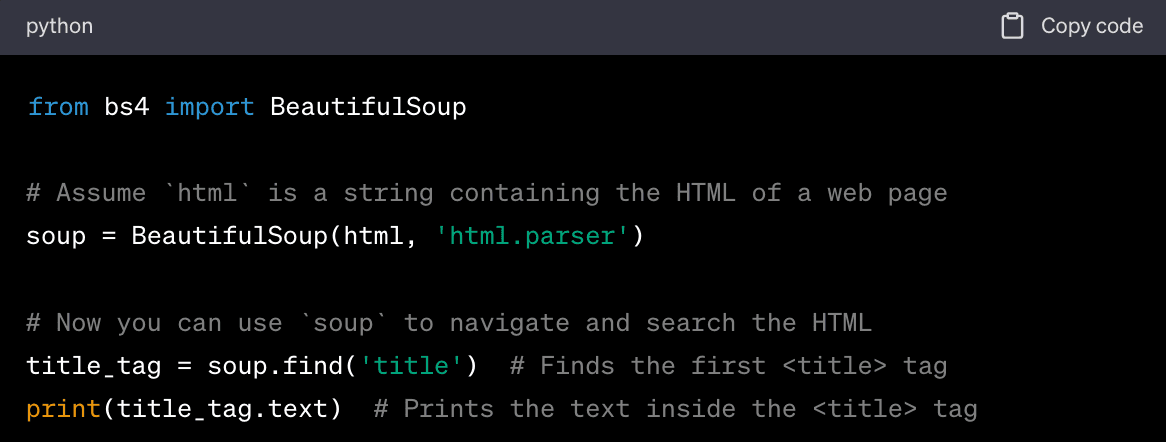
HTML ist die Standard-Auszeichnungssprache zur Erstellung von Webseiten. Sie verwendet Tags, um verschiedene Arten von Inhalten zu kennzeichnen, was die Navigation und das Extrahieren bestimmter Daten relativ einfach macht.
Hier ist ein Beispiel dafür, wie Sie HTML in Python mithilfe der BeautifulSoup-Bibliothek analysieren können:
JSON-Analyse
JSON (JavaScript Object Notation) ist ein schlankes Datenaustauschformat, das für Menschen leicht zu lesen und zu schreiben und für Maschinen leicht zu parsen und zu generieren ist. Es wird häufig von APIs zum Senden von Daten verwendet.
Hier ist ein Beispiel dafür, wie man JSON in Python parsen könnte:
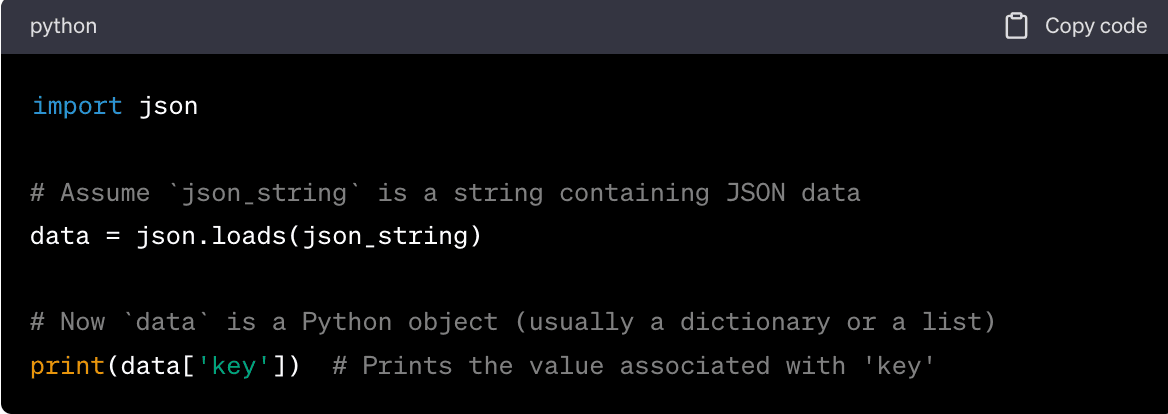
In beiden Fällen besteht das Ziel des Parsens darin, die rohen HTML- oder JSON-Daten in ein Format umzuwandeln, mit dem sich in Ihrer Programmiersprache leichter arbeiten lässt. Sobald die Daten geparst sind, können Sie sie durchsuchen, um die spezifischen Datenelemente zu finden, die Sie interessieren.
Tipps zur effizienten Datenverwaltung
Die effiziente Verwaltung großer Datenmengen ist ein entscheidender Aspekt beim Web-Scraping großer E-Commerce-Plattformen wie Walmart. Hier sind einige Tipps zum Umgang mit großen Datensätzen:
• Verwenden Sie eine Datenbank. Das Speichern Ihrer Daten in einer Datenbank kann die Verwaltung vereinfachen, insbesondere wenn Sie es mit großen Datenmengen zu tun haben. Datenbanken sind für die Verarbeitung großer Datensätze ausgelegt und bieten Funktionen wie die Indizierung, wodurch Abfragen Ihrer Daten beschleunigt werden können.
• Stapelverarbeitung. Anstatt jeden Datenpunkt sofort nach dem Scraping zu verarbeiten, sollten Sie in Erwägung ziehen, Ihre Daten in Stapeln zu sammeln und jeden Stapel auf einmal zu verarbeiten. Dies kann effizienter sein und die Belastung Ihres Systems verringern.
• Datenkomprimierung. Wenn Speicherplatz ein Problem darstellt, sollten Sie eine Komprimierung Ihrer Daten in Betracht ziehen. Viele gängige Datenformate, wie CSV und JSON, lassen sich auf einen Bruchteil ihrer ursprünglichen Größe komprimieren.
• Parallele Verarbeitung. Wenn Sie mehrere Seiten oder Websites gleichzeitig scrapen, sollten Sie die parallele Verarbeitung nutzen, um den Vorgang zu beschleunigen. Dabei werden mehrere Scraping-Aufgaben gleichzeitig ausgeführt, was die Gesamtdauer des Scrapings erheblich verkürzen kann.
• Inkrementelles Scraping. Anstatt alle Daten auf einmal zu scrapen, sollten Sie in Betracht ziehen, dies schrittweise zu tun. Dabei wird nachverfolgt, welche Daten bereits gescrapt wurden, und es werden nur neue oder aktualisierte Daten gescrapt. Dies kann effizienter sein und sowohl Ihr System als auch die Website, die Sie scrapen, entlasten.
• Nutzen Sie eine cloudbasierte Lösung. Cloudbasierte Lösungen bieten skalierbaren Speicherplatz und Rechenleistung, was insbesondere beim Umgang mit großen Datenmengen von Vorteil sein kann. Dienste wie Amazon Web Services (AWS), Google Cloud und Microsoft Azure bieten verschiedene Lösungen zur Datenspeicherung und -verarbeitung, die große Datensätze verarbeiten können.
• Datenbereinigung und -validierung. Bereinigen und validieren Sie Ihre Daten so früh wie möglich in der Datenpipeline. Dazu gehören das Entfernen von Duplikaten, der Umgang mit fehlenden Werten und die Überprüfung der Datenkonsistenz. Eine frühzeitige Bereinigung und Validierung Ihrer Daten kann spätere Fehler und Ineffizienzen verhindern.
Denken Sie daran: Das Ziel ist es, Ihre Daten auf eine Weise zu verwalten, die effizient, skalierbar und auf Ihre spezifischen Anforderungen zugeschnitten ist. Der beste Ansatz hängt von der Größe Ihres Datensatzes, den Ihnen zur Verfügung stehenden Ressourcen und den spezifischen Anforderungen Ihres Projekts ab.
So vermeiden Sie eine Sperrung
Web-Scraping ist zwar ein leistungsstarkes Werkzeug zur Datenextraktion aus Websites, doch Walmart sieht diese Praxis nicht gerne.
Hier sind einige häufige Gründe für eine Sperrung beim Scraping sowie Tipps, wie Sie diese vermeiden können:
• Zu viele Anfragen. Das Senden zu vieler Anfragen in kurzer Zeit kann die Server von Walmart überlasten und die Leistung der Website beeinträchtigen. Dies wird oft als Missbrauch angesehen und ist ein häufiger Grund für eine Sperrung. Um dies zu vermeiden, sollten Sie Ihre Anfragerate begrenzen und Verzögerungen zwischen den Anfragen einbauen.
• Ignorieren der robots.txt. Die robots.txt-Datei ist ein Mittel, mit dem Websites mit Webcrawlern und Scrapern kommunizieren. Sie legt fest, welche Teile der Website nicht gescrapt werden dürfen. Das Ignorieren der Regeln in dieser Datei kann dazu führen, dass Ihr Scraper gesperrt wird. Überprüfen und beachten Sie stets die robots.txt-Datei der Website, die Sie scrapen.
• Keine Rotation der IP-Adressen. Wenn alle Ihre Anfragen von derselben IP-Adresse stammen, kann dies ein deutliches Anzeichen dafür sein, dass Sie die Website scrapen. Walmart sperrt Ihre IP-Adresse, wenn von ihr zu viele Anfragen gesendet werden. Um dies zu vermeiden, sollten Sie die Verwendung eines Pools rotierender Residential-Proxys in Betracht ziehen, um Ihre Anfragen auf mehrere IP-Adressen zu verteilen.
- Die Scraping-API von Geonode nutzt einen Pool rotierender Proxys. Jede Anfrage, die Sie über die API senden, erfolgt von einer anderen IP-Adresse aus. Dies kann dazu beitragen, IP-basierte Sperrungen und Ratenbegrenzungen zu vermeiden, da es für Websites dadurch schwieriger wird, Ihren Scraper zu identifizieren und zu blockieren. Die Rotation der IP-Adressen trägt zudem dazu bei, Ihre Anfragen gleichmäßiger zu verteilen, wodurch die Belastung einzelner Server verringert und Ihr Scraping effizienter gestaltet wird.
• Keine oder Verwendung einer verdächtigen User-Agent-Zeichenkette. Die User-Agent-Zeichenkette teilt der Website mit, welche Art von Gerät und Browser die Anfrage stellt. Websites wie Walmart blockieren Anfragen, die keine User-Agent-Zeichenkette enthalten oder eine verwenden, die bekanntermaßen mit Scrapern in Verbindung steht. Verwenden Sie einen legitimen User-Agent-String, der einen echten Browser nachahmt.
• Scraping geschützter Daten. Einige Daten auf einer Website können urheberrechtlich oder durch andere gesetzliche Bestimmungen geschützt sein. Das Scraping dieser Daten kann zu einer Sperrung führen und auch rechtliche Konsequenzen nach sich ziehen. Vergewissern Sie sich stets, dass Sie das Recht haben, die gewünschten Daten zu scrapen und zu nutzen.
Der beste Weg, um eine Sperrung zu vermeiden, ist natürlich verantwortungsbewusstes Scraping. Halten Sie sich an die Regeln der Website, überlasten Sie den Server nicht und vergewissern Sie sich stets, dass Sie das Recht haben, die gewünschten Daten zu scrapen und zu nutzen.

