Stellen Sie sich vor, Sie bekämen eine riesige Kiste mit Tausenden von Puzzleteilen in die Hand gedrückt – das sind die Daten, die wir im digitalen Zeitalter sammeln. Es ist eine gewaltige Menge, überwältigend und auf den ersten Blick vielleicht nicht besonders einleuchtend.
Hier kommt das Daten-Parsing ins Spiel. Stellen Sie es sich als Ihren Meister-Puzzler vor, der all diese Puzzleteile sortiert und so gruppiert, dass das Bild langsam Sinn ergibt.
Daten-Parsing verwandelt dieses verwirrende Durcheinander an Informationen in geschäftsreife Daten, die Sie auswerten und aus denen Sie lernen können. Es ist wie das Backstage-Team bei einer Theaterproduktion: oft unsichtbar, aber entscheidend dafür, dass die Vorstellung stattfinden kann.
In diesem Artikel möchten wir zeigen, wie das Daten-Parsing ins Rampenlicht rückt und das Chaos der Rohdaten in eine Geschichte voller aufschlussreicher Erkenntnisse verwandelt.
Datenauswertung verstehen
Die Datenauswertung ist ein wichtiger Bestandteil im Bereich der Datenanalyse. Sie wandelt riesige Mengen an Rohdaten in ein strukturiertes Datenformat um, um sie lesbar und verständlich zu machen.
Diese Umwandlung ist in der heutigen Zeit, in der jede Sekunde riesige Datenmengen generiert werden, von entscheidender Bedeutung.
Durch das Parsen von Daten können wir Informationen so strukturieren, dass sie sowohl von Maschinen als auch von Menschen verstanden werden können. Das Ergebnis: eine reibungslosere Datenverarbeitung und -analyse, die wertvolle Erkenntnisse liefert.
Die Bedeutung der Datenauswertung liegt in ihrer Fähigkeit, unstrukturierte Daten in lesbare Datenformate umzuwandeln, die .
Ob für Geschäftsanalysen, Softwareentwicklung oder Forschung – ausgewertete Daten sorgen für Klarheit und unterstützen eine fundierte Entscheidungsfindung.
Praktische Beispiele für Datenauswertung in der Praxis
-
Web-Scraping. Wenn Entwickler Informationen aus Websites extrahieren, liegen die Daten oft im HTML-Format vor.
Die Datenauswertung wandelt diese HTML-Daten in strukturierte Formate wie JSON oder XML um, die sich leichter analysieren und speichern lassen.
-
Protokollanalyse. Systemadministratoren analysieren häufig Protokolldateien, um bestimmte Informationen zu extrahieren.
Wenn beispielsweise ein Server abstürzt, kann die Analyse des Protokolls dabei helfen, den genauen Zeitpunkt des Absturzes und die Ereignisse, die dazu geführt haben, zu ermitteln.
-
E-Commerce-Plattformen. Wenn Sie auf einer Online-Shopping-Seite nach einem Produkt suchen, analysiert die Plattform Ihre Suchanfrage, um die relevantesten Produkte anzuzeigen.
Dabei wird Ihre Eingabe aufgeschlüsselt und mit Produktdaten abgeglichen.
-
Wetter-Apps. Eine Wetter-App analysiert Daten aus meteorologischen Quellen, um sie in einem benutzerfreundlichen Format darzustellen, das Temperatur, Luftfeuchtigkeit, Vorhersagen und mehr anzeigt.
-
Finanztransaktionen. Banking-Apps analysieren Transaktionsdaten, um Ihre Kontobewegungen übersichtlich darzustellen. Sie kategorisieren Käufe, Einzahlungen und andere Transaktionen, um die Nachverfolgung zu erleichtern.
In jedem dieser Beispiele spielt das Parsen von Daten eine entscheidende Rolle, um sicherzustellen, dass die Daten aussagekräftig und übersichtlich dargestellt werden.
Das Parsen von Daten erleichtert nicht nur eine effiziente Datenanalyse, sondern verbessert auch die Benutzererfahrung.
Die Mechanismen der Datenauswertung
Um unübersichtliche Daten in klare Informationen umzuwandeln, sind bestimmte Schritte erforderlich.
Diese Schritte – oder Mechanismen – helfen dabei, die Daten so aufzuschlüsseln und zu organisieren, dass sie leicht verständlich sind.
Sehen wir uns die wichtigsten Arten der Analyse an, die beim Datenparsing zum Einsatz kommen:
Lexikalische Analyse
Die lexikalische Analyse bildet die grundlegende Basis für das Datenparsing.
Bei diesem Prozess werden Rohdaten gescannt, um einzelne Elemente zu identifizieren und zu kategorisieren, die oft als Token oder einzelne lexikalische Einheiten bezeichnet werden.
Man kann sich das wie das Zerlegen eines Satzes in Wörter vorstellen. Jedes Wort, also jedes Token, hat eine bestimmte Rolle.
Bei der Datenauswertung identifiziert die lexikalische Analyse diese Token aus den Rohdaten und stellt so sicher, dass sie in den nachfolgenden Auswertungsschritten korrekt verarbeitet werden können.
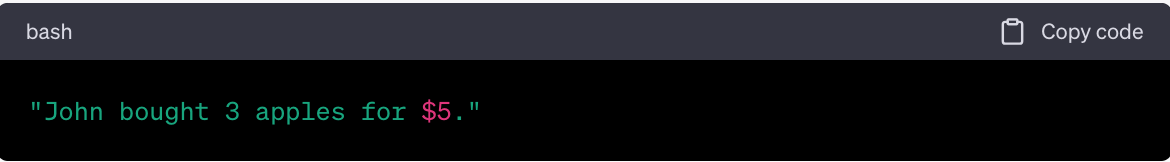
Angenommen, wir haben die folgende Rohdatenzeichenfolge:
Aufschlüsselung durch die lexikalische Analyse
In der Phase der lexikalischen Analyse würde diese Zeichenfolge gescannt und in einzelne Tokens zerlegt werden. So könnte der Vorgang aussehen:
- „John“ – Als Eigenname identifiziert (in diesem Fall ein Name).
- „bought“ – Als Verb identifiziert.
- „3“ – Als Zahl identifiziert.
- „apples“ – Als Substantiv identifiziert.
- „for“ – Als Präposition identifiziert.
- „$“ – Wird als Währungssymbol identifiziert.
- „5“ – Wird als Zahl identifiziert.
Jedes dieser Tokens wird anhand seines Typs und seiner Rolle in der Datenzeichenfolge kategorisiert.
Der Prozess der lexikalischen Analyse befasst sich nicht mit den Beziehungen zwischen diesen Tokens oder der Gesamtbedeutung der Zeichenfolge.
Stattdessen konzentriert er sich ausschließlich darauf, jedes einzelne Datenelement zu erkennen und zu kategorisieren, mit dem Ziel, die Daten so zu erfassen, dass sie in den nächsten Analyseschritten verwendet werden können.
Syntaktische Analyse
Sobald die Daten in Token zerlegt sind, kommt die syntaktische Analyse ins Spiel.
In dieser Phase geht es darum, diese Token so anzuordnen, dass sie eine zusammenhängende Struktur bilden – ähnlich wie beim Anordnen von Wörtern zu sinnvollen Sätzen.
Durch die Erstellung dieser Struktur stellt die syntaktische Analyse sicher, dass die Daten so organisiert sind, dass sowohl Maschinen als auch Menschen sie interpretieren können.
Erinnern Sie sich an die Datenfolge, die wir oben verwendet haben?
Die lexikalische Analyse zerlegt sie in Token: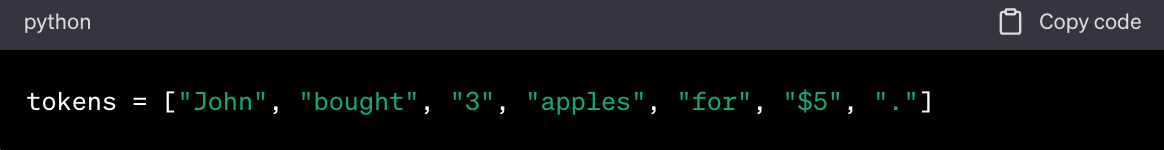
Die syntaktische Analyse veranschaulicht
Anhand dieser Token strukturiert die syntaktische Analyse sie zu einer sinnvollen Abfolge, die als Baumstruktur dargestellt wird: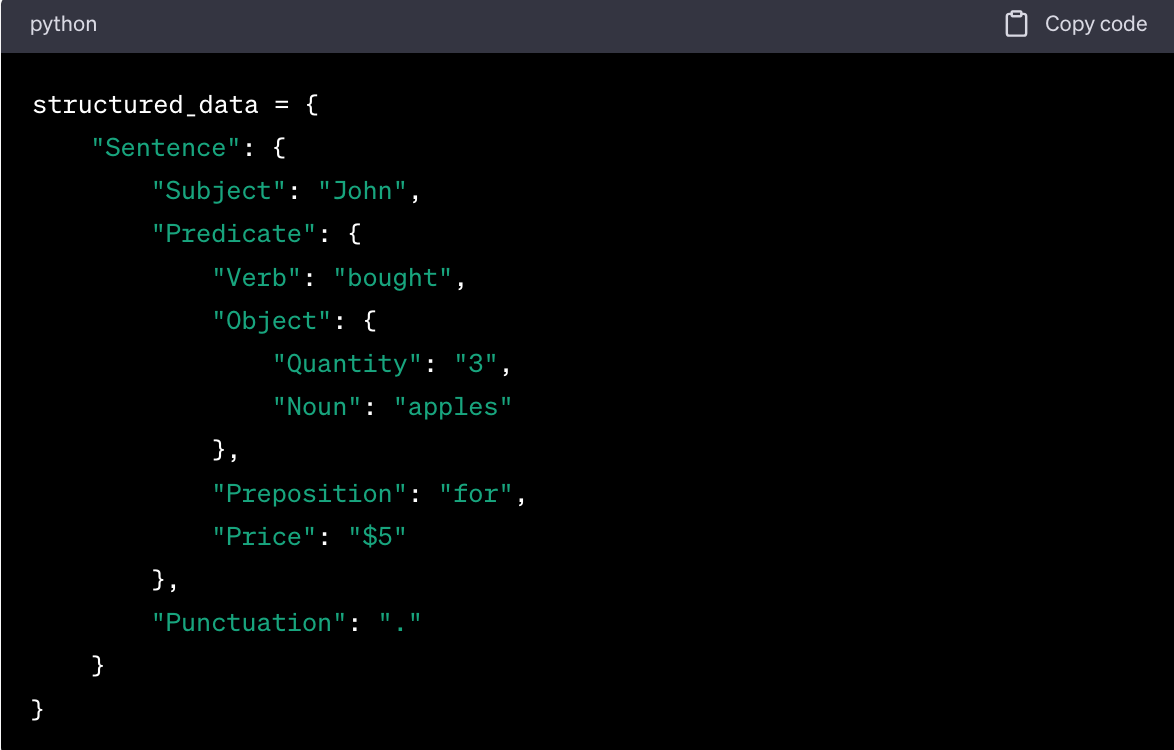
In dieser Parsebaumstruktur:
- „John“ wird als Subjekt des Satzes identifiziert.
- „bought“ ist das Hauptverb bzw. die Handlung.
- „3 apples“ ist das Objekt, das weiter in Menge („3“) und Substantiv („apples“) unterteilt wird.
- „for“ kennzeichnet eine Präpositionalphrase.
- „$5“ steht für den Preis oder die Kosten, die mit der Handlung verbunden sind.
- „.“ ist das Satzzeichen, das das Ende des Satzes markiert.
Diese strukturierte Darstellung, die durch die Syntaxanalyse gewonnen wird, liefert eine klare Hierarchie und Beziehungen zwischen den Tokens und ermöglicht so ein tieferes Verständnis der Bedeutung der ursprünglichen Datenfolge.
Semantische Analyse
Der nächste Schritt ist die semantische Analyse.
In diesem Schritt geht es darum, die Bedeutung hinter den strukturierten Daten zu verstehen.
Sie stellt sicher, dass die Beziehungen zwischen den verschiedenen Datenelementen klar sind und dass die Daten insgesamt Sinn ergeben.
Semantische Analyse veranschaulicht
Nach der syntaktischen Analyse verfügen wir über eine strukturierte Darstellung der Daten.
Nun wird die semantische Analyse die Bedeutung hinter dieser Struktur interpretieren.
Ausgabe:
Bei dieser semantischen Analyse werden die strukturierten Daten interpretiert, um aussagekräftige Informationen zu extrahieren.
Der Name des Käufers, die durchgeführte Aktion, der gekaufte Artikel, die Menge des Artikels und die Gesamtkosten werden alle aus den strukturierten Daten abgeleitet.
Die Interpretation ermöglicht ein klares Verständnis des in der ursprünglichen Datenfolge beschriebenen Ereignisses.
Arten der Datenauswertung
Im Zusammenhang mit der Datenauswertung ist es wichtig, die beiden Hauptarten zu kennen: die grammatikgesteuerte Datenauswertung und die datengesteuerte Datenauswertung.
Jede dieser Methoden hat ihre eigenen Vorteile und geeigneten Anwendungsfälle.
Wenn Sie diese verstehen, können Sie die richtige Methode für Ihre spezifischen Anforderungen auswählen.
Grammatikgesteuerte Datenanalyse
Die grammatikgesteuerte Datenanalyse stützt sich, wie der Name schon sagt, auf vordefinierte Grammatikregeln, um Daten zu strukturieren.
Diese Methode ist akribisch und präzise und stellt sicher, dass die geparsten Daten streng den festgelegten Richtlinien entsprechen.
Beispielsweise verwenden Programmiersprachen häufig grammatikgesteuerte Parser, um Code zu interpretieren und sicherzustellen, dass Entwickler die Syntax und die formalen Grammatikregeln der Sprache einhalten.
Dieser Ansatz bietet zwar eine hohe Genauigkeit, ist jedoch möglicherweise nicht so flexibel, wenn unbekannte oder unregelmäßige Datenmuster auftreten.
Zur Veranschaulichung:
Stellen Sie sich vor, Sie bauen eine Spielzeugburg anhand einer bestimmten LEGO-Bauanleitung.
Jeder Schritt in der Anleitung sagt Ihnen genau, welches Teil Sie verwenden und wo Sie es platzieren müssen.
Wenn Sie die Anleitung genau befolgen, erhalten Sie am Ende eine perfekte Burg.
Versuchen Sie jedoch, ein Teil zu verwenden, das in der Anleitung nicht erwähnt wird, oder es an einer nicht angegebenen Stelle zu platzieren, wird die Burg nicht richtig zusammenpassen.
In dieser Analogie stehen die LEGO-Bauanleitung für die Grammatikregeln, und der Vorgang des Bauens der Burg entspricht dem grammatikgesteuerten Parsing.
Genauso wie für die LEGO-Burg bestimmte Teile an bestimmten Stellen benötigt werden, müssen bei der grammatikgesteuerten Syntaxanalyse die Daten genau in die vordefinierten Regeln passen.
Passen die Daten nicht, kann der Parsing-Prozess – genau wie bei einem falschen LEGO-Teil – nicht korrekt fortgesetzt werden.
Datengesteuertes Parsen
Demgegenüber nutzt das datengesteuerte Parsen statistische Methoden zur Interpretation von Daten.
Anstatt sich ausschließlich auf feste Regeln zu stützen, verwendet es Muster aus großen Datensätzen, um fundierte Annahmen darüber zu treffen, wie neue Daten strukturiert werden sollten.
Dieser Ansatz ist besonders nützlich bei Aufgaben der natürlichen Sprachverarbeitung oder wenn die Datenquelle vielfältig und unvorhersehbar ist.
Durch die Nutzung riesiger Datenmengen kann sich diese Methode anpassen und eine breitere Abdeckung bieten, wodurch sie bei der Verarbeitung unterschiedlicher Dateneingaben vielseitiger einsetzbar ist.
Zur Veranschaulichung:
Um bei der LEGO-Analogie zu bleiben: Stellen Sie sich vor, Sie hätten eine gemischte Schachtel mit LEGO-Steinen ohne konkrete Anleitung.
Anstelle einer Bauanleitung haben Sie im Laufe der Zeit beobachtet, wie viele Menschen mit ähnlichen LEGO-Sets verschiedene Bauwerke errichtet haben.
Aufgrund dieser Beobachtungen beginnen Sie, gemeinsame Muster und Strukturen zu erkennen, die häufig gebaut werden, wie Wände, Türme oder Brücken.
Wenn Sie sich entscheiden, etwas aus der gemischten Schachtel zu bauen, stützen Sie sich auf diese beobachteten Muster.
Wenn Sie eine bestimmte Art von Stein sehen, die in früheren Konstruktionen oft als Fenster oder Tür verwendet wurde, entscheiden Sie sich vielleicht, ihn auf die gleiche Weise zu nutzen.
Du folgst nicht strikt einer einzigen Anleitung, sondern nutzt das Wissen aus zahlreichen früheren Bauwerken als Leitfaden für dein Bauvorhaben.
In diesem Szenario ähnelt der Bauprozess auf der Grundlage beobachteter Muster dem datengesteuerten Parsing.
Genauso wie du dich beim Bauen an früheren LEGO-Konstruktionen orientierst, nutzt das datengesteuerte Parsing Muster in bestehenden Datensätzen, um neue Daten zu interpretieren und zu strukturieren.
Es ist flexibel und anpassungsfähig und lässt Raum für Kreativität und Variation – ganz ähnlich wie das Bauen mit LEGO ohne feste Anleitung.
Datenauswertung vs. Datenscraping
Datenauswertung und Datenscraping sind zwei Begriffe, die oft synonym verwendet werden, jedoch unterschiedliche Prozesse der Datenanalyse bezeichnen.
Das Verständnis der Unterschiede zwischen ihnen sowie ihrer jeweiligen Bedeutung ist für jeden, der mit Daten arbeitet, von entscheidender Bedeutung.
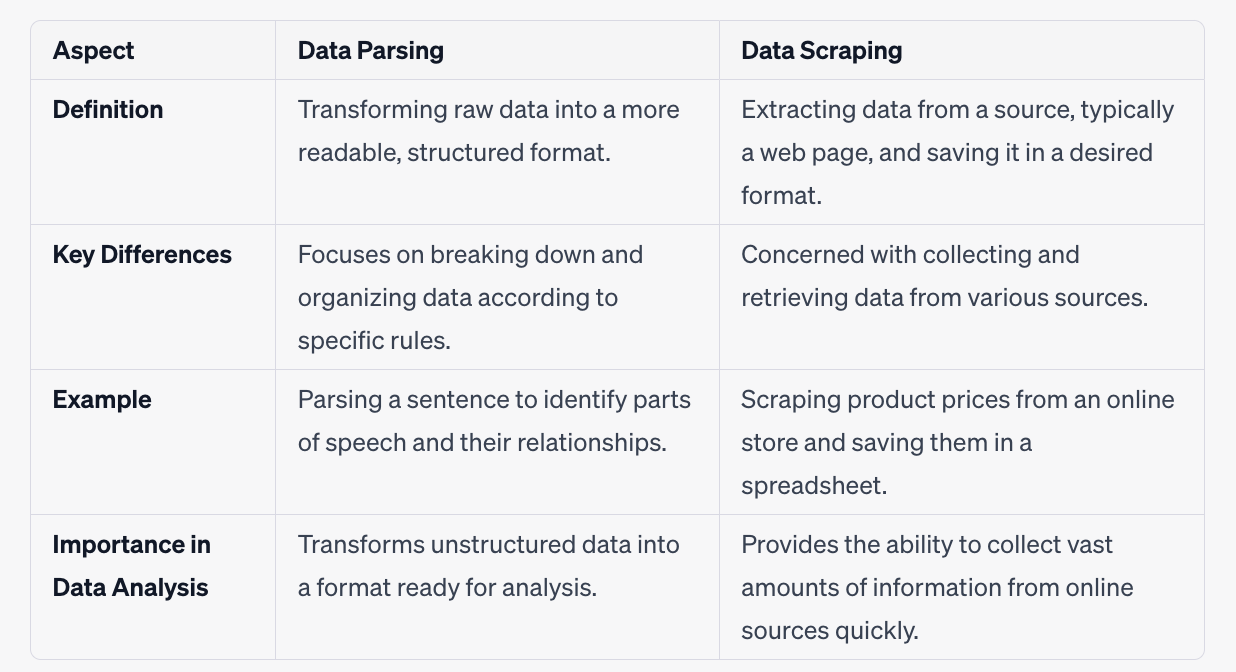
Datenparsing und Datenscraping sind unterschiedliche, sich jedoch ergänzende Prozesse im Bereich der Datenanalyse.
Beim Parsing geht es darum, Daten so umzuwandeln und zu strukturieren, dass sie für die Analyse bereit sind, während es beim Scraping darum geht, Daten aus verschiedenen Quellen zu sammeln und abzurufen.
Beides sind wesentliche Schritte, um Rohdaten in verwertbare Erkenntnisse umzuwandeln.
Anwendungsbereiche der Datenauswertung
Die Datenauswertung fungiert als Brücke zwischen unübersichtlichen Informationen und verwertbaren Erkenntnissen und ermöglicht es modernen Branchen, Daten effektiv zu analysieren und zu nutzen.
Dieser Abschnitt beleuchtet die vielfältigen Anwendungsbereiche der Datenanalyse und hebt deren wesentliche Rolle in Bereichen hervor, die von der Verarbeitung natürlicher Sprache (Natural Language Processing, NLP) über E-Commerce und das Gesundheitswesen bis hin zur Finanzanalyse und darüber hinaus reichen.
-
Verarbeitung natürlicher Sprache (NLP). Beim Daten-Parsing im Bereich NLP wird die menschliche Sprache in kleinere Einheiten wie Wörter und Phrasen zerlegt und deren Beziehungen zueinander erfasst.
Dieser Prozess ist entscheidend für verschiedene Anwendungen wie die Spracherkennung, bei der gesprochene Wörter in Text umgewandelt werden, und die maschinelle Übersetzung, bei der Text von einer Sprache in eine andere übersetzt wird.
-
Datentransformation und ETL-Prozesse (Extract, Transform, Load). ETL-Prozesse nutzen die Datenanalyse, um Daten aus verschiedenen Quellen zu entnehmen und in ein einheitliches Format umzuwandeln.
Diese Einheitlichkeit ist für die Datenanalyse unerlässlich, da sie sicherstellt, dass Daten aus verschiedenen Quellen miteinander verglichen und gemeinsam analysiert werden können. Es handelt sich um einen entscheidenden Schritt im Data Warehousing und in der Business Intelligence.
-
Abfrageoptimierung in Datenbanken. Datenparsing wird eingesetzt, um Datenbankabfragen zu analysieren, ihre Struktur zu verstehen und ihre Ausführung zu optimieren.
Durch die Wahl des effizientesten Weges zum Abrufen von Daten trägt das Parsing dazu bei, die Zeit für die Beantwortung von Abfragen zu verkürzen und so die Leistung von Datenbanksystemen zu verbessern.
-
Finanzdatenanalyse. Im Finanzsektor wird das Daten-Parsing eingesetzt, um komplexe Finanzdaten zu analysieren und zu interpretieren.
Es hilft dabei, Finanzberichte und ähnliche unstrukturierte Daten in ein lesbares Format umzuwandeln, das für verschiedene Analysen wie die Erkennung von Trends, die Risikobewertung und die Entscheidungsfindung bei Investitionen genutzt werden kann.
-
Standardisierung von Gesundheitsdaten. Gesundheitsdaten stammen oft aus verschiedenen Quellen und liegen in unterschiedlichen Formaten vor. Das Daten-Parsing unterstützt die Gesundheitsbranche bei der Standardisierung dieser Informationen und sorgt so für Konsistenz über verschiedene Systeme hinweg.
Diese Standardisierung ist für die Patientenversorgung von entscheidender Bedeutung, da sie sicherstellt, dass medizinisches Fachpersonal über genaue und einheitliche Daten verfügt.
-
Suchmaschinenoptimierung (SEO)-Analyse. Die Datenauswertung spielt eine Rolle bei der Analyse von Webseiten und dem Verständnis ihrer Inhalte, Struktur und Metadaten.
Dieses Verständnis hilft bei der Optimierung verschiedener Elemente einer Webseite und verbessert deren Sichtbarkeit im Internet.
-
Analyse von Social-Media-Daten. Social-Media-Plattformen generieren riesige Mengen unstrukturierter Daten. Die Datenauswertung hilft dabei, diese Daten zu strukturieren, wodurch die Analyse von Trends, Stimmungen und Nutzerverhalten ermöglicht wird.
Diese Analyse ist wertvoll für Unternehmen, die ihre Zielgruppe besser verstehen und ihre Marketingstrategien darauf abstimmen möchten.
-
Auswertung wissenschaftlicher Daten. Wissenschaftliche Forschung befasst sich oft mit komplexen Daten in unterschiedlichen Dateiformaten, die präzise ausgewertet werden müssen.
Die Datenauswertung hilft dabei, diese Daten zu strukturieren – sei es Genomdaten in der Biologie oder meteorologische Daten in der Klimawissenschaft –, und ermöglicht es Forschern, aussagekräftige Erkenntnisse zu gewinnen.
-
Datenverarbeitung in Geografischen Informationssystemen (GIS). GIS stützen sich auf räumliche Daten, die präzise geparst und strukturiert werden müssen.
Das Daten-Parsing stellt sicher, dass Koordinaten, Kartenebenen und andere geografische Informationen korrekt verarbeitet werden, was Aufgaben wie Kartierung, räumliche Analyse und Umweltüberwachung erleichtert.
-
Strukturierung von Produktinformationen im E-Commerce. E-Commerce-Plattformen verarbeiten riesige Mengen an Produktinformationen. Die Datenauswertung hilft bei der Strukturierung dieser Informationen und stellt sicher, dass Produktbeschreibungen, Spezifikationen und Preise plattformübergreifend einheitlich sind.
Diese Einheitlichkeit verbessert das Einkaufserlebnis für Verbraucher und erleichtert die Produktsuche und den Produktvergleich.
Datenparser verstehen
Datenparser sind spezielle Softwareprogramme oder Algorithmen – oft auch als Parsing-Mechanismen bezeichnet –, die dazu dienen, uneinheitliche Datenformate in ein strukturiertes und korrektes Format umzuwandeln.
Sie lesen die Rohdaten ein, erkennen bestimmte Elemente und ordnen diese nach vordefinierten Regeln oder Mustern.
Dieser Parsing-Vorgang ist unerlässlich, um qualitativ hochwertige Daten in eine Form zu bringen, die für verschiedene Anwendungen verständlich und nutzbar ist.
Es gibt zwei Hauptarten von Datenparsern: selbst entwickelte und Parser von Drittanbietern.
Selbst entwickelte Parser werden von einer Organisation maßgeschneidert, um spezifische Anforderungen zu erfüllen, während Parser von Drittanbietern vorgefertigte Lösungen sind, die von externen Anbietern bereitgestellt werden.
Bedeutung von Datenparsern
- Zugänglichkeit. Durch die Strukturierung von Daten in das richtige Format machen Parser diese für Analysen, Berichte und Entscheidungsfindungen zugänglich.
- Interoperabilität. Parser ermöglichen die Datenintegration über verschiedene Systeme hinweg und gewährleisten so Konsistenz und Kompatibilität, selbst bei inkonsistenten Datenformaten.
- Effizienz. Leistungsstarke Datenparser beschleunigen Parsing-Aufgaben durch die Automatisierung der Transformation und reduzieren so den manuellen Aufwand.
- Genauigkeit. Parser stellen sicher, dass Daten korrekt interpretiert werden, minimieren Fehler und erhöhen die Zuverlässigkeit hochwertiger Daten.
Selbst entwickelte Parser
Selbst entwickelte Parser werden von einem Unternehmen speziell für bestimmte Anforderungen konzipiert und sind somit ein leistungsstarkes Werkzeug für die Datenverarbeitung.
Im Gegensatz zu Lösungen von Drittanbietern ermöglichen selbst entwickelte Parser die Erstellung dedizierter Parsersysteme, die auf die Bewältigung einzigartiger und komplexer Anforderungen zugeschnitten werden können.
-
Spezialisierter Parser. Durch die Entwicklung eines hauseigenen Parsers kann ein Unternehmen einen speziellen Parsing-Mechanismus schaffen, der perfekt auf seine Datenstruktur und Anforderungen abgestimmt ist.
Dadurch wird sichergestellt, dass der Parser genau auf die spezifischen Datenformate und -muster abgestimmt ist, mit denen das Unternehmen regelmäßig arbeitet, was zu einer präzisen Analyse führt.
-
Ideale Lösungen für komplexe Anforderungen. Für Geschäftsabläufe, die mit hochspezialisierten oder komplexen Daten zu tun haben, erweisen sich selbst entwickelte Parser oft als ideale Lösungen, die dabei helfen, fundierte Geschäftsentscheidungen zu treffen.
Sie können so konzipiert werden, dass sie komplexe Datenstrukturen verarbeiten oder strenge Branchenvorschriften und geschäftliche Anforderungen erfüllen, und bieten dabei ein Maß an Anpassbarkeit, das Parser von Drittanbietern möglicherweise nicht bieten.
-
Leistungsstarkes Werkzeug zur Optimierung. Ein selbst entwickelter Parser ist nicht nur ein funktionales Hilfsmittel, sondern ein leistungsstarkes Werkzeug, das so optimiert werden kann, dass es präzise Erkenntnisse für den langfristigen Geschäftserfolg liefert.
Durch die Kontrolle über jeden Aspekt des Parsing-Prozesses kann ein Unternehmen sicherstellen, dass der Parser mit maximaler Effizienz arbeitet und große Datenmengen ohne Engpässe verarbeitet.
-
Herausforderungen und Überlegungen. Selbst entwickelte Parser bieten zwar viele Vorteile, bringen aber auch Herausforderungen mit sich.
Die Entwicklung eines dedizierten Parsers erfordert Fachwissen und kann ressourcenintensiv sein. Die Komplexität der Entwicklung eines Parsers, der komplexe Lösungen verarbeiten kann, kann zudem zu höheren Entwicklungskosten und längeren Implementierungszeiten führen.
Daten-Parser von Drittanbietern
Daten-Parser von Drittanbietern sind vorgefertigte Lösungen externer Anbieter, die Unternehmen bei der Datenerfassung und der Umwandlung der Daten in ein strukturiertes Format unterstützen sollen.
Zu den beliebtesten Parsern von Drittanbietern gehören:
- Apache Commons CSV – Eine Bibliothek zum Lesen und Schreiben von CSV-Dateien.
- Jackson – Ein JSON-Parser für Java, der hohe Leistung und Flexibilität bietet.
- Beautiful Soup – Eine Python-Bibliothek für Web-Scraping, die das Parsen von HTML und XML ermöglicht.
- TinyXML – Ein schlanker XML-Parser, der sich für kleinere Projekte oder eingebettete Systeme eignet.
- Pandas – Eine Python-Bibliothek, die Datenstrukturen für die effiziente Speicherung großer Datensätze bereitstellt und Funktionen zum Parsen von Daten enthält.
Diese Parser verfügen über verschiedene Funktionen und können für unterschiedliche Zwecke eingesetzt werden, beispielsweise:
- XML-Parsing. Parser von Drittanbietern können XML-Dokumente verarbeiten und die Befehlszeichenfolge in ein Format übersetzen, das leicht lesbar und verwaltbar ist.
- Dokument-Parsing. Dokumenten-Parser werden verwendet, um wertvolle Informationen aus verschiedenen Dokumentformaten zu extrahieren.
- Proxy-Parsing. Beim Umgang mit Webdaten und Kommunikationsprotokollen kann ein Proxy-Parser eingesetzt werden, um den Datenfluss zu verwalten.
Vorteile
- Einfache Handhabung. Viele Parser von Drittanbietern sind einfach aufgebaut, sodass sie auch für Nutzer ohne tiefgreifende technische Fachkenntnisse zugänglich sind. Diese Einfachheit beschleunigt oft den Erfassungsprozess.
- Detaillierte Steuerung: Auch wenn sie nicht so anpassbar sind wie selbst entwickelte Parser, bieten viele ausgefeilte Parser eine detaillierte Steuerung, die eine gründliche Analyse und spezifische Datenverarbeitung ermöglicht.
- Optionen für dedizierte Server: Einige Parser von Drittanbietern bieten Optionen für dedizierte Server, was die vollständige Kontrolle über die Parsing-Umgebung gewährleistet und die Leistung verbessert.
- Kontinuierliche Wartung: Anbieter bieten oft eine kontinuierliche Wartung an, wodurch sichergestellt wird, dass der Parser stets auf dem neuesten Stand der Kommunikationsprotokolle und -standards ist.
Herausforderungen
- Eingeschränkte Anpassungsmöglichkeiten. Im Gegensatz zu benutzerdefinierten Skripten in selbst entwickelten Parsern bieten Lösungen von Drittanbietern möglicherweise keine vollständige Kontrolle für sehr spezifische Anforderungen.
- Mögliche Sicherheitsbedenken. Je nach Parser können Bedenken hinsichtlich der Datensicherheit und der Einhaltung branchenweiter Vorschriften bestehen.
- Lizenzierung und Kosten. Die Nutzung eines geeigneten Parsers eines Drittanbieters kann mit Lizenzgebühren sowie laufenden Kosten für Wartung und Support verbunden sein.
Die Zukunft der Datenauswertung
Die Zukunft der Datenauswertung ist geprägt von kontinuierlicher Weiterentwicklung und Innovation, angetrieben durch neue Technologien und Methoden.
Die Integration mit Cloud-Computing, Echtzeit-Parsing-Fähigkeiten, verbesserte Sicherheitsmaßnahmen und anpassbare Lösungen ebnen den Weg für skalierbarere, flexiblere und effizientere Parsing-Tools.
Künstliche Intelligenz (KI) und maschinelles Lernen (ML) spielen bei diesem Wandel eine bedeutende Rolle.
KI-gestützte Parser können Daten nicht nur strukturieren, sondern auch deren Bedeutung interpretieren und so eine Ebene semantischen Verständnisses hinzufügen, die komplexere Analysen ermöglicht.
Darüber hinaus treiben die Nachfrage nach Echtzeitanalysen und die wachsende Sorge um den Datenschutz die Entwicklung robusterer und agilerer Parsing-Lösungen voran.
Die Fähigkeit, Daten im laufenden Betrieb zu parsen, sowie die Einbindung robuster Sicherheitsmaßnahmen werden zu unverzichtbaren Merkmalen moderner Parsing-Tools.
Die Zukunft des Daten-Parsings ist vielversprechend: Technologische Fortschritte sowie die Integration von KI und ML machen das Parsing automatisierter, anpassungsfähiger und aufschlussreicher.
Diese Entwicklungen werden das Daten-Parsing zu einer noch wichtigeren und dynamischeren Komponente in den datengesteuerten Entscheidungsprozessen der Zukunft machen.
Abschließende Gedanken
Die Datenauswertung ist mehr als nur eine technische Notwendigkeit; sie ist ein strategischer Vorteil, der umsetzbare geschäftliche Erkenntnisse liefern kann.
Durch die Umwandlung von rohen, unstrukturierten Daten in ein strukturiertes und verständliches Format ermöglicht die Datenauswertung Unternehmen die Analyse und Interpretation von Informationen, die die Entscheidungsfindung und Innovation vorantreiben können.
Ob es darum geht, das Kundenverhalten zu verstehen, die betriebliche Effizienz zu verbessern oder neue Marktchancen aufzudecken – die Datenauswertung ist ein leistungsstarkes Werkzeug, um aussagekräftige Erkenntnisse zu gewinnen.
Durch Investitionen in geeignete Auswertungsmechanismen – sei es durch eigene Entwicklungen oder durch Lösungen von Drittanbietern – können Unternehmen ihre Fähigkeit verbessern, fundierte, datengestützte Entscheidungen zu treffen.
Wir möchten Sie dazu ermutigen, über die Zahlen hinauszudenken und die Geschichten und Chancen zu erkennen, die in den Daten verborgen sind. Mit der Datenauswertung können Sie Informationen auf eine Weise erkunden, verstehen und nutzen, die Ihr Unternehmen transformieren und zu Wachstum und Erfolg führen kann.

