ETL-Pipelines sind unverzichtbar, da sie einen optimierten Ansatz für die Datenverarbeitung bieten und es Unternehmen ermöglichen, Einblicke in ihre Geschäftsabläufe zu gewinnen und fundierte Entscheidungen zu treffen.
Ein Beispiel für eine ETL-Pipeline ist der Einsatz in einem Einzelhandelsunternehmen, um Verkaufsdaten aus einer Datenbank zu extrahieren, sie in ein für die Analyse geeignetes Format umzuwandeln und sie für Business-Intelligence-Zwecke in ein Data Warehouse zu laden.
Die Pipeline könnte ein Tool wie Apache NiFi oder Talend nutzen, um die Daten zu extrahieren, sie mit Tools wie Apache Spark oder Python zu transformieren und sie in ein Data Warehouse wie Amazon Redshift oder Google BigQuery zu laden.
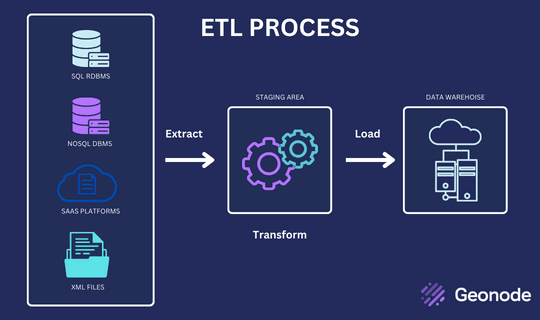
3 Die Komponenten einer ETL-Pipeline
Ein ETL-Pipeline-Vorgang besteht aus drei Hauptkomponenten: Extraktion, Transformation und Laden.
Extraktion
In der Extraktionsphase werden Daten aus verschiedenen Quellen wie Datenbanken, Cloud-Speichern, APIs und Flatfiles abgerufen. Die extrahierten Daten können in verschiedenen Formaten vorliegen, beispielsweise JSON, CSV oder XML.
Transformation
In der Transformationsphase werden die extrahierten Daten in ein nutzbares Format konvertiert, bereinigt und mit zusätzlichen Informationen angereichert. In dieser Phase kommen verschiedene Datenverarbeitungstechniken zum Einsatz, wie z. B. Filtern, Aggregieren, Verknüpfen und Sortieren.
Laden
In der Ladephase werden die transformierten Daten an einem Zielort gespeichert, beispielsweise in einer Datenbank, einem Data Warehouse oder einem Data Lake. Die geladenen Daten können für verschiedene Zwecke genutzt werden, wie zum Beispiel für das Reporting, die Analyse oder maschinelles Lernen.
Datenpipeline vs. ETL-Pipeline
Eine Datenpipeline ist ein allgemeiner Begriff, der sich auf eine Abfolge von Schritten oder Prozessen bezieht, mit denen Daten von einem System oder einer Anwendung in ein anderes übertragen werden. Sie kann verschiedene Komponenten umfassen, wie beispielsweise Datenerfassung, -verarbeitung, -speicherung und -analyse.
Eine ETL-Pipeline (Extract, Transform, Load) ist eine spezielle Art von Datenpipeline, die dazu dient, Daten aus einer oder mehreren Quellen zu extrahieren, sie in ein nützlicheres oder strukturierteres Format umzuwandeln und sie in ein Zielsystem oder eine Zielanwendung zu laden. ETL-Pipelines werden häufig für Data-Warehousing-, Business-Intelligence- und Analyseanwendungen eingesetzt.
Obwohl ETL-Pipelines eine spezielle Art von Datenpipeline sind, werden die beiden Begriffe in der Praxis oft synonym verwendet. Eine Datenpipeline ist im Allgemeinen eine beliebige Reihe von Prozessen oder Tools, die zum Transport, zur Verarbeitung und zur Analyse von Daten verwendet werden. Im Gegensatz dazu bezieht sich eine ETL-Pipeline speziell auf Datenextraktion, Transformation und Laden.
Arten von ETL-Pipelines
Die beiden unterschiedlichen Arten von ETL-Pipelines (Extract, Transform, Load) sind:
Batch-Verarbeitung: Bei dieser Art von Pipeline werden große Datenmengen in Batches verarbeitet, in der Regel täglich oder wöchentlich. Die Daten werden aus Quellsystemen extrahiert, in ein gewünschtes Format transformiert und in einem Batch-Prozess in ein Zielsystem geladen. Batch-ETL eignet sich für Data-Warehousing-, Business-Intelligence- und Analyseanwendungen.
Echtzeitverarbeitung: Bei dieser Art von Pipeline werden Daten nahezu in Echtzeit verarbeitet, sobald sie vom Quellsystem generiert oder empfangen werden. Die Daten werden aus den Quellsystemen extrahiert, in Echtzeit transformiert und in einem kontinuierlichen Prozess in ein Zielsystem geladen.
Die Vorteile der Verwendung einer ETL-Pipeline
ETL-Pipelines bieten zahlreiche Vorteile, darunter:
Optimierte Datenverarbeitung
ETL-Pipelines ermöglichen einen optimierten Ansatz für die Datenverarbeitung, sodass Unternehmen große Datenmengen schnell und effizient verarbeiten können.
Verbesserte Datenqualität
ETL-Pipelines ermöglichen es Unternehmen, die Qualität ihrer Daten zu verbessern, indem sie doppelte Datensätze beseitigen, Fehler korrigieren und Datenstandards durchsetzen.
Geringere Komplexität
ETL-Pipelines reduzieren die Komplexität der Datenverarbeitung, indem sie eine zentrale Schnittstelle für die Verwaltung von Datenintegrationsaufgaben bereitstellen.
Verbesserte Entscheidungsfindung
ETL-Pipelines liefern Unternehmen zeitnahe, genaue und umsetzbare Einblicke in ihre Geschäftsabläufe und ermöglichen es ihnen so, fundierte Entscheidungen zu treffen.
ETL-Sprachen
ETL-Pipelines können mithilfe einer Vielzahl von Programmiersprachen und Tools implementiert werden, je nach den spezifischen Anforderungen der Pipeline und den verwendeten Technologien. Zu den häufig verwendeten ETL-Sprachen und -Tools gehören:
SQL (Structured Query Language): SQL ist eine Standardsprache zur Verwaltung und Abfrage von Daten in relationalen Datenbanken. ETL-Pipelines nutzen sie häufig, um Daten aus Datenbanken zu extrahieren und zu transformieren.
Python: Python ist eine beliebte Programmiersprache, die für eine Vielzahl von Datenverarbeitungs- und Analyseaufgaben eingesetzt wird, darunter auch ETL-Pipelines. Für Python stehen zahlreiche Bibliotheken und Frameworks zur Datenbearbeitung, -transformation und zum Datenladen zur Verfügung, wie beispielsweise Pandas, NumPy und Apache Airflow.
Java: Java ist eine weit verbreitete Programmiersprache, die zum Aufbau von ETL-Pipelines verwendet werden kann. Es stehen mehrere Java-basierte ETL-Tools zur Verfügung, wie beispielsweise Apache NiFi, Talend und Apache Beam.
R: R ist eine Programmiersprache, die häufig für statistische Analysen und Datenvisualisierung verwendet wird. Sie verfügt über zahlreiche Bibliotheken und Pakete zur Datenbearbeitung und -transformation und kann zum Aufbau von ETL-Pipelines genutzt werden.
ETL-Tools: Es stehen zudem zahlreiche ETL-Tools zur Verfügung, die eine grafische Benutzeroberfläche für die Erstellung und Verwaltung von ETL-Pipelines bieten, wie beispielsweise Talend, Informatica und Microsoft SSIS. Diese Tools unterstützen oft eine Vielzahl von Programmiersprachen und Datenquellen und können den Prozess der Erstellung und Wartung von ETL-Pipelines vereinfachen.
Bewährte Verfahren für die Konzeption und Implementierung von ETL-Pipelines
Unternehmen müssen bestimmte bewährte Verfahren befolgen, um den Erfolg einer ETL-Pipeline sicherzustellen, darunter:
Definieren Sie Ihre Datenquellen und Anforderungen
Vor der Konzeption einer ETL-Pipeline müssen Unternehmen ihre Datenquellen und Anforderungen definieren. Dazu gehört die Ermittlung der zu integrierenden Datenquellen, ihrer Datenformate und der Datenqualitätsstandards, die sie erfüllen müssen.
Wählen Sie die richtigen Tools
Die Auswahl der richtigen Tools ist entscheidend für die Konzeption und Implementierung einer ETL-Pipeline. Darüber hinaus sollten Unternehmen die Skalierbarkeit, Flexibilität und Kosteneffizienz der ausgewählten Tools berücksichtigen.
Erstellen Sie einen klaren Datenfluss
Ein klarer Datenfluss ist unerlässlich für die Konzeption einer effizienten und effektiven ETL-Pipeline. Darüber hinaus sollte der Datenfluss leicht verständlich sein, und die verschiedenen Phasen der Pipeline sollten klar definiert sein.
Implementieren Sie eine robuste Fehlerbehandlung
Eine robuste Fehlerbehandlung ist unerlässlich, um die Zuverlässigkeit einer ETL-Pipeline zu gewährleisten. Daher sollten Unternehmen Mechanismen zur Fehlerbehandlung implementieren, die Fehler erkennen und beheben können.
Testen und überwachen Sie Ihre Pipeline regelmäßig
Das regelmäßige Testen und Überwachen einer ETL-Pipeline ist unerlässlich, um ihre Effektivität sicherzustellen und potenzielle Probleme zu identifizieren, bevor sie zu Störungen führen.
Häufige Herausforderungen bei ETL-Pipelines und wie man sie bewältigt
Trotz ihrer Vorteile können ETL-Pipelines auch gewisse Herausforderungen mit sich bringen, darunter:
Dateninkonsistenzen
Dateninkonsistenzen können auftreten, wenn die in einer ETL-Pipeline verwendeten Datenquellen Fehler oder Unstimmigkeiten enthalten. Um dieses Problem zu beheben, müssen Datenqualitätsprüfungen und Bereinigungsmechanismen durchgeführt werden.
Probleme mit der Datenqualität
Probleme mit der Datenqualität können auftreten, wenn die in einer ETL-Pipeline verwendeten Daten von schlechter Qualität sind oder Ungenauigkeiten enthalten. Unternehmen sollten Datenqualitätsprüfungen und Validierungsmechanismen implementieren, um die Genauigkeit und Konsistenz der Daten sicherzustellen.
Leistungsengpässe
Leistungsengpässe können auftreten, wenn eine ETL-Pipeline überlastet ist oder sich nicht skalieren lässt, um steigende Datenmengen zu bewältigen. Um dieses Problem zu vermeiden, sollten Unternehmen ihre ETL-Pipelines hinsichtlich Leistung und Skalierbarkeit optimieren.
Begrenzte Skalierbarkeit
Eine begrenzte Skalierbarkeit kann auftreten, wenn eine ETL-Pipeline nicht in der Lage ist, große Datenmengen zu verarbeiten. ETL-Pipelines sollten skalierbar ausgelegt sein und verteilte Rechentechnologien nutzen, um dieses Problem zu beheben.
Fazit
Zusammenfassend lässt sich sagen, dass eine ETL-Pipeline ein wesentlicher Bestandteil eines umfassenden Datenverarbeitungssystems ist. Sie ermöglicht es Unternehmen, große Datenmengen aus verschiedenen Quellen zu erfassen, zu transformieren und zu laden sowie Einblicke in ihre Geschäftsabläufe zu gewinnen. Um jedoch eine effektive ETL-Pipeline zu entwerfen und zu implementieren, müssen Unternehmen bestimmte bewährte Verfahren befolgen, wie beispielsweise die Definition ihrer Datenquellen und Anforderungen, die Auswahl der richtigen Tools, die Erstellung eines klaren Datenflusses, die Implementierung einer robusten Fehlerbehandlung sowie das regelmäßige Testen und Überwachen ihrer Pipeline.
Häufig gestellte Fragen
-
Was ist der Unterschied zwischen ETL und einer Datenpipeline?
ETL und Datenpipeline sind zwei miteinander verbundene, aber unterschiedliche Konzepte. ETL steht für „Extract, Transform und Load (Extrahieren, Transformieren und Laden) und bezeichnet einen spezifischen Prozess, bei dem Daten aus verschiedenen Quellen extrahiert, in ein nutzbares Format umgewandelt und in ein Zielsystem geladen werden. Eine Datenpipeline hingegen ist ein weiter gefasstes Konzept, das den Datentransfer zwischen verschiedenen Systemen und Anwendungen umfasst und ETL als Teil des Gesamtprozesses beinhalten kann.
-
Ist SQL ein ETL-Tool?
SQL ist an sich kein ETL-Tool, wird jedoch häufig in ETL-Prozessen zur Bearbeitung und Transformation von Daten eingesetzt. Mit SQL lassen sich verschiedene Datentransformationen durchführen, wie beispielsweise Filtern, Aggregieren und Verknüpfen, die wesentliche Bestandteile der Transformationsphase in einer ETL-Pipeline sind.
-
Wie erstellt man eine ETL-Pipeline?
Die Erstellung einer ETL-Pipeline umfasst mehrere Schritte, darunter die Definition von Datenquellen und Anforderungen, die Auswahl der richtigen Tools, die Erstellung eines klaren Datenflusses, die Implementierung einer robusten Fehlerbehandlung sowie das regelmäßige Testen und Überwachen der Pipeline. Zu den gängigen Tools für die Erstellung von ETL-Pipelines gehören Apache Kafka, Apache Spark und Talend Open Studio.
-
Was ist ETL in DevOps?
In DevOps bezieht sich ETL auf den Prozess der Integration von Daten aus verschiedenen Quellen in die DevOps-Pipeline. Dies kann das Extrahieren von Daten aus Quellcode-Repositorys, Build-Tools und Testautomatisierungs-Frameworks, deren Transformation in ein nutzbares Format sowie das Laden in ein Zielsystem, wie beispielsweise ein Data Warehouse oder ein Business-Intelligence-Tool, umfassen. ETL in DevOps ist unerlässlich, um Teams Echtzeit-Einblicke in ihre Softwareentwicklungsprozesse zu verschaffen und ihnen datengestützte Entscheidungen zu ermöglichen.
Quellenangaben
Sharma, V. (13. Juni 2022). Ein umfassender Leitfaden zum Aufbau einer ETL-Pipeline für Einsteiger. Analytics Vidhya. Abgerufen am 10. März 2023 von https://www.analyticsvidhya.com/blog/2022/06/a-complete-guide-on-building-an-etl-pipeline-for-beginners/
Was ist eine ETL-Pipeline? (o. J.). Snowflake. Abgerufen am 10. März 2023 von https://www.snowflake.com/guides/etl-pipeline
Was ist eine ETL-Pipeline? Vergleich zwischen Datenpipeline und ETL. (o. J.). Qlik. Abgerufen am 10. März 2023 von https://www.qlik.com/us/etl/etl-pipeline

