Mengapa Mengumpulkan Data dari Twitter?
Data Twitter, mengingat sifatnya yang real-time dan banyaknya opini publik yang terkandung di dalamnya, dapat dimanfaatkan dalam berbagai cara di berbagai bidang, seperti:
• Pemantauan Merek. Perusahaan dapat menggunakan data Twitter untuk memantau apa yang dibicarakan tentang merek mereka secara real-time. Hal ini dapat membantu mereka merespons keluhan atau pertanyaan pelanggan dengan cepat, melacak efektivitas kampanye pemasaran, dan memahami sentimen publik terhadap merek mereka. Misalnya, lonjakan tiba-tiba dalam sentimen negatif tentang suatu produk dapat menandakan adanya masalah yang perlu segera ditangani.
• Analisis Tren. Twitter sering kali menjadi tempat munculnya tren baru, sehingga menjadikannya sumber daya yang berharga untuk analisis tren. Dengan menganalisis isi cuitan, perusahaan dapat mengidentifikasi tren yang sedang berkembang di industri mereka, melacak popularitas topik tertentu dari waktu ke waktu, dan bahkan memprediksi tren di masa depan. Hal ini dapat menjadi dasar bagi strategi bisnis, mulai dari pengembangan produk hingga pemasaran dan penjualan.
• Penelitian Akademik. Para peneliti di bidang seperti sosiologi, linguistik, dan ilmu politik dapat menggunakan data Twitter untuk berbagai tujuan. Misalnya, mereka mungkin menganalisis cuitan pengguna untuk mempelajari penggunaan bahasa, meneliti penyebaran informasi atau disinformasi, atau menyelidiki respons publik terhadap peristiwa atau kebijakan tertentu.
• Jurnalisme. Jurnalis dapat menggunakan data Twitter untuk menemukan berita terkini, memantau perkembangan suatu peristiwa, dan mengukur opini publik mengenai berbagai isu. Dalam beberapa kasus, cuitan itu sendiri dapat menjadi berita. Misalnya, cuitan dari tokoh publik dapat memiliki dampak yang signifikan dan sering diliput oleh media.
Ini hanyalah beberapa contoh bagaimana data dari miliaran cuitan dapat dimanfaatkan. Kemungkinannya sangat luas dan terus berkembang seiring semakin banyaknya orang yang beralih dari platform media sosial lain ke Twitter untuk berbagi pemikiran dan pengalaman mereka.
Memahami Data Twitter
Sebelum mendalami metode penggalian data Twitter, penting untuk memahami empat jenis data yang tersedia di Twitter serta wawasan potensial yang dapat diperoleh darinya.
• Tweet. Tweet adalah unit informasi paling dasar di Twitter. Tweet adalah pesan yang diposting oleh pengguna dan dapat berisi hingga 280 karakter. Setiap tweet mengandung banyak data, termasuk isi tweet, waktu posting, jumlah suka dan retweet yang diterima, serta tagar yang digunakan. Menganalisis data tweet dapat memberikan wawasan mengenai topik yang sedang tren, sentimen terhadap suatu topik tertentu, jangkauan sebuah tagar, dan banyak lagi.
• Pengguna. Data pengguna merujuk pada informasi yang terkait dengan akun Twitter. Ini mencakup nama pengguna, deskripsi profil, lokasi, jumlah pengikut dan yang diikuti, jumlah tweet, serta tanggal pembuatan akun. Dengan menganalisis data pengguna, Anda dapat memperoleh wawasan mengenai demografi basis pengguna, mengidentifikasi influencer di bidang tertentu, atau melacak pertumbuhan akun Twitter dari waktu ke waktu.
• Entitas. Entitas dalam data Twitter merujuk pada objek yang terkait dengan sebuah tweet. Hal ini mencakup tagar, sebutan pengguna, URL, dan media (foto dan video). Entitas memberikan cara untuk memahami konteks sebuah cuitan. Misalnya, menganalisis tagar yang terkait dengan sebuah cuitan dapat membantu mengidentifikasi topik yang sedang dibahas, sementara memeriksa sebutan pengguna dapat mengungkap jaringan interaksi.
• Lokasi. Data ini merujuk pada informasi geografis yang terkait dengan sebuah tweet atau pengguna. Ini bisa berupa lokasi tempat tweet tersebut diposting atau lokasi yang ditentukan dalam profil pengguna. Menganalisis data lokasi dapat memberikan wawasan mengenai tren geografis, penyebaran informasi di berbagai lokasi, atau popularitas suatu topik di wilayah yang berbeda.
Setiap jenis data memiliki signifikansi tersendiri dan dapat memberikan wawasan yang unik. Sebagai contoh, data tweet dapat membantu mengidentifikasi topik yang sedang tren dan sentimen publik, data pengguna dapat mengungkap influencer dan demografi audiens, entitas dapat memberikan konteks pada diskusi, dan data lokasi dapat mengungkap tren geografis.
Dengan memahami dan menganalisis jenis-jenis data ini, Anda dapat menggali berbagai wawasan berharga dari Twitter. Baik untuk riset pasar, pemantauan merek, penelitian akademis, maupun jurnalisme, data Twitter menyediakan sumber daya yang kaya dan dinamis untuk memahami opini publik, melacak tren, dan menangkap denyut nadi percakapan global.
Cara Mengambil Data Twitter: Tiga Cara
1. API Twitter
API resmi Twitter memungkinkan pengembang untuk berinteraksi dengan platformnya secara terprogram. API ini menyediakan akses ke berbagai jenis data, termasuk cuitan, profil Twitter, dan lainnya.
Mengapa Menggunakan API Twitter?
• Data Terstruktur. Data yang dikembalikan oleh API terstruktur dengan baik dan konsisten, sehingga lebih mudah untuk diolah dan diparsing.
• Keandalan. Karena API ini disediakan langsung oleh Twitter, keandalan dan kelangsungan layanannya terjamin.
• Dokumentasi yang Lengkap. Twitter menyediakan dokumentasi yang komprehensif untuk API-nya, sehingga memudahkan pengembang untuk memahami dan menggunakan API secara efektif.
Batasan API Twitter
• Batas Frekuensi. Untuk mencegah penyalahgunaan, Twitter memberlakukan batasan pada API-nya untuk periode waktu tertentu. Misalnya, seseorang hanya dapat melakukan 900 permintaan setiap 15 menit untuk permintaan timeline pengguna dengan aplikasi yang telah diautentikasi oleh pengguna.
• Akses Data. Tidak semua data dapat diakses melalui API. Misalnya, Anda hanya dapat mengakses 3.200 tweet terbaru dari timeline pengguna.
• Biaya. Meskipun Twitter menyediakan paket gratis untuk API-nya, paket tersebut memiliki batasan yang signifikan. Akses ke lebih banyak data dan batas frekuensi yang lebih tinggi memerlukan langganan berbayar, yang biayanya bisa cukup mahal.
Langkah-langkah Menggunakan API Twitter untuk Mengambil Data Twitter:
API Twitter adalah alat yang sangat berguna yang memungkinkan pengembang mengakses berbagai macam data Twitter secara terprogram. Berikut adalah panduan langkah demi langkah tentang cara menggunakannya:
1. Buat Akun Pengembang
• Kunjungi situs web Pengembang Twitter (https://developer.twitter.com/
).
• Klik tombol 'Apply'.
• Anda akan diminta untuk masuk ke akun Twitter Anda. Jika belum memiliki akun, Anda perlu membuatnya.
• Setelah masuk, isi formulir pendaftaran untuk mengajukan akun pengembang. Formulir tersebut meminta detail tentang bagaimana Anda berencana menggunakan API. Jelaskan sedetail mungkin untuk meningkatkan peluang persetujuan.
• Setelah mengirimkan permohonan, tunggu persetujuan dari Twitter. Proses ini bisa memakan waktu beberapa hari, jadi bersabarlah.
2. Buat Aplikasi dan Dapatkan Kunci API
• Masuk ke Akun Pengembang Twitter Anda.
• Buka 'Dashboard' dan klik 'Create an app'.
• Isi formulir dengan detail mengenai aplikasi Anda. Cantumkan nama, deskripsi, URL situs web, dan jelaskan kepada Twitter bagaimana Anda berencana menggunakan aplikasi tersebut.
• Catat kunci API yang muncul di halaman setelah aplikasi Anda dibuat. Terdapat dua set kunci: kunci API dan rahasia, serta token akses dan rahasia. Anda akan memerlukan kunci-kunci ini untuk mengautentikasi aplikasi Anda saat menggunakan API.
3. Gunakan Tweepy untuk Mengakses 'Scraper API
' Twitter
Ikuti langkah-langkah berikut:
• Impor pustaka Tweepy.
• Lakukan autentikasi ke Twitter menggunakan kunci API Anda.
• Buat objek API yang dapat Anda gunakan untuk berinteraksi dengan API Twitter.
• Gunakan metode user_timeline untuk mengambil tweet terbaru dari timeline pengguna (dalam hal ini, 'twitter') dan tampilkan teks setiap tweet.
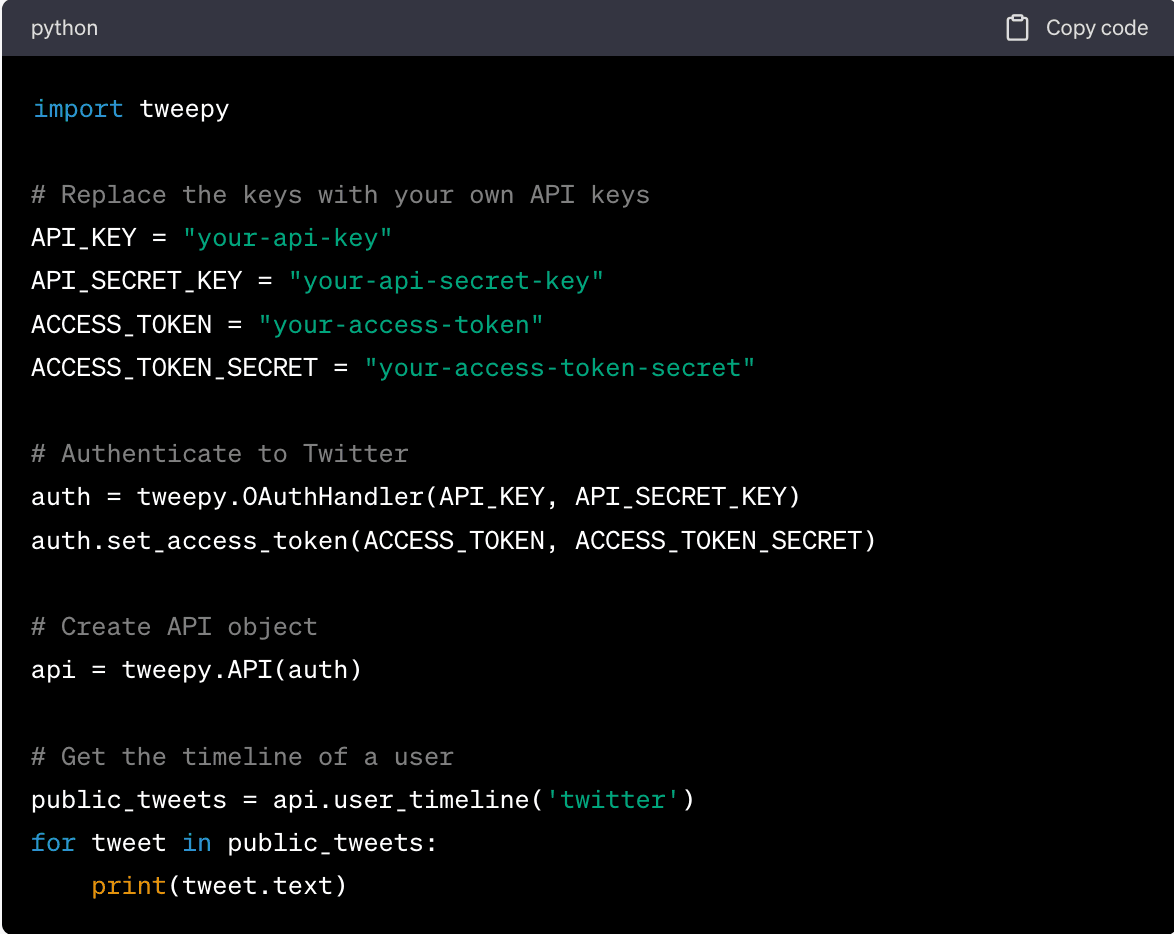
Ingatlah untuk mengganti 'your-api-key', 'your-api-secret-key', 'your-access-token', dan 'your-access-token-secret' dengan kunci API Anda sendiri. Selain itu, gantilah 'twitter' dengan nama pengguna akun Twitter yang ingin Anda ambil tweet-nya.
Ini hanyalah contoh sederhana, namun Tweepy menyediakan banyak metode lain untuk mengakses berbagai jenis data Twitter. Silakan lihat dokumentasi Tweepy untuk informasi lebih lanjut.
Singkatnya, meskipun API Twitter menyediakan cara yang andal dan terstruktur untuk mengakses data Twitter, API ini memiliki batasan terkait batas kecepatan, akses data, dan biaya. Keterbatasan ini dapat menjadi hambatan yang signifikan bagi proyek ekstraksi data berskala besar. Dalam kasus seperti itu, web scraping dapat menjadi alternatif yang lebih fleksibel dan hemat biaya, yang akan kita bahas pada bagian berikutnya.
2. Web Scraping Twitter dengan Python
Web scraping Twitter dengan Python adalah proses ekstraksi data secara otomatis dari situs web Twitter menggunakan bahasa pemrograman Python. Proses ini sering digunakan untuk mengumpulkan data dalam jumlah besar dari Twitter yang akan memakan waktu terlalu lama jika dikumpulkan secara manual.
Mengapa Menggunakan Python?
• Pustaka yang Kuat. Python memiliki ekosistem pustaka yang kaya yang menyederhanakan proses web scraping. Pustaka seperti Tweepy, BeautifulSoup, dan Scrapy dapat menangani segala hal, mulai dari membuat permintaan HTTP hingga mengurai HTML dan berinteraksi dengan API.
• Kemudahan Penggunaan. Sintaks Python jelas dan ringkas, sehingga menjadikannya bahasa pemrograman yang baik untuk web scraping. Bahkan tugas-tugas scraping yang kompleks pun dapat diselesaikan dengan baris kode yang relatif sedikit.
• Alat Analisis Data. Python juga sangat baik untuk menganalisis data. Pustaka seperti Pandas, Numpy, dan Matplotlib memudahkan pembersihan, analisis, dan visualisasi data yang telah di-scraping.
• Dukungan Komunitas. Python memiliki komunitas yang besar dan aktif sehingga sangat mudah menemukan bantuan dan sumber daya secara online. Jika Anda menemui masalah, kemungkinan besar sudah ada orang lain yang menyelesaikannya.
Keterbatasan Python
• Konten Dinamis. Alat pengikisan web standar Python kesulitan menangani konten dinamis yang dimuat menggunakan JavaScript. Ada cara untuk mengatasinya, seperti menggunakan pustaka seperti Selenium, tetapi hal ini menambah tingkat kerumitan pada proyek pengikisan Twitter.
• Pembatasan Laju. Twitter memberlakukan batasan laju API, yang dapat memperlambat proyek web scraping Anda. Meskipun ada cara untuk mengatasinya, seperti menggunakan beberapa akun atau alamat IP, metode-metode ini melanggar ketentuan layanan Twitter.
• Perubahan Struktur Situs Web. Jika Twitter mengubah struktur situs web atau API-nya, kode pengikisan Anda mungkin berhenti berfungsi. Anda perlu memperbarui kode Anda agar sesuai dengan perubahan tersebut, yang bisa memakan waktu.
Langkah-langkah Menggunakan Python untuk Pengikisan Web Twitter:
1. Siapkan Lingkungan. Instal Python dan pustaka yang diperlukan jika Anda belum memilikinya. Untuk contoh ini, kita akan menggunakan BeautifulSoup dan Requests.
2. Kirim permintaan HTTP ke halaman Twitter yang ingin Anda ambil datanya.
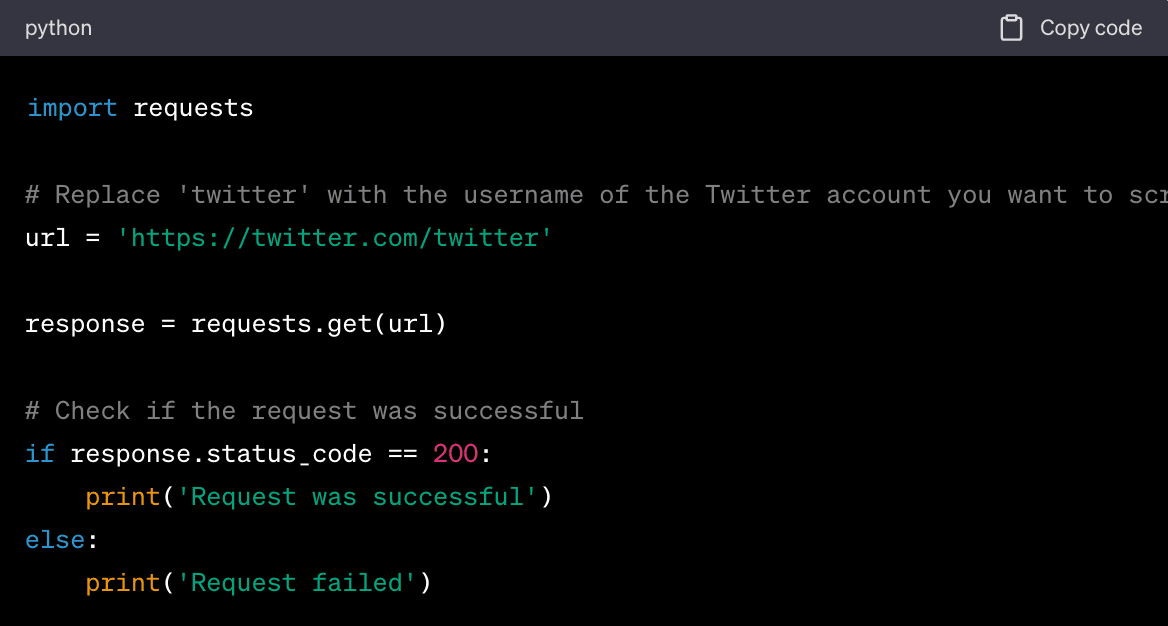
Server merespons permintaan tersebut dengan mengembalikan konten HTML dari halaman web tersebut.
3. Uraikan data. Karena data berada dalam format HTML, Anda memerlukan parser yang dapat mengurai dan mengekstrak data yang diinginkan.
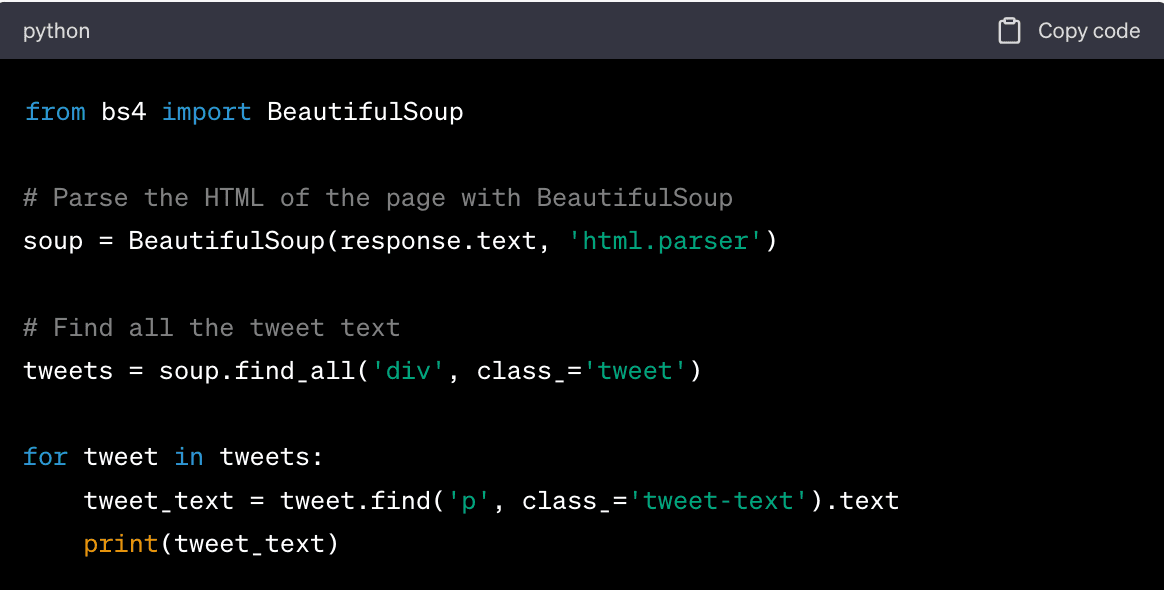
Dalam kode ini, pertama-tama kita membuat objek BeautifulSoup dan mengurai HTML halaman tersebut. Selanjutnya, kita mencari semua elemen div dengan kelas 'tweet', yang berisi tweet-tweet tersebut. Untuk setiap tweet, kita mencari elemen p dengan kelas 'tweet-text', yang berisi teks tweet tersebut, lalu menampilkannya.
4. Gunakan metode pencarian untuk menemukan elemen data tertentu. Dengan BeautifulSoup, misalnya, Anda dapat menggunakan metode seperti find_all() untuk menemukan tag header, paragraf, atau elemen lainnya.
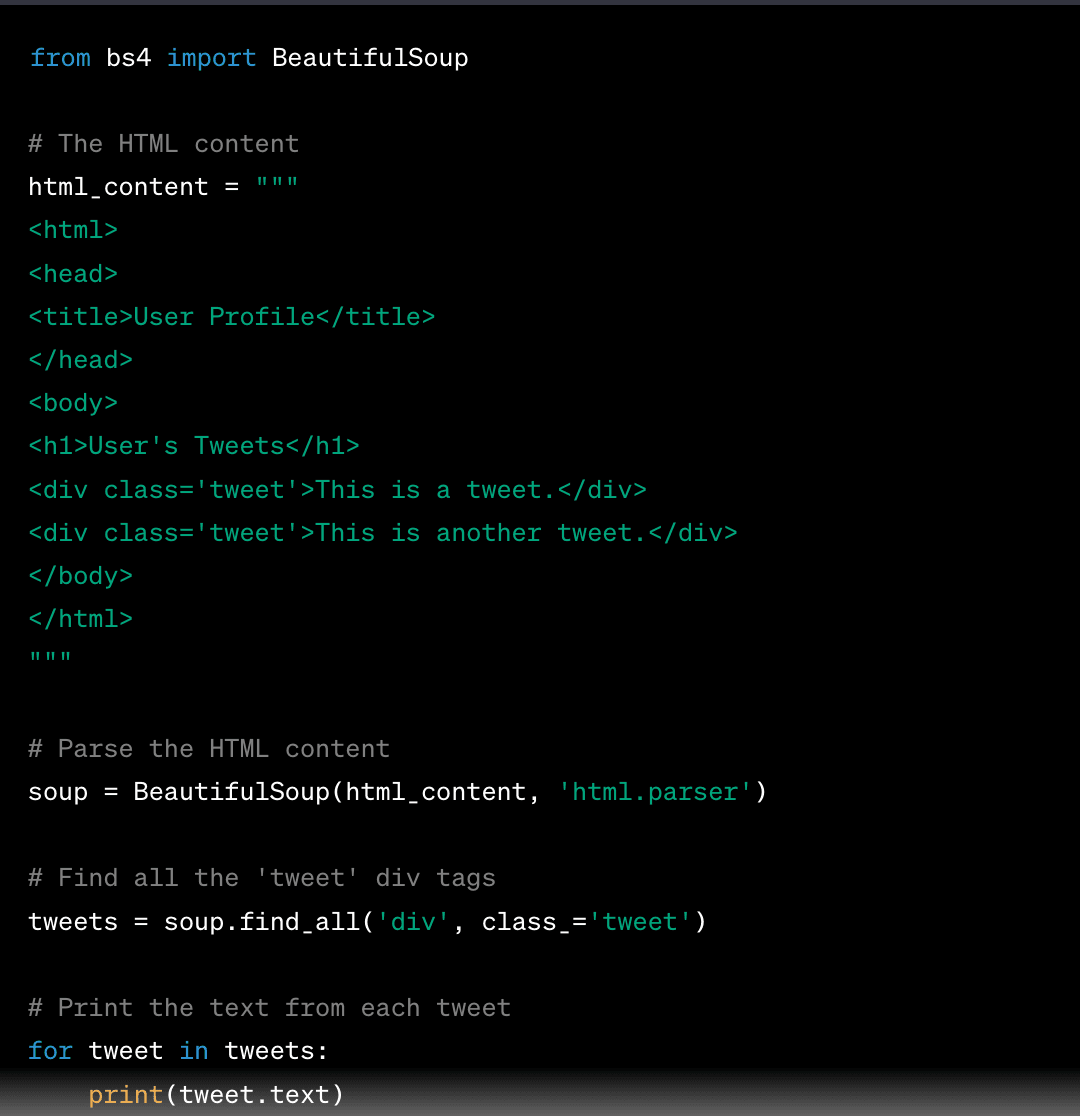
5. Simpan data dalam format yang Anda inginkan, seperti CSV, JSON, atau basis data. Berikut cara menyimpannya dalam berkas CSV menggunakan pustaka Pandas:
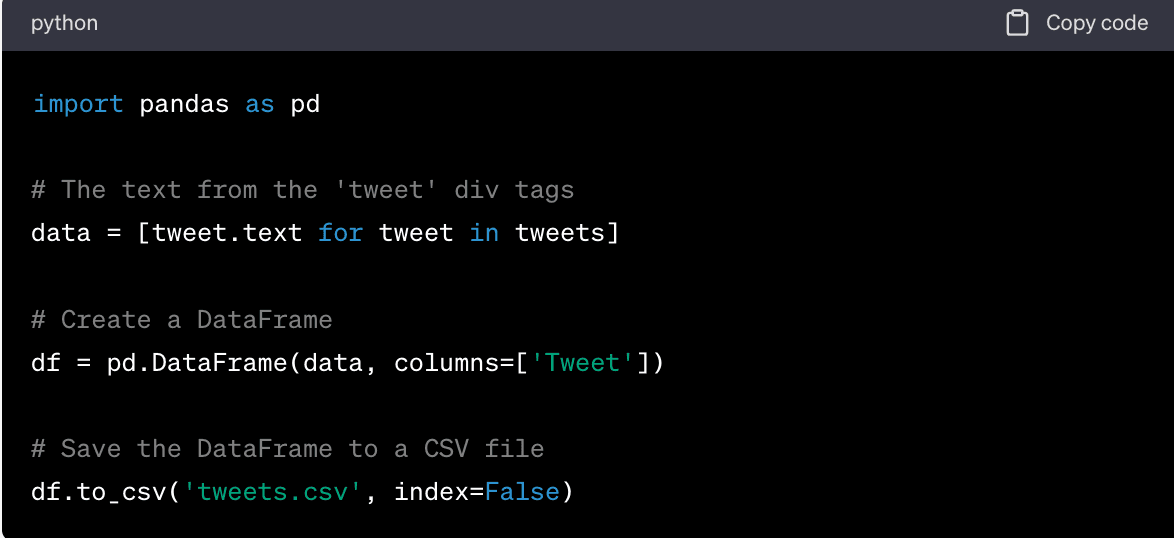
Ini akan membuat berkas CSV bernama 'tweets.csv' dengan satu kolom 'Tweet' yang berisi teks dari tag div 'tweet'. Berikut adalah contoh sederhana tentang cara mengekstrak teks dari sebuah tweet menggunakan Python dan BeautifulSoup:
3. Geonode
Scraper API
dari
Geonode
adalah alat yang sangat berguna yang memungkinkan Anda mengekstrak data dari situs web seperti Twitter. Alat ini menawarkan berbagai mode pengikisan untuk kinerja dan efisiensi yang optimal.
Mengapa Menggunakan Scraper Pay-As-You-Go
dari Geonode
?
• Harga Fleksibel. Model pay-as-you-go
memungkinkan Anda hanya membayar sesuai penggunaan. Hal ini bisa lebih hemat biaya daripada model berlangganan, terutama untuk penggunaan yang tidak teratur atau dalam volume rendah.
• Skalabilitas. Scraper API
ini dirancang untuk menangani tugas pengikisan data baik skala kecil maupun besar. Artinya, Anda dapat meningkatkan skala tugas pengikisan data sesuai kebutuhan tanpa khawatir melebihi batas penggunaan.
• Kemudahan Penggunaan. Scraper API
dari Geonode
mudah digunakan, bahkan bagi mereka yang tidak memiliki pengetahuan pemrograman. Layanan ini menyediakan cara sederhana untuk mengekstrak data dari Twitter.
• Fitur-Fitur Lanjutan. Geonode
's Scraper API
menawarkan berbagai fitur lanjutan seperti rendering JavaScript, eksekusi potongan kode JS kustom, proksi bergilir, penargetan geografis, dan banyak lagi. Fitur-fitur ini bisa sangat berguna untuk tugas-tugas pengikisan data yang kompleks.
• Mode Real-Time dan Callback. API ini menyediakan dua mode untuk pengikisan: Mode Real-Time dan Mode Callback. Hal ini memberi Anda fleksibilitas dalam cara Anda menerima hasil pengikisan.
Keterbatasan Scraper Pay-As-You-Go
dari GeoNode
• Biaya Dapat Menumpuk: Meskipun model pay-as-you-go
dapat hemat biaya untuk penggunaan volume rendah, biaya dapat menumpuk dengan cepat untuk tugas pengikisan skala besar. Penting untuk memantau penggunaan Anda guna menghindari biaya tak terduga.
• Kurva Pembelajaran: Meskipun Scraper API
dari GeoNode
dirancang agar mudah digunakan, tetap ada kurva pembelajaran, terutama bagi mereka yang baru mengenal pengikisan web atau API secara umum.
• **Bergantung pada Layanan GeoNode
**: Seperti halnya layanan pihak ketiga lainnya, Anda bergantung pada layanan GeoNode
untuk tugas-tugas pengikisan data Anda. Jika ada masalah dengan layanan mereka, hal itu dapat memengaruhi tugas-tugas pengikisan data Anda.
• Pertimbangan Hukum dan Etika: Web scraping bisa jadi berada di wilayah abu-abu secara hukum. Meskipun Scraper API
dari GeoNode
memudahkan pengambilan data, penting untuk memastikan bahwa aktivitas pengambilan data Anda mematuhi ketentuan layanan situs web yang Anda ambil datanya serta undang-undang privasi yang relevan.
Langkah-langkah Menggunakan Geonode Scraper API untuk Mengambil Data dari Twitter
1. Siapkan Permintaan Anda. Untuk menggunakan GeoNode Scraper API, Anda perlu menyiapkan sebuah permintaan. Permintaan ini harus mencakup URL halaman yang ingin Anda ambil datanya (dalam hal ini, halaman Twitter), serta serangkaian konfigurasi yang mengatur cara kerja alat pengambil data tersebut. Berikut adalah contoh cara menyusun permintaan Anda:
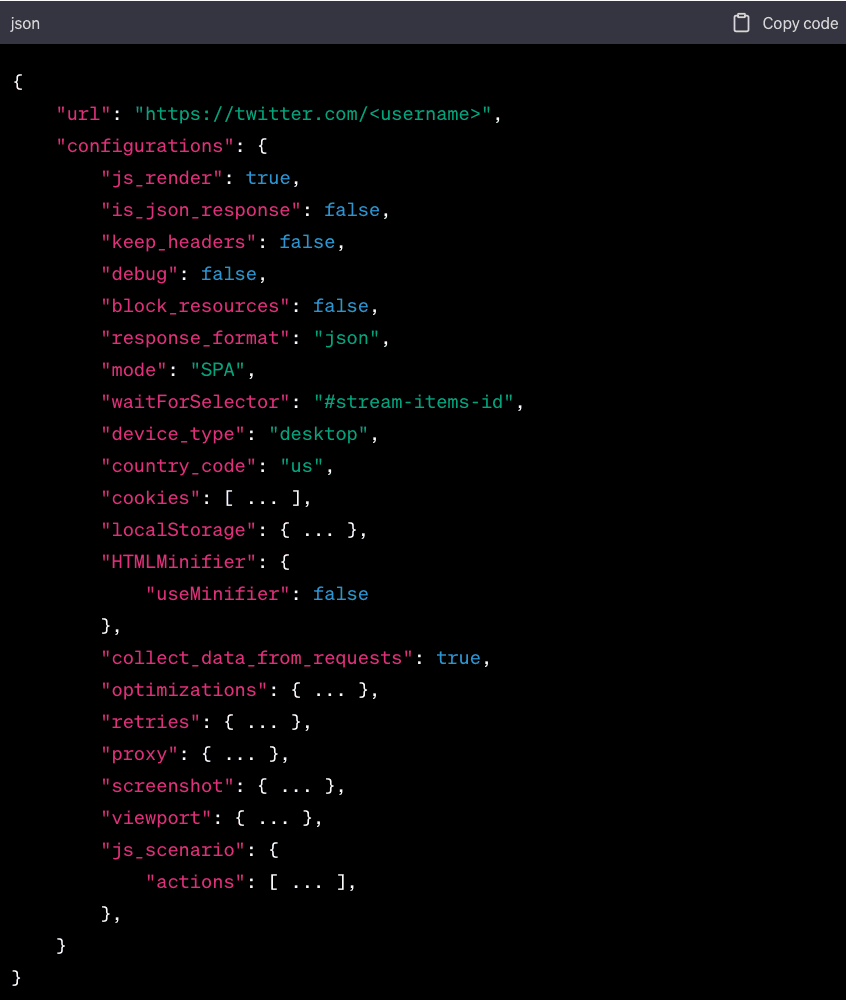
Dalam contoh ini, url adalah halaman Twitter yang ingin Anda ambil datanya. Parameter waitForSelector diatur ke #stream-items-id, yang merupakan ID dari elemen div yang berisi tweet di halaman Twitter. Ini memberi tahu scraper untuk menunggu hingga elemen ini dimuat sebelum melakukan pengikisan halaman.
2. Mode Realtime dan Mode Callback. GeoNode Scraper API menyediakan dua mode untuk pengikisan: Mode Realtime dan Mode Callback. Dalam Mode Realtime, API mengembalikan hasil segera setelah pengikisan selesai. Dalam Mode Callback, API mengirimkan hasilnya ke URL callback yang ditentukan setelah proses pengikisan selesai. Anda dapat memilih mode yang paling sesuai dengan kebutuhan Anda.
3. Periksa Status Tugas Anda. Anda dapat memeriksa status tugas pengikisan Anda menggunakan ID permintaan yang Anda terima dalam respons awal. Hal ini memungkinkan Anda melacak kemajuan tugas Anda dan menentukan status penyelesaiannya.
4. Tindakan. Geonode Scraper API memungkinkan Anda berinteraksi dengan dokumen target melalui daftar tindakan yang didukung. Misalnya, Anda dapat menggunakan tindakan untuk mengklik tombol atau mengisi formulir di halaman sebelum melakukan penggalian data.
Menganalisis Data Twitter
Setelah Anda mengumpulkan dan menyimpan data Twitter, langkah selanjutnya adalah menganalisisnya. Berikut ini panduan langkah demi langkah:
**1. Analisis Dasar. **
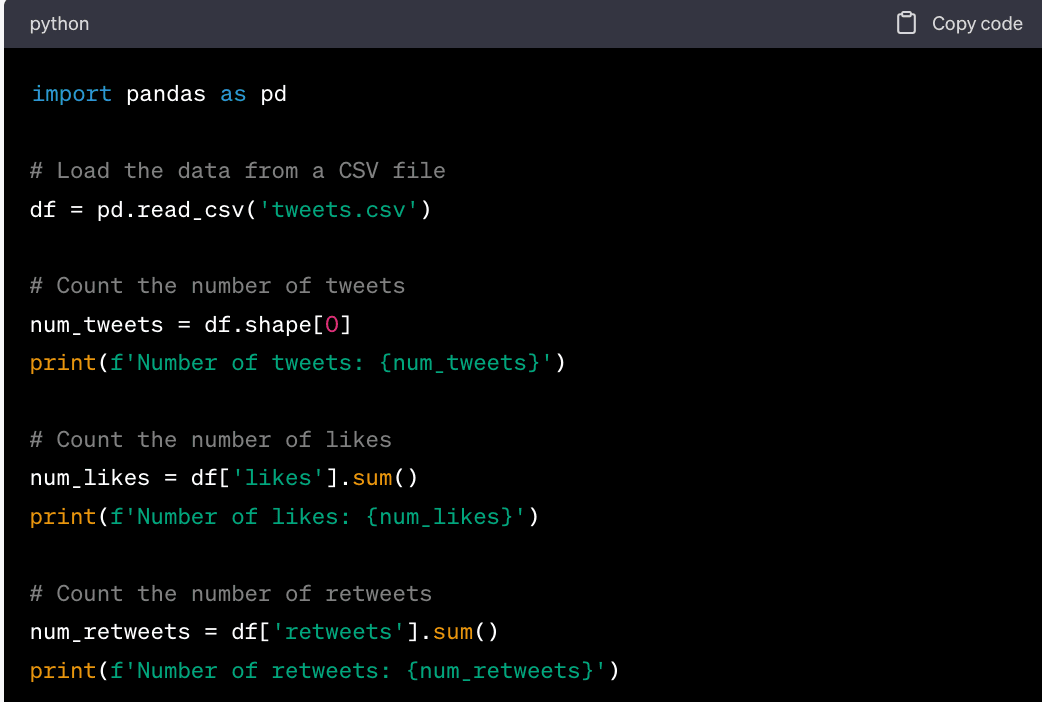
Analisis dasar melibatkan penghitungan tweet, suka, retweet, dan metrik sederhana lainnya. Berikut adalah contoh cara melakukannya menggunakan pandas, sebuah pustaka analisis data yang kuat untuk Python:
2. Analisis Sentimen
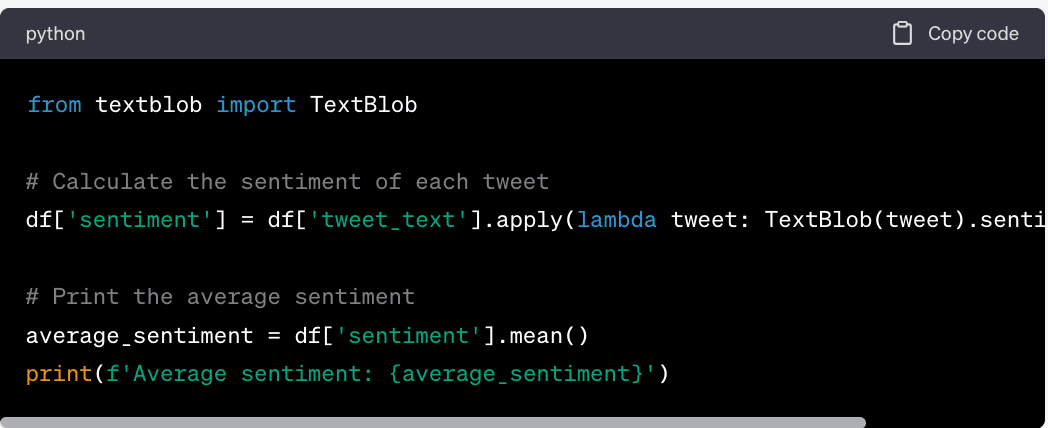
Analisis sentimen melibatkan penentuan sentimen dari sebuah teks, seperti tweet. Berikut adalah contoh cara melakukannya menggunakan TextBlob, sebuah pustaka untuk memproses data tekstual:
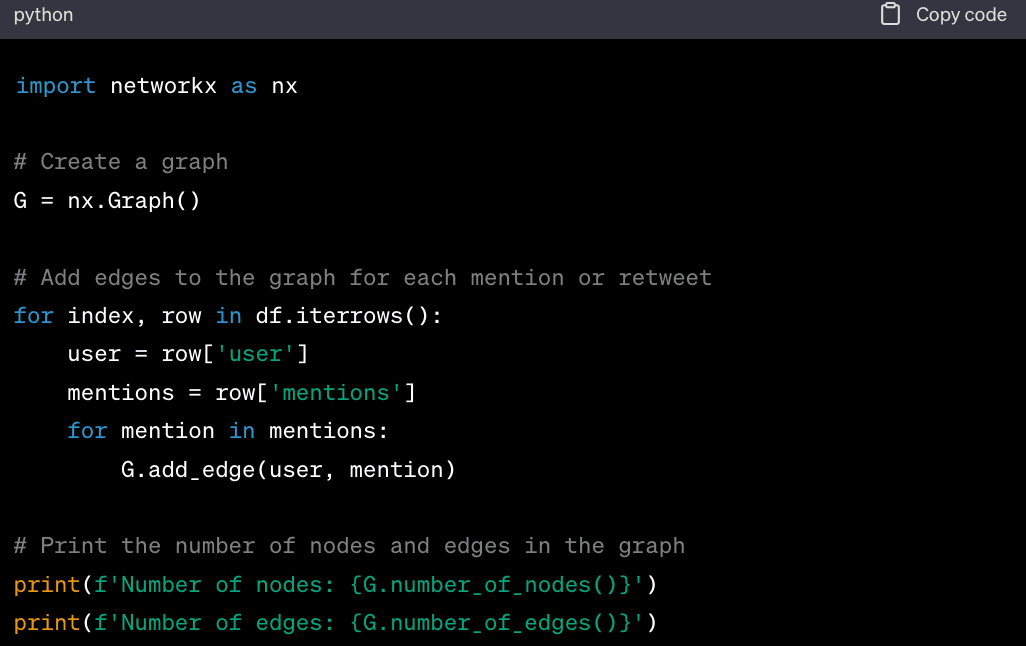
3. Analisis Jaringan
Analisis jaringan melibatkan analisis hubungan antar pengguna Twitter. Hal ini dapat dilakukan menggunakan NetworkX, sebuah pustaka Python untuk pembuatan, manipulasi, dan studi mengenai struktur, dinamika, serta fungsi jaringan kompleks.
4. Visualisasi Data Twitter
Visualisasi data Twitter dapat membantu Anda memahaminya dengan lebih baik. Hal ini dapat dilakukan menggunakan Matplotlib, sebuah pustaka plot untuk Python:
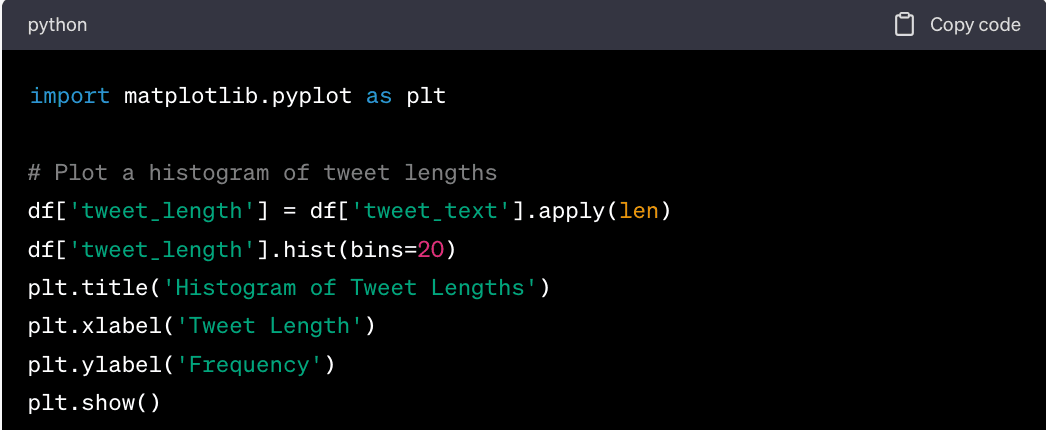
Dalam kode ini, pertama-tama kita menghitung panjang setiap tweet. Selanjutnya, kita membuat histogram panjang tweet, yang menunjukkan distribusi panjang tweet.
Ingatlah untuk mengganti 'tweets.csv' dengan jalur ke berkas CSV Anda, serta 'tweet_text', 'likes', dan 'retweets' dengan nama kolom yang sebenarnya di DataFrame Anda. Selain itu, gantilah 'user' dan 'mentions' dengan nama kolom yang sebenarnya untuk pengguna dan sebutan di DataFrame Anda.
Kesimpulan
Dalam panduan komprehensif ini, kita telah membahas pentingnya dan metode pengambilan data dari Twitter. Twitter, sebagai gudang data yang luas berisi opini publik, tren, dan tautan, menawarkan kekayaan data yang dapat dimanfaatkan untuk berbagai tujuan, mulai dari riset pasar dan analisis sentimen hingga peramalan tren dan banyak lagi.
Kita telah mendalami tiga metode utama untuk mengekstrak data ini:
-
API Twitter. Ini adalah cara resmi yang disediakan oleh Twitter untuk berinteraksi dengan datanya. Ini adalah alat yang ampuh, tetapi memiliki keterbatasan tersendiri, seperti batasan frekuensi dan kebutuhan akan persetujuan akun pengembang. Namun, ini merupakan cara yang andal dan mudah untuk mengakses data Twitter, terutama jika digunakan bersama pustaka seperti Tweepy.
-
Web Scraping dengan Python. Metode ini melibatkan penggunaan pustaka Python seperti BeautifulSoup dan requests untuk mengekstrak data langsung dari situs web Twitter. Meskipun metode ini dapat mengatasi beberapa batasan API Twitter, metode ini lebih rumit secara teknis dan bisa lebih rentan terhadap perubahan struktur situs web Twitter.
-
Scraper Pay-As-You-Go dari GeoNode. Ini adalah layanan pihak ketiga yang menyediakan cara yang lebih fleksibel dan kuat untuk mengekstrak data dari Twitter. Layanan ini menawarkan fitur-fitur canggih seperti rendering JavaScript dan penargetan geografis, tetapi memiliki biaya tersendiri dan perlu digunakan dengan hati-hati untuk menghindari tagihan yang tidak terduga.
Masing-masing metode ini memiliki kelebihan dan kekurangannya sendiri, dan metode mana yang terbaik untuk digunakan bergantung pada kebutuhan spesifik, kemampuan teknis, dan anggaran Anda.
Sebagai penutup, sangat penting untuk menekankan pentingnya pengambilan data yang etis dan bertanggung jawab.
Meskipun pengambilan data Twitter dapat memberikan wawasan yang berharga, sangatlah penting untuk menghormati ketentuan layanan Twitter, privasi pengguna Twitter, dan undang-undang yang berlaku. Selalu gunakan data yang Anda ambil secara bertanggung jawab, dan jika ragu, mintalah nasihat hukum.
Dengan memahami alat dan teknik pengumpulan data Twitter, Anda kini siap memanfaatkan kekuatan data Twitter untuk proyek Anda sendiri.

