Porquê extrair dados do Twitter?
Os dados do Twitter, dada a sua natureza em tempo real e a vasta quantidade de opinião pública que refletem, podem ser utilizados de inúmeras formas em vários domínios, tais como:
• Monitorização da marca. As empresas podem utilizar os dados do Twitter para monitorizar o que está a ser dito sobre a sua marca em tempo real. Isto pode ajudá-las a responder prontamente a reclamações ou questões dos clientes, a acompanhar a eficácia das campanhas de marketing e a compreender o sentimento do público em relação à sua marca. Por exemplo, um aumento repentino de sentimentos negativos sobre um produto pode indicar um problema que precisa de ser resolvido rapidamente.
• Análise de tendências. O Twitter é frequentemente o local onde as novas tendências surgem pela primeira vez, tornando-o um recurso valioso para a análise de tendências. Ao analisar o conteúdo dos tweets, as empresas podem identificar tendências emergentes no seu setor, acompanhar a popularidade de determinados tópicos ao longo do tempo e até prever tendências futuras. Isto pode orientar a estratégia empresarial, desde o desenvolvimento de produtos até ao marketing e às vendas.
• Investigação académica. Investigadores em áreas como a sociologia, a linguística e as ciências políticas podem utilizar os dados do Twitter para diversos fins. Por exemplo, podem analisar os tweets dos utilizadores para estudar o uso da linguagem, examinar a disseminação de informação ou desinformação, ou investigar a reação do público a determinados acontecimentos ou políticas.
• Jornalismo. Os jornalistas podem utilizar os dados do Twitter para descobrir notícias de última hora, acompanhar o desenrolar das notícias e avaliar a opinião pública sobre várias questões. Em alguns casos, os próprios tweets podem tornar-se notícias. Por exemplo, os tweets de figuras públicas podem ter um impacto significativo e são frequentemente noticiados nos meios de comunicação social.
Estes são apenas alguns exemplos de como os dados de milhares de milhões de tweets podem ser utilizados. As possibilidades são vastas e continuam a crescer à medida que cada vez mais pessoas migram de outras plataformas de redes sociais para o Twitter para partilharem os seus pensamentos e experiências.
Compreender os dados do Twitter
Antes de nos debruçarmos sobre os métodos de extração de dados do Twitter, é essencial compreender os quatro tipos de dados disponíveis no Twitter e as possíveis conclusões que podem ser tiradas a partir deles.
• Tweets. Um tweet é a unidade mais básica de informação no Twitter. Trata-se de uma mensagem publicada por um utilizador e pode conter até 280 caracteres. Cada tweet contém uma grande quantidade de dados, incluindo o conteúdo do tweet, a hora em que foi publicado, o número de «gostos» e retweets que recebeu e as hashtags utilizadas. A análise dos dados dos tweets pode fornecer informações sobre temas em destaque, a opinião em relação a um determinado assunto, o alcance de uma hashtag e muito mais.
• Utilizadores. Os dados dos utilizadores referem-se à informação relacionada com as contas do Twitter. Isto inclui o nome de utilizador, a descrição do perfil, a localização, o número de seguidores e de pessoas seguidas, o número de tweets e a data em que a conta foi criada. Ao analisar os dados dos utilizadores, é possível obter informações sobre os dados demográficos de uma base de utilizadores, identificar influenciadores num determinado campo ou acompanhar o crescimento de uma conta do Twitter ao longo do tempo.
• Entidades. As entidades nos dados do Twitter referem-se aos objetos associados a um tweet. Isto inclui hashtags, menções a utilizadores, URLs e conteúdos multimédia (fotografias e vídeos). As entidades permitem compreender o contexto de um tweet. Por exemplo, a análise das hashtags associadas a um tweet pode ajudar a identificar os tópicos em discussão, enquanto a análise das menções a utilizadores pode revelar a rede de interações.
• Locais. Estes dados referem-se à informação geográfica associada a um tweet ou a um utilizador. Pode tratar-se da localização a partir da qual um tweet foi publicado ou da localização especificada no perfil de um utilizador. A análise dos dados de locais pode fornecer informações sobre tendências geográficas, a disseminação de informação entre diferentes locais ou a popularidade de um tema em diferentes regiões.
Cada tipo de dados tem a sua própria importância e pode fornecer insights únicos. Por exemplo, os dados de tweets podem ajudar a identificar temas em destaque e a opinião pública, os dados de utilizadores podem revelar influenciadores e dados demográficos do público, as entidades podem fornecer contexto às discussões e os dados de locais podem revelar tendências geográficas.
Ao compreender e analisar estes tipos de dados, é possível obter uma grande variedade de insights a partir do Twitter. Seja para estudos de mercado, monitorização de marcas, investigação académica ou jornalismo, os dados do Twitter constituem um recurso rico e dinâmico para compreender a opinião pública, acompanhar tendências e ficar a par das conversas globais.
Como extrair dados do Twitter: três formas
1. API do Twitter
A API oficial do Twitter permite que os programadores interajam com a sua plataforma de forma programática. A API fornece acesso a vários tipos de dados, incluindo tweets, perfis do Twitter e muito mais.
Porquê utilizar a API do Twitter?
• Dados estruturados. Os dados devolvidos pela API são bem estruturados e consistentes, o que facilita o seu manuseamento e análise.
• Fiabilidade. Como a API é fornecida pelo próprio Twitter, garante fiabilidade e continuidade do serviço.
• Documentação abrangente. O Twitter disponibiliza documentação extensa sobre a sua API, facilitando aos programadores a compreensão e a utilização eficaz da mesma.
Limitações da API do Twitter
• Limites de frequência. Para evitar abusos, o Twitter impõe limites à sua API durante um determinado período de tempo. Por exemplo, só é possível efetuar 900 pedidos a cada 15 minutos para pedidos relativos à cronologia de um utilizador com uma aplicação autenticada pelo utilizador.
• Acesso aos dados. Nem todos os dados estão acessíveis através da API. Por exemplo, só é possível aceder aos 3200 tweets mais recentes da cronologia de um utilizador.
• Custos. Embora o Twitter ofereça um plano gratuito para a sua API, este apresenta limitações significativas. O acesso a mais dados e a limites de taxa mais elevados requer uma subscrição paga, que pode ser bastante dispendiosa.
Passos para utilizar a API do Twitter para extrair dados do Twitter:
A API do Twitter é uma ferramenta poderosa que permite aos programadores aceder a uma vasta gama de dados do Twitter de forma programática. Aqui está um guia passo a passo sobre como utilizá-la:
1. Criar uma conta de programador
• Aceda ao site de programadores do Twitter (https://developer.twitter.com/
).
• Clique no botão «Candidatar-se».
• Ser-lhe-á solicitado que inicie sessão na sua conta do Twitter. Se ainda não tiver uma, terá de criar uma.
• Depois de iniciar sessão, preencha o formulário de candidatura para solicitar uma conta de programador. O formulário pede detalhes sobre como tenciona utilizar a API. Seja o mais detalhado possível para aumentar as suas hipóteses de aprovação.
• Depois de enviar a sua candidatura, aguarde a aprovação do Twitter. Isto pode demorar alguns dias, por isso seja paciente.
2. Criar uma aplicação e obter chaves de API
• Inicie sessão na sua conta de programador do Twitter.
• Aceda ao «Painel de controlo» e clique em «Criar uma aplicação».
• Preencha o formulário com detalhes sobre a sua aplicação. Indique um nome, uma descrição, o URL do site e explique ao Twitter como pretende utilizar a aplicação.
• Anote as chaves de API que aparecem na página após a criação da sua aplicação. Existem dois conjuntos de chaves: a chave de API e o segredo, e o token de acesso e o segredo. Vais precisar destas chaves para autenticar a tua aplicação ao utilizar a API.
3. Utiliza o Tweepy para aceder à API do Twitter (Scraper API
)
Segue estes passos:
• Importa a biblioteca Tweepy.
• Autentica-te no Twitter utilizando as tuas chaves de API.
• Crie um objeto API que possa utilizar para interagir com a API do Twitter.
• Utilize o método user_timeline para obter os tweets mais recentes da linha do tempo de um utilizador (neste caso, «twitter») e imprima o texto de cada tweet.
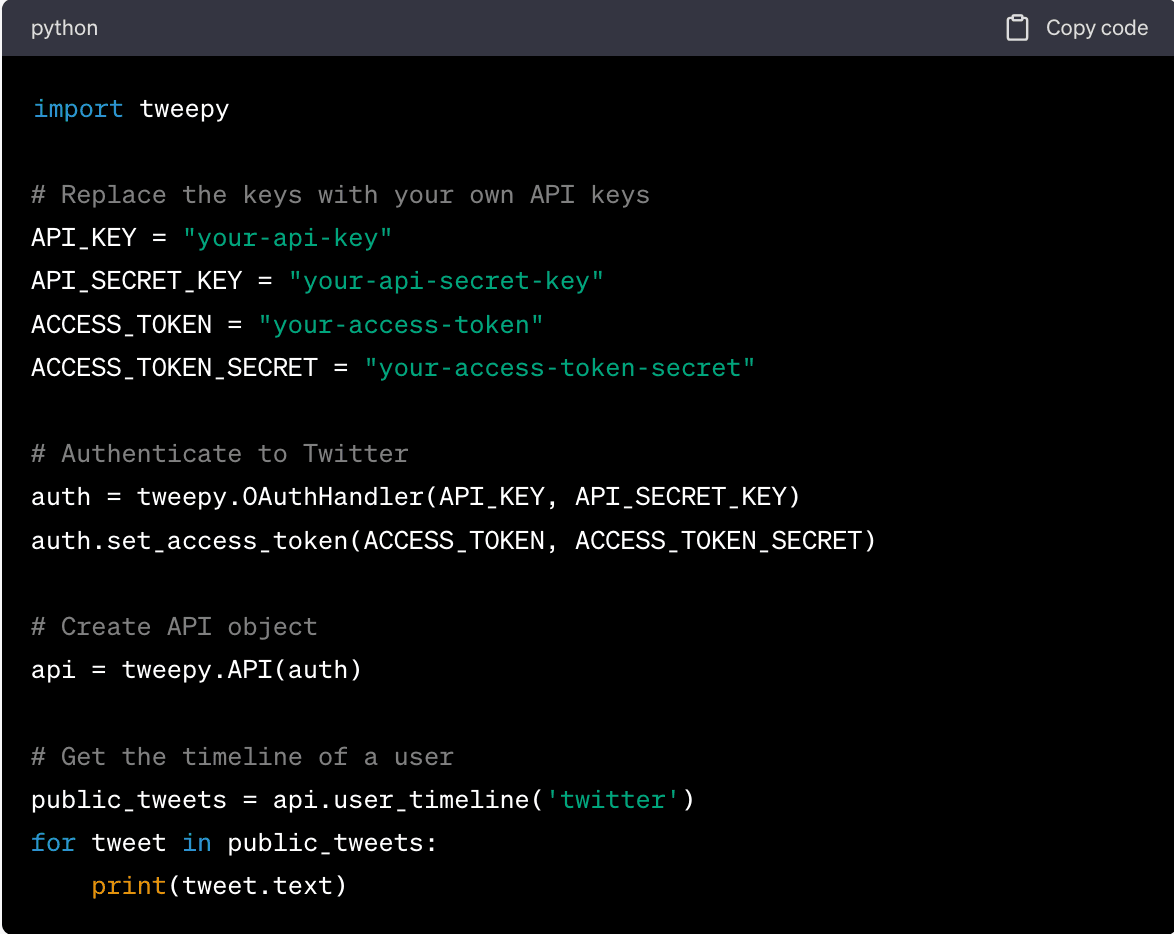
Lembre-se de substituir «your-api-key», «your-api-secret-key», «your-access-token» e «your-access-token-secret» pelas suas próprias chaves de API. Além disso, substitua «twitter» pelo nome de utilizador da conta do Twitter da qual pretende obter os tweets.
Este é um exemplo simples, mas o Tweepy disponibiliza muitos outros métodos para aceder a diferentes tipos de dados do Twitter. Consulte a documentação do Tweepy para obter mais informações.
Em resumo, embora a API do Twitter ofereça uma forma fiável e estruturada de aceder aos dados do Twitter, apresenta limitações em termos de limites de taxa, acesso aos dados e custos. Estas limitações podem constituir um obstáculo significativo para projetos de extração de dados em grande escala. Nesses casos, o web scraping pode ser uma alternativa mais flexível e económica, que iremos abordar na próxima secção.
2. Web scraping no Twitter com Python
O web scraping no Twitter com Python é o processo de extrair automaticamente dados do site do Twitter utilizando a linguagem de programação Python. Este processo é frequentemente utilizado para recolher grandes quantidades de dados do Twitter que seriam demasiado demoradas de recolher manualmente.
Porquê utilizar Python?
• Bibliotecas poderosas. O Python possui um ecossistema rico de bibliotecas que simplificam o web scraping. Bibliotecas como Tweepy, BeautifulSoup e Scrapy podem lidar com tudo, desde a realização de pedidos HTTP até à análise de HTML e à interação com APIs.
• Facilidade de utilização. A sintaxe do Python é clara e concisa, o que o torna uma boa linguagem para o web scraping. Mesmo tarefas complexas de scraping podem ser realizadas com relativamente poucas linhas de código.
• Ferramentas de análise de dados. O Python também é excelente para analisar dados. Bibliotecas como Pandas, Numpy e Matplotlib facilitam a limpeza, a análise e a visualização dos dados extraídos.
• Apoio da comunidade. O Python conta com uma comunidade vasta e ativa, o que torna muito fácil encontrar ajuda e recursos online. Se se deparar com um problema, é provável que alguém já o tenha resolvido.
Limitações do Python
• Conteúdo dinâmico. As ferramentas padrão de web scraping do Python têm dificuldade com conteúdo dinâmico carregado através de JavaScript. Existem formas de contornar isto, como utilizar uma biblioteca como o Selenium, mas fazê-lo acrescenta mais uma camada de complexidade ao projeto de web scraping do Twitter.
• Limitação de taxa. O Twitter impõe limites de taxa à API, o que pode tornar o seu projeto de web scraping mais lento. Embora existam formas de contornar esta situação, como utilizar várias contas ou endereços IP, estes métodos violam os termos de serviço do Twitter.
• Alterações na estrutura do site. Se o Twitter alterar a estrutura do seu site ou da sua API, o seu código de scraping poderá deixar de funcionar. Terá de atualizar o seu código para refletir essas alterações, o que pode ser demorado.
Passos para utilizar Python no scraping do Twitter:
1. Configurar o ambiente. Instale o Python e as bibliotecas necessárias, caso ainda não as tenha. Para efeitos deste exemplo, utilizaremos o BeautifulSoup e o Requests.
2. Envie um pedido HTTP para a página do Twitter que pretende extrair.
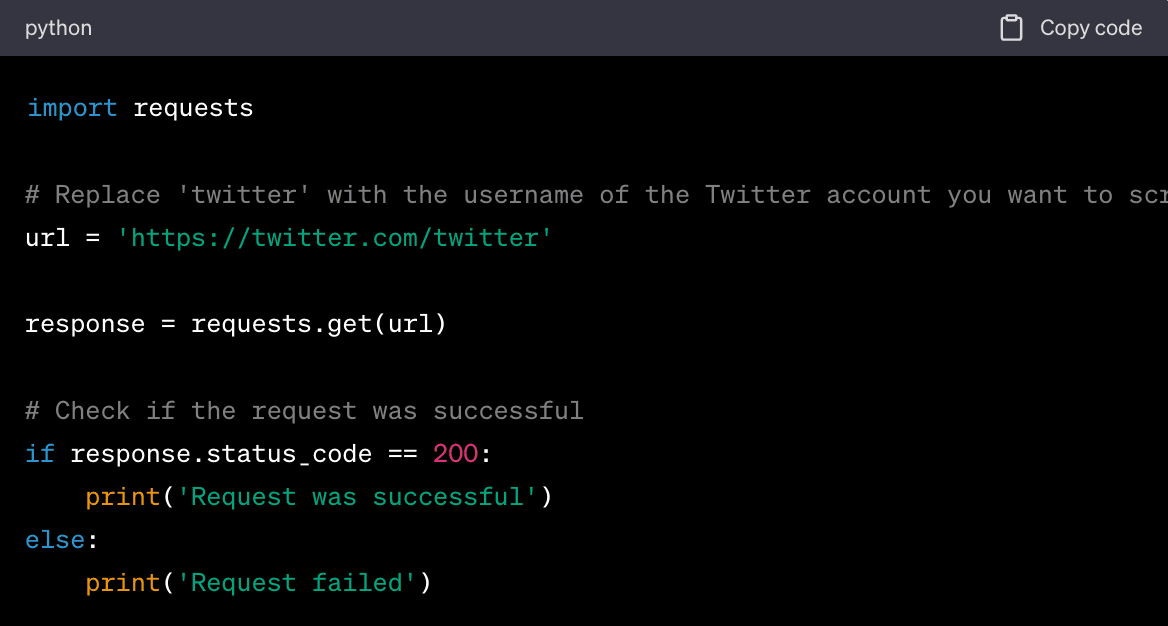
O servidor responde à solicitação, devolvendo o conteúdo HTML da página web.
3. Analise os dados. Uma vez que os dados estão no formato HTML, vai precisar de um analisador capaz de analisar e extrair os dados de interesse.
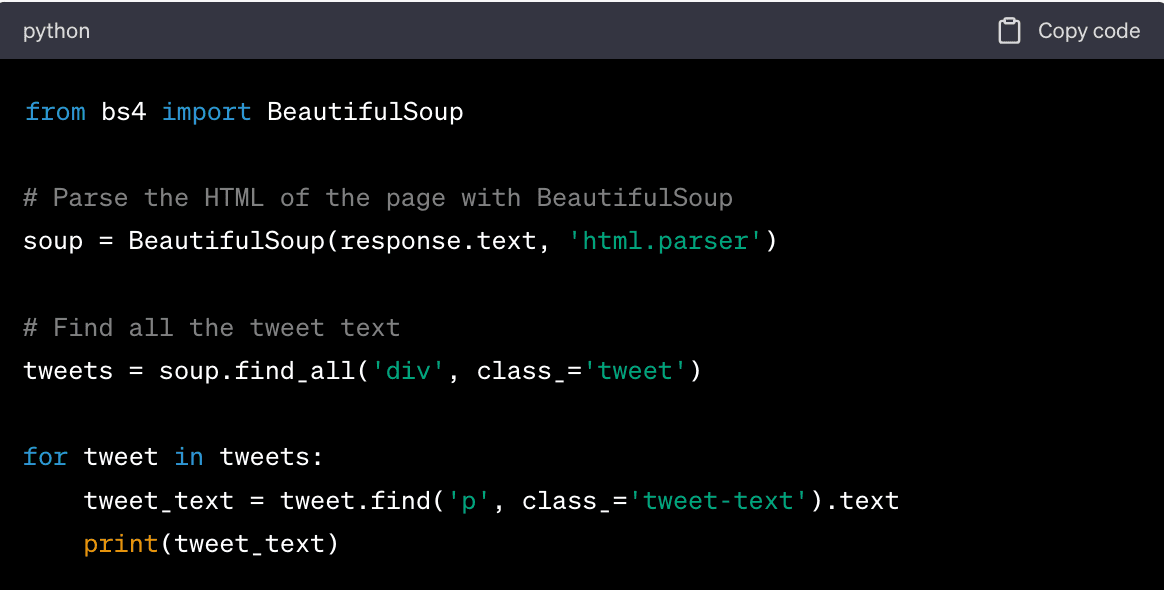
Neste código, começamos por criar um objeto BeautifulSoup e analisar o HTML da página. Em seguida, localizamos todos os elementos div com a classe «tweet», que contêm os tweets. Para cada tweet, localizamos o elemento p com a classe «tweet-text», que contém o texto do tweet, e exibimo-lo.
4. Utilize métodos de consulta para localizar elementos de dados específicos. Com o BeautifulSoup, por exemplo, pode utilizar métodos como o find_all() para localizar tags de cabeçalho, parágrafos ou outros elementos.
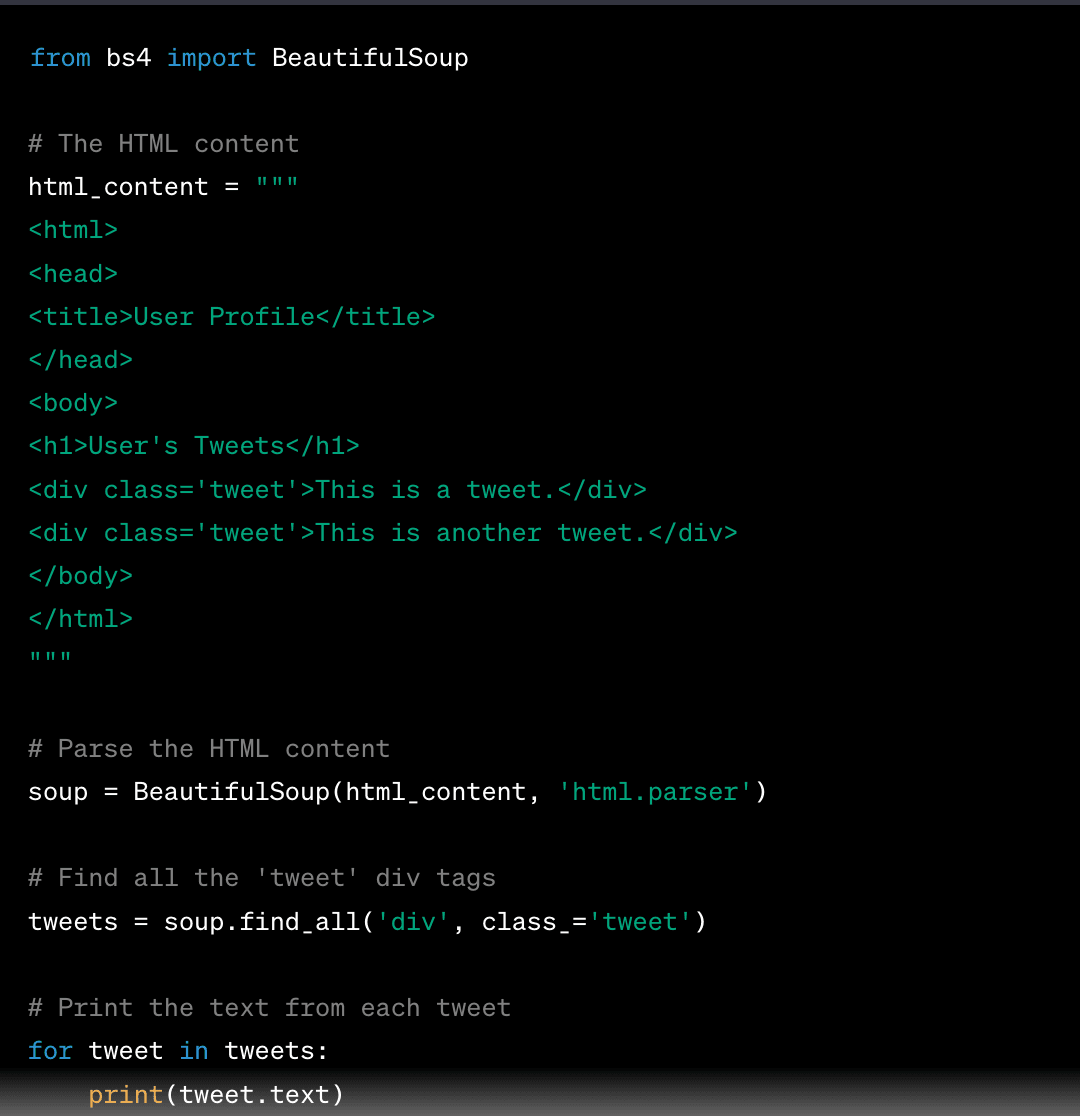
5. Guarde os dados no formato que preferir, como CSV, JSON ou numa base de dados. Veja aqui como guardá-los num ficheiro CSV utilizando a biblioteca Pandas:
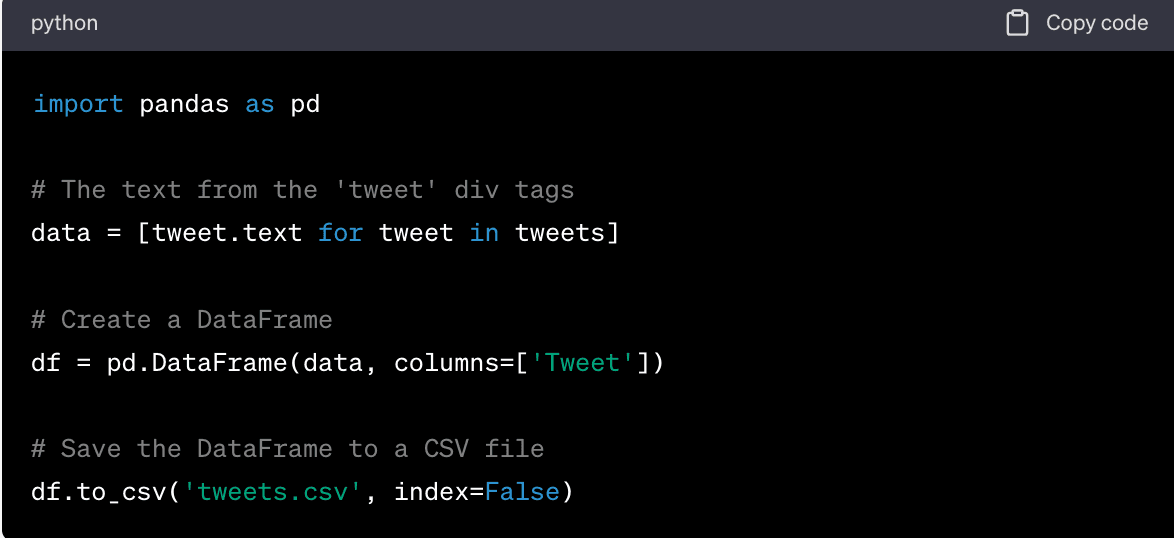
Isto irá criar um ficheiro CSV denominado «tweets.csv» com uma única coluna «Tweet» que contém o texto das tags div «tweet». Eis um exemplo simples de como pode extrair o texto de um tweet utilizando Python e BeautifulSoup:
3. Geonode
O Scraper API
da
Geonode
é uma ferramenta poderosa que permite extrair dados de sites como o Twitter. Oferece diferentes modos de extração para um desempenho e eficiência ótimos.
Porquê utilizar o scraper Pay-As-You-Go
de Geonode
?
• Preços flexíveis. O modelo «pay-as-you-go
» permite-lhe pagar apenas pelo que utiliza. Isto pode ser mais económico do que um modelo de subscrição, especialmente para uma utilização irregular ou de baixo volume.
• Escalabilidade. Este Scraper API
foi concebido para lidar com tarefas de scraping tanto em pequena como em grande escala. Isto significa que pode ampliar as suas tarefas de scraping conforme necessário, sem se preocupar em atingir limites de utilização.
• Facilidade de utilização. O Scraper API
da Geonode
é fácil de utilizar, mesmo para quem não tem conhecimentos de programação. Oferece uma forma simples de extrair dados do Twitter.
• Funcionalidades avançadas. O Scraper API
da Geonode
oferece uma variedade de funcionalidades avançadas, tais como renderização em JavaScript, execução de trechos de código JS personalizados, proxies rotativos, segmentação geográfica e muito mais. Estas funcionalidades podem ser muito úteis para tarefas complexas de scraping.
• Modos em tempo real e de callback. A API disponibiliza dois modos de scraping: o Modo em Tempo Real e o Modo de Callback. Isto proporciona-lhe flexibilidade na forma como recebe os resultados do scraping.
Limitações do Scraper Pay-As-You-Go
da GeoNode
• Os custos podem acumular-se: Embora o modelo «pay-as-you-go
» possa ser económico para uma utilização de baixo volume, os custos podem acumular-se rapidamente em tarefas de scraping em grande escala. É importante monitorizar a sua utilização para evitar cobranças inesperadas.
• Curva de aprendizagem: Embora o Scraper API
dGeoNode
tenha sido concebido para ser fácil de utilizar, pode ainda assim existir uma curva de aprendizagem, especialmente para quem é novo no scraping da Web ou em APIs em geral.
• **Dependência do serviço dGeoNode
**: Tal como acontece com qualquer serviço de terceiros, fica dependente do serviço dGeoNode
para as suas tarefas de scraping. Se houver algum problema com o serviço deles, isso poderá afetar as suas tarefas de scraping.
• Considerações legais e éticas: O web scraping pode constituir uma zona cinzenta do ponto de vista legal. Embora o Scraper API
da GeoNode
facilite a recolha de dados, é importante garantir que as suas atividades de recolha cumprem os termos de serviço do site que está a rastrear e quaisquer leis de privacidade relevantes.
Passos para utilizar o Geonode Scraper API para extrair dados do Twitter
1. Configure o seu pedido. Para utilizar o GeoNode Scraper API, é necessário configurar um pedido. Este pedido deve incluir o URL da página que pretende extrair (neste caso, uma página do Twitter) e um conjunto de configurações que controlam o comportamento do extrator. Eis um exemplo de como estruturar a sua solicitação:
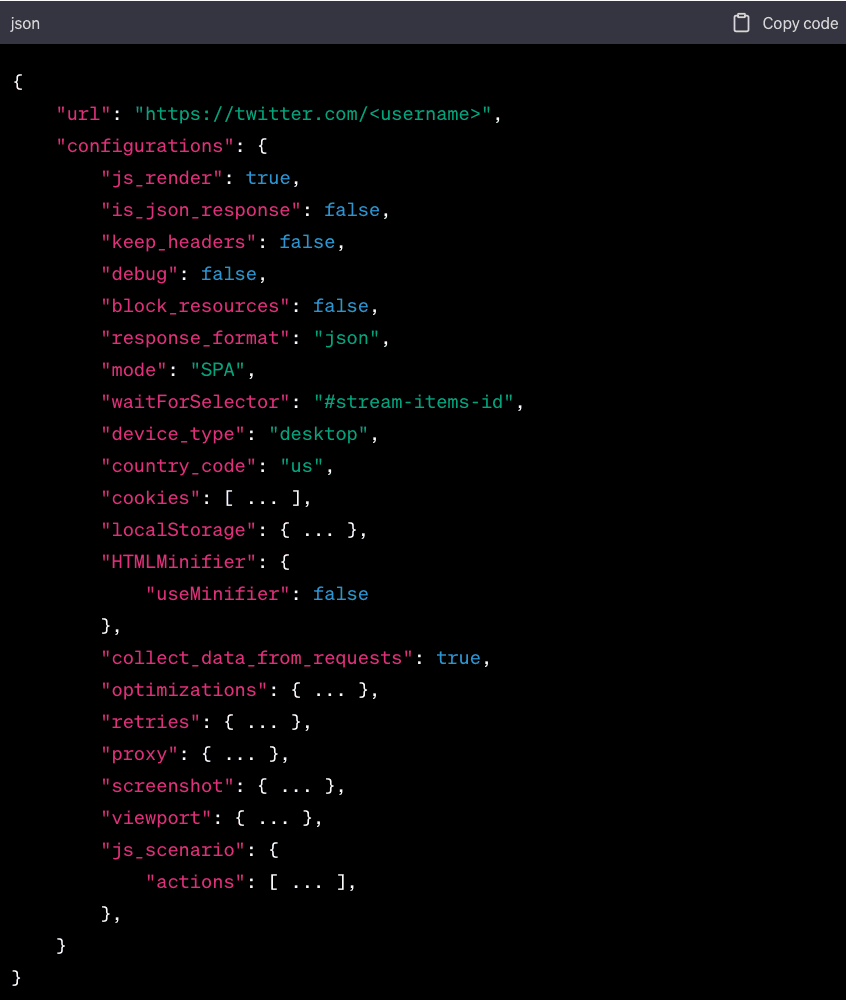
Neste exemplo, a URL é a página do Twitter que pretende extrair. O parâmetro waitForSelector está definido como #stream-items-id, que é o ID da div que contém os tweets numa página do Twitter. Isto indica ao scraper para aguardar até que este elemento seja carregado antes de extrair a página.
2. Modo em tempo real e modo de callback. GeoNode Scraper API disponibiliza dois modos de extração: o modo em tempo real e o modo de callback. No modo em tempo real, a API devolve o resultado imediatamente após a conclusão da extração. No Modo de Callback, a API envia o resultado para um URL de callback especificado assim que a extração estiver concluída. Pode escolher o modo que melhor se adequa às suas necessidades.
3. Verifique o estado da sua tarefa. Pode verificar o estado da sua tarefa de extração utilizando o ID do pedido que recebeu na resposta inicial. Isto permite-lhe acompanhar o progresso da sua tarefa e determinar o seu estado de conclusão.
4. Ações. A API de extração de dados (Geonode) Scraper API permite-lhe interagir com o documento de destino através de uma lista de ações suportadas. Por exemplo, pode utilizar ações para clicar num botão ou preencher um formulário na página antes da extração.
Análise de dados do Twitter
Depois de extrair e armazenar os dados do Twitter, o próximo passo é analisá-los. Aqui está um guia passo a passo:
**1. Análise básica. **
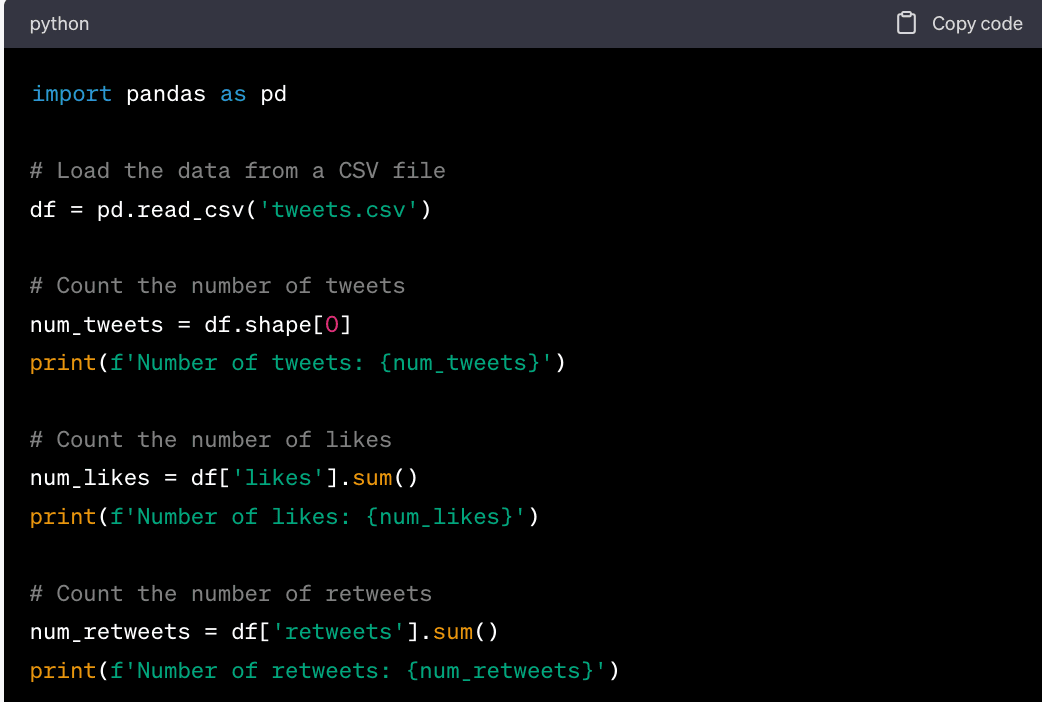
A análise básica envolve a contagem de tweets, «gostos», retweets e outras métricas simples. Aqui está um exemplo de como fazê-lo utilizando o pandas, uma poderosa biblioteca de análise de dados para Python:
2. Análise de sentimento
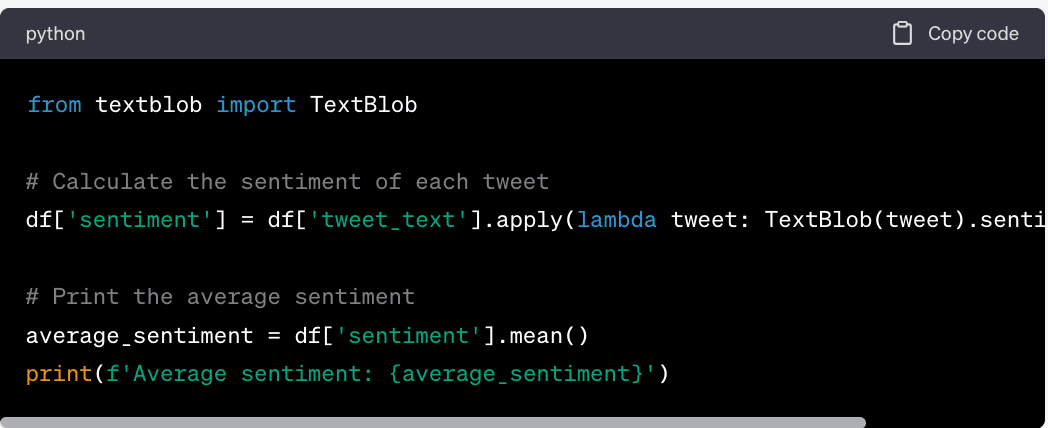
A análise de sentimento consiste em determinar o sentimento de um texto, como um tweet. Aqui está um exemplo de como fazê-lo utilizando o TextBlob, uma biblioteca para o processamento de dados textuais:
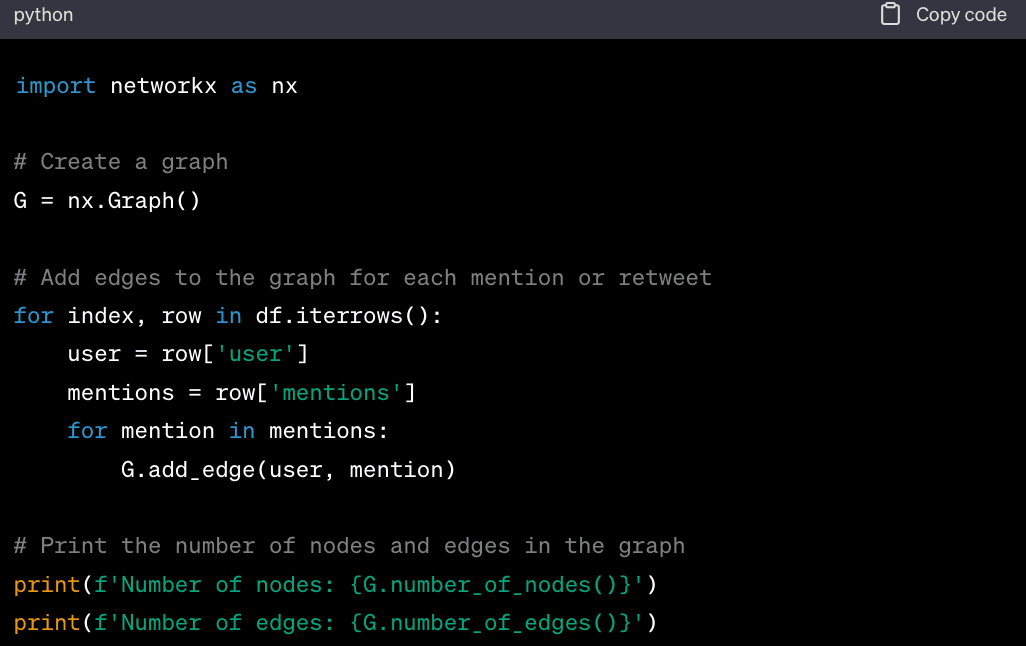
3. Análise de redes
A análise de redes consiste em analisar as ligações entre utilizadores do Twitter. Isto pode ser feito utilizando o NetworkX, uma biblioteca Python para a criação, manipulação e estudo da estrutura, dinâmica e funções de redes complexas.
4. Visualização de Dados do Twitter
A visualização dos dados do Twitter pode ajudar-te a compreendê-los melhor. Isto pode ser feito utilizando o Matplotlib, uma biblioteca de gráficos para Python:
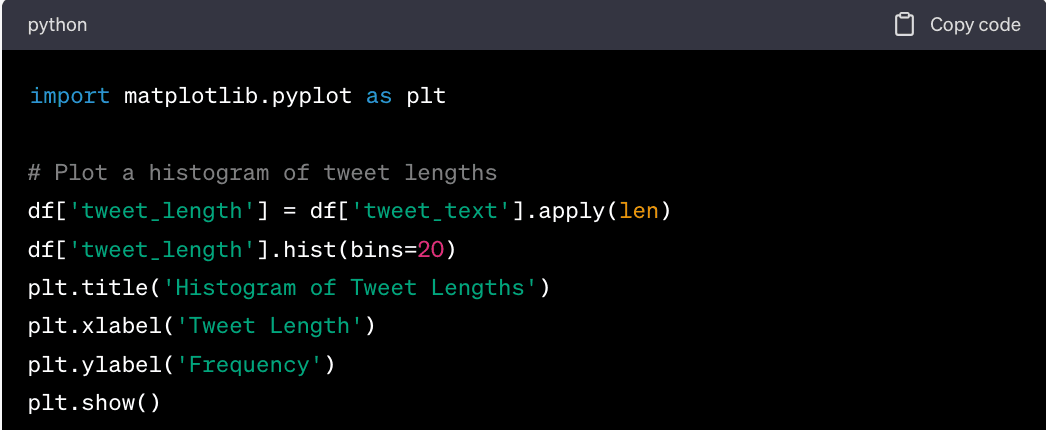
Neste código, calculamos primeiro o comprimento de cada tweet. Em seguida, traçamos um histograma dos comprimentos dos tweets, que mostra a distribuição dos comprimentos dos tweets.
Lembre-se de substituir «tweets.csv» pelo caminho para o seu ficheiro CSV e «tweet_text», «likes» e «retweets» pelos nomes reais das colunas no seu DataFrame. Além disso, substitua «user» e «mentions» pelos nomes reais das colunas correspondentes ao utilizador e às menções no seu DataFrame.
Conclusão
Neste guia abrangente, explorámos a importância e os métodos de extração de dados do Twitter. O Twitter, sendo um vasto repositório de opinião pública, tendências e links, oferece uma grande quantidade de dados que podem ser aproveitados para diversos fins, desde estudos de mercado e análise de sentimentos até à previsão de tendências e muito mais.
Aprofundámos três métodos principais de extração destes dados:
-
API do Twitter. Esta é a forma oficial disponibilizada pelo Twitter para interagir com os seus dados. É uma ferramenta poderosa, mas apresenta as suas próprias limitações, tais como limites de frequência e a necessidade de aprovação de uma conta de programador. No entanto, é uma forma fiável e simples de aceder aos dados do Twitter, especialmente quando utilizada com bibliotecas como a Tweepy.
-
Web scraping com Python. Este método envolve a utilização de bibliotecas Python, como a BeautifulSoup e a requests, para extrair dados diretamente do site do Twitter. Embora este método possa contornar algumas das limitações da API do Twitter, é tecnicamente mais complexo e pode ser mais frágil devido a potenciais alterações na estrutura do site do Twitter.
-
Scraper «Pay-As-You-Go» de GeoNode. Trata-se de um serviço de terceiros que oferece uma forma mais flexível e poderosa de extrair dados do Twitter. Oferece funcionalidades avançadas, como renderização em JavaScript e segmentação geográfica, mas tem os seus próprios custos e requer uma utilização cuidadosa para evitar cobranças inesperadas.
Cada um destes métodos tem as suas vantagens e desvantagens, e o melhor a utilizar depende das suas necessidades específicas, capacidade técnica e orçamento.
Para concluir, é fundamental salientar a importância de uma extração de dados ética e responsável.
Embora a extração de dados do Twitter possa proporcionar informações valiosas, é essencial respeitar os termos de serviço do Twitter, a privacidade dos utilizadores do Twitter e todas as leis aplicáveis. Utilize sempre os dados extraídos de forma responsável e, em caso de dúvida, procure aconselhamento jurídico.
Ao compreender as ferramentas e técnicas para a extração de dados do Twitter, está agora preparado para tirar partido do potencial dos dados do Twitter nos seus próprios projetos.

