O que é a extração de dados?
A extração de dados consiste na obtenção de informações a partir de sítios Web, bases de dados e documentos. De acordo com a IDC, o volume crescente de dados, que deverá atingir 175 zettabytes até 2025, torna a extração de dados crucial. É por isso que muitas empresas automatizam o seu fluxo de trabalho de extração de dados utilizando APIs de web scraping, uma vez que isso lhes permite recolher, processar e analisar grandes quantidades de dados de forma eficiente. Através do web scraping, as empresas podem aceder e analisar facilmente os dados de que necessitam para tomar decisões mais informadas, promover o crescimento e alcançar o sucesso no mundo atual, orientado pelos dados.
Extração de dados através do ETL
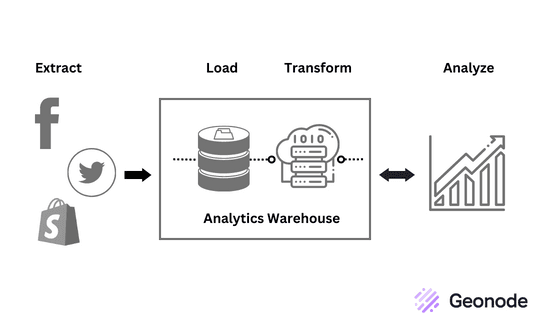
Extração, Transformação e Carregamento (ETL) é um processo utilizado para integrar e gerir grandes quantidades de dados provenientes de várias fontes. Trata-se de um processo frequentemente utilizado na extração de dados e no web scraping para recolher, limpar e organizar dados para análise.
O processo ETL envolve três etapas principais:
-
Extração: A primeira etapa consiste em extrair ou recolher dados de várias fontes, tais como bases de dados, ficheiros ou APIs. Os dados extraídos podem ser estruturados, semiestruturados ou não estruturados.
-
Transformação: A segunda fase consiste em transformar os dados extraídos num formato adequado para o sistema de destino, como um armazém de dados ou uma ferramenta de relatórios. Esta fase envolve a limpeza, filtragem, agregação e enriquecimento dos dados para garantir consistência e precisão. Implica também a conversão dos dados para um formato padrão de fácil compreensão.
-
Carregamento: A etapa final consiste em carregar os dados transformados no sistema de destino para posterior análise e processamento. Os dados são carregados numa base de dados ou num armazém de dados, onde outras aplicações podem facilmente consultá-los e analisá-los.
Extração de dados sem ETL
Embora a extração de dados possa ser realizada fora do ETL, esta apresenta limitações e deve ser utilizada de forma adequada. Por exemplo, se os dados brutos forem extraídos sem uma transformação e um carregamento adequados, poderá ser difícil organizá-los e analisá-los, podendo ainda ser incompatíveis com programas e aplicações mais recentes. Consequentemente, estes dados podem ter um valor limitado, exceto para fins de arquivo.
No entanto, a extração de dados sem ETL continua a ser uma excelente opção para empresas que precisam de aceder rapidamente a dados de várias fontes. É também uma solução económica, eliminando a necessidade de software e hardware ETL dispendiosos.
Além disso, pode ser utilizada para transferir dados de um sistema para outro de forma rápida e fácil, sem a necessidade de transformações complexas.
Dependendo das suas necessidades e dos recursos disponíveis, poderá encontrar várias técnicas alternativas de extração de dados que não dependem do ETL tradicional.
Captura de Alterações de Dados (CDC)
A Captura de Alterações nos Dados (CDC) é um método de ETL que captura e armazena as alterações feitas nos dados de um sistema de origem para análise. Ao contrário do ETL tradicional, que extrai conjuntos de dados na íntegra, o CDC captura apenas as alterações feitas nos dados desde a última extração. Isto torna-o um método mais eficiente para a extração de dados.
Interface de Programação de Aplicações (API)
Outro método de extração de dados sem ETL é a API (Interface de Programação de Aplicações). As APIs são um conjunto de protocolos e ferramentas para a criação de aplicações de software. Com as APIs, os programadores podem extrair dados de um sistema de origem de forma programática e disponibilizá-los nas suas aplicações.
Muitas aplicações populares, como o Google Maps e o Twitter, disponibilizam APIs que podem ser utilizadas para a extração de dados.
Web Scraping
O web scraping é outro método para extrair dados sem ETL. Envolve a utilização de scripts automatizados para extrair dados de páginas web. Embora o web scraping tenha algumas limitações, como a vulnerabilidade a alterações na estrutura da página web, pode ser uma ferramenta poderosa para extrair dados de sites.
Embora o ETL seja o método mais utilizado para a extração de dados, os métodos alternativos podem ser igualmente eficazes. A Captura de Alterações de Dados (Change Data Capture), as APIs e o web scraping são, todos, opções viáveis para extrair informações de várias fontes. É essencial avaliar qual o método mais adequado para um caso de utilização específico e manter-se a par das técnicas e tecnologias mais recentes para descobrir qual delas melhor se adapta às suas necessidades.
Leia também: Conheça a diferença entre um web scraper e um web crawler
Benefícios da extração de dados
Reduz o erro humano
A extração de dados automatiza o processo de recolha de dados, minimizando as possibilidades de erros que podem ocorrer durante a introdução manual de dados. Consequentemente, melhora a precisão e a consistência dos dados.
Aumenta a produtividade
A extração de dados liberta tempo para que os colaboradores se concentrem noutras tarefas, aumentando a sua produtividade. O processo é também mais rápido do que a introdução manual de dados, permitindo às empresas processar mais dados em menos tempo.
Permite melhores decisões empresariais
A extração de dados dá às empresas acesso a uma grande quantidade de informação, permitindo-lhes tomar decisões baseadas em dados. Isto conduz a um melhor serviço ao cliente, a produtos e serviços melhorados e a um aumento das receitas.
Proporciona visibilidade
A extração de dados proporciona visibilidade sobre as operações empresariais, permitindo às empresas identificar ineficiências, oportunidades de crescimento e áreas de melhoria.
Simplifica a partilha
A extração de dados permite às empresas partilhar facilmente dados entre departamentos e partes interessadas externas, melhorando a colaboração e a comunicação.
Relação custo-benefício
A extração de dados é uma solução económica para as empresas, uma vez que elimina a necessidade de introdução manual de dados e reduz a probabilidade de erros, que podem sair caros.
Poupança de tempo
A extração de dados automatiza a recolha e o processamento de dados, poupando às empresas tempo valioso para que se possam concentrar noutras tarefas importantes.
Extração de dados: casos de utilização no mundo real
A extração de dados tem vários casos de utilização no mundo real em diferentes setores. Aqui estão alguns dos casos de utilização mais comuns da extração de dados:
Monitorização da reputação
As empresas precisam de monitorizar a sua reputação online para proteger a sua marca. A extração de dados ajuda a rastrear menções à marca, identificar críticas negativas e recolher feedback dos clientes para melhorar a imagem da marca.
Estudo de mercado
A extração de dados ajuda as empresas a recolher dados sobre tendências de mercado, comportamento do consumidor e informações sobre o setor. Isto é utilizado para tomar decisões informadas sobre o desenvolvimento de produtos, estratégias de marketing e expansão dos negócios.
Dados financeiros
As instituições financeiras utilizam a extração de dados para recolher e analisar dados de várias fontes, incluindo demonstrações financeiras, artigos noticiosos e relatórios de mercado, com o objetivo de tomar decisões de investimento informadas e identificar tendências de mercado.
Geração de leads
A extração de dados ajuda a gerar leads através da recolha de informações de contacto e outros dados relevantes a partir de perfis nas redes sociais, sites de empresas e outras fontes online.
Agregação de Conteúdo
Para criar notícias abrangentes e atualizadas, as empresas de notícias e meios de comunicação utilizam a extração de dados para reunir informações de várias fontes, tais como artigos de notícias, publicações em blogs e redes sociais.
Análise de Sentimento
As empresas utilizam a extração de dados para monitorizar o sentimento dos clientes, recolhendo e analisando comentários, avaliações e feedback. Isto ajuda as empresas a melhorar os seus produtos e serviços e a construir melhores relações com os clientes.
Inteligência de Preços
Os retalhistas utilizam a extração de dados para recolher informações sobre os preços, promoções e descontos da concorrência, de forma a ajustar as suas próprias estratégias de preços e a obter uma vantagem competitiva.
Análise do mercado de trabalho
As agências de recrutamento e os portais de emprego utilizam a extração de dados para recolher informações sobre ofertas de emprego, descrições de funções e competências exigidas, ajudando os candidatos a encontrar vagas relevantes e os empregadores a identificar potenciais candidatos.
Análise das redes sociais
As plataformas de redes sociais utilizam a extração de dados para analisar o comportamento e as preferências dos utilizadores, identificar influenciadores e fornecer recomendações personalizadas aos utilizadores.
Setor das viagens
As agências de viagens e as plataformas de reservas utilizam a extração de dados para recolher informações sobre voos, hotéis e destinos de viagem, permitindo-lhes oferecer pacotes de viagem mais personalizados aos seus clientes.
Explorar diferentes tipos de dados extraídos
Durante a extração de dados, podem ser extraídos diferentes tipos de dados, dependendo da natureza dos mesmos e do objetivo da extração. Vamos explorar alguns dos tipos de dados extraídos durante o processo de extração de dados.
Dados não estruturados
Os dados não estruturados referem-se a dados que não estão organizados de forma predefinida, tais como e-mails, publicações nas redes sociais ou documentos de texto. A análise de dados não estruturados pode ser um desafio, uma vez que não possuem uma estrutura consistente.
No entanto, com a ajuda de técnicas de processamento de linguagem natural, os dados não estruturados podem ser transformados num formato estruturado, para uma análise e tomada de decisões mais simples.
Dados estruturados
Os dados estruturados, por outro lado, estão organizados de forma predefinida, como numa folha de cálculo ou numa base de dados. Os dados estruturados são mais fáceis de analisar porque possuem uma estrutura consistente, o que facilita a pesquisa, a filtragem e a agregação.
Os dados estruturados podem ser ainda categorizados em diferentes tipos de dados, tais como dados de clientes, financeiros e operacionais.
Dados de Clientes
Os dados de clientes incluem informações sobre os clientes, tais como os seus dados demográficos, histórico de compras e preferências. Os dados de clientes são utilizados para melhorar o envolvimento dos clientes, desenvolver campanhas de marketing direcionadas e otimizar a experiência do cliente.
Exemplos de fontes de dados de clientes incluem inquéritos aos clientes, atividade nas redes sociais e análises de websites.
Dados financeiros
Os dados financeiros referem-se a informações relacionadas com as finanças de uma empresa, tais como receitas, despesas e margens de lucro. Os dados financeiros são utilizados para acompanhar o desempenho financeiro, identificar áreas de redução de custos e tomar decisões financeiras informadas.
Exemplos de fontes de dados financeiros incluem software de contabilidade, demonstrações financeiras e dados transacionais.
Dados operacionais
Os dados operacionais referem-se a informações relacionadas com as operações quotidianas de uma empresa, tais como níveis de inventário, produção e métricas de atendimento ao cliente. Os dados operacionais são utilizados para identificar áreas de melhoria de processos, otimizar a alocação de recursos e aumentar a eficiência geral.
As fontes de dados operacionais incluem sensores de equipamentos de fabrico, sistemas de ponto de venda e software de assistência técnica.
A extração de dados pode produzir diferentes tipos de dados, incluindo dados não estruturados e estruturados. A extração e análise destes tipos de dados podem fornecer informações valiosas para que as organizações tomem decisões informadas e impulsionem o sucesso empresarial.
Técnicas de extração de dados
Existem dois tipos principais de métodos de extração no armazenamento de dados: a extração lógica e a extração física.
Extração lógica
A extração lógica é um método de extração de dados que envolve a utilização de regras lógicas e transformações para extrair dados de várias fontes e integrá-los num formato comum num armazém de dados. Existem três métodos principais na extração lógica: notificação de atualização, extração incremental e extração completa.
Notificação de atualização
Este método envolve a extração apenas dos dados que foram atualizados no sistema de origem desde a última extração. O sistema de origem notifica o armazém de dados das alterações, e apenas os dados atualizados são extraídos. Isto é vantajoso quando é necessária a integração de dados em tempo real e apenas os dados mais recentes são necessários para análise.
Extração incremental
Isto envolve a extração apenas dos dados que foram adicionados, atualizados ou eliminados no sistema de origem desde a última extração. A extração baseia-se num carimbo temporal ou num indicador que assinala quando os dados foram modificados pela última vez. Este método é frequentemente utilizado quando está envolvido um volume significativo de dados e não é prático extrair todos os dados de cada vez.
Extração completa
A extração completa envolve a extração de todos os dados do sistema de origem, independentemente de terem ou não sofrido alterações desde a última extração. Quando o volume de dados é pequeno ou o sistema de origem é relativamente estável, e o armazém de dados necessita de uma cópia completa dos dados de origem, o método de extração completa é a escolha ideal.
Extração física
Por outro lado, a extração física é outro método de extração de dados no armazenamento de dados que envolve a cópia ou a transferência física de dados do sistema de origem para o armazém de dados. A extração física tem dois métodos principais: a extração online e a extração offline.
Extração online
A extração em linha envolve a extração de dados do sistema de origem enquanto este ainda está em funcionamento. Isto é útil quando os dados são necessários em tempo real e o sistema de origem não pode ser colocado fora de linha. No entanto, o processo de extração pode afetar o desempenho do sistema de origem, o que constitui uma consideração importante na escolha deste método.
Extração fora de linha
Isto envolve a extração de dados do sistema de origem quando este não está em funcionamento. É frequentemente utilizada quando os dados podem ser extraídos durante períodos de baixa atividade ou quando não é necessário extraí-los em tempo real. O processo de extração não afeta o desempenho do sistema de origem, o que constitui uma grande vantagem quando comparado com a extração online.
Em geral, estes métodos têm as suas vantagens e desvantagens. A escolha de um método depende das necessidades específicas da sua empresa e da natureza dos dados a extrair. A seleção cuidadosa do método adequado garante que os dados no seu armazém de dados sejam precisos, atualizados e estejam disponíveis para análise.
Extração de dados vs. mineração de dados
Tal como a extração de dados, a mineração de dados é mais um passo crucial na análise e utilização de grandes quantidades de dados. No entanto, embora ambas sejam utilizadas para extrair informações e conhecimentos valiosos a partir dos dados, existem diferenças significativas entre as duas.
Extração de dados
A extração de dados é o processo de extrair dados de várias fontes e consolidá-los num local central, como um armazém de dados.
Isto envolve identificar as fontes de dados relevantes, aplicar técnicas de limpeza e transformação de dados e carregar os dados numa base de dados centralizada. O objetivo da extração de dados é criar uma cópia completa e precisa dos dados que possa ser facilmente acedida e analisada.
Mineração de dados
Por outro lado, a mineração de dados é o processo de descobrir padrões, tendências e insights nos dados que foram extraídos.
Este processo envolve a utilização de análises estatísticas e técnicas de aprendizagem automática para identificar correlações, classificações e outras informações, com vista a tomar decisões empresariais informadas.
A mineração de dados visa transformar dados brutos em conhecimento aplicável e utilizá-lo para melhorar o desempenho empresarial e obter uma vantagem competitiva.
Em termos simples, a extração de dados é o processo de recolher dados de várias fontes e reuni-los num único local. Em contrapartida, a mineração de dados analisa esses dados para encontrar padrões e insights significativos.
Ambas são etapas essenciais na análise de dados e são frequentemente utilizadas em conjunto para proporcionar uma visão abrangente dos dados de uma empresa.
Ao utilizar estas técnicas, as empresas podem obter informações valiosas sobre os seus clientes, operações e tendências de mercado, o que as pode ajudar a tomar melhores decisões e a manter-se à frente da concorrência.
Diferentes tipos de ferramentas de extração de dados
As ferramentas de extração de dados são aplicações de software que facilitam a extração de dados de várias fontes e a sua consolidação num local central, como um armazém de dados. Estas ferramentas foram concebidas para automatizar o processo de extração de dados e torná-lo mais eficiente e preciso.
Existem diferentes tipos de ferramentas de extração de dados disponíveis no mercado, cada uma com as suas próprias funcionalidades e vantagens. Seguem-se três tipos comuns:
Ferramentas de processamento em lote
Estas ferramentas foram concebidas para extrair dados de grandes volumes de ficheiros ou documentos em modo de lote. As ferramentas de processamento em lote são úteis quando é necessário extrair dados de vários ficheiros ou de documentos com estruturas semelhantes.
Entre os exemplos de ferramentas de processamento em lote contam-se o Talend Open Studio, o Apache Nifi e o Alteryx.
Ferramentas de código aberto
Estas aplicações de software estão disponíveis gratuitamente e podem ser modificadas e personalizadas pelos utilizadores. As ferramentas de extração de dados de código aberto são populares entre as pequenas e médias empresas com orçamentos limitados e para quem não pode adquirir software comercial dispendioso.
Exemplos de ferramentas de extração de dados de código aberto incluem o Apache Kafka, o Apache Flume e o Pentaho Data Integration.
Ferramentas baseadas na nuvem
As ferramentas baseadas na nuvem estão alojadas na nuvem e podem ser acedidas através de um navegador da Web. Pode utilizar ferramentas de extração de dados baseadas na nuvem quando precisar de extrair dados de fontes remotas ou quando pretender colaborar com outros membros da equipa em diferentes localizações geográficas.
Entre os exemplos de ferramentas de extração de dados baseadas na nuvem contam-se o AWS Glue, o Azure Data Factory e o Google Cloud Dataflow.
As ferramentas de extração de dados são parte integrante do processo de análise de dados, uma vez que ajudam as empresas a consolidar e analisar dados provenientes de várias fontes. Lembre-se de que a escolha da ferramenta de extração de dados adequada pode fazer uma grande diferença na eficiência e na precisão dos seus esforços de análise de dados.
As melhores ferramentas de extração de dados
As ferramentas de extração de dados apresentam-se em diversos formatos e tamanhos. Quer precise de extrair dados de sites, documentos ou plataformas de redes sociais, existe uma ferramenta que o ajudará a automatizar o processo e a obter informações valiosas a partir dos seus dados.
Scrapestorm
Scrapestorm é uma ferramenta de web scraping que ajuda os utilizadores a extrair dados de vários sites. Foi concebida para automatizar o processo de web scraping e facilita a recuperação de dados para utilizadores sem qualquer experiência em programação. O Scrapestorm consegue extrair dados de tabelas, gráficos e mapas, bem como de PDFs e imagens. A sua interface intuitiva e as opções de personalização flexíveis tornam-no uma escolha popular para empresas de todas as dimensões.
Altair Monarch
O Altair Monarch é uma ferramenta de extração de dados que permite aos utilizadores extrair dados de várias fontes, incluindo PDFs, folhas de cálculo e bases de dados. Utiliza algoritmos de aprendizagem automática para identificar e extrair automaticamente dados de documentos não estruturados, o que ajuda a reduzir o esforço manual necessário para a extração de dados. Como resultado, o Altair Monarch é particularmente útil para empresas que extraem regularmente dados de grandes volumes de documentos.
Klippa
Uma ferramenta de extração de dados baseada em OCR, a Klippa automatiza o processamento de documentos. Consegue extrair dados de vários documentos, tais como faturas, recibos e contratos. Utiliza algoritmos de aprendizagem automática para reconhecer e extrair dados destes documentos e exporta os dados extraídos para vários formatos, como Excel, JSON e XML. O Klippa é particularmente útil para empresas que precisam de extrair dados de grandes volumes de documentos num curto espaço de tempo.
NodeXL
O NodeXL é uma ferramenta de análise e visualização de dados para redes sociais. Permite aos utilizadores extrair dados de várias plataformas de redes sociais, como o Twitter, o Facebook e o LinkedIn, e visualizá-los em gráficos e tabelas. O NodeXL é particularmente útil para empresas que precisam de analisar o comportamento dos seus clientes e concorrentes nas redes sociais. É popular entre muitas empresas devido à sua interface intuitiva e às suas funcionalidades avançadas.
O que torna a extração de dados um desafio?
Apesar de ser uma parte essencial do processo de análise de dados, a extração de dados também apresenta vários desafios que podem dificultar às empresas a extração e a utilização eficaz dos dados. Seguem-se alguns dos maiores desafios na extração de dados:
Problemas de formatação dos dados
Os dados podem apresentar-se em vários formatos e estruturas, o que dificulta a sua extração e normalização. Podem estar incompletos, ser inconsistentes ou conter erros, exigindo uma limpeza e transformação exaustivas dos dados.
Preocupações com a segurança dos dados
A extração de dados pode representar riscos de segurança se envolver informações sensíveis ou confidenciais. As empresas devem tomar medidas adequadas para garantir que os dados estejam seguros durante a extração e a transferência.
Limitações técnicas
A extração de dados pode ser um desafio se os dados estiverem armazenados em sistemas antigos ou em diferentes fontes de dados. Pode ser necessário recorrer a competências técnicas especializadas ou a ferramentas de software para extrair e integrar dados de múltiplas fontes.
Conformidade legal
A extração de dados deve cumprir os requisitos legais e regulamentares, tais como as leis de privacidade de dados, como o RGPD e a CCPA. O incumprimento destas regulamentações pode resultar em multas avultadas e danos à reputação.
Para superar estes desafios, é necessária uma abordagem estratégica à extração de dados, incluindo a utilização de ferramentas e técnicas avançadas e um compromisso com a qualidade e a segurança dos dados. Ao enfrentar estes desafios, as empresas podem explorar todo o potencial dos seus dados e obter uma vantagem competitiva no mercado.
Melhores práticas para a extração de dados
A extração de dados é uma etapa crucial na análise de dados, pelo que é essencial seguir as melhores práticas para garantir a precisão, a qualidade e o sucesso.
Identificar as fontes de dados
Comece por identificar todas as fontes de dados relevantes e compreender a estrutura dos dados. Isto irá ajudá-lo a evitar a perda de dados essenciais e o desperdício de recursos em fontes de dados irrelevantes.
Limpar e pré-processar os dados
Para garantir a precisão e a consistência, limpe e pré-processe os dados antes da extração. A limpeza e o pré-processamento dos dados podem ajudar a identificar e remover inconsistências, erros e valores atípicos que possam afetar a qualidade dos dados extraídos.
Armazenar e fazer cópias de segurança dos dados
O armazenamento e a realização de cópias de segurança dos dados são cruciais para garantir que os dados estejam acessíveis e seguros. Soluções de armazenamento de dados, como serviços baseados na nuvem, proporcionam flexibilidade e escalabilidade e podem ajudar a proteger os dados contra perdas ou danos.
Proteja os dados
Implemente medidas de segurança robustas, tais como encriptação de dados, controlos de acesso e auditorias de segurança regulares. A segurança dos dados deve ser uma prioridade máxima para proteger dados sensíveis e prevenir violações de segurança.
Conclusão
A extração de dados pode ser um desafio, mas com as ferramentas e técnicas certas, pode tornar-se fácil e acessível para principiantes. Abordámos os conceitos básicos da extração de dados neste guia para principiantes, desde a definição do termo até à discussão de diferentes métodos e ferramentas para a extração de dados.
O futuro da extração de dados é promissor, à medida que assistimos a avanços na aprendizagem automática e na inteligência artificial que permitem uma extração de dados mais eficiente e precisa a partir de várias fontes. À medida que a quantidade de dados disponíveis continua a crescer, surgirão questões como: de que tipos de big data podemos extrair valor e de que forma? Consequentemente, dominar a extração de dados tornar-se-á uma competência cada vez mais importante, tanto para as empresas como para os particulares.
É fundamental abordar a extração de dados com uma compreensão clara dos objetivos e necessidades do seu projeto, bem como com a disposição para experimentar diferentes ferramentas e métodos, a fim de descobrir o que funciona melhor. Ao seguir as dicas e técnicas descritas neste guia, estará no bom caminho para extrair e utilizar com sucesso dados valiosos.
Perguntas Frequentes - FAQs:
O que significa «extração de dados»?
A extração de dados é o processo de recolher dados de várias fontes, tais como bases de dados, sítios Web ou aplicações, e transformá-los num formato utilizável para análise. Os dados extraídos podem, em seguida, ser utilizados para gerar insights e apoiar a tomada de decisões.
Qual é um exemplo de extração de dados?
Um exemplo de extração de dados é a recolha de informações sobre produtos a partir de um site de comércio eletrónico. O processo de extração envolve a identificação dos campos de dados relevantes, tais como o nome do produto, o preço e a descrição, e a recuperação dos dados utilizando ferramentas de web scraping ou APIs.
Para que serve a extração de dados?
A extração de dados é utilizada para recuperar dados de múltiplas fontes, a fim de apoiar várias funções empresariais, tais como a análise de dados, a elaboração de relatórios e a tomada de decisões. Estes dados serão utilizados para gerar insights, desenvolver modelos preditivos e melhorar as operações e estratégias empresariais.
Quais são as técnicas de extração de dados?
Existem várias técnicas de extração de dados, tais como o web scraping, a integração de APIs e a consulta de bases de dados. O web scraping envolve a extração de dados de sites utilizando ferramentas automatizadas, enquanto a integração de APIs permite que os dados sejam recuperados a partir de aplicações baseadas na Web. A consulta de bases de dados é o processo de recuperação de dados a partir de bases de dados estruturadas utilizando consultas SQL.
Referências
(26 de maio de 2020). Técnicas de extração de dados. Rosoka.
https://www.rosoka.com/blog/data-extraction-techniques
(12 de agosto de 2022). Qual é a diferença entre mineração de dados e extração de dados? AmyGB.ai.
https://www.amygb.ai/blog/difference-between-data-mining-and-data-extraction
(12 de novembro de 2022). O que é a extração de dados? Por que é importante? The ECM Consultant.
https://theecmconsultant.com/what-is-data-extraction
(s.d.). ETL: Extrair, Transformar, Carregar. Talend.
https://www.talend.com/resources/what-is-etl/
(s.d.). Tipos de ferramentas ETL. Dremio.
https://www.dremio.com/resources/guides/adv-types-etl-tools/
(s.d.). O que são APIs e como funcionam? MuleSoft.
https://www.mulesoft.com/api-university/what-are-apis-and-how-do-they-work
(s.d.). O que é a Captura de Alterações de Dados (CDC)? Qlik.
https://www.qlik.com/us/change-data-capture/cdc-change-data-capture
(s.d.). O que é a extração de dados? Docparser.
https://docparser.com/blog/what-is-data-extraction/
(s.d.). O que é ETL (Extract, Transform, Load)? Oracle.
https://www.oracle.com/ph/integration/what-is-etl/
Deshpande, I. (16 de março de 2021). O que são dados de clientes? Definição, tipos, recolha, validação e análise. Spiceworks.
https://www.spiceworks.com/marketing/customer-data/articles/what-is-customer-data/
Eteng, O. (27 de janeiro de 2023). O que é a extração de dados? Tudo o que precisa de saber. Hevo Data.
https://hevodata.com/learn/data-extraction/#usecase
Hillier, W. (13 de agosto de 2021). O que é o web scraping e como utilizá-lo? CareeerFoundry.
https://careerfoundry.com/en/blog/data-analytics/web-scraping-guide/
IBM Cloud Education (29 de junho de 2021). Dados estruturados vs. dados não estruturados: qual é a diferença? IBM.
https://www.ibm.com/cloud/blog/structured-vs-unstructured-data

