Immobiliare.it 是意大利领先的在线房地产平台之一。
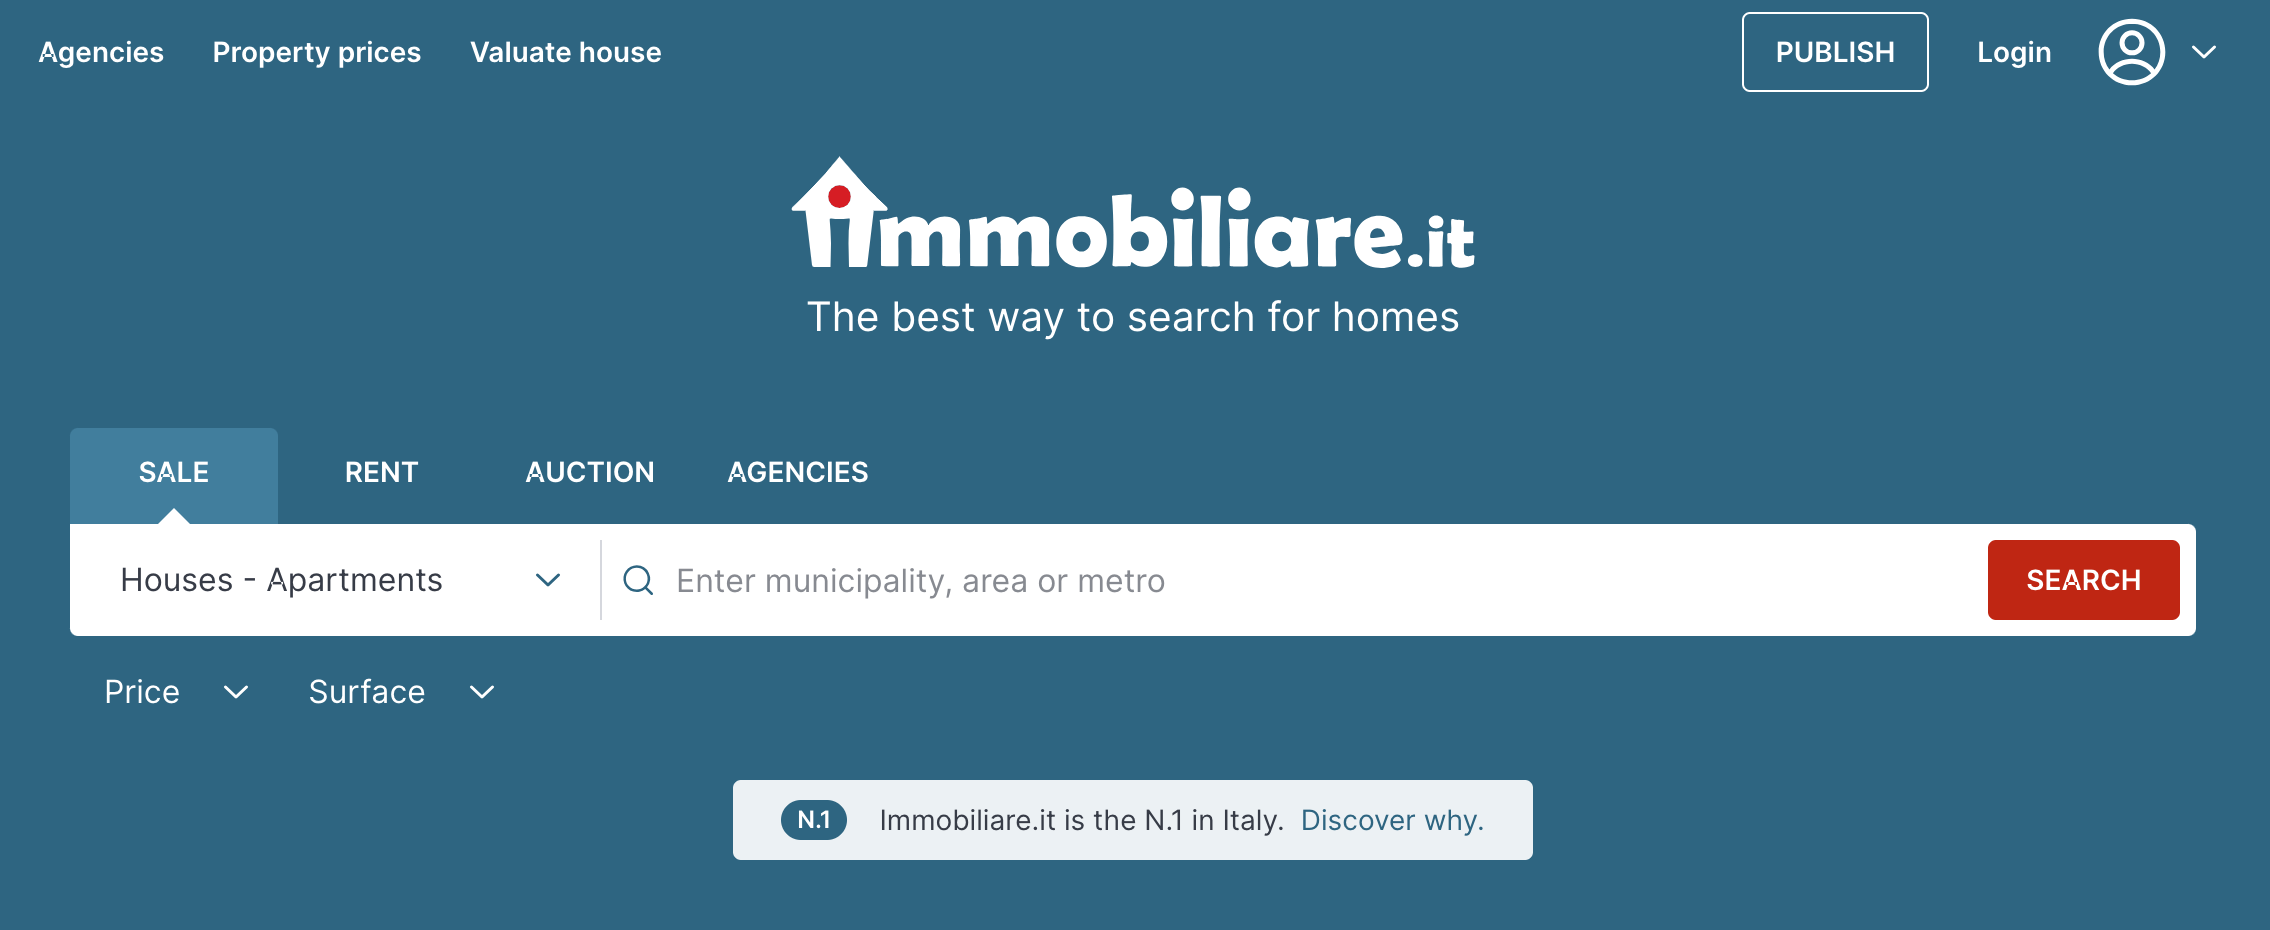
该网站拥有涵盖住宅、商业及度假房产的丰富房源,是任何有意投资意大利房地产人士的综合资源平台。
对于美国房地产经纪人和购房者而言,Immobiliare.it 提供了一个独特的机会,让他们能够接触到一个多元化的市场——若非通过该平台,从海外进入这一市场往往颇具挑战。

Maricor Bunal
更新于:2026年10月7日
发布于:2023年9月7日
探索从 Immobiliare.it 抓取房地产数据的终极指南。学习相关技术、工具和最佳实践,轻松收集有价值的房产信息。立即提升您的房地产分析能力!
Immobiliare.it 是意大利领先的在线房地产平台之一。
该网站拥有涵盖住宅、商业及度假房产的丰富房源,是任何有意投资意大利房地产人士的综合资源平台。
对于美国房地产经纪人和购房者而言,Immobiliare.it 提供了一个独特的机会,让他们能够接触到一个多元化的市场——若非通过该平台,从海外进入这一市场往往颇具挑战。
在房地产行业,数据就是王道。准确、及时的信息,往往决定了投资是成功还是会酿成代价高昂的失误。
对于美国房地产经纪人和购房者而言,要了解意大利市场,就需要一个可靠的数据来源。
Immobiliare.it 通过房产列表、价格走势、社区分析等形式提供了这些信息。
该平台强大的搜索筛选功能允许用户根据位置、房产类型和价格范围等多种标准缩小选择范围,从而更轻松地找到符合特定投资目标的房产。
Immobiliare.it 房地产数据的应用场景
市场调研。 美国房地产经纪人可以利用这些数据更好地了解意大利房地产市场,从而发现可能为客户带来利益的趋势和机会。
投资决策。 来自美国的购房者可以利用 Immobiliare.it 做出明智的投资决策。该
该平台的数据有助于发现被低估的房产、潜力新兴社区或利润丰厚的度假租赁房源。
比较分析。 这些数据可用于对比意大利市场与美国市场。
这对希望在国际上实现投资组合多元化的投资者尤为有用。
客户服务。 房地产经纪人可以为对意大利市场感兴趣的美国客户提供额外服务,例如基于 Immobiliare.it 数据制作的定制报告和分析。
营销策略。 通过抓取 Immobiliare.it 的数据,企业可以识别房产特征和地段的当前趋势,从而制定更有效的市场策略。
这种方法可以增强房地产网站在市场中的竞争力。
定价分析。 从Immobiliare.it抓取价格数据和价格历史记录,有助于进行全面的定价分析。
了解市场价格波动、最新价格及当前市场行情,可帮助企业和消费者做出更明智的决策。
法律与监管洞察。 Immobiliare.it 经常发布文章和资源,解释意大利的房地产法律法规,这对不熟悉意大利法律环境的美国投资者而言极具价值。
通过利用 Immobiliare.it 上的数据和资源,美国房地产经纪人和购房者可以在这个既充满挑战又回报丰厚的市场中获得竞争优势。
在从在线平台收集数据时,了解相关法律和伦理框架至关重要,以确保您的操作符合法律规定并尊重数据所有者的权利。
在抓取任何网站之前,务必查阅其 robots.txt 文件,该文件概述了针对网络爬虫的规则。
Immobiliare.it 的 robots.txt 文件 包含多项“Disallow”指令,指明了网站中不应被抓取的区域。
例如,该文件禁止抓取搜索地图、用户专区以及特定类型的房源信息等内容。
违反这些规则可能会导致被该网站封禁,甚至面临法律诉讼。
因此,在考虑对 Immobiliare.it 进行任何数据采集活动时,必须遵守 robots.txt 文件中规定的准则。
除了法律层面,从网站抓取数据时还需考虑道德因素。
符合道德规范的网络抓取既要遵守法律的条文和精神,也要尊重网站的 robots.txt 文件——该文件明确列出了网站中不应被抓取的区域。
此外,符合伦理规范的抓取还包括避免给网站服务器造成过载、尊重用户隐私,并负责任地使用数据。
若不遵守这些伦理准则,不仅会损害您的声誉,还可能面临法律后果。
以下是三篇探讨网络爬虫合法性的文章及其摘要:
美国第九巡回上诉法院裁定,抓取公开可访问的数据并不违反《计算机欺诈与滥用法案》(CFAA)。这一裁决对于使用网络爬虫工具的档案管理员、学者、研究人员和记者而言意义重大。
不过,文章也提到,此前曾有网络爬虫引发隐私和安全问题的案例。该案最初由领英(LinkedIn)对爬取领英用户个人资料的 Hiq Labs 公司提起诉讼。领英于 2019 年败诉,第九巡回上诉法院随后重申了其原判。
该文章指出,只要爬取的数据属于公开信息,美国目前尚无联邦法律禁止网络爬取。
不过,文章强调了伦理考量的重要性,并建议网络爬虫操作者应在网站服务条款和 robots.txt 文件的允许范围内进行操作。
该文章指出,根据大多数法律规定,未经所有者明确同意,收集、使用或存储个人身份信息(PII)均属违法行为。
文章还提到,网络爬取有时会陷入法律灰色地带,尤其是在涉及收集敏感信息时。
在网页抓取领域,有各种各样的工具和技术可供选择,以满足不同的需求。无论您是初学者还是经验丰富的数据科学家,都可能找到一款符合您项目要求的工具。下面,我们将探讨一些最常用的工具。
Python 是网络爬虫领域中广受欢迎的编程语言,它提供了多个库来简化爬取过程:
BeautifulSoup: 这是一个用于从 HTML 和 XML 文件中提取数据的 Python 库。它提供了用于遍历、搜索和修改解析树的 Python 风格惯用语。
BeautifulSoup 常用于网络爬虫,从网页中提取数据,对于初学者来说相对容易上手。
Selenium:与仅抓取源代码的 BeautifulSoup 不同,Selenium 能像人类用户一样与网页进行交互。
它常用于抓取通过 JavaScript 加载内容的动态网站,也可用于自动化测试。
这两个库可以结合使用,为任何网页抓取项目提供一套强大的工具集。
对于不愿深入研究编程的人来说,网页抓取服务提供了一种便捷的替代方案。
这些服务通常配备直观的用户界面,允许您指定需要抓取的数据,而无需编写任何代码。
它们负责从数据提取到存储的全部流程,让您能够更轻松地专注于数据的分析和利用。P
GitHub 是网络爬虫资源的宝库。您可以在这里找到大量提供现成爬虫脚本、框架和教程的仓库。
以下是一些您可能会觉得有用的仓库类型:
教程仓库。 这些仓库提供分步指南和代码片段,帮助您入门网页抓取。
框架仓库。 这些仓库包含预先构建的框架,专为抓取特定类型的网站或数据而设计。
项目仓库。 这些是功能完备的项目,演示了更复杂的抓取任务,通常涉及多个网站或技术。
通过研究这些仓库,您可以深入了解网页抓取的最佳实践和高级技术。
本节提供了一份全面指南,介绍如何使用 Python 库和其他工具从 Immobiliare.it 收集数据。
请按照以下步骤设置运行环境、编写代码,并查找 GitHub 示例以供进一步学习。
安装 Python。 如果您尚未安装,请从官方网站下载并安装 Python。
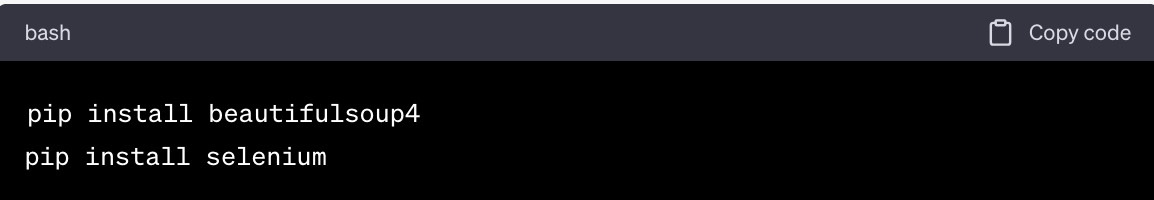
安装库。 打开终端,运行以下命令安装 BeautifulSoup 和 Selenium:
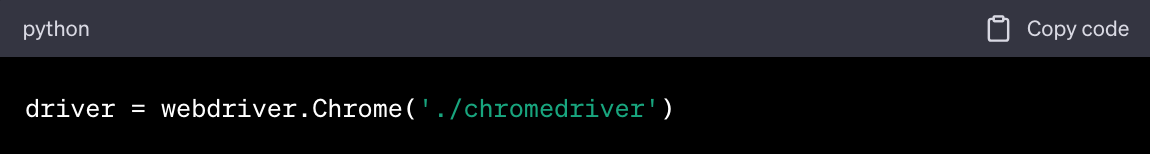
WebDriver。 下载与您的浏览器兼容的 WebDriver(例如,Chrome 浏览器需使用 ChromeDriver),并将其放置在项目目录中。
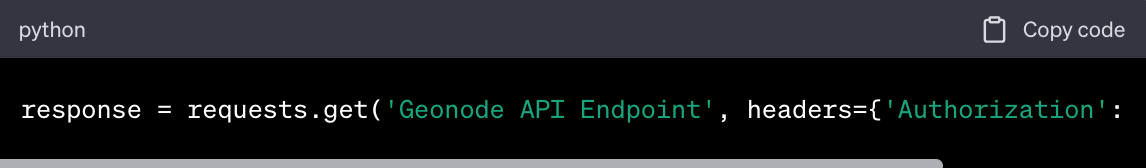
Geonode 的 API 密钥。 如果您使用的是 Geonode 的 Pay-As-You-Go 爬虫工具,请在其网站上注册获取一个 API 密钥。
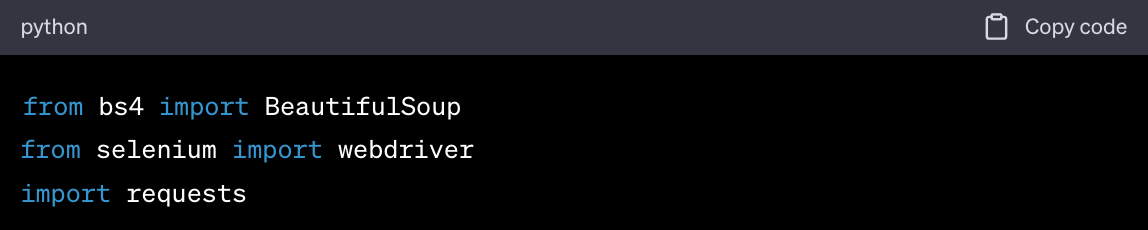
导入库。 在脚本开头导入必要的 Python 库。
初始化 WebDriver。 初始化 Selenium WebDriver。
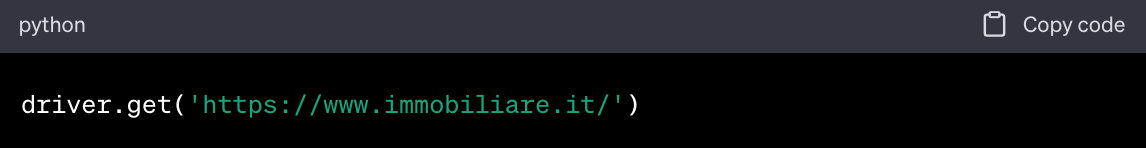
访问 Immobiliare.it。 使用 WebDriver 导航至您想要抓取的 Immobiliare.it 网页。
定位元素。 使用 BeautifulSoup 或 Selenium 函数定位包含您想要抓取数据的 HTML 元素。
抓取数据。 提取数据并将其存储在变量或文件中。
Geonode API。 如果使用 Geonode,请发起 API 调用以处理代理、浏览器和验证码。
关闭 WebDriver。 完成后请务必关闭 WebDriver。
搜索仓库。 使用 GitHub 的搜索功能查找与 Python、BeautifulSoup 和 Selenium 进行网页抓取相关的仓库。
研究代码。 寻找专门针对房地产网站或 Immobiliare.it 设计的示例。
学习教程。 部分 GitHub 仓库提供了分步教程,可帮助您更好地理解代码。
克隆并尝试。 不要犹豫,克隆这些仓库并根据你的具体需求调整代码。
随着您对基础网页抓取技巧越来越熟悉,您可能会发现需要应对更复杂的挑战。本节概述了一些高级技巧,可帮助您应对这些更复杂的场景。
动态网站通常通过 JavaScript 以异步方式加载内容,这会增加抓取的难度。以下是处理动态网站的一些高级技巧:
Selenium WebDriver。 如前所述,Selenium 可以与动态网页交互,从而让你抓取通过 JavaScript 加载的数据。
无头浏览。 使用 PhantomJS 等无头浏览器,或以无头模式运行 Selenium,无需打开实际的浏览器窗口即可抓取网站数据。
AJAX 请求。 部分网站通过 AJAX 请求加载数据。您可以使用开发者工具检查这些请求,并借助 Python 的 requests 库进行模拟。
等待命令。 使用 Selenium 中的显式和隐式等待命令,确保网页完全加载后再进行抓取。
由于需要确保准确性且涉及道德考量,抓取房地产经纪人相关数据可能会稍显复杂。以下是一些建议:
锁定特定区域。 使用 BeautifulSoup 或 XPath 表达式,锁定网站中存储经纪人数据的特定区域。
分页处理。 许多网站将经纪人信息分页展示。请确保您的代码能够处理分页功能。
请求速率限制。 请遵守网站的条款和条件。在代码中实现请求速率限制,以避免给服务器造成过载。
数据验证。 务必对抓取到的数据进行验证,以确保其准确性和完整性。
网站经常更新其 HTML 结构,这可能会导致您的抓取代码失效。以下是应对方法:
定期更新:密切关注与您正在抓取的网站相关的 StackOverflow 讨论帖。用户通常会分享网站结构变更的最新信息。
错误处理:在代码中实现完善的错误处理机制,以便在抓取失败时发出警报,从而让你能够相应地更新代码。
社区见解:当网站更改代码结构时,StackOverflow 是寻找抓取变通方案或替代方法的绝佳去处。
掌握这些高级技巧后,您将更有能力应对各种网络爬取挑战。无论是处理动态内容、专业数据,还是应对不断变化的网站结构,这些方法都能为您提供有效收集数据所需的技能。
成功收集数据后,下一步就是对其进行有效分析和应用。
本节将指导您完成对抓取数据的分析、构建自己的定价模型,以及创建和更新报价配置文件。
数据清洗。 任何数据分析流程的第一步都是对数据进行清洗。 删除重复项、处理缺失值,并在必要时转换数据类型。
数据可视化。 使用 Matplotlib 或 Seaborn 等库对数据进行可视化。这有助于您识别趋势、异常值或规律。
统计分析。 使用统计方法对数据进行汇总。计算均值、中位数、标准差等指标,以便更好地理解数据分布。
**文本分析。 **如果你抓取了文本数据,可以考虑使用自然语言处理(NLP)技术来提取洞见。
相关性分析。 识别彼此之间相关性较强的变量。这在房地产领域尤为有用,有助于理解不同因素如何影响房价。
网络爬虫并非没有挑战。从验证码(CAPTCHA)和速率限制,到数据质量和可靠性的问题,本节旨在帮助您做好应对可能遇到的一些障碍的准备,并提供相应的解决方案。
了解这些常见挑战及其解决方案,将使您在进行网页抓取时,能够更好地应对可能遇到的任何问题。
您可以使用 WebHarvy、Octoparse 或 Import.io 等无需编码的网页抓取工具。 这些工具提供用户友好的界面,支持点选式数据提取。
最常用的 Python 网络爬虫库包括用于解析 HTML 和 XML 的 BeautifulSoup,以及用于与大量使用 JavaScript 的网站交互的 Selenium。 对于更复杂的项目,Scrapy 也是一个不错的选择。
网页抓取的合法性取决于网站的服务条款以及您对数据的使用方式。请务必查阅网站的使用条款,并考虑寻求法律建议以确保合规。
在深入探讨了网络爬虫的各个方面——从环境搭建到克服挑战——之后,现在是时候总结一下,并展望下一步了。
官方文档。 这始终是一个很好的起点。 BeautifulSoup、Selenium 及其他库都提供了详尽的文档,有助于您更好地理解其功能。
在线课程。 Udemy、Coursera 和 edX 等网站提供了关于网页抓取和数据分析的课程。
YouTube 教程。 有无数的教程可供参考,内容涵盖从基础知识到高级技巧的方方面面。
论坛和社区。 StackOverflow 和 Reddit 等网站拥有活跃的社区,您可以在那里提问并分享知识。
书籍。 此外,还有多本专注于网络爬虫和数据采集技术的书籍可供参考。
既然你已经掌握了高效进行网页抓取所需的知识和工具,现在是时候将它们付诸实践了。
不妨从小处着手,多加尝试,随着自信心的增强,也请不要犹豫,大胆尝试更复杂的项目。
请记住,成功进行网页抓取的关键不仅在于收集数据,更在于将其转化为可付诸行动的洞察。