Warum Twitter-Daten scrapen?
Twitter-Daten lassen sich aufgrund ihres Echtzeitcharakters und der enormen Menge an öffentlicher Meinung, die sie widerspiegeln, auf vielfältige Weise in verschiedenen Bereichen nutzen, beispielsweise:
• Markenbeobachtung. Unternehmen können Twitter-Daten nutzen, um in Echtzeit zu beobachten, was über ihre Marke gesagt wird. Dies kann ihnen helfen, umgehend auf Kundenbeschwerden oder -anfragen zu reagieren, die Wirksamkeit von Marketingkampagnen zu verfolgen und die öffentliche Stimmung gegenüber ihrer Marke zu verstehen. So könnte beispielsweise ein plötzlicher Anstieg negativer Äußerungen zu einem Produkt auf ein Problem hinweisen, das schnell behoben werden muss.
• Trendanalyse. Auf Twitter entstehen neue Trends oft als Erstes, was die Plattform zu einer wertvollen Quelle für die Trendanalyse macht. Durch die Analyse der Inhalte von Tweets können Unternehmen aufkommende Trends in ihrer Branche erkennen, die Popularität bestimmter Themen im Zeitverlauf verfolgen und sogar zukünftige Trends vorhersagen. Dies kann als Grundlage für die Geschäftsstrategie dienen – von der Produktentwicklung bis hin zu Marketing und Vertrieb.
• Wissenschaftliche Forschung. Forscher in Bereichen wie Soziologie, Linguistik und Politikwissenschaft können Twitter-Daten für eine Vielzahl von Zwecken nutzen. So können sie beispielsweise Tweets von Nutzern analysieren, um den Sprachgebrauch zu untersuchen, die Verbreitung von Informationen oder Falschinformationen zu beobachten oder die Reaktion der Öffentlichkeit auf bestimmte Ereignisse oder politische Maßnahmen zu erforschen.
• Journalismus. Journalisten können Twitter-Daten nutzen, um aktuelle Nachrichten zu finden, die Entwicklung von Themen zu verfolgen und die öffentliche Meinung zu verschiedenen Themen einzuschätzen. In manchen Fällen können Tweets selbst zu Nachrichten werden. So können beispielsweise Tweets von Persönlichkeiten des öffentlichen Lebens erhebliche Auswirkungen haben und werden oft in den Medien aufgegriffen.
Dies sind nur einige Beispiele dafür, wie Daten aus Milliarden von Tweets genutzt werden können. Die Möglichkeiten sind enorm und nehmen weiter zu, da immer mehr Menschen vom Teilen ihrer Gedanken und Erfahrungen auf anderen Social-Media-Plattformen auf Twitter umsteigen.
Twitter-Daten verstehen
Bevor wir uns mit den Methoden des Twitter-Scrapings befassen, ist es wichtig, die vier auf Twitter verfügbaren Datentypen und die potenziellen Erkenntnisse, die sich daraus ableiten lassen, zu verstehen.
• Tweets. Ein Tweet ist die grundlegendste Informationseinheit auf Twitter. Es handelt sich um eine von einem Nutzer gepostete Nachricht, die bis zu 280 Zeichen umfassen kann. Jeder Tweet enthält eine Fülle von Daten, darunter den Inhalt des Tweets, den Zeitpunkt der Veröffentlichung, die Anzahl der Likes und Retweets sowie die verwendeten Hashtags. Die Analyse von Tweet-Daten kann Einblicke in Trendthemen, die Stimmung zu einem bestimmten Thema, die Reichweite eines Hashtags und vieles mehr liefern.
• Nutzer. Nutzerdaten beziehen sich auf die Informationen zu Twitter-Konten. Dazu gehören der Nutzername, die Profilbeschreibung, der Standort, die Anzahl der Follower und der Personen, denen man folgt, die Anzahl der Tweets sowie das Erstellungsdatum des Kontos. Durch die Analyse von Nutzerdaten können Sie Einblicke in die demografische Zusammensetzung einer Nutzerbasis gewinnen, Influencer in einem bestimmten Bereich identifizieren oder das Wachstum eines Twitter-Kontos im Zeitverlauf verfolgen.
• Entitäten. Entitäten in Twitter-Daten beziehen sich auf die Objekte, die mit einem Tweet verbunden sind. Dazu gehören Hashtags, Erwähnungen von Nutzern, URLs und Medien (Fotos und Videos). Entitäten bieten eine Möglichkeit, den Kontext eines Tweets zu verstehen. So kann beispielsweise die Analyse der mit einem Tweet verbundenen Hashtags dabei helfen, die diskutierten Themen zu identifizieren, während die Untersuchung der Erwähnungen von Nutzern das Netzwerk der Interaktionen aufzeigen kann.
• Orte. Diese Daten beziehen sich auf die geografischen Informationen, die mit einem Tweet oder einem Nutzer verbunden sind. Dies kann der Ort sein, von dem aus ein Tweet gepostet wurde, oder der im Profil eines Nutzers angegebene Standort. Die Analyse von Ortsdaten kann Einblicke in geografische Trends, die Verbreitung von Informationen über verschiedene Orte hinweg oder die Beliebtheit eines Themas in unterschiedlichen Regionen liefern.
Jede Datenart hat ihre eigene Bedeutung und kann einzigartige Erkenntnisse liefern. So können beispielsweise Tweet-Daten dabei helfen, Trendthemen und die öffentliche Stimmung zu identifizieren, Nutzerdaten können Influencer und demografische Merkmale der Zielgruppe aufzeigen, Entitäten können Kontext für die Diskussionen liefern und Ortsdaten können geografische Trends aufdecken.
Durch das Verstehen und Analysieren dieser Datentypen können Sie eine Fülle von Erkenntnissen aus Twitter gewinnen. Ob für Marktforschung, Markenbeobachtung, wissenschaftliche Forschung oder Journalismus – Twitter-Daten bieten eine reichhaltige und dynamische Quelle, um die öffentliche Meinung zu verstehen, Trends zu verfolgen und den Puls globaler Diskussionen zu erfassen.
So extrahieren Sie Twitter-Daten: Drei Methoden
1. Twitter-API
Die offizielle API von Twitter ermöglicht es Entwicklern, programmgesteuert mit der Plattform zu interagieren. Die API bietet Zugriff auf verschiedene Arten von Daten, darunter Tweets, Twitter-Profile und vieles mehr.
Warum die Twitter-API nutzen?
• Strukturierte Daten. Die von der API zurückgegebenen Daten sind gut strukturiert und konsistent, was ihre Verarbeitung und Analyse erleichtert.
• Zuverlässigkeit. Da die API von Twitter selbst bereitgestellt wird, gewährleistet sie Zuverlässigkeit und Kontinuität des Dienstes.
• Umfassende Dokumentation. Twitter stellt eine umfangreiche Dokumentation für seine API bereit, was es Entwicklern erleichtert, die API zu verstehen und effektiv zu nutzen.
Einschränkungen der Twitter-API
• Ratenbeschränkungen. Um Missbrauch zu verhindern, legt Twitter für einen bestimmten Zeitraum Beschränkungen für seine API fest. Beispielsweise sind mit einer benutzerauthentifizierten App nur 900 Anfragen pro 15 Minuten für Nutzer-Timeline-Abfragen zulässig.
• Datenzugriff. Nicht alle Daten sind über die API zugänglich. So kann man beispielsweise nur auf die letzten 3.200 Tweets aus der Timeline eines Nutzers zugreifen.
• Kosten. Twitter bietet zwar eine kostenlose Stufe für seine API an, diese ist jedoch mit erheblichen Einschränkungen verbunden. Der Zugriff auf mehr Daten und höhere Ratenbegrenzungen erfordert ein kostenpflichtiges Abonnement, das recht teuer sein kann.
Schritte zur Nutzung der Twitter-API zum Auslesen von Twitter-Daten:
Die Twitter-API ist ein leistungsstarkes Tool, mit dem Entwickler programmgesteuert auf eine Vielzahl von Twitter-Daten zugreifen können. Hier finden Sie eine Schritt-für-Schritt-Anleitung zur Nutzung:
1. Entwicklerkonto einrichten
• Rufen Sie die Entwickler-Website von Twitter auf (https://developer.twitter.com/
).
• Klicken Sie auf die Schaltfläche „Beantragen“.
• Sie werden aufgefordert, sich bei Ihrem Twitter-Konto anzumelden. Falls Sie noch kein Konto haben, müssen Sie eines erstellen.
• Füllen Sie nach der Anmeldung den Antrag auf ein Entwicklerkonto aus. Im Antrag werden Details dazu abgefragt, wie Sie die API nutzen möchten. Geben Sie so detaillierte Angaben wie möglich an, um Ihre Chancen auf eine Genehmigung zu erhöhen.
• Warten Sie nach dem Absenden Ihres Antrags auf die Genehmigung durch Twitter. Dies kann einige Tage dauern, haben Sie also etwas Geduld.
2. Erstellen Sie eine App und erhalten Sie API-Schlüssel
• Melden Sie sich bei Ihrem Twitter-Entwicklerkonto an.
• Gehen Sie zum „Dashboard“ und klicken Sie auf „App erstellen“.
• Füllen Sie das Formular mit Angaben zu Ihrer App aus. Geben Sie einen Namen, eine Beschreibung und die URL Ihrer Website an und teilen Sie Twitter mit, wie Sie die App nutzen möchten.
• Notieren Sie sich die API-Schlüssel, die nach der Erstellung Ihrer App auf der Seite angezeigt werden. Es gibt zwei Schlüsselpaare: den API-Schlüssel und das API-Geheimnis sowie den Zugriffstoken und das Zugriffsgeheimnis. Sie benötigen diese Schlüssel, um Ihre App bei der Nutzung der API zu authentifizieren.
**3. Verwenden Sie Tweepy für den Zugriff auf die Twitter-Scraper API
**
Befolgen Sie diese Schritte:
• Importieren Sie die Tweepy-Bibliothek.
• Authentifizieren Sie sich bei Twitter mit Ihren API-Schlüsseln.
• Erstellen Sie ein API-Objekt, mit dem Sie mit der Twitter-API interagieren können.
• Verwenden Sie die Methode user_timeline, um die neuesten Tweets aus der Timeline eines Nutzers (in diesem Fall „twitter“) abzurufen und den Text jedes Tweets auszugeben.
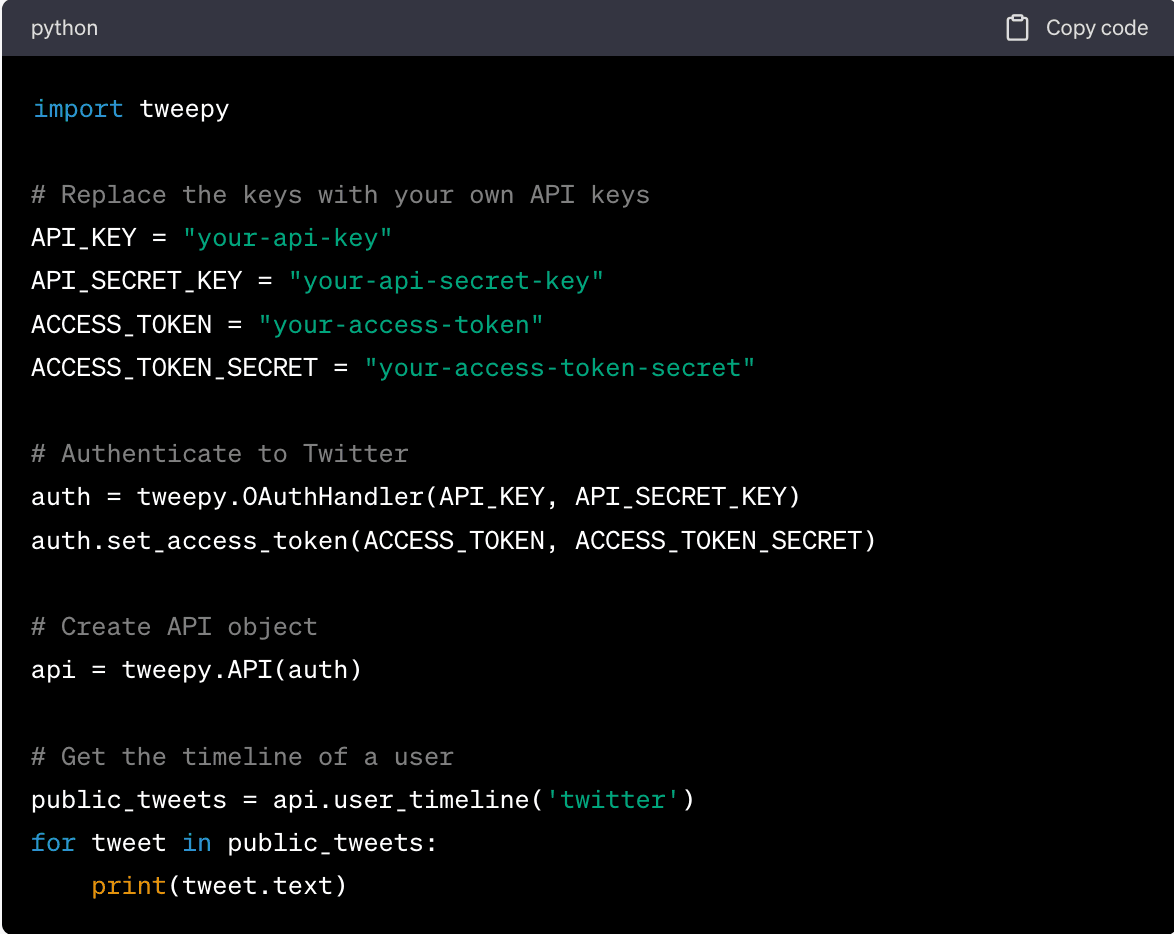
Denke daran, „your-api-key“, „your-api-secret-key“, „your-access-token“ und „your-access-token-secret“ durch deine eigenen API-Schlüssel zu ersetzen. Ersetze außerdem „twitter“ durch den Nutzernamen des Twitter-Kontos, von dem du Tweets abrufen möchtest.
Dies ist ein einfaches Beispiel, aber Tweepy bietet viele weitere Methoden für den Zugriff auf verschiedene Arten von Twitter-Daten. Weitere Informationen findest du in der Dokumentation von Tweepy.
Zusammenfassend lässt sich sagen: Die Twitter-API bietet zwar eine zuverlässige und strukturierte Möglichkeit, auf Twitter-Daten zuzugreifen, ist jedoch mit Einschränkungen hinsichtlich Ratenbegrenzungen, Datenzugriff und Kosten verbunden. Diese Einschränkungen können bei groß angelegten Datenextraktionsprojekten eine erhebliche Hürde darstellen. In solchen Fällen kann Web-Scraping eine flexiblere und kostengünstigere Alternative sein, auf die wir im nächsten Abschnitt eingehen werden.
2. Web-Scraping auf Twitter mit Python
Web-Scraping auf Twitter mit Python bezeichnet den Prozess der automatischen Extraktion von Daten aus der Twitter-Website mithilfe der Programmiersprache Python. Dieser Prozess wird häufig genutzt, um große Datenmengen von Twitter zu sammeln, deren manuelle Erfassung zu zeitaufwendig wäre.
Warum Python verwenden?
• Leistungsstarke Bibliotheken. Python verfügt über ein umfangreiches Ökosystem an Bibliotheken, die das Web-Scraping vereinfachen. Bibliotheken wie Tweepy, BeautifulSoup und Scrapy können alles abdecken – von der Erstellung von HTTP-Anfragen über das Parsen von HTML bis hin zur Interaktion mit APIs.
• Benutzerfreundlichkeit. Die Syntax von Python ist klar und prägnant, was die Sprache zu einer guten Wahl für das Web-Scraping macht. Selbst komplexe Scraping-Aufgaben lassen sich mit relativ wenigen Codezeilen bewältigen.
• Tools zur Datenanalyse. Python eignet sich zudem hervorragend zur Datenanalyse. Bibliotheken wie Pandas, Numpy und Matplotlib erleichtern das Bereinigen, Analysieren und Visualisieren der gescrapten Daten.
• Unterstützung durch die Community. Python verfügt über eine große und aktive Community, die es sehr einfach macht, online Hilfe und Ressourcen zu finden. Wenn Sie auf ein Problem stoßen, ist die Wahrscheinlichkeit groß, dass es bereits von jemand anderem gelöst wurde.
Einschränkungen von Python
• Dynamische Inhalte. Die Standard-Web-Scraping-Tools von Python haben Schwierigkeiten mit dynamischen Inhalten, die über JavaScript geladen werden. Es gibt zwar Möglichkeiten, dies zu umgehen, beispielsweise durch die Verwendung einer Bibliothek wie Selenium, doch dies erhöht die Komplexität des Twitter-Scraping-Projekts zusätzlich.
• Ratenbegrenzung. Twitter legt API-Ratenbegrenzungen fest, die Ihr Web-Scraping-Projekt verlangsamen können. Zwar gibt es Möglichkeiten, dies zu umgehen, beispielsweise durch die Verwendung mehrerer Konten oder IP-Adressen, doch verstoßen diese Methoden gegen die Nutzungsbedingungen von Twitter.
• Änderungen an der Website-Struktur. Wenn Twitter die Struktur seiner Website oder seiner API ändert, funktioniert Ihr Scraping-Code möglicherweise nicht mehr. Sie müssen Ihren Code dann an diese Änderungen anpassen, was zeitaufwendig sein kann.
Schritte zur Verwendung von Python für das Web-Scraping von Twitter:
1. Richten Sie die Umgebung ein. Installieren Sie Python und die erforderlichen Bibliotheken, falls Sie diese noch nicht haben. Für dieses Beispiel verwenden wir BeautifulSoup und Requests.
2. Senden Sie eine HTTP-Anfrage an die Twitter-Seite, die Sie scrapen möchten.
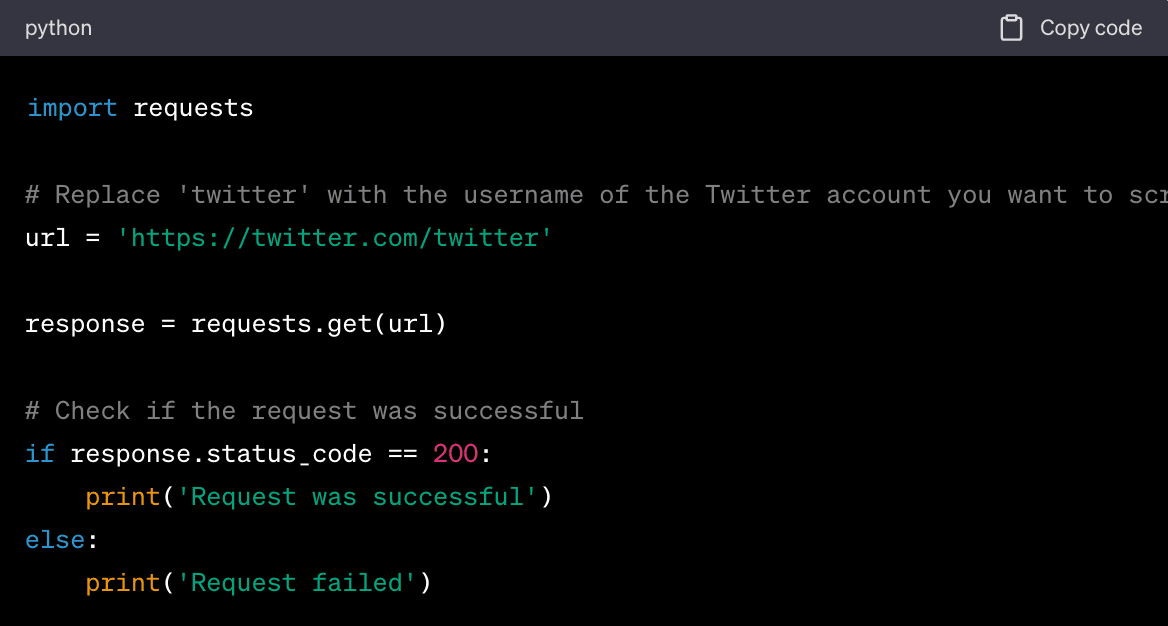
Der Server antwortet auf die Anfrage, indem er den HTML-Inhalt der Webseite zurückgibt.
3. Die Daten auswerten. Da die Daten im HTML-Format vorliegen, benötigst du einen Parser, der die gewünschten Daten auswerten und extrahieren kann.
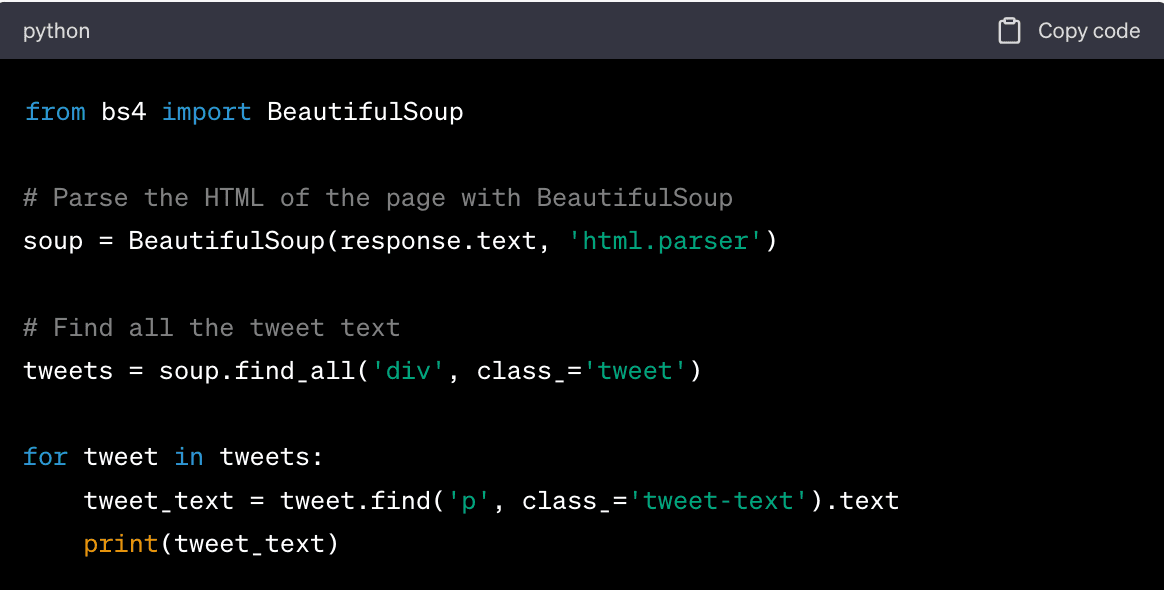
In diesem Code erstellen wir zunächst ein BeautifulSoup-Objekt und analysieren den HTML-Code der Seite. Anschließend suchen wir alle div-Elemente mit der Klasse „tweet“, die die Tweets enthalten. Für jeden Tweet suchen wir das p-Element mit der Klasse „tweet-text“, das den Text des Tweets enthält, und geben ihn aus.
4. Verwende Abfragemethoden, um bestimmte Datenelemente zu finden. Mit BeautifulSoup kannst du beispielsweise Methoden wie find_all() verwenden, um Header-Tags, Absätze oder andere Elemente zu lokalisieren.
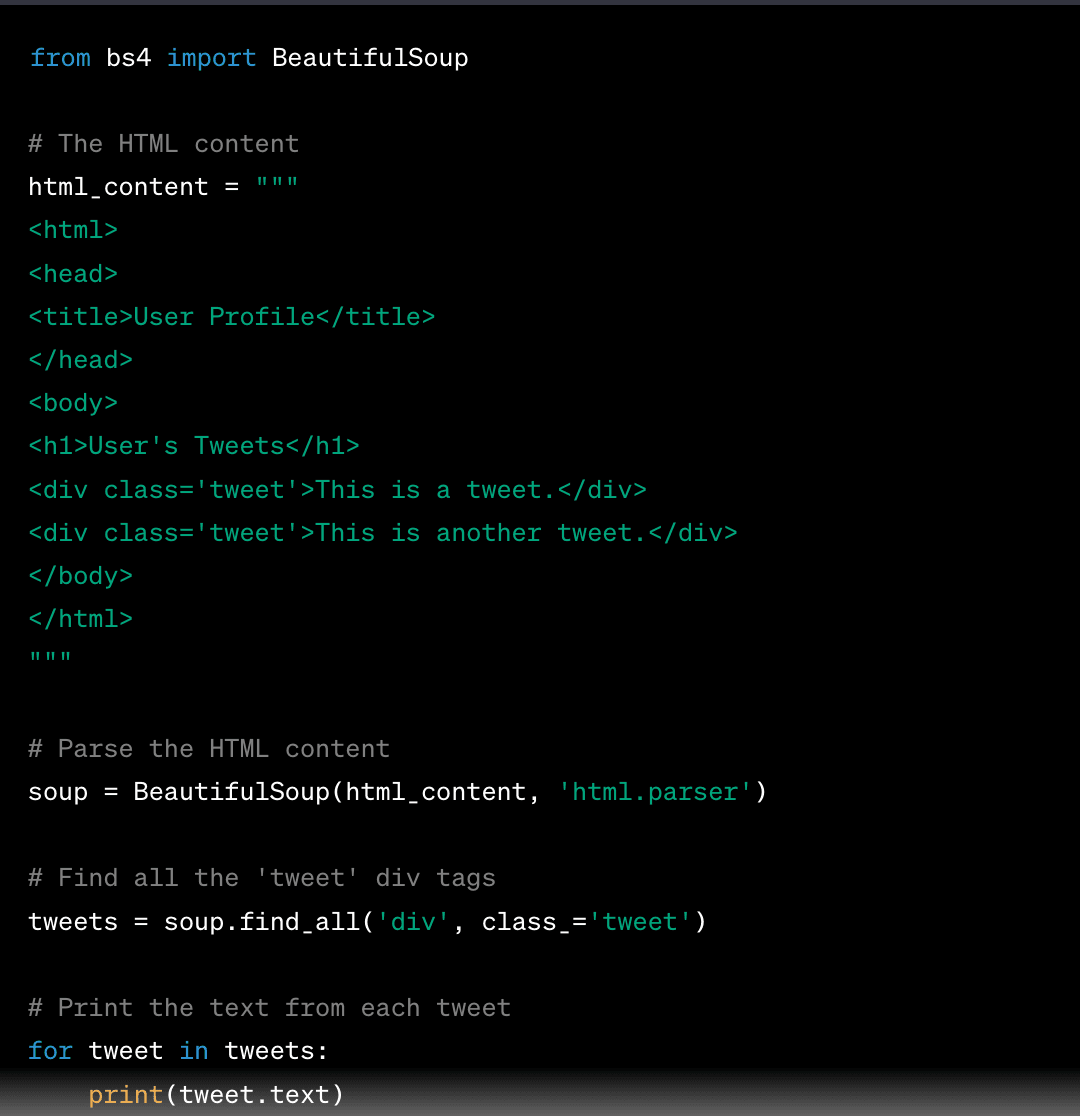
5. Speichern Sie die Daten in dem von Ihnen bevorzugten Format, z. B. als CSV, JSON oder in einer Datenbank. So speichern Sie sie mithilfe der Pandas-Bibliothek in einer CSV-Datei:
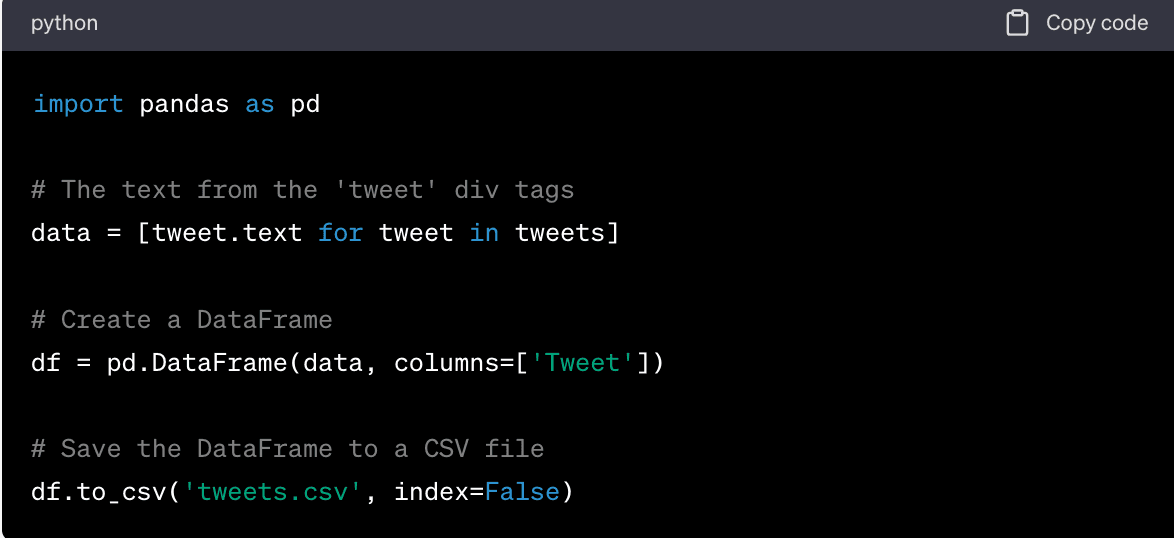
Dadurch wird eine CSV-Datei namens „tweets.csv“ mit einer einzigen Spalte „Tweet“ erstellt, die den Text aus den „tweet“-Div-Tags enthält. Hier ist ein einfaches Beispiel, wie Sie den Text eines Tweets mit Python und BeautifulSoup auslesen können:
3. „Geonode
“
Geonode
s „Scraper API
“ ist ein leistungsstarkes Tool, mit dem Sie Daten von Websites wie Twitter extrahieren können. Es bietet verschiedene Scraping-Modi für optimale Leistung und Effizienz.
Warum den „Pay-As-You-Go
“-Scraper von „Geonode
“ verwenden?
• Flexible Preisgestaltung. Beim „pay-as-you-go
“-Modell zahlen Sie nur für das, was Sie tatsächlich nutzen. Dies kann kostengünstiger sein als ein Abonnementmodell, insbesondere bei unregelmäßiger Nutzung oder geringen Datenmengen.
• Skalierbarkeit. Dieser Scraper API
ist sowohl für kleine als auch für umfangreiche Scraping-Aufgaben ausgelegt. Das bedeutet, dass Sie Ihre Scraping-Aufgaben nach Bedarf skalieren können, ohne sich Gedanken über Nutzungsgrenzen machen zu müssen.
• Benutzerfreundlichkeit. Geonode
s Scraper API
ist einfach zu bedienen, selbst für Nutzer ohne Programmierkenntnisse. Es bietet eine einfache Möglichkeit, Daten aus Twitter zu extrahieren.
• Erweiterte Funktionen. Geonode
s Scraper API
bietet eine Reihe erweiterter Funktionen wie JavaScript-Rendering, die Ausführung benutzerdefinierter JS-Snippets, Proxy-Rotation, Geotargeting und vieles mehr. Diese Funktionen können bei komplexen Scraping-Aufgaben sehr nützlich sein.
• Echtzeit- und Callback-Modus. Die API bietet zwei Modi für das Scraping: den Echtzeitmodus und den Callback-Modus. Dies gibt Ihnen Flexibilität bei der Art und Weise, wie Sie Ihre Scraping-Ergebnisse erhalten.
Einschränkungen des „Pay-As-You-Go
“-Scrapers von GeoNode
• Kosten können sich summieren: Während das „pay-as-you-go
“-Modell bei geringer Nutzung kostengünstig sein kann, können sich die Kosten bei groß angelegten Scraping-Aufgaben schnell summieren. Es ist wichtig, Ihre Nutzung zu überwachen, um unerwartete Kosten zu vermeiden.
• Lernkurve: Obwohl der „Scraper API
“ von GeoNode
auf Benutzerfreundlichkeit ausgelegt ist, kann es dennoch eine gewisse Lernkurve geben, insbesondere für diejenigen, die noch keine Erfahrung mit Web-Scraping oder APIs im Allgemeinen haben.
• **Abhängigkeit vom Dienst von GeoNode
**: Wie bei jedem Drittanbieter-Dienst sind Sie für Ihre Scraping-Aufgaben auf den Dienst von GeoNode
angewiesen. Sollten Probleme mit diesem Dienst auftreten, könnte dies Ihre Scraping-Aufgaben beeinträchtigen.
• Rechtliche und ethische Überlegungen: Web-Scraping kann eine rechtliche Grauzone darstellen. Auch wenn die „Scraper API
“ von GeoNode
das Scrapen von Daten vereinfachen, ist es wichtig sicherzustellen, dass Ihre Scraping-Aktivitäten den Nutzungsbedingungen der von Ihnen gescrapten Website sowie allen einschlägigen Datenschutzgesetzen entsprechen.
Schritte zur Verwendung von Geonode Scraper API für das Data-Scraping auf Twitter
1. Richten Sie Ihre Anfrage ein. Um den GeoNode Scraper API zu nutzen, müssen Sie eine Anfrage einrichten. Diese Anfrage sollte die URL der Seite enthalten, die Sie scrapen möchten (in diesem Fall eine Twitter-Seite), sowie eine Reihe von Konfigurationen, die das Verhalten des Scrapers steuern. Hier ist ein Beispiel dafür, wie Sie Ihre Anfrage strukturieren können:
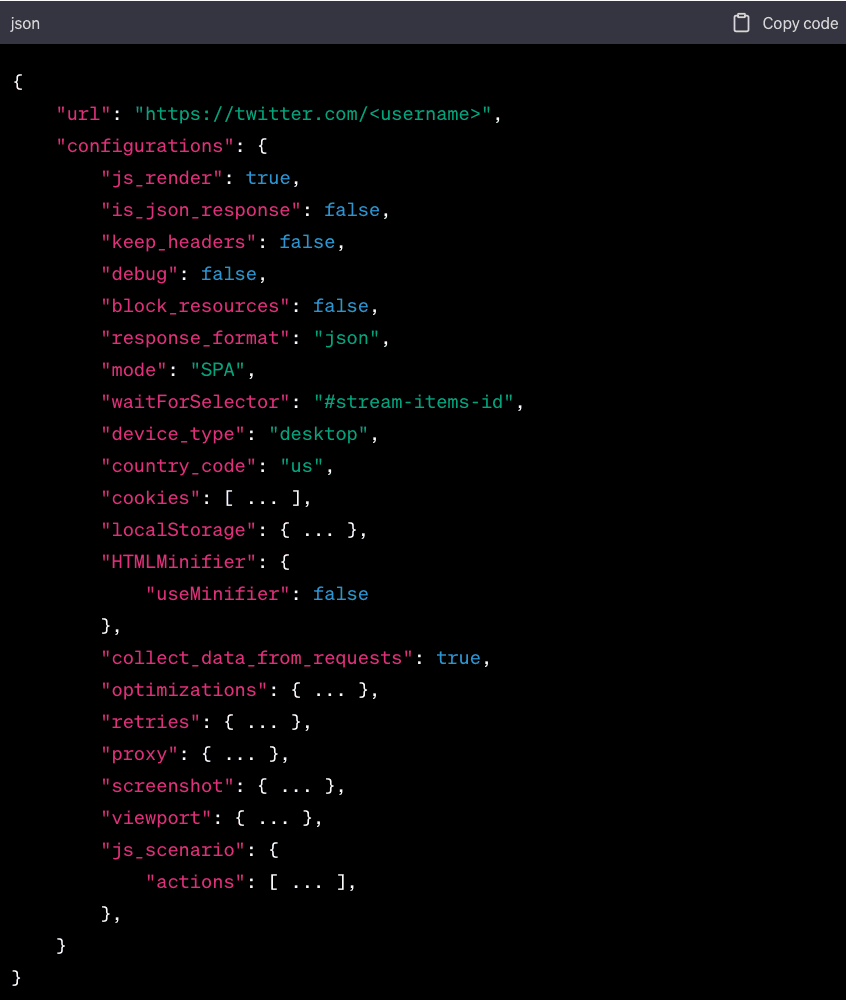
In diesem Beispiel ist die URL die Twitter-Seite, die Sie scrapen möchten. Der Parameter „waitForSelector“ ist auf „#stream-items-id“ gesetzt, was die ID des div-Elements ist, das die Tweets auf einer Twitter-Seite enthält. Dadurch wird der Scraper angewiesen, zu warten, bis dieses Element geladen ist, bevor die Seite gescrapt wird.
2. Echtzeitmodus und Callback-Modus. GeoNode Scraper API bietet zwei Modi für das Scraping: den Echtzeitmodus und den Callback-Modus. Im Echtzeitmodus gibt die API das Ergebnis unmittelbar nach Abschluss des Scrapings zurück. Im Callback-Modus sendet die API das Ergebnis an eine angegebene Callback-URL, sobald das Scraping abgeschlossen ist. Sie können den Modus wählen, der Ihren Anforderungen am besten entspricht.
3. Überprüfen Sie den Status Ihrer Aufgabe. Sie können den Status Ihrer Scraping-Aufgabe anhand der Anfrage-ID überprüfen, die Sie in der ersten Antwort erhalten haben. Auf diese Weise können Sie den Fortschritt Ihrer Aufgabe verfolgen und deren Abschlussstatus ermitteln.
4. Aktionen. Die „Geonode“ (Scraper API) ermöglicht es Ihnen, über eine Liste unterstützter Aktionen mit dem Zieldokument zu interagieren. Sie können beispielsweise Aktionen nutzen, um vor dem Scraping auf eine Schaltfläche zu klicken oder ein Formular auf der Seite auszufüllen.
Analyse von Twitter-Daten
Nachdem Sie Twitter-Daten gesammelt und gespeichert haben, besteht der nächste Schritt darin, diese zu analysieren. Hier finden Sie eine Schritt-für-Schritt-Anleitung:
**1. Grundlegende Analyse. **
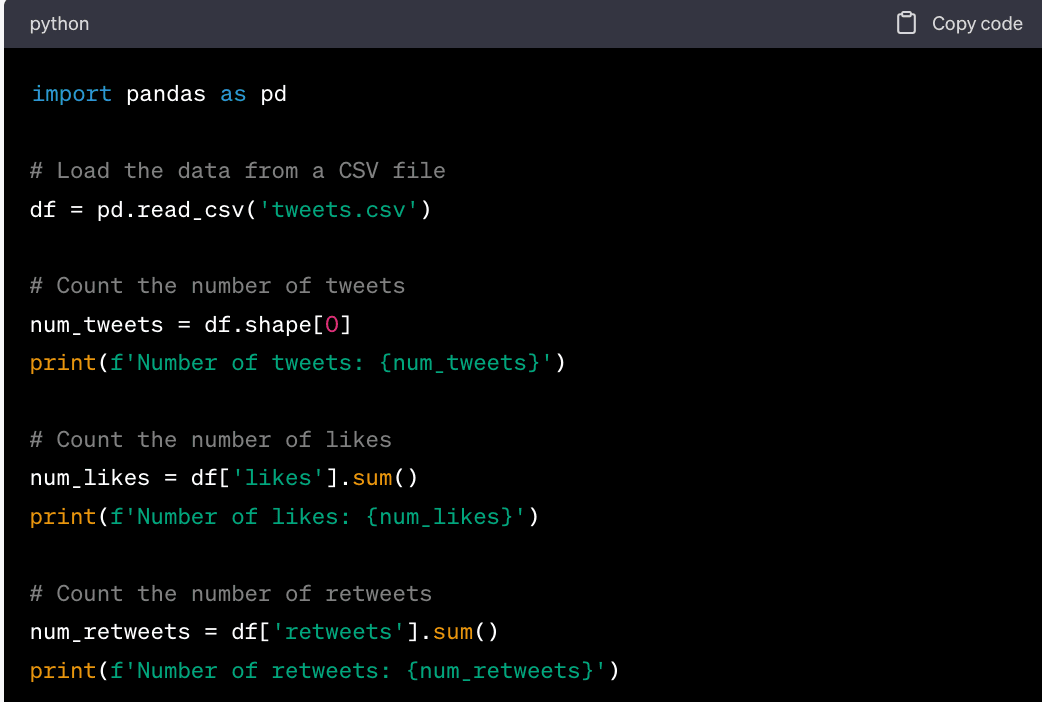
Die grundlegende Analyse umfasst das Zählen von Tweets, Likes, Retweets und anderen einfachen Kennzahlen. Hier ist ein Beispiel dafür, wie man dies mit pandas, einer leistungsstarken Datenanalyse-Bibliothek für Python, umsetzt:
2. Stimmungsanalyse
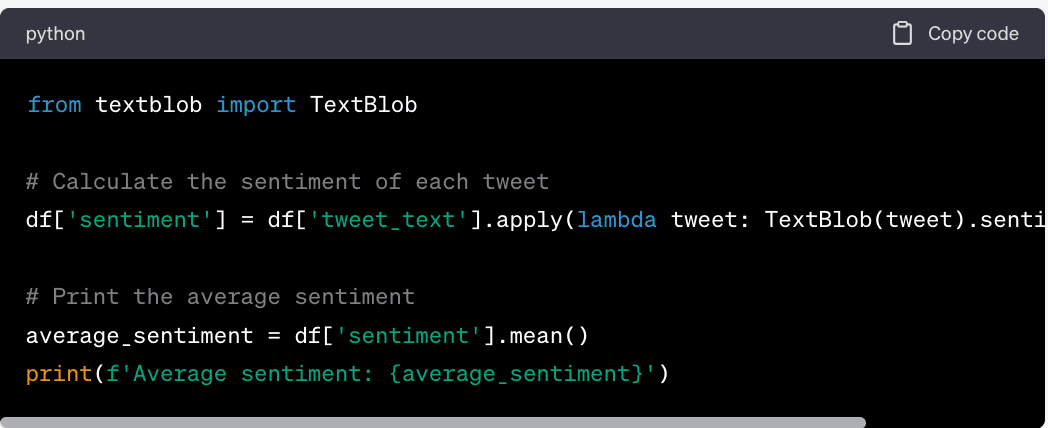
Bei der Stimmungsanalyse wird die Stimmung eines Textes, beispielsweise eines Tweets, ermittelt. Hier ist ein Beispiel dafür, wie dies mit TextBlob, einer Bibliothek zur Verarbeitung von Textdaten, durchgeführt werden kann:
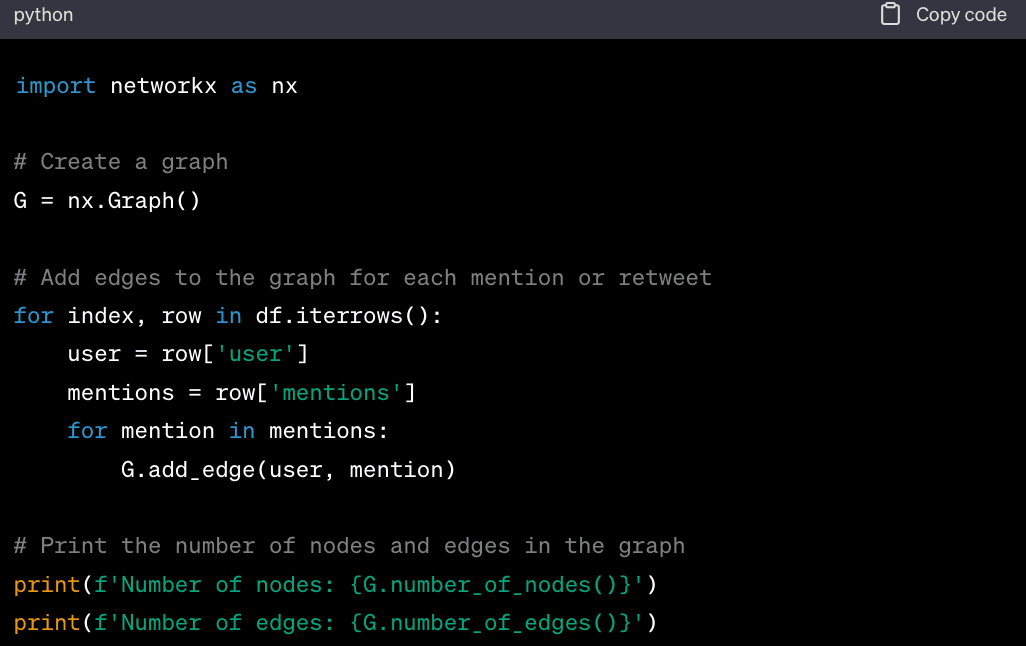
3. Netzwerkanalyse
Bei der Netzwerkanalyse werden die Verbindungen zwischen Twitter-Nutzern analysiert. Dies kann mit NetworkX erfolgen, einer Python-Bibliothek zur Erstellung, Bearbeitung und Untersuchung der Struktur, Dynamik und Funktionen komplexer Netzwerke.
4. Visualisierung von Twitter-Daten
Die Visualisierung von Twitter-Daten kann Ihnen helfen, diese besser zu verstehen. Dies lässt sich mit Matplotlib bewerkstelligen, einer Plotting-Bibliothek für Python:
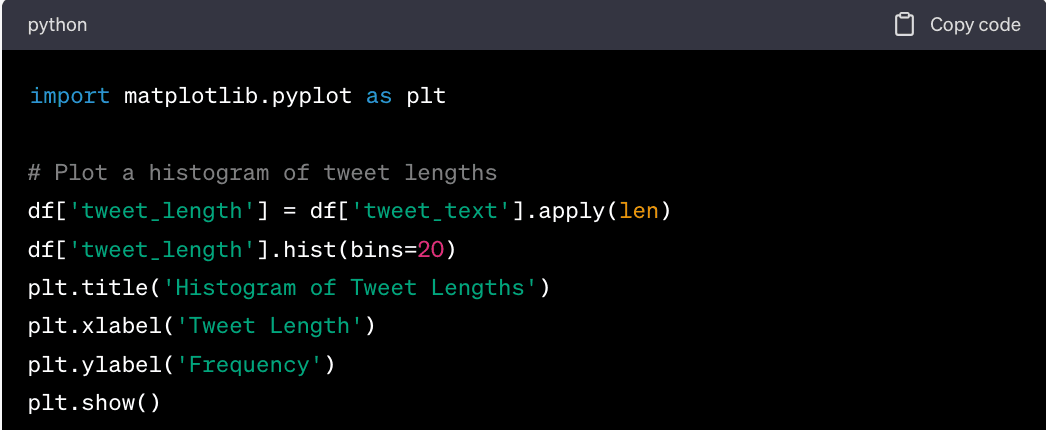
In diesem Code berechnen wir zunächst die Länge jedes Tweets. Anschließend erstellen wir ein Histogramm der Tweet-Längen, das die Verteilung der Tweet-Längen zeigt.
Denken Sie daran, „tweets.csv“ durch den Pfad zu Ihrer CSV-Datei und „tweet_text“, „likes“ sowie „retweets“ durch die tatsächlichen Spaltennamen in Ihrem DataFrame zu ersetzen. Ersetzen Sie außerdem „user“ und „mentions“ durch die tatsächlichen Spaltennamen für „user“ und „mentions“ in Ihrem DataFrame.

