Was ist Datenextraktion?
Bei der Datenextraktion werden Informationen aus Websites, Datenbanken und Dokumenten gewonnen. Laut IDC macht das wachsende Datenvolumen, das bis 2025 voraussichtlich 175 Zettabyte erreichen wird, die Datenextraktion unverzichtbar. Aus diesem Grund automatisieren viele Unternehmen ihren Workflow zur Datenextraktion mithilfe von Web-Scraping-APIs, da sie so große Datenmengen effizient erfassen, verarbeiten und analysieren können. Durch Web-Scraping können Unternehmen problemlos auf die Daten zugreifen und diese analysieren, die sie benötigen, um in der heutigen datengesteuerten Welt fundiertere Entscheidungen zu treffen und Wachstum sowie Erfolg zu erzielen.
Datenextraktion mithilfe von ETL
Extraktion, Transformation und Laden (ETL) ist ein Verfahren zur Integration und Verwaltung großer Datenmengen aus verschiedenen Quellen. Es wird häufig bei der Datenextraktion und beim Web-Scraping eingesetzt, um Daten für die Analyse zu sammeln, zu bereinigen und zu organisieren.
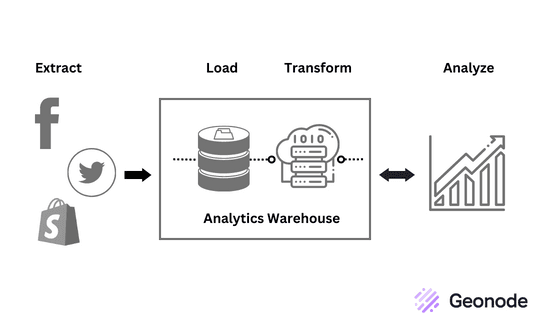
Der ETL-Prozess umfasst drei Hauptphasen:
-
Extraktion: In der ersten Phase werden Daten aus verschiedenen Quellen wie Datenbanken, Dateien oder APIs extrahiert oder abgerufen. Die extrahierten Daten können strukturiert, semistrukturiert oder unstrukturiert sein.
-
Transformation: In der zweiten Phase werden die extrahierten Daten in ein für das Zielsystem geeignetes Format umgewandelt, beispielsweise für ein Data Warehouse oder ein Berichtstool. Diese Phase umfasst die Datenbereinigung, Filterung, Aggregation und Anreicherung, um Konsistenz und Genauigkeit zu gewährleisten. Zudem werden die Daten in ein leicht verständliches Standardformat konvertiert.
-
Laden: In der letzten Phase werden die transformierten Daten zur weiteren Analyse und Verarbeitung in das Zielsystem geladen. Die Daten werden in eine Datenbank oder ein Data Warehouse geladen, wo sie von anderen Anwendungen problemlos abgefragt und analysiert werden können.
Datenextraktion ohne ETL
Zwar kann die Datenextraktion auch außerhalb des ETL-Prozesses erfolgen, doch weist diese Vorgehensweise Einschränkungen auf und muss entsprechend eingesetzt werden. Werden beispielsweise Rohdaten ohne ordnungsgemäße Transformation und Laden extrahiert, kann ihre Organisation und Analyse schwierig sein, und sie sind möglicherweise nicht mit neueren Programmen und Anwendungen kompatibel. Folglich könnten diese Daten außer für Archivierungszwecke nur einen begrenzten Wert haben.
Dennoch ist die Datenextraktion ohne ETL nach wie vor eine hervorragende Option für Unternehmen, die schnell auf Daten aus mehreren Quellen zugreifen müssen. Sie ist zudem eine kostengünstige Lösung, da teure ETL-Software und -Hardware entfallen.
Zudem können damit Daten schnell und einfach von einem System in ein anderes übertragen werden, ohne dass komplexe Transformationen erforderlich sind.
Je nach Ihren Anforderungen und verfügbaren Ressourcen stehen Ihnen mehrere alternative Datenextraktionstechniken zur Verfügung, die nicht auf traditionelles ETL basieren.
Change Data Capture (CDC)
Change Data Capture (CDC) ist eine ETL-Methode, bei der Änderungen an Daten in einem Quellsystem zur Analyse erfasst und gespeichert werden. Im Gegensatz zum herkömmlichen ETL, das ganze Datensätze extrahiert, erfasst CDC nur die Änderungen, die seit der letzten Extraktion an den Daten vorgenommen wurden. Dies macht es zu einer effizienteren Methode zur Datenextraktion.
Application Programming Interface (API)
Eine weitere Methode zur Datenextraktion ohne ETL ist die API (Application Programming Interface). APIs sind eine Reihe von Protokollen und Werkzeugen zur Entwicklung von Softwareanwendungen. Mit APIs können Entwickler Daten programmgesteuert aus einem Quellsystem extrahieren und in ihren Anwendungen zur Verfügung stellen.
Viele beliebte Anwendungen, wie beispielsweise Google Maps und Twitter, stellen APIs zur Verfügung, die zur Datenextraktion genutzt werden können.
Web-Scraping
Web-Scraping ist eine weitere Methode zur Datenextraktion ohne ETL. Dabei werden automatisierte Skripte verwendet, um Daten aus Webseiten zu extrahieren. Obwohl Web-Scraping einige Einschränkungen aufweist – beispielsweise ist es anfällig für Änderungen in der Struktur der Webseite –, kann es ein leistungsstarkes Werkzeug zur Datenextraktion aus Websites sein.
Zwar ist ETL die am häufigsten verwendete Methode zur Datenextraktion, doch können alternative Methoden ebenso effektiv sein. Change Data Capture, APIs und Web-Scraping sind allesamt praktikable Optionen, um Informationen aus verschiedenen Quellen zu extrahieren. Es ist unerlässlich, zu prüfen, welche Methode für einen bestimmten Anwendungsfall am besten geeignet ist, und sich über die neuesten Techniken und Technologien auf dem Laufenden zu halten, um die für Ihre Anforderungen optimale Lösung zu finden.
Lesen Sie auch: Den Unterschied zwischen einem Web-Scraper und einem Web-Crawler kennenlernen
Vorteile der Datenextraktion
Reduziert menschliche Fehler
Die Datenextraktion automatisiert den Prozess der Datenerfassung und minimiert so das Risiko von Fehlern, die bei der manuellen Dateneingabe auftreten können. Dadurch werden die Genauigkeit und Konsistenz der Daten verbessert.
Steigert die Produktivität
Durch die Datenextraktion gewinnen Mitarbeiter Zeit, um sich auf andere Aufgaben zu konzentrieren, was ihre Produktivität erhöht. Der Prozess ist zudem schneller als die manuelle Dateneingabe, sodass Unternehmen mehr Daten in kürzerer Zeit verarbeiten können.
Ermöglicht bessere Geschäftsentscheidungen
Die Datenextraktion verschafft Unternehmen Zugang zu einer Fülle von Informationen und ermöglicht es ihnen, datengestützte Entscheidungen zu treffen. Dies führt zu einem besseren Kundenservice, verbesserten Produkten und Dienstleistungen sowie höheren Umsätzen.
Schafft Transparenz
Die Datenextraktion schafft Transparenz in den Geschäftsabläufen und ermöglicht es Unternehmen, Ineffizienzen, Wachstumschancen und Verbesserungsmöglichkeiten zu identifizieren.
Vereinfacht den Datenaustausch
Die Datenextraktion ermöglicht es Unternehmen, Daten problemlos zwischen Abteilungen und externen Stakeholdern auszutauschen, was die Zusammenarbeit und Kommunikation verbessert.
Kosteneffizient
Die Datenextraktion ist eine kosteneffiziente Lösung für Unternehmen, da sie die manuelle Dateneingabe überflüssig macht und die Wahrscheinlichkeit von Fehlern verringert, die kostspielig sein können.
Zeitsparend
Die Datenextraktion automatisiert die Erfassung und Verarbeitung von Daten und spart Unternehmen wertvolle Zeit, sodass sie sich auf andere wichtige Aufgaben konzentrieren können.
Datenextraktion: Anwendungsbeispiele aus der Praxis
Die Datenextraktion findet in verschiedenen Branchen zahlreiche praktische Anwendungsfälle. Hier sind einige der häufigsten Anwendungsbeispiele für die Datenextraktion:
Reputationsüberwachung
Unternehmen müssen ihre Online-Reputation überwachen, um ihre Marke zu schützen. Die Datenextraktion hilft dabei, Erwähnungen der Marke zu verfolgen, negative Bewertungen zu identifizieren und Kundenfeedback zu sammeln, um das Image der Marke zu verbessern.
Marktforschung
Die Datenextraktion hilft Unternehmen dabei, Daten zu Markttrends, Verbraucherverhalten und Brancheneinblicken zu sammeln. Diese werden genutzt, um fundierte Entscheidungen über Produktentwicklung, Marketingstrategien und Geschäftsausweitung zu treffen.
Finanzdaten
Finanzinstitute nutzen die Datenextraktion, um Daten aus verschiedenen Quellen – darunter Jahresabschlüsse, Nachrichtenartikel und Marktberichte – zu sammeln und zu analysieren, um fundierte Investitionsentscheidungen zu treffen und Markttrends zu erkennen.
Lead-Generierung
Die Datenextraktion hilft bei der Generierung von Leads, indem Kontaktinformationen und andere relevante Daten aus Social-Media-Profilen, Unternehmenswebsites und anderen Online-Quellen gesammelt werden.
Inhaltsaggregation
Um umfassende und aktuelle Nachrichtenbeiträge zu erstellen, nutzen Nachrichten- und Medienunternehmen die Datenextraktion, um Informationen aus verschiedenen Quellen wie Nachrichtenartikeln, Blogbeiträgen und sozialen Medien zu sammeln.
Stimmungsanalyse
Unternehmen nutzen die Datenextraktion, um die Kundenstimmung zu beobachten, indem sie Kommentare, Bewertungen und Rückmeldungen sammeln und analysieren. Dies hilft Unternehmen dabei, ihre Produkte und Dienstleistungen zu verbessern und bessere Kundenbeziehungen aufzubauen.
Preisinformationen
Einzelhändler nutzen die Datenextraktion, um Informationen über die Preise, Werbeaktionen und Rabatte der Konkurrenz zu sammeln, um ihre eigenen Preisstrategien anzupassen und sich einen Wettbewerbsvorteil zu verschaffen.
Arbeitsmarktanalyse
Personalvermittlungsagenturen und Jobbörsen nutzen die Datenextraktion, um Informationen zu Stellenanzeigen, Stellenbeschreibungen und erforderlichen Qualifikationen zu sammeln. So helfen sie Arbeitssuchenden dabei, relevante Stellenangebote zu finden, und Arbeitgebern, potenzielle Kandidaten zu identifizieren.
Social-Media-Analyse
Social-Media-Plattformen nutzen die Datenextraktion, um das Nutzerverhalten und die Präferenzen zu analysieren, Influencer zu identifizieren und den Nutzern personalisierte Empfehlungen zu geben.
Reisebranche
Reisebüros und Buchungsplattformen nutzen die Datenextraktion, um Informationen über Flüge, Hotels und Reiseziele zu sammeln, wodurch sie ihren Kunden personalisiertere Reisepakete anbieten können.
Verschiedene Arten extrahierter Daten
Bei der Datenextraktion können je nach Art der Daten und Zweck der Extraktion verschiedene Arten von Daten extrahiert werden. Sehen wir uns einige der Arten von Daten an, die im Rahmen des Datenextraktionsprozesses extrahiert werden.
Unstrukturierte Daten
Unstrukturierte Daten sind Daten, die nicht nach einem vordefinierten Schema organisiert sind, wie beispielsweise E-Mails, Social-Media-Beiträge oder Textdokumente. Die Analyse unstrukturierter Daten kann eine Herausforderung darstellen, da sie keine einheitliche Struktur aufweisen.
Mithilfe von Techniken der natürlichen Sprachverarbeitung lassen sich unstrukturierte Daten jedoch in ein strukturiertes Format umwandeln, was die Analyse und Entscheidungsfindung vereinfacht.
Strukturierte Daten
Strukturierte Daten hingegen sind auf vordefinierte Weise organisiert, beispielsweise in einer Tabellenkalkulation oder einer Datenbank. Strukturierte Daten lassen sich leichter analysieren, da sie eine einheitliche Struktur aufweisen, was das Durchsuchen, Filtern und Aggregieren erleichtert.
Strukturierte Daten lassen sich weiter in verschiedene Datentypen unterteilen, wie beispielsweise Kunden-, Finanz- und Betriebsdaten.
Kundendaten
Kundendaten umfassen Informationen über Kunden, wie beispielsweise deren demografische Merkmale, Kaufhistorie und Präferenzen. Kundendaten werden genutzt, um die Kundenbindung zu verbessern, gezielte Marketingkampagnen zu entwickeln und das Kundenerlebnis zu optimieren.
Beispiele für Quellen von Kundendaten sind Kundenumfragen, Aktivitäten in sozialen Medien und Website-Analysen.
Finanzdaten
Finanzdaten beziehen sich auf Informationen im Zusammenhang mit den Finanzen eines Unternehmens, wie beispielsweise Umsatz, Ausgaben und Gewinnmargen. Finanzdaten werden verwendet, um die finanzielle Leistung zu verfolgen, Bereiche für Kosteneinsparungen zu identifizieren und fundierte finanzielle Entscheidungen zu treffen.
Beispiele für Quellen von Finanzdaten sind Buchhaltungssoftware, Jahresabschlüsse und Transaktionsdaten.
Betriebsdaten
Betriebsdaten beziehen sich auf Informationen zum täglichen Geschäftsbetrieb eines Unternehmens, wie beispielsweise Lagerbestände, Produktionsleistung und Kundenservice-Kennzahlen. Betriebsdaten werden genutzt, um Bereiche für Prozessverbesserungen zu identifizieren, die Ressourcenzuweisung zu optimieren und die Gesamteffizienz zu steigern.
Zu den Quellen für Betriebsdaten zählen Sensoren an Fertigungsanlagen, Kassensysteme und Helpdesk-Software.
Bei der Datenextraktion können verschiedene Arten von Daten gewonnen werden, darunter unstrukturierte und strukturierte Daten. Die Extraktion und Analyse dieser Datentypen kann Unternehmen wertvolle Erkenntnisse liefern, um fundierte Entscheidungen zu treffen und den Geschäftserfolg voranzutreiben.
Techniken zur Datenextraktion
Im Bereich Data Warehousing gibt es zwei Hauptarten von Extraktionsmethoden: die logische Extraktion und die physische Extraktion.
Logische Extraktion
Die logische Extraktion ist eine Methode der Datenextraktion, bei der logische Regeln und Transformationen verwendet werden, um Daten aus verschiedenen Quellen zu extrahieren und sie in einem Data Warehouse in ein einheitliches Format zu integrieren. Bei der logischen Extraktion gibt es drei Hauptmethoden: Aktualisierungsbenachrichtigung, inkrementelle Extraktion und vollständige Extraktion.
Aktualisierungsbenachrichtigung
Bei dieser Methode werden nur die Daten extrahiert, die im Quellsystem seit der letzten Extraktion aktualisiert wurden. Das Quellsystem benachrichtigt das Data Warehouse über die Änderungen, und es werden ausschließlich die aktualisierten Daten extrahiert. Dies ist vorteilhaft, wenn eine Datenintegration in Echtzeit erforderlich ist und für die Analyse nur die aktuellsten Daten benötigt werden.
Inkrementelle Extraktion
Hierbei werden nur die Daten extrahiert, die im Quellsystem seit der letzten Extraktion hinzugefügt, aktualisiert oder gelöscht wurden. Die Extraktion basiert auf einem Zeitstempel oder einem Flag, das angibt, wann die Daten zuletzt geändert wurden. Diese Methode wird häufig verwendet, wenn es um ein erhebliches Datenvolumen geht und es nicht praktikabel ist, jedes Mal alle Daten zu extrahieren.
Vollständige Extraktion
Bei der vollständigen Extraktion werden alle Daten aus dem Quellsystem extrahiert, unabhängig davon, ob sie sich seit der letzten Extraktion geändert haben oder nicht. Wenn das Datenvolumen gering ist oder das Quellsystem relativ stabil ist und das Data Warehouse eine vollständige Kopie der Quelldaten benötigt, ist die vollständige Extraktion die erste Wahl.
Physische Extraktion
Die physische Extraktion hingegen ist eine weitere Methode der Datenextraktion im Data Warehousing, bei der Daten physisch vom Quellsystem in das Data Warehouse kopiert oder verschoben werden. Bei der physischen Extraktion gibt es zwei Hauptmethoden: die Online-Extraktion und die Offline-Extraktion.
Online-Extraktion
Bei der Online-Extraktion werden Daten aus dem Quellsystem extrahiert, während dieses noch in Betrieb ist. Dies ist sinnvoll, wenn die Daten in Echtzeit benötigt werden und das Quellsystem nicht offline geschaltet werden kann. Der Extraktionsprozess kann jedoch die Leistung des Quellsystems beeinträchtigen, was bei der Wahl dieser Methode unbedingt zu berücksichtigen ist.
Offline-Extraktion
Hierbei werden Daten aus dem Quellsystem extrahiert, wenn dieses nicht in Betrieb ist. Diese Methode wird häufig eingesetzt, wenn die Daten in Zeiten geringer Auslastung extrahiert werden können oder wenn die Daten nicht in Echtzeit extrahiert werden müssen. Der Extraktionsprozess hat keine Auswirkungen auf die Leistung des Quellsystems, was im Vergleich zur Online-Extraktion ein großer Vorteil ist.
Insgesamt haben diese Methoden ihre Vor- und Nachteile. Die Wahl einer Methode hängt von den spezifischen Anforderungen Ihres Unternehmens und der Art der zu extrahierenden Daten ab. Durch die sorgfältige Auswahl der geeigneten Methode wird sichergestellt, dass die Daten in Ihrem Data Warehouse korrekt, aktuell und für die Analyse verfügbar sind.
Datenextraktion vs. Data Mining
Genau wie die Datenextraktion ist auch das Data Mining ein entscheidender Schritt bei der Analyse und Nutzung großer Datenmengen. Obwohl beide Verfahren dazu dienen, wertvolle Erkenntnisse und Wissen aus Daten zu gewinnen, gibt es erhebliche Unterschiede zwischen den beiden.
Datenextraktion
Datenextraktion ist der Prozess, bei dem Daten aus verschiedenen Quellen extrahiert und an einem zentralen Ort, beispielsweise in einem Data Warehouse, zusammengeführt werden.
Dazu gehört die Identifizierung der relevanten Datenquellen, die Anwendung von Techniken zur Datenbereinigung und -transformation sowie das Laden der Daten in eine zentralisierte Datenbank. Das Ziel der Datenextraktion ist es, eine vollständige und genaue Kopie der Daten zu erstellen, auf die leicht zugegriffen und die leicht analysiert werden kann.
Data Mining
Data Mining hingegen ist der Prozess der Entdeckung von Mustern, Trends und Erkenntnissen in den extrahierten Daten.
Dieser Prozess umfasst den Einsatz statistischer Analysen und Techniken des maschinellen Lernens, um Korrelationen, Klassifizierungen und andere Informationen zu identifizieren, die fundierte geschäftliche Entscheidungen ermöglichen.
Data Mining zielt darauf ab, Rohdaten in verwertbares Wissen umzuwandeln und dieses zur Verbesserung der Unternehmensleistung sowie zur Erlangung eines Wettbewerbsvorteils zu nutzen.
Einfach ausgedrückt ist die Datenextraktion der Prozess, bei dem Daten aus verschiedenen Quellen gewonnen und an einem Ort zusammengeführt werden. Im Gegensatz dazu analysiert Data Mining diese Daten, um aussagekräftige Muster und Erkenntnisse zu finden.
Beides sind wesentliche Schritte der Datenanalyse und werden oft gemeinsam eingesetzt, um einen umfassenden Überblick über die Daten eines Unternehmens zu gewinnen.
Durch den Einsatz dieser Techniken können Unternehmen wertvolle Erkenntnisse über ihre Kunden, ihre Geschäftsabläufe und Markttrends gewinnen, was ihnen hilft, bessere Entscheidungen zu treffen und der Konkurrenz einen Schritt voraus zu sein.
Verschiedene Arten von Datenextraktions-Tools
Datenextraktions-Tools sind Softwareanwendungen, die das Extrahieren von Daten aus verschiedenen Quellen und deren Zusammenführung an einem zentralen Ort, wie beispielsweise einem Data Warehouse, erleichtern. Diese Tools sind darauf ausgelegt, den Datenextraktionsprozess zu automatisieren und ihn effizienter und genauer zu gestalten.
Auf dem Markt sind verschiedene Arten von Datenextraktions-Tools erhältlich, die jeweils ihre eigenen Funktionen und Vorteile bieten. Im Folgenden werden drei gängige Arten vorgestellt:
Tools zur Stapelverarbeitung
Diese Tools sind dafür ausgelegt, Daten aus großen Mengen von Dateien oder Dokumenten im Batch-Modus zu extrahieren. Batch-Verarbeitungs-Tools sind hilfreich, wenn Sie Daten aus mehreren Dateien oder ähnlich strukturierten Dokumenten extrahieren müssen.
Beispiele für Batch-Verarbeitungs-Tools sind Talend Open Studio, Apache NiFi und Alteryx.
Open-Source-Tools
Diese Softwareanwendungen sind kostenlos erhältlich und können von den Nutzern angepasst und individuell gestaltet werden. Open-Source-Tools zur Datenextraktion sind beliebt bei kleinen und mittleren Unternehmen mit begrenztem Budget sowie bei denen, die sich teure kommerzielle Software nicht leisten können.
Beispiele für Open-Source-Tools zur Datenextraktion sind Apache Kafka, Apache Flume und Pentaho Data Integration.
Cloud-basierte Tools
Cloud-basierte Tools werden in der Cloud gehostet und sind über einen Webbrowser zugänglich. Sie können cloud-basierte Datenextraktions-Tools nutzen, wenn Sie Daten aus entfernten Quellen extrahieren müssen oder wenn Sie mit anderen Teammitgliedern an verschiedenen geografischen Standorten zusammenarbeiten möchten.
Beispiele für cloudbasierte Datenextraktions-Tools sind AWS Glue, Azure Data Factory und Google Cloud Dataflow.
Datenextraktions-Tools sind ein wesentlicher Bestandteil des Datenanalyseprozesses, da sie Unternehmen dabei helfen, Daten aus verschiedenen Quellen zu konsolidieren und zu analysieren. Denken Sie daran, dass die Wahl des richtigen Datenextraktions-Tools einen großen Unterschied hinsichtlich der Effizienz und Genauigkeit Ihrer Datenanalysebemühungen ausmachen kann.
Die besten Tools zur Datenextraktion
Tools zur Datenextraktion gibt es in vielen verschiedenen Formen und Ausführungen. Ganz gleich, ob Sie Daten aus Websites, Dokumenten oder Social-Media-Plattformen extrahieren möchten – es gibt ein passendes Tool, mit dem Sie den Prozess automatisieren und wertvolle Erkenntnisse aus Ihren Daten gewinnen können.
Scrapestorm
Scrapestorm ist ein Web-Scraping-Tool, mit dem Nutzer Daten aus verschiedenen Websites extrahieren können. Es wurde entwickelt, um den Prozess des Web-Scrapings zu automatisieren, und erleichtert auch Nutzern ohne Programmierkenntnisse das Abrufen von Daten. Scrapestorm kann Daten aus Tabellen, Diagrammen und Karten sowie aus PDF-Dateien und Bildern extrahieren. Dank seiner benutzerfreundlichen Oberfläche und flexiblen Anpassungsmöglichkeiten ist es eine beliebte Wahl für Unternehmen jeder Größe.
Altair Monarch
Altair Monarch ist ein Tool zur Datenextraktion, mit dem Nutzer Daten aus verschiedenen Quellen extrahieren können, darunter PDF-Dateien, Tabellenkalkulationen und Datenbanken. Es nutzt Algorithmen des maschinellen Lernens, um Daten aus unstrukturierten Dokumenten automatisch zu identifizieren und zu extrahieren, was den manuellen Aufwand für die Datenextraktion reduziert. Daher eignet sich Altair Monarch besonders für Unternehmen, die regelmäßig Daten aus großen Dokumentenmengen extrahieren.
Klippa
Als OCR-basiertes Tool zur Datenextraktion automatisiert Klippa die Dokumentenverarbeitung. Es kann Daten aus verschiedenen Dokumenten wie Rechnungen, Belegen und Verträgen extrahieren. Dabei nutzt es Algorithmen des maschinellen Lernens, um Daten aus diesen Dokumenten zu erkennen und zu extrahieren, und exportiert die extrahierten Daten in verschiedene Formate wie Excel, JSON und XML. Klippa ist besonders nützlich für Unternehmen, die in kurzer Zeit Daten aus großen Dokumentenmengen extrahieren müssen.
NodeXL
NodeXL ist ein Tool zur Datenanalyse und -visualisierung für soziale Netzwerke. Es ermöglicht Nutzern, Daten aus verschiedenen Social-Media-Plattformen wie Twitter, Facebook und LinkedIn zu extrahieren und in Grafiken und Diagrammen zu visualisieren. NodeXL eignet sich besonders gut für Unternehmen, die das Social-Media-Verhalten ihrer Kunden und Wettbewerber analysieren müssen. Aufgrund seiner benutzerfreundlichen Oberfläche und seiner erweiterten Funktionen ist es bei vielen Unternehmen beliebt.
Was macht die Datenextraktion so schwierig?
Obwohl die Datenextraktion ein wesentlicher Bestandteil des Datenanalyseprozesses ist, bringt sie doch einige Herausforderungen mit sich, die es Unternehmen erschweren können, Daten effektiv zu extrahieren und zu nutzen. Im Folgenden sind einige der größten Herausforderungen bei der Datenextraktion aufgeführt:
Probleme bei der Datenformatierung
Daten können in verschiedenen Formaten und Strukturen vorliegen, was ihre Extraktion und Standardisierung erschwert. Sie können unvollständig oder inkonsistent sein oder Fehler enthalten, was eine umfangreiche Datenbereinigung und -transformation erforderlich macht.
Bedenken hinsichtlich der Datensicherheit
Die Datenextraktion kann Sicherheitsrisiken mit sich bringen, wenn es sich um sensible oder vertrauliche Informationen handelt. Unternehmen müssen geeignete Maßnahmen ergreifen, um sicherzustellen, dass die Daten während der Extraktion und Übertragung geschützt sind.
Technische Einschränkungen
Die Datenextraktion kann eine Herausforderung darstellen, wenn die Daten in Altsystemen oder unterschiedlichen Datenquellen gespeichert sind. Für die Extraktion und Integration aus mehreren Quellen sind unter Umständen spezielle technische Kenntnisse oder Softwaretools erforderlich.
Einhaltung gesetzlicher Vorschriften
Die Datenextraktion muss gesetzlichen und regulatorischen Anforderungen entsprechen, beispielsweise Datenschutzgesetzen wie der DSGVO und dem CCPA. Die Nichteinhaltung dieser Vorschriften kann zu hohen Geldstrafen und Reputationsschäden führen.
Um diese Herausforderungen zu meistern, ist ein strategischer Ansatz bei der Datenextraktion erforderlich, einschließlich des Einsatzes fortschrittlicher Tools und Techniken sowie eines Bekenntnisses zu Datenqualität und -sicherheit. Indem sie diese Herausforderungen angehen, können Unternehmen das volle Potenzial ihrer Daten ausschöpfen und sich einen Wettbewerbsvorteil auf dem Markt verschaffen.
Bewährte Verfahren für die Datenextraktion
Die Datenextraktion ist ein entscheidender Schritt bei der Datenanalyse. Daher ist es unerlässlich, bewährte Verfahren zu befolgen, um Genauigkeit, Qualität und Erfolg zu gewährleisten.
Identifizieren Sie die Datenquellen
Beginnen Sie damit, alle relevanten Datenquellen zu identifizieren und die Struktur der Daten zu verstehen. So vermeiden Sie, dass wichtige Daten übersehen werden und Ressourcen für irrelevante Datenquellen verschwendet werden.
Daten bereinigen und vorverarbeiten
Um Genauigkeit und Konsistenz zu gewährleisten, sollten Sie die Daten vor der Extraktion bereinigen und vorverarbeiten. Durch die Bereinigung und Vorverarbeitung von Daten lassen sich Inkonsistenzen, Fehler und Ausreißer identifizieren und entfernen, die die Qualität der extrahierten Daten beeinträchtigen könnten.
Speichern und sichern Sie die Daten
Das Speichern und Sichern von Daten ist entscheidend, um sicherzustellen, dass die Daten zugänglich und sicher sind. Datenspeicherlösungen wie cloudbasierte Dienste bieten Flexibilität und Skalierbarkeit und können dazu beitragen, Daten vor Verlust oder Beschädigung zu schützen.
Sichern Sie die Daten
Implementieren Sie robuste Sicherheitsmaßnahmen wie Datenverschlüsselung, Zugriffskontrollen und regelmäßige Sicherheitsaudits. Datensicherheit sollte oberste Priorität haben, um sensible Daten zu schützen und Datenlecks zu verhindern.
Fazit
Die Datenextraktion kann eine Herausforderung darstellen, doch mit den richtigen Werkzeugen und Techniken ist sie auch für Anfänger einfach und zugänglich. In diesem Leitfaden für Einsteiger haben wir die Grundlagen der Datenextraktion behandelt – von der Definition des Begriffs bis hin zur Erörterung verschiedener Methoden und Werkzeuge für die Datenextraktion.
Die Zukunft der Datenextraktion ist spannend, da Fortschritte im Bereich des maschinellen Lernens und der künstlichen Intelligenz eine effizientere und genauere Datenextraktion aus verschiedenen Quellen ermöglichen. Da die Menge der verfügbaren Daten weiter wächst, werden sich Fragen stellen wie: Aus welchen Arten von Big Data können wir Wert schöpfen und wie? Daher wird die Beherrschung der Datenextraktion sowohl für Unternehmen als auch für Einzelpersonen zu einer immer wichtigeren Kompetenz werden.
Es ist entscheidend, an die Datenextraktion mit einem klaren Verständnis der Ziele und Anforderungen Ihres Projekts heranzugehen sowie mit der Bereitschaft, mit verschiedenen Werkzeugen und Methoden zu experimentieren, um herauszufinden, was am besten funktioniert. Wenn Sie die in diesem Leitfaden beschriebenen Tipps und Techniken befolgen, sind Sie auf dem besten Weg, wertvolle Daten erfolgreich zu extrahieren und zu nutzen.
Häufig gestellte Fragen – FAQs:
Was versteht man unter Datenextraktion?
Datenextraktion ist der Vorgang, bei dem Daten aus verschiedenen Quellen wie Datenbanken, Websites oder Anwendungen abgerufen und in ein für die Analyse nutzbares Format umgewandelt werden. Die extrahierten Daten können dann dazu verwendet werden, Erkenntnisse zu gewinnen und die Entscheidungsfindung zu unterstützen.
Was ist ein Beispiel für Datenextraktion?
Ein Beispiel für Datenextraktion ist das Scraping von Produktinformationen von einer E-Commerce-Website. Der Extraktionsprozess umfasst die Identifizierung der relevanten Datenfelder, wie Produktname, Preis und Beschreibung, sowie das Abrufen der Daten mithilfe von Web-Scraping-Tools oder APIs.
Wozu wird die Datenextraktion verwendet?
Die Datenextraktion dient dazu, Daten aus verschiedenen Quellen abzurufen, um verschiedene Geschäftsfunktionen wie Datenanalyse, Berichterstellung und Entscheidungsfindung zu unterstützen. Dies wird genutzt, um Erkenntnisse zu gewinnen, Vorhersagemodelle zu entwickeln und Geschäftsabläufe sowie Strategien zu verbessern.
Welche Techniken der Datenextraktion gibt es?
Es gibt verschiedene Techniken der Datenextraktion, wie beispielsweise Web-Scraping, API-Integration und Datenbankabfragen. Beim Web-Scraping werden Daten mithilfe automatisierter Tools von Websites extrahiert, während die API-Integration das Abrufen von Daten aus webbasierten Anwendungen ermöglicht. Bei Datenbankabfragen werden Daten mithilfe von SQL-Abfragen aus strukturierten Datenbanken abgerufen.
Quellenangaben
(26. Mai 2020). Techniken zur Datenextraktion. Rosoka.
https://www.rosoka.com/blog/data-extraction-techniques
(12. August 2022). Was ist der Unterschied zwischen Data Mining und Datenextraktion? AmyGB.ai.
https://www.amygb.ai/blog/difference-between-data-mining-and-data-extraction
(12. November 2022). Was ist Datenextraktion? Warum ist sie wichtig? The ECM Consultant.
https://theecmconsultant.com/what-is-data-extraction
(o. J.). ETL: Extrahieren, Transformieren, Laden. Talend.
https://www.talend.com/resources/what-is-etl/
(o. J.). Arten von ETL-Tools. Dremio.
https://www.dremio.com/resources/guides/adv-types-etl-tools/
(o. J.). Was sind APIs und wie funktionieren sie? MuleSoft.
https://www.mulesoft.com/api-university/what-are-apis-and-how-do-they-work
(o. J.). Was ist Change Data Capture (CDC)? Qlik.
https://www.qlik.com/us/change-data-capture/cdc-change-data-capture
(o. J.). Was ist Datenextraktion? Docparser.
https://docparser.com/blog/what-is-data-extraction/
(o. J.). Was ist ETL (Extract, Transform, Load)? Oracle.
https://www.oracle.com/ph/integration/what-is-etl/
Deshpande, I. (16. März 2021). Was sind Kundendaten? Definition, Arten, Erfassung, Validierung und Analyse. Spiceworks.
https://www.spiceworks.com/marketing/customer-data/articles/what-is-customer-data/
Eteng, O. (27. Januar 2023). Was ist Datenextraktion? Alles, was Sie wissen müssen. Hevo Data.
https://hevodata.com/learn/data-extraction/#usecase
Hillier, W. (13. August 2021). Was ist Web-Scraping und wie wird es eingesetzt? CareeerFoundry.
https://careerfoundry.com/en/blog/data-analytics/web-scraping-guide/
IBM Cloud Education (29. Juni 2021). Strukturierte vs. unstrukturierte Daten: Was ist der Unterschied? IBM.
https://www.ibm.com/cloud/blog/structured-vs-unstructured-data

