Immobiliare.it es una de las principales plataformas inmobiliarias online de Italia.
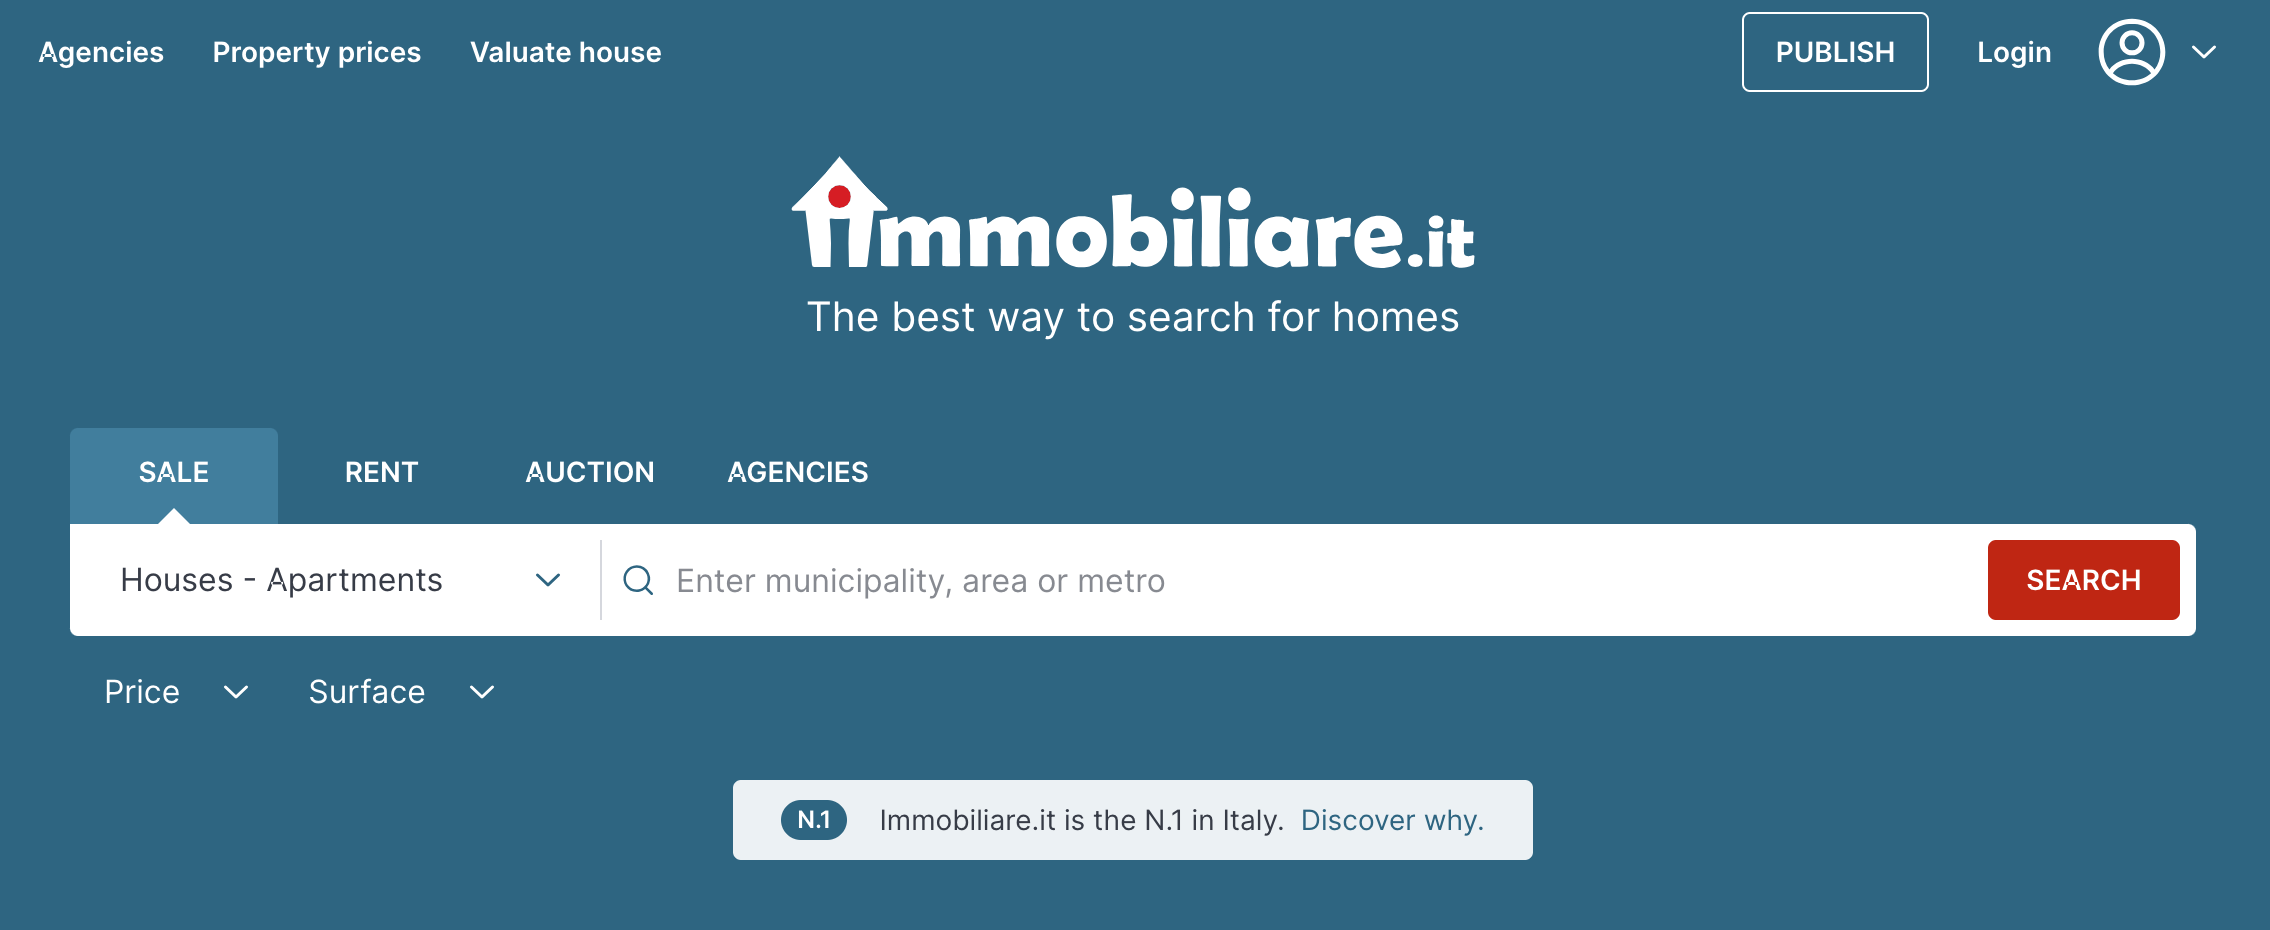
Con una amplia variedad de anuncios que incluyen inmuebles residenciales, comerciales y vacacionales, la página web constituye un recurso completo para cualquiera que desee invertir en el sector inmobiliario italiano.
Para los agentes inmobiliarios y compradores estadounidenses, Immobiliare.it ofrece una oportunidad única de acceder a un mercado diverso que, de otro modo, podría resultar complicado de explorar desde el extranjero.
La importancia de los datos inmobiliarios
En el sector inmobiliario, los datos lo son todo. Una información precisa y oportuna puede marcar la diferencia entre una inversión exitosa y un error costoso.
Para los agentes inmobiliarios y compradores estadounidenses, comprender el mercado italiano requiere una fuente de datos fiable.
Immobiliare.it ofrece esto en forma de listados de inmuebles, tendencias de precios, información sobre barrios y mucho más.
Los potentes filtros de búsqueda de la plataforma permiten a los usuarios acotar sus opciones en función de diversos criterios, como la ubicación, el tipo de inmueble y el rango de precios, lo que facilita la búsqueda de propiedades que se ajusten a objetivos de inversión específicos.
Casos de uso de los datos inmobiliarios de Immobiliare.it
-
Estudio de mercado. Los agentes inmobiliarios estadounidenses pueden utilizar los datos para comprender mejor el mercado inmobiliario italiano, identificando tendencias y oportunidades que podrían beneficiar a sus clientes.
-
Decisiones de inversión. Los compradores de inmuebles de Estados Unidos pueden utilizar Immobiliare.it para tomar decisiones de inversión bien fundamentadas. L
Los datos de la plataforma pueden ayudar a identificar propiedades infravaloradas, barrios en auge o alquileres vacacionales rentables.
-
Análisis comparativo. Los datos pueden utilizarse para comparar el mercado italiano con el estadounidense.
Esto resulta especialmente útil para los inversores que buscan diversificar su cartera a nivel internacional.
-
Servicios al cliente. Los agentes inmobiliarios pueden ofrecer servicios adicionales a sus clientes estadounidenses interesados en el mercado italiano, como informes y análisis personalizados basados en los datos de Immobiliare.it.
-
Estrategia de marketing. Al extraer datos de Immobiliare.it, las empresas pueden identificar las tendencias actuales en cuanto a características y ubicaciones de los inmuebles, lo que les ayuda a formular una estrategia de mercado más eficaz.
Este enfoque puede hacer que los sitios web inmobiliarios sean más competitivos en el mercado.
-
Análisis de precios. La extracción de datos sobre precios y el historial de precios de Immobiliare.it permite realizar un análisis exhaustivo de los precios.
Comprender las fluctuaciones de los precios de mercado, los precios más recientes y los precios actuales del mercado puede ayudar a las empresas y a los consumidores a tomar decisiones más informadas.
-
Información jurídica y normativa. Immobiliare.it suele publicar artículos y recursos que explican las leyes y normativas inmobiliarias de Italia, lo que puede resultar de gran valor para los inversores estadounidenses que no estén familiarizados con el panorama jurídico italiano.
Al aprovechar los datos y recursos disponibles en Immobiliare.it, los agentes inmobiliarios y los compradores de inmuebles estadounidenses pueden obtener una ventaja competitiva en un mercado que resulta a la vez desafiante y gratificante.
Consideraciones legales
A la hora de recopilar datos de plataformas en línea, es fundamental comprender el marco legal y ético para garantizar que se actúa dentro de los límites de la ley y se respetan los derechos de los titulares de los datos.
¿Es legal extraer datos de Immobiliare.it?
Antes de extraer datos de cualquier sitio web, es fundamental consultar su archivo robots.txt, que establece las normas para los rastreadores web.
El archivo robots.txt de Immobiliare.it incluye varias directivas «Disallow», que indican las áreas del sitio web que no deben ser objeto de scraping.
Por ejemplo, prohíbe el scraping de mapas de búsqueda, áreas de usuario y tipos específicos de anuncios, entre otras cosas.
El incumplimiento de estas normas podría dar lugar a la expulsión del sitio o a acciones legales.
Por lo tanto, es esencial respetar las directrices establecidas en el archivo robots.txt a la hora de plantearse cualquier actividad de recopilación de datos en Immobiliare.it.
Consideraciones éticas
Más allá de los aspectos legales, también entran en juego consideraciones éticas a la hora de extraer datos de sitios web.
La extracción ética de datos respeta tanto la letra como el espíritu de la ley, así como el archivo robots.txt del sitio web, que especifica las áreas del sitio que no deben ser objeto de extracción.
Además, el scraping ético implica no sobrecargar los servidores del sitio web, respetar la privacidad de los usuarios y utilizar los datos de forma responsable.
El incumplimiento de estas directrices éticas puede dañar tu reputación y también podría acarrear repercusiones legales.
Perspectivas sobre la legalidad del scraping web
A continuación se presentan tres artículos que abordan la legalidad del scraping web, junto con sus resúmenes:
El Tribunal de Apelación del Noveno Circuito de EE. UU. ha dictaminado que el scraping de datos de acceso público no constituye una infracción de la Ley de Fraude y Abuso Informático (CFAA). Esta sentencia es importante para archiveros, académicos, investigadores y periodistas que utilizan herramientas de scraping web.
Sin embargo, el artículo también menciona que ha habido casos en los que el web scraping ha suscitado preocupaciones en materia de privacidad y seguridad. El caso fue presentado inicialmente por LinkedIn contra Hiq Labs, una empresa que extraía perfiles de usuarios de LinkedIn. LinkedIn perdió el caso en 2019, y el Noveno Circuito reafirmó su decisión original.
Este artículo afirma que no existen leyes federales que prohíban el web scraping en Estados Unidos, siempre y cuando los datos extraídos estén disponibles públicamente.
Sin embargo, hace hincapié en la importancia de las consideraciones éticas y aconseja a quienes realizan web scraping que actúen dentro de los límites de las condiciones de uso y los archivos robots.txt de los sitios web.
El artículo explica que, según la mayoría de las leyes, es ilegal recopilar, utilizar o almacenar información de identificación personal (PII) sin el consentimiento explícito del titular.
También menciona que el web scraping puede entrar a veces en zonas grises legales, especialmente cuando implica la recopilación de información sensible.
Herramientas y tecnologías utilizadas para la recopilación de datos
En el ámbito del web scraping, existe una gran variedad de herramientas y tecnologías disponibles para satisfacer diferentes necesidades. Tanto si eres un principiante como un científico de datos con experiencia, es probable que haya una herramienta que se adapte a los requisitos de tu proyecto. A continuación, analizamos algunas de las herramientas más utilizadas. 
Bibliotecas de Python (BeautifulSoup, Selenium)
Python es un lenguaje muy popular para el web scraping y ofrece varias bibliotecas que facilitan el proceso:
-
BeautifulSoup: Se trata de una biblioteca de Python para extraer datos de archivos HTML y XML. Proporciona expresiones típicas de Python para iterar, buscar y modificar el árbol de análisis sintáctico.
BeautifulSoup se utiliza a menudo con fines de web scraping para extraer datos de páginas web y es relativamente fácil de aprender para los principiantes.
-
Selenium: A diferencia de BeautifulSoup, que solo extrae el código fuente, Selenium interactúa con la página web igual que lo haría un usuario humano.
Se utiliza a menudo para extraer datos de sitios web dinámicos en los que el contenido se carga mediante JavaScript, y también puede emplearse para pruebas automatizadas.
Ambas bibliotecas pueden utilizarse conjuntamente, lo que proporciona un potente conjunto de herramientas para cualquier proyecto de extracción de datos web.
Servicios de extracción de datos web
Los servicios de extracción de datos web ofrecen una alternativa práctica para quienes prefieren no adentrarse en la programación.
Estos servicios suelen contar con interfaces de usuario intuitivas que te permiten especificar qué datos quieres extraer, sin necesidad de escribir código alguno.
Se encargan de todo, desde la extracción de datos hasta su almacenamiento, lo que te facilita centrarte en el análisis y la utilización de los datos. P
Repositorios de GitHub como referencia
GitHub es un tesoro de recursos para el web scraping. Puedes encontrar numerosos repositorios que ofrecen scripts de scraping ya escritos, marcos de trabajo y tutoriales.
Estos son algunos tipos de repositorios que pueden resultarte útiles:
-
Repositorios de tutoriales. Estos repositorios proporcionan guías paso a paso y fragmentos de código para ayudarte a dar tus primeros pasos en el scraping web.
-
Repositorios de marcos de trabajo. Contienen marcos de trabajo ya creados, diseñados para extraer datos de tipos específicos de sitios web o datos.
-
Repositorios de proyectos. Se trata de proyectos completos que muestran tareas de scraping más complejas, que a menudo implican múltiples sitios web o tecnologías.
Al estudiar estos repositorios, podrás conocer las mejores prácticas y las técnicas avanzadas para el scraping web.
Guía paso a paso
Esta sección ofrece una guía completa sobre cómo recopilar datos de Immobiliare.it utilizando bibliotecas de Python y otras herramientas.
Sigue estos pasos para configurar tu entorno, escribir el código y encontrar ejemplos en GitHub para seguir aprendiendo.
Configuración del entorno
-
Instala Python. Si aún no lo has hecho, descarga e instala Python desde la página web oficial.
-
Instala las bibliotecas. Abre el terminal e instala BeautifulSoup y Selenium ejecutando los siguientes comandos: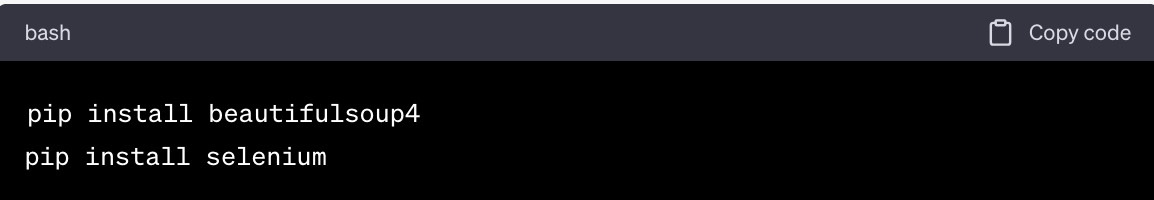
-
Controlador web. Descarga el controlador web compatible con tu navegador (por ejemplo, ChromeDriver para Chrome) y colócalo en el directorio de tu proyecto.
-
Clave API para Geonode. Si utilizas el rastreador de Pay-As-You-Go de Geonode, solicita una clave API en su página web.
Escribir el código para recopilar datos de Immobiliare.it
-
Importar bibliotecas. Importa las bibliotecas de Python necesarias al principio de tu script.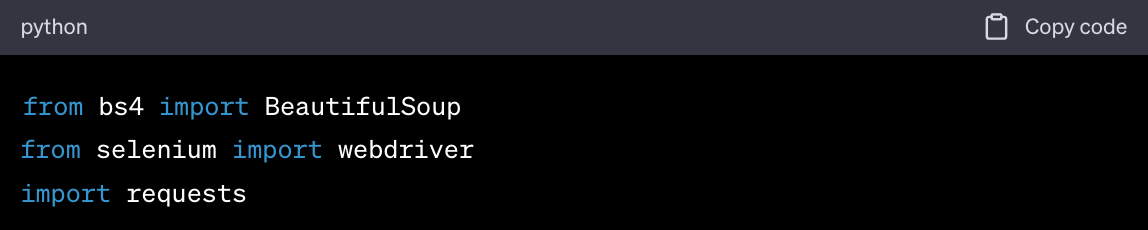
-
Inicializar WebDriver. Inicializa el Selenium WebDriver. 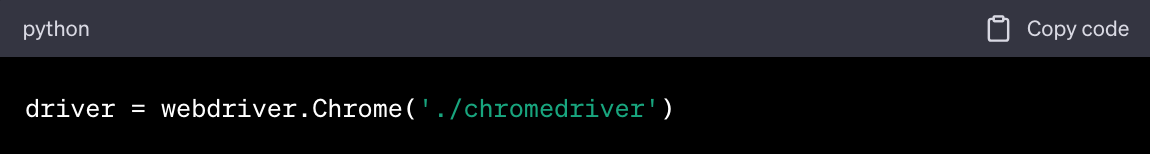
-
Acceder a Immobiliare.it. Utiliza WebDriver para acceder a la página web de Immobiliare.it de la que deseas extraer datos. 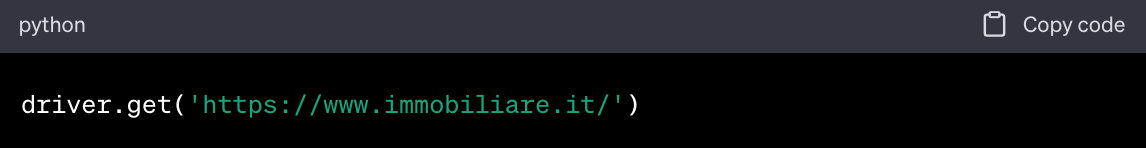
-
Localiza los elementos. Utiliza BeautifulSoup o las funciones de Selenium para localizar los elementos HTML que contienen los datos que deseas extraer.
-
Extrae los datos. Extrae los datos y guárdalos en una variable o en un archivo.
-
API deGeonode. Si utilizas Geonode, realiza una llamada a la API para gestionar proxies, navegadores y captchas.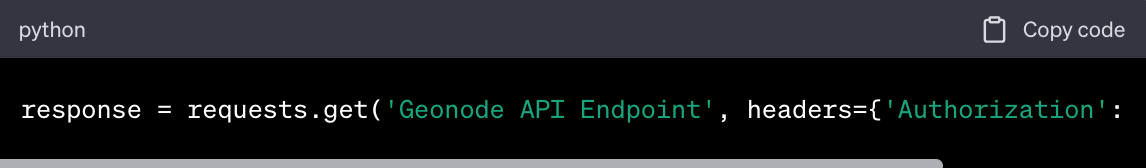
-
Cierra WebDriver. ¡No olvides cerrar WebDriver cuando hayas terminado! 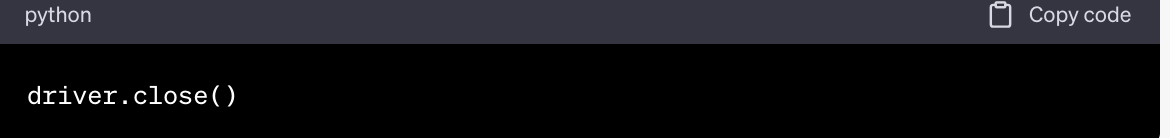
Ejemplos y tutoriales de GitHub
-
Busca repositorios. Utiliza la función de búsqueda de GitHub para encontrar repositorios relacionados con el web scraping con Python, BeautifulSoup y Selenium.
-
Estudia el código. Busca ejemplos diseñados específicamente para sitios web inmobiliarios o para Immobiliare.it.
-
Sigue los tutoriales. Algunos repositorios de GitHub ofrecen tutoriales paso a paso que pueden ayudarte a comprender mejor el código.
-
Clona y experimenta. No dudes en clonar repositorios y modificar el código para adaptarlo a tus necesidades específicas.
Técnicas avanzadas
A medida que te vayas familiarizando con las técnicas básicas de web scraping, es posible que surja la necesidad de abordar retos más complejos. En esta sección se describen algunas técnicas avanzadas que pueden ayudarte a afrontar estas situaciones más complicadas.
Gestión de sitios web dinámicos
Los sitios web dinámicos cargan el contenido de forma asíncrona, a menudo utilizando JavaScript. Esto puede hacer que el scraping resulte más complicado. A continuación se presentan algunas técnicas avanzadas para gestionar sitios web dinámicos:
-
Selenium WebDriver. Como se ha mencionado anteriormente, Selenium puede interactuar con páginas web dinámicas, lo que te permite extraer datos que se cargan mediante JavaScript.
-
Navegación sin interfaz gráfica (headless). Utiliza navegadores sin interfaz gráfica como PhantomJS o ejecuta Selenium en modo headless para extraer datos de sitios web sin abrir una ventana de navegador real.
-
Solicitudes AJAX. Algunos sitios web cargan datos mediante solicitudes AJAX. Puedes utilizar herramientas de desarrollo para inspeccionar estas solicitudes y replicarlas utilizando la biblioteca requests de Python.
-
Comandos de espera. Utiliza comandos de espera explícitos e implícitos en Selenium para asegurarte de que la página web se haya cargado por completo antes de extraer los datos.
Extracción de datos de agentes inmobiliarios
Extraer datos relacionados con agentes inmobiliarios puede resultar algo más complejo debido a la necesidad de precisión y a las consideraciones éticas que conlleva. A continuación, te ofrecemos algunos consejos:
-
Céntrate en secciones específicas. Utiliza BeautifulSoup o expresiones XPath para centrarte en secciones específicas de un sitio web donde se almacenen los datos de los agentes.
-
Paginación. Muchos sitios web muestran a los agentes en varias páginas. Asegúrate de que tu código pueda navegar por la paginación.
-
Limitación de frecuencia. Respeta los términos y condiciones del sitio web. Implementa una limitación de frecuencia en tu código para evitar sobrecargar sus servidores.
-
Validación de datos. Valida siempre los datos que hayas extraído para asegurarte de que sean precisos y completos.
Consejos de StackOverflow sobre cómo gestionar los cambios en el código
Los sitios web actualizan con frecuencia su estructura HTML, lo que puede hacer que tu código de extracción deje de funcionar. A continuación te explicamos cómo puedes adaptarte:
-
Actualizaciones periódicas: Mantente al tanto de los hilos de StackOverflow relacionados con el sitio web del que estás extrayendo datos. Los usuarios suelen compartir información sobre los cambios en la estructura de los sitios web.
-
Gestión de errores: Implementa una gestión de errores sólida en tu código para que te avise cuando falle el rastreo, lo que te permitirá actualizar tu código en consecuencia.
-
Consejos de la comunidad: StackOverflow es un lugar ideal para encontrar soluciones provisionales o métodos alternativos de rastreo cuando un sitio web cambia su estructura de código.
Al dominar estas técnicas avanzadas, estarás mejor preparado para afrontar una amplia gama de retos relacionados con el scraping web. Tanto si te enfrentas a contenido dinámico, datos especializados o estructuras de sitios web cambiantes, estos métodos te dotarán de las habilidades necesarias para una recopilación de datos eficaz.
Análisis y utilización de datos
Una vez que hayas recopilado los datos con éxito, el siguiente paso es analizarlos y utilizarlos de forma eficaz.
Esta sección te guiará a través del proceso de análisis de los datos extraídos, la creación de tu propio modelo de precios y la creación y actualización de perfiles de ofertas.
Cómo analizar los datos extraídos
-
Limpieza de datos. El primer paso en cualquier proceso de análisis de datos es limpiar los datos. Elimina los duplicados, gestiona los valores que faltan y convierte los tipos de datos si es necesario.
-
Visualización de datos. Utiliza bibliotecas como Matplotlib o Seaborn para visualizar los datos. Esto puede ayudarte a identificar tendencias, valores atípicos o patrones.
-
Análisis estadístico. Utiliza métodos estadísticos para resumir los datos. Calcula medias, medianas, desviaciones estándar, etc., para comprender mejor la distribución de los datos.
-
**Análisis de texto. Si has recopilado datos textuales, plantéate utilizar técnicas de procesamiento del lenguaje natural (PLN) para extraer información relevante.
-
Análisis de correlación. Identifica las variables que presentan una fuerte correlación entre sí. Esto puede resultar especialmente útil en el sector inmobiliario para comprender cómo los distintos factores influyen en los precios de los inmuebles.
Retos habituales y soluciones
El web scraping no está exento de retos. Desde los CAPTCHAs y los límites de frecuencia hasta las preocupaciones sobre la calidad y la fiabilidad de los datos, esta sección tiene como objetivo prepararte para algunos de los obstáculos a los que podrías enfrentarte y ofrecerte soluciones para superarlos.
CAPTCHAs
-
- Problema: Muchos sitios web utilizan CAPTCHAs para impedir el scraping automatizado.
- Solución: Puedes utilizar servicios como 2Captcha o Anti-Captcha para resolver los CAPTCHAs automáticamente. Como alternativa, se puede utilizar Selenium para resolver manualmente el CAPTCHA durante el proceso de extracción de datos.
Límites de frecuencia
-
- Problema: Los sitios web suelen tener límites de frecuencia para restringir el número de solicitudes procedentes de una misma dirección IP.
- Solución: Implementa la limitación de frecuencia en tu código para respetar las condiciones del sitio web. También puedes utilizar servicios de proxy para rotar las direcciones IP. Los proxies residenciales de Geonode son un servicio excelente para este fin.
Datos incompletos
-
- Problema: A veces, los datos extraídos pueden estar incompletos debido a la carga dinámica u otros problemas.
- Solución: Utiliza Selenium para asegurarte de que la página se haya cargado por completo antes de realizar el scraping. También puedes utilizar sus funciones de espera para pausar el código hasta que se carguen determinados elementos.
Datos incoherentes
-
- Problema: La estructura del sitio web puede cambiar con el tiempo, lo que da lugar a datos incoherentes.
- Solución: Actualiza periódicamente tu código de extracción para adaptarlo a cualquier cambio en la estructura del sitio web. Implementa un sistema robusto de gestión de errores que te avise cuando falle el scraping.
Validación de datos
-
- Problema: Los datos extraídos pueden contener errores o imprecisiones.
- Solución: Valida siempre tus datos contrastándolos con varias fuentes o utiliza sumas de comprobación para garantizar la integridad de los datos.
Cuestiones legales y éticas
-
- Problema: El scraping de datos puede, en ocasiones, infringir las condiciones de uso del sitio web.
- Solución: Lee siempre y respeta las condiciones de uso del sitio web y el archivo robots.txt. Respeta las normas y políticas del sitio web.
Si eres consciente de estos retos habituales y de sus soluciones, estarás mejor preparado para hacer frente a cualquier problema que surja durante tus tareas de extracción de datos web.
Preguntas frecuentes
¿Cómo puedo extraer datos de páginas web inmobiliarias sin programar?
Puedes utilizar herramientas de extracción de datos web sin código, como WebHarvy, Octoparse o Import.io. Estas herramientas ofrecen interfaces intuitivas que permiten extraer datos con solo apuntar y hacer clic.
¿Cuáles son las mejores bibliotecas de Python para el scraping web?
Las bibliotecas de Python más utilizadas para el scraping web son BeautifulSoup, para analizar HTML y XML, y Selenium, para interactuar con sitios web que utilizan mucho JavaScript. Scrapy es otra opción para proyectos más complejos.
¿Es legal el scraping web?
La legalidad del scraping web depende de las condiciones de uso del sitio web y de cómo utilices los datos. Consulta siempre los términos y condiciones del sitio web y considera la posibilidad de buscar asesoramiento legal para garantizar el cumplimiento de la normativa.
Recursos adicionales
Tras repasar los distintos aspectos del web scraping, desde la configuración del entorno hasta cómo superar los retos, es hora de concluir y ver qué viene a continuación.
Documentación oficial. Siempre es un buen punto de partida. BeautifulSoup, Selenium y otras bibliotecas cuentan con una amplia documentación que te ayudará a comprender mejor sus funcionalidades.
Cursos en línea. Sitios web como Udemy, Coursera y edX ofrecen cursos sobre web scraping y análisis de datos.
Tutoriales de YouTube. Hay innumerables tutoriales disponibles que abarcan desde los conceptos básicos hasta las técnicas avanzadas.
Foros y comunidades. Sitios web como StackOverflow y Reddit cuentan con comunidades activas en las que puedes plantear preguntas y compartir conocimientos.
Libros. También hay varios libros disponibles que se centran en el web scraping y las técnicas de recopilación de datos.
Conclusión
Ahora que ya dispones de los conocimientos y las herramientas necesarios para realizar un web scraping eficaz, es hora de ponerlos en práctica.
Empieza poco a poco, experimenta y no dudes en lanzarte a proyectos más complejos a medida que ganes confianza.
Recuerda que la clave para un web scraping exitoso no es solo recopilar datos, sino convertirlos en información útil.

