Geonode logo

Crawl. Únete a la beta gratuita

Rastrea un sitio completo y obtén datos limpios de cada página
Envía una URL
Rastrea el sitio completo o una sección
Tarifa mensual fija o por solicitud
Gratis1,500 solicitudes/mes
Datos limpios por página
  • HTML
  • Markdown

Ve ilimitado, o paga por solicitud

Un solo plan cubre Scraper, Map, Crawl y Search. Sin créditos, sin multiplicadores, sin facturas sorpresa.

  • Plan gratuito

    $0/ mes

    1,500 solicitudes / mes

    • Concurrencia1
    • Tamaño del lote5 URLs
    • Páginas por rastreo10
    • Se reinicia cada mes
    • No se requiere tarjeta de crédito
    • Las solicitudes fallidas nunca se cobran – en todos los endpoints
  • Planes por solicitud

    $62.50/ mes

    250,000 solicitudes / mes

    Solicitudes:
    • Concurrencia50
    • Tamaño del lote100 URLs
    • Páginas por rastreo200
    • Las solicitudes no usadas se acumulan
    • Las solicitudes fallidas nunca se cobran – en todos los endpoints
  • Planes ilimitados

    $1,000/ mes

    Volumen de solicitudes ilimitado

    Hilos:
    • Ideal para hasta7M solicitudes/mes
    • Tamaño del lote1,000 URLs
    • Páginas por rastreo1,000
    • Solicitudes ilimitadas, precio fijo
    • Incluye todos los endpoints
  • Pago por Uso

    desde $0.40/ 1k solicitudes

    Cantidad de solicitudes personalizada

    • Concurrencia100
    • Tamaño del lote500 URLs
    • Páginas por rastreo500
    • Las solicitudes no usadas se acumulan
    • Pedido mínimo de $50
    • Las solicitudes fallidas nunca se cobran – en todos los endpoints

Así es como ofrecemos precios bajos con una calidad de primer nivel

La mayoría de las APIs de scraping funcionan con suministro alquilado y precios basados en créditos. Por eso tu factura es impredecible. Nosotros elegimos el camino contrario, y las matemáticas se acumulan a nuestro favor.
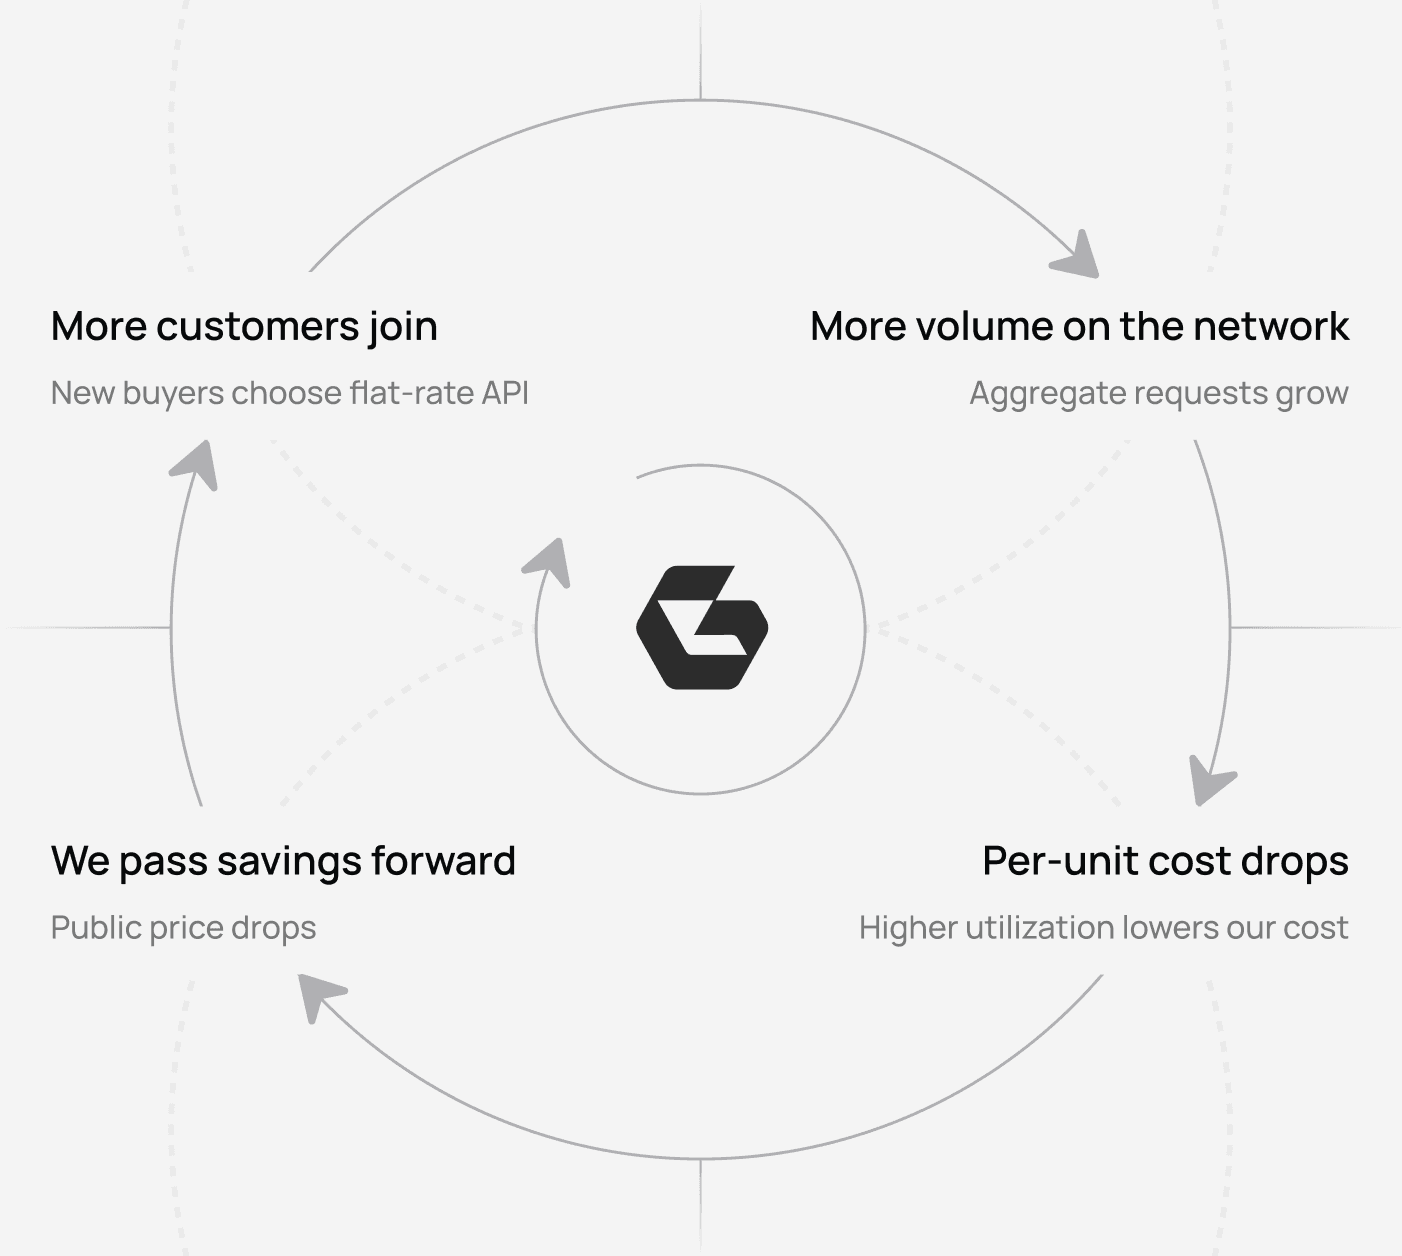
Cómo más clientes, operar nuestra propia red, precios mayoristas y costos más bajos se refuerzan mutuamente

Inicio rápido de código

Agrega la Crawl API de Geonode a tu aplicación y extrae un sitio completo en un solo job

import requests

r = requests.post(
  "https://scraper.geonode.io/v1/extract",
  headers={"X-Api-Key": "YOUR_API_KEY", "Content-Type": "application/json"},
  json={"url": "https://example.com", "formats": ["markdown"], "processing_mode": "sync"},
)
print(r.json())

Empieza a extraer datos en segundos

Crea tu cuenta

Regístrate y obtén 1,500 solicitudes gratis para empezar. Sin tarjeta de crédito
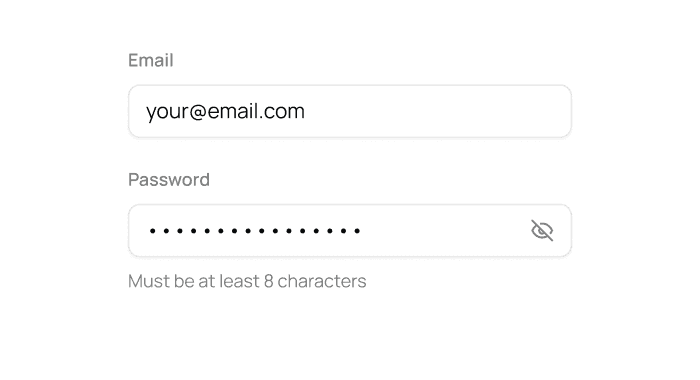
Formulario de registro con campos de correo y contraseña en el panel

Envía una solicitud

Envía cualquier URL al endpoint de scraping con una simple llamada a la API

Controles de país de la puerta de enlace y tipo de sesión en el panel

Obtén datos limpios

Recibe HTML analizado o Markdown

Formato del endpoint del proxy y detalles de la conexión

Ve ilimitado cuando escales

Cambia a un plan mensual fijo por concurrencia, o quédate por solicitud. Sin créditos, sin sorpresas de medición.

Ejemplos de código y fragmentos de integración en el panel

FAQ

Envía una solicitud POST a /v1/crawl con tu clave API de Geonode y la URL que quieres rastrear. La URL es el único campo obligatorio; ajustes como profundidad, límite de páginas, formato de salida y renderizado de JavaScript son opcionales.

Cada crawl devuelve un job_id único. Úsalo para obtener el estado del crawl y monitorear el total de páginas, las completadas y las fallidas hasta que el job termine.

Sí. Puedes configurar el crawl para devolver el contenido extraído en los formatos de salida admitidos, incluido Markdown. El formato seleccionado se aplica a las páginas procesadas por el crawl.

Sí. Las solicitudes de crawl admiten configuración de proxy, incluido el targeting por país, para recuperar el contenido tal como aparece desde una ubicación seleccionada cuando esté disponible.

Sí. En sitios dinámicos puedes usar renderizado de JavaScript junto con wait_config para controlar cuándo una página está lista para la extracción, por ejemplo esperando a que termine la actividad de red o a que aparezca un elemento concreto.

Sí. Puedes listar jobs de crawl anteriores con GET /v1/crawl/jobs. La respuesta incluye el estado del job, estadísticas del crawl, detalles de configuración e información de paginación.

Deja de pagar matemáticas de créditos. Empieza a rastrear.

1,500 solicitudes/mes gratis. Sin tarjeta de crédito.