Media.net es una empresa líder en tecnología publicitaria que ofrece una amplia gama de soluciones para editores, anunciantes y agencias. 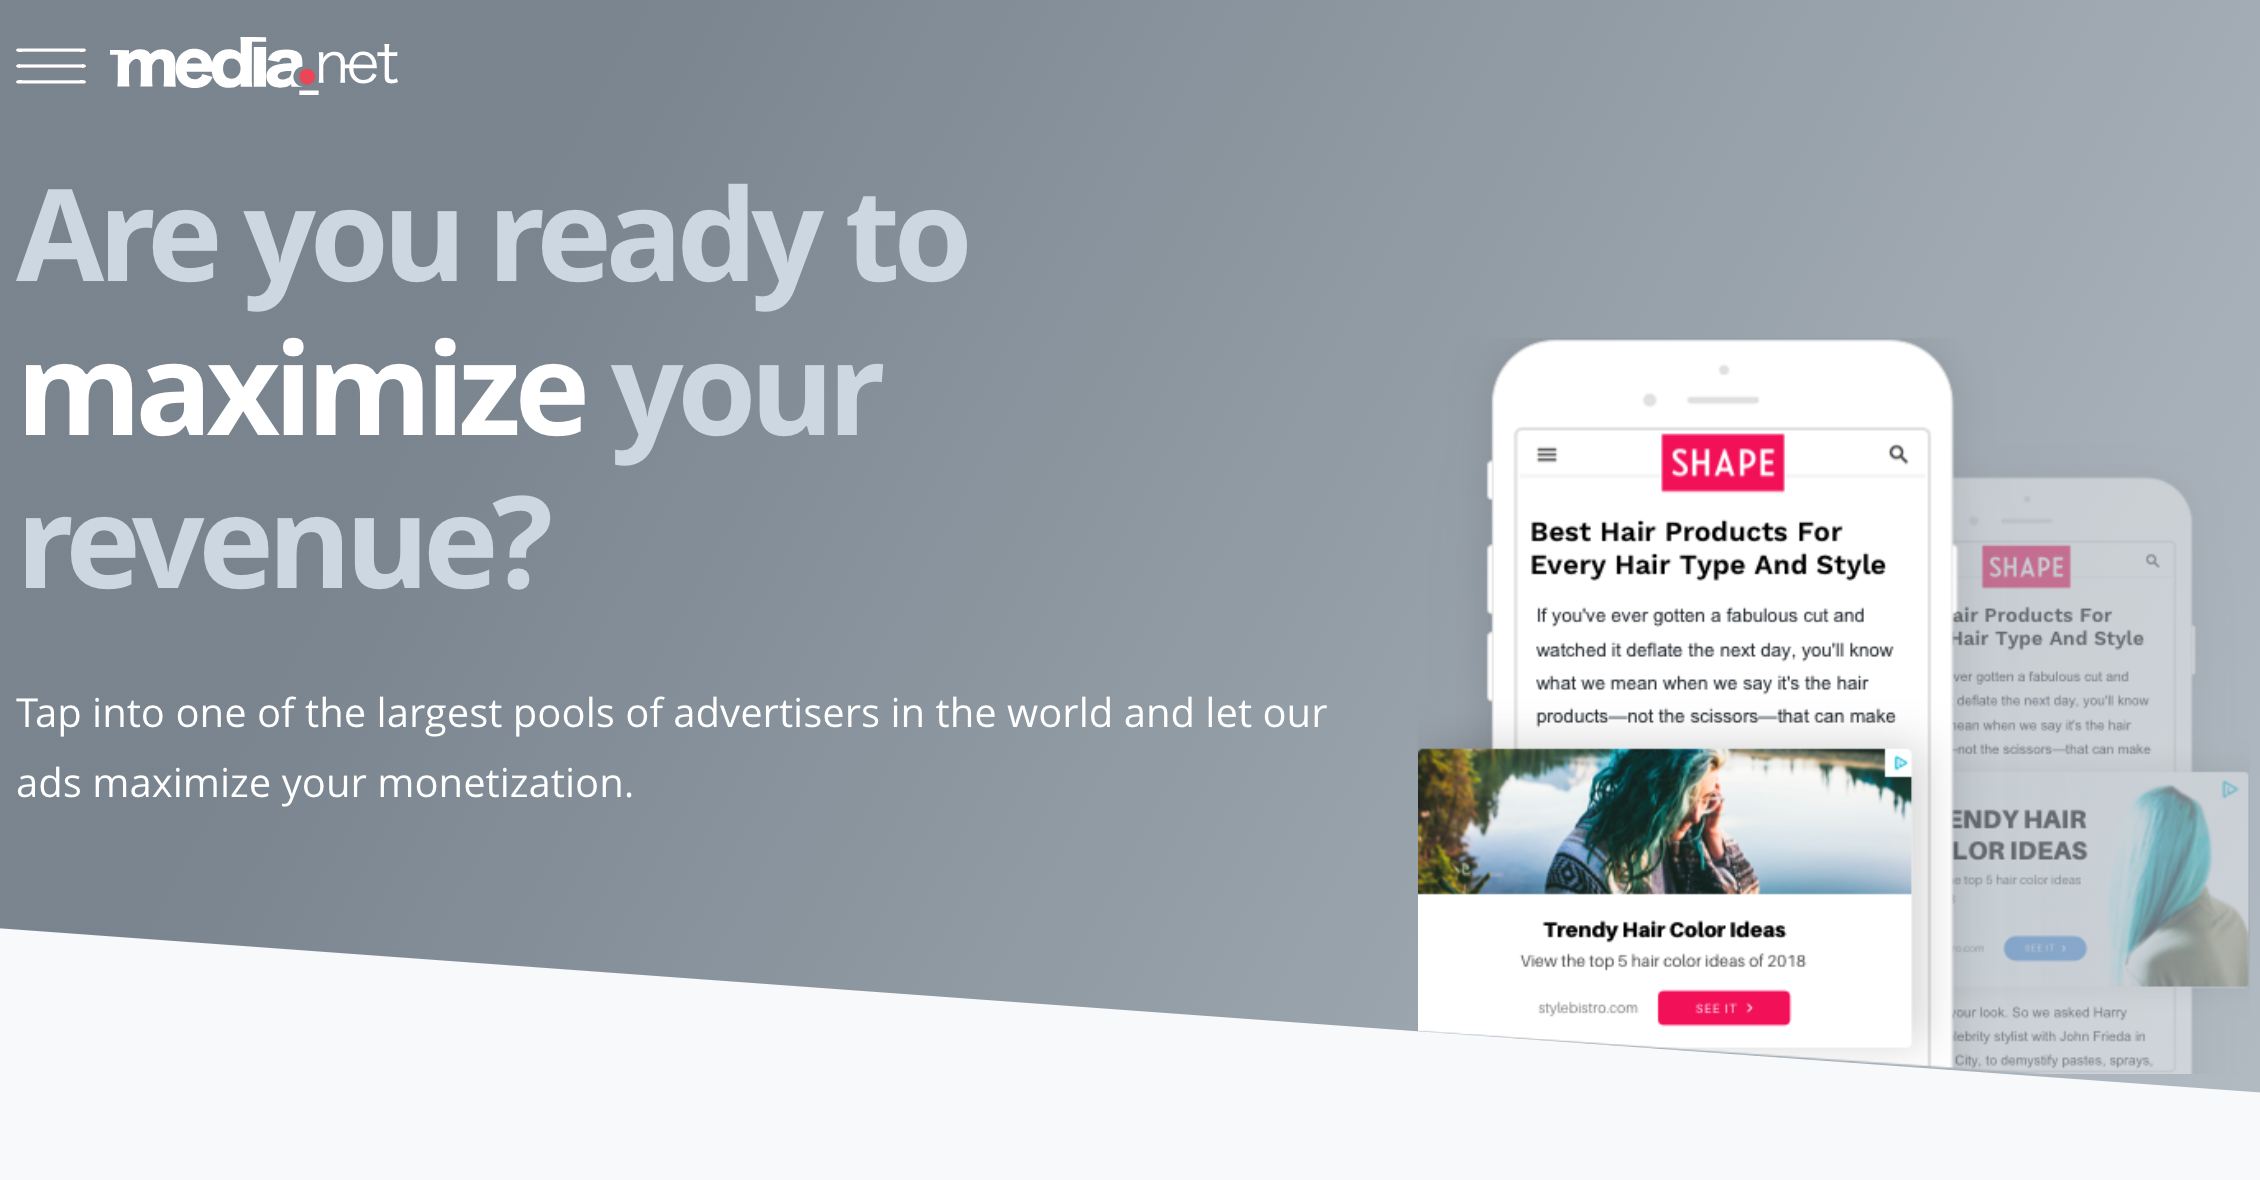
Centrada en la publicidad contextual, Media.net se ha consolidado como un actor clave en el ecosistema de la publicidad digital.
Ofrece una plataforma que permite monetizar el contenido de los sitios web mediante anuncios muy relevantes, creando así una situación beneficiosa tanto para los editores como para los anunciantes.
¿Por qué extraer datos de Media.net?
Maximización de los ingresos
Extraer datos de Media.net permite a los editores y anunciantes conocer los tipos de anuncios y los modelos de precios disponibles, lo que les ayuda a formular estrategias de marketing y planes de negocio más eficaces para maximizar los ingresos.
Inteligencia competitiva
Media.net es líder mundial en el sector de la tecnología publicitaria. Recopilar datos de esta plataforma proporciona inteligencia competitiva que puede resultar crucial para comprender las tendencias del mercado y definir tu estrategia empresarial.
Métricas de interacción
Media.net da prioridad a la experiencia del usuario ofreciendo anuncios nativos personalizados. Analizar métricas de interacción, como las tasas de interacción de usuarios reales, puede ayudarte a optimizar tus propias estrategias de interacción con los usuarios.
Perspectivas tecnológicas
Media.net emplea tecnologías de vanguardia, como el header bidding multiformato. Comprenderlas puede proporcionarte una ventaja competitiva a la hora de aprovechar tecnologías similares.
Cumplimiento legal y ético
Es esencial cumplir con las condiciones de servicio y las políticas de calidad de Media.net. La extracción de datos debe realizarse de manera que se respeten estas directrices para garantizar unas prácticas éticas.
Casos de uso del scraping de Media.net
Análisis de la competencia
El scraping de Media.net proporciona información sobre su oferta publicitaria, sus modelos de precios y su posicionamiento en el mercado. Esta inteligencia competitiva resulta inestimable para las empresas que desean comprender su posición en el sector.
Investigación de mercado
Los datos de Media.net pueden revelar tendencias de mercado y preferencias de los consumidores, lo que ayuda a las empresas a crear un perfil de cliente ideal y a adaptar su oferta en consecuencia.
Estrategias de precios
Extraer datos sobre precios de Media.net puede servir de base para desarrollar estrategias de precios más competitivas, al ofrecer una comprensión clara de las tarifas de mercado para diversos tipos de anuncios.
Análisis de opinión
Si están disponibles, las opiniones o comentarios de los usuarios en Media.net pueden ofrecer información sobre el sentimiento del mercado y la satisfacción de los clientes. Estos datos pueden servir de guía tanto a Media.net como a sus competidores a la hora de identificar áreas de mejora o aprovechar sus puntos fuertes.
Al incorporar la extracción de datos a tus operaciones empresariales, puedes optimizar todo el proceso de recopilación de información útil para la toma de decisiones estratégicas.
Consideraciones legales y éticas
Conocer el panorama legal y ético del proceso de recopilación de datos es fundamental para cualquiera que desee recabar datos de Media.net.
Aunque el web scraping puede ofrecer información muy valiosa, es importante abordarlo de forma responsable para evitar cualquier repercusión legal.
Respetar el archivo robots.txt
El archivo robots.txt es un estándar utilizado por los sitios web para indicar a los bots de rastreo y extracción de datos qué páginas pueden o no pueden recuperarse.
Antes de iniciar cualquier proyecto de extracción de datos en Media.net, es imprescindible consultar el archivo robots.txt del sitio.
Este archivo indica las áreas del sitio web a las que no se puede acceder y aquellas a las que sí se puede acceder para la extracción de datos.
Ignorar las directrices de este archivo no solo puede provocar que se bloquee tu dirección IP, sino que también te expone a riesgos legales.
Comprender las Condiciones de uso de Media.net
Las Condiciones de uso (ToS) de Media.net son un acuerdo legal que describe las normas, condiciones y directrices para el uso de su plataforma.
Es fundamental leer y comprender estas condiciones antes de empezar a extraer datos del sitio.
Incumplir las Condiciones de servicio podría acarrear diversas consecuencias, desde la suspensión temporal de tu cuenta hasta acciones legales.
Busca en las Condiciones de servicio las secciones que traten específicamente sobre la extracción de datos o el acceso automatizado a la plataforma.
Si las Condiciones de servicio prohíben explícitamente la extracción de datos web, deberás obtener un permiso por escrito de Media.net para continuar.
Directrices éticas para la extracción de datos web
Más allá de las consideraciones legales, el comportamiento ético es fundamental a la hora de extraer datos de cualquier sitio web, incluido Media.net. A continuación se indican algunas directrices éticas que debes tener en cuenta:
Minimiza la carga del servidor
Asegúrate de que tus actividades de extracción de datos web no sobrecarguen ni interrumpan los servicios de Media.net.
Utiliza la limitación de tasa y realiza las solicitudes con una frecuencia que imite el comportamiento de navegación de un usuario humano.
Uso de los datos
Sé transparente sobre tus intenciones respecto al uso de los datos extraídos. Si los datos van a publicarse o utilizarse con fines comerciales, solicita permiso a Media.net.
Privacidad de los usuarios
Si estás extrayendo contenido generado por los usuarios, ten cuidado de no recopilar ninguna información personal a menos que sea absolutamente necesario para tu proyecto.
Si se recopilan datos personales, deben anonimizarse y almacenarse de forma segura.
Atribución
Si tiene previsto publicar los datos o cualquier conclusión derivada de ellos, cite debidamente a Media.net como fuente de los datos.
Al cumplir estas directrices legales y éticas, podrás llevar a cabo tus actividades de web scraping de forma responsable y respetuosa. Esto no solo minimiza los riesgos, sino que también contribuye a la integridad y credibilidad de tu análisis de datos o proyecto de inteligencia empresarial.
Herramientas y tecnologías
El éxito de un proyecto de web scraping suele depender de las herramientas y tecnologías empleadas.
Al aprovechar estas herramientas y tecnologías, puedes crear un proceso sólido de web scraping para recopilar datos de Media.net.
Tanto si eres principiante como experto, la combinación adecuada de estos recursos puede mejorar significativamente la eficiencia y la eficacia de tus proyectos de web scraping.
Lenguajes de programación
Python
Python es un lenguaje versátil muy utilizado para el web scraping debido a su facilidad de uso y a sus amplias bibliotecas.
Permite el desarrollo y la implementación rápidos de scripts de extracción de datos web, lo que lo hace ideal tanto para principiantes como para expertos con amplia experiencia en programación.
JavaScript
JavaScript, en particular Node.js, es otro lenguaje potente para la extracción de datos web.
Resulta especialmente útil cuando se trata de sitios web que dependen en gran medida de JavaScript para cargar contenido, ya que puede interactuar directamente con el DOM (Modelo de Objetos de Documento).
Bibliotecas y marcos de trabajo
BeautifulSoup
BeautifulSoup es una biblioteca de Python ideal para principiantes en el scraping web.
Permite navegar y manipular fácilmente documentos HTML y XML, lo que facilita la extracción de datos.
Scrapy
Scrapy es un marco de trabajo de Python más avanzado, diseñado para el scraping y el rastreo web.
Ofrece compatibilidad integrada para gestionar diversos formatos de datos y exportar los datos extraídos, lo que lo hace adecuado para proyectos a gran escala.
Selenium
Selenium se utiliza a menudo para extraer datos de sitios web con un uso intensivo de JavaScript. Automatiza la interacción con el navegador, lo que permite extraer datos que se cargan dinámicamente.
Servicios de proxy
Importancia del uso de proxies para el scraping
El uso de proxies es fundamental en el scraping a gran escala para evitar la detección y el bloqueo de IP. Los proxies también permiten el scraping con segmentación geográfica, lo que puede resultar esencial para recopilar datos específicos de una ubicación.
Proxies de Geonode
Los proxies de Geonode ofrecen una capa de anonimato y seguridad, lo que los hace ideales para proyectos de extracción de datos web.
Ayudan a eludir los bloqueos de IP y los límites de velocidad impuestos por sitios web como Media.net.
Integración de los proxies de Geonode en tu código de extracción
Para configurar los proxies de Geonode hay que crear una cuenta e integrarla en tu código.
La mayoría de los lenguajes de programación y bibliotecas de scraping ofrecen formas sencillas de configurar los proxies.
Por ejemplo, en Python, puedes utilizar la biblioteca Requests para integrar fácilmente los proxies de Geonode.
Extensiones de navegador
Web Scraper
Web Scraper es una extensión de navegador que permite realizar el scraping web fácilmente con solo apuntar y hacer clic.
Es excelente para proyectos a pequeña escala y para quienes se inician en el scraping web.
Data Miner
Data Miner es otra extensión de navegador que ofrece «recetas» predefinidas para el scraping de datos.
Resulta útil para extraer datos de sitios web sin necesidad de escribir código, aunque puede que no sea adecuada para necesidades de scraping más complejas.
Configuración del entorno
Antes de adentrarnos en el proceso de extracción de datos web propiamente dicho, es fundamental configurar un entorno de desarrollo adecuado.
Esto implica instalar el software y las bibliotecas esenciales que se utilizarán a lo largo del proyecto.
Instalación de Python y pip
-
Descarga Python. Visita la página web oficial de Python y descarga la última versión adecuada para tu sistema operativo.
-
Instalación. Ejecuta el instalador y sigue las instrucciones que aparecen en pantalla. Asegúrate de marcar la casilla que dice «Añadir Python a PATH» durante la instalación.
-
Comprueba la instalación. Abre el símbolo del sistema o la terminal y escribe python --version para asegurarte de que Python se ha instalado correctamente.
-
Instala pip. Pip (Package Installer for Python) suele venir preinstalado con Python.
Puedes comprobar su instalación escribiendo pip --version en la línea de comandos o en la terminal.
Configuración de un editor de código
- Descarga Visual Studio Code. Visita la página web de Visual Studio Code y descarga la versión compatible con tu sistema operativo.
- Instalación. Ejecuta el instalador y sigue las instrucciones de configuración.
- Extensiones. Una vez instalado, puedes añadir extensiones como Python, Beautify e IntelliSense para mejorar tu experiencia de programación.
Instalación de las bibliotecas y los marcos necesarios
Abre tu terminal e instala las siguientes bibliotecas de Python:
- BeautifulSoup:
pip install beautifulsoup4
- Scrapy:
pip install scrapy
- Selenium:
pip install selenium
Identificación de puntos de datos
Navegación por el sitio web de Media.net
Antes de escribir ningún código, dedica un tiempo a navegar por el sitio web de Media.net para comprender su estructura e identificar los puntos de datos que deseas extraer.
Comprender la estructura del sitio web de Media.net
El sitio web de Media.net sirve como plataforma para la publicidad contextual y las soluciones programáticas. Está dirigido tanto a anunciantes como a editores, y ofrece una variedad de servicios para maximizar los ingresos. El sitio web está organizado en varias secciones principales, entre las que se incluyen:
- Inicio. Introducción a Media.net y sus servicios.
- Marketplace. Información sobre la demanda competitiva procedente de diversas fuentes para maximizar el rendimiento.
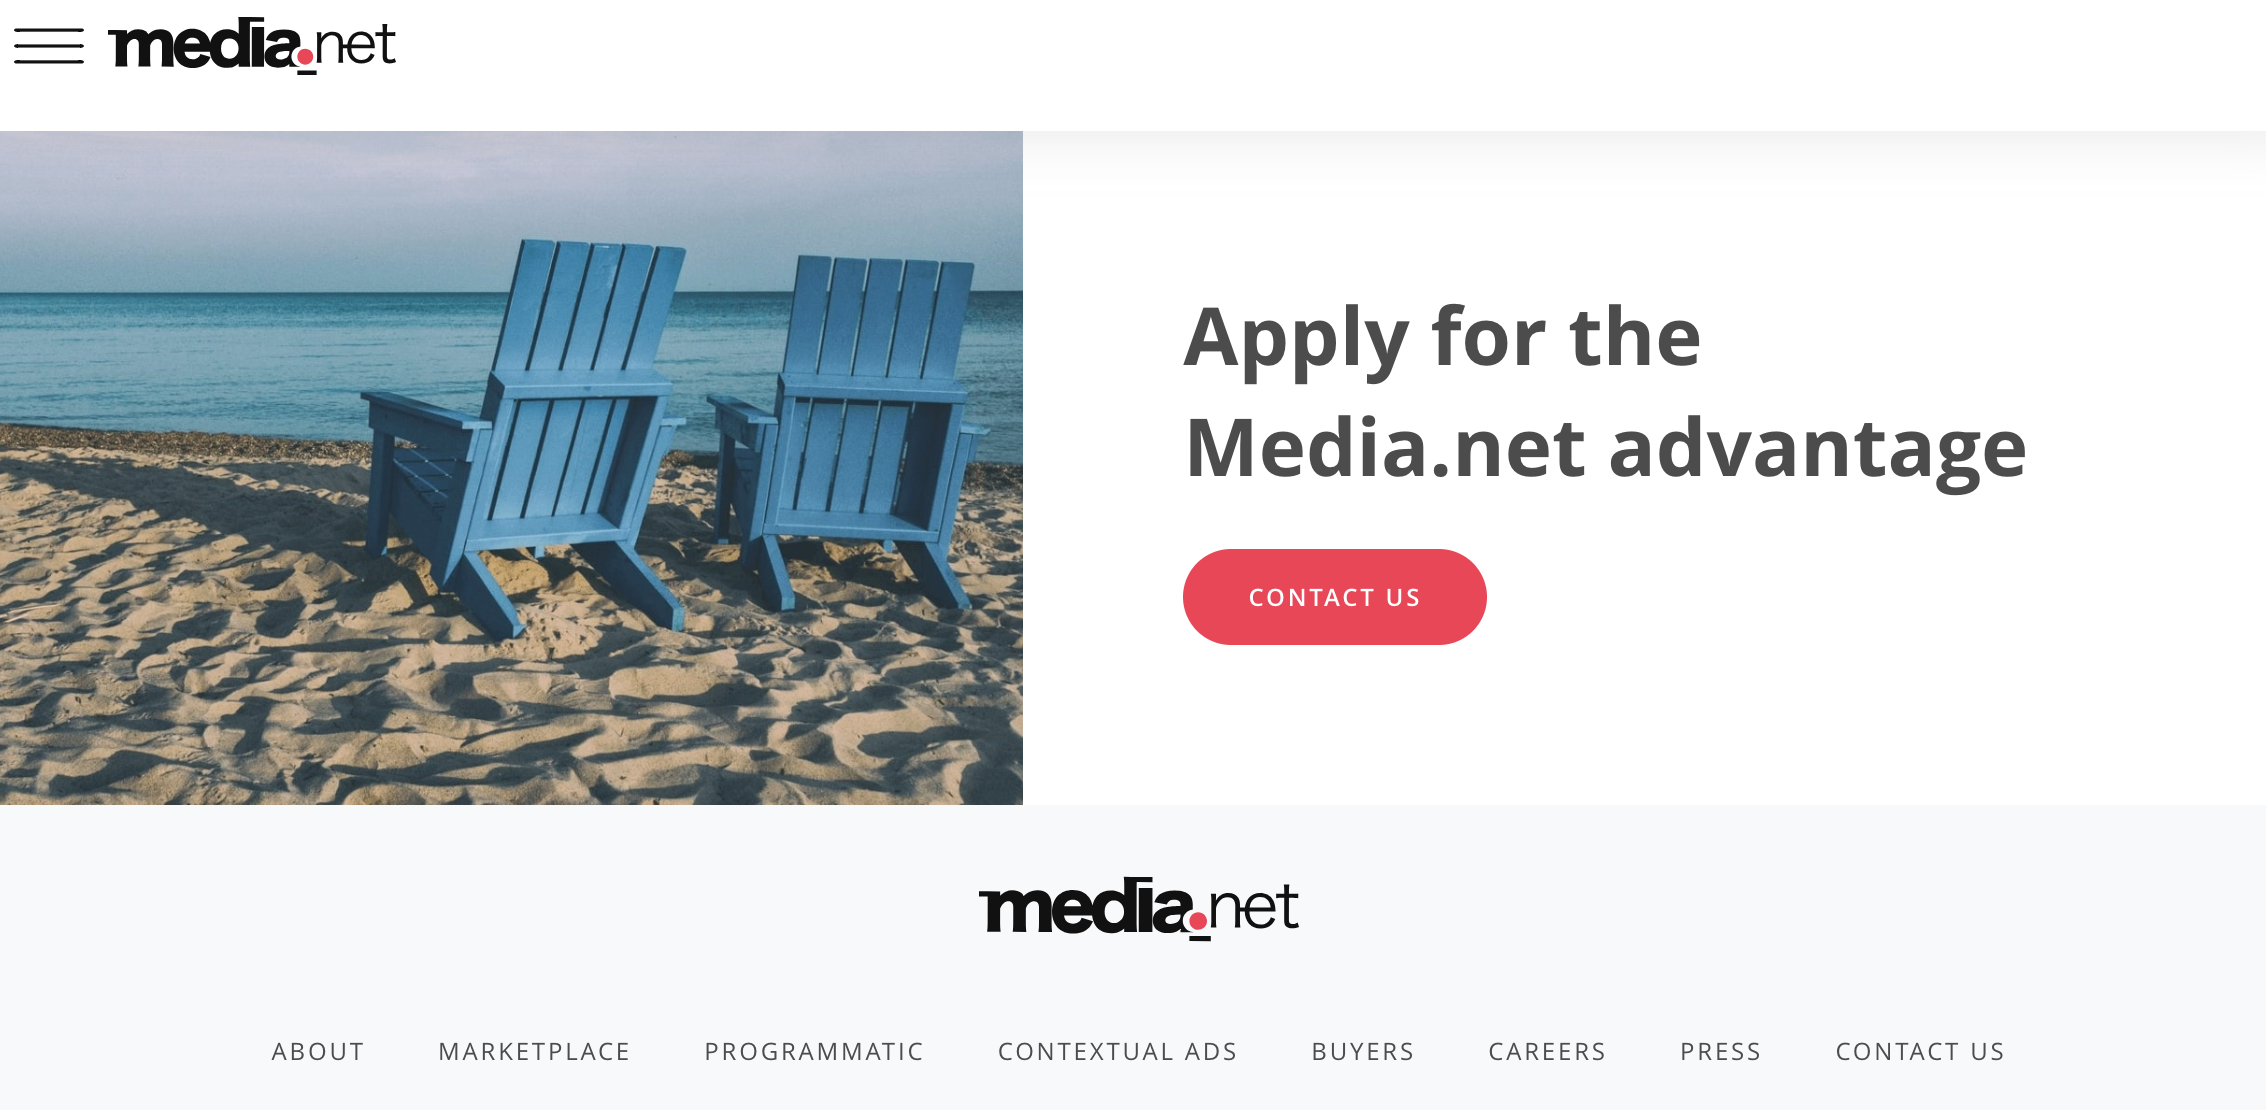
- Anuncios contextuales. Detalles sobre el formato publicitario propio de Media.net que aprovecha las palabras clave de búsqueda para la publicidad dirigida.
- Programática. Información sobre su plataforma de puja de encabezado (header bidding) de última generación y multiformato.
- Compradores. Una sección probablemente dedicada a los anunciantes potenciales.
- Acerca de. Información general sobre Media.net.
- Iniciar sesión. Para que los usuarios existentes accedan a sus cuentas.
- Contáctanos. Para consultas y asistencia.
El sitio web también ofrece información adicional sobre anuncios gráficos y anuncios nativos, explicando cómo pueden beneficiar a los editores.
Identificación de los datos clave que se van a extraer
Determina qué datos específicos quieres extraer de Media.net. Estos pueden abarcar desde los tipos de anuncios ofrecidos y los modelos de precios hasta entradas de blog y artículos. Elabora una lista de estos datos, ya que te servirán de guía para tu lógica de extracción.
Escribir el código
Una vez que hayas configurado tu entorno y hayas identificado los datos que quieres extraer, el siguiente paso es escribir el código.
La extracción de datos web puede realizarse de forma manual o mediante métodos automatizados. A continuación, analizaremos ambos enfoques y proporcionaremos fragmentos de código de ejemplo para cada uno de ellos.
Extracción manual
Pasos y limitaciones
La extracción manual consiste en navegar por el sitio web y copiar los datos manualmente en una hoja de cálculo o un medio de almacenamiento similar.
Aunque este método es sencillo, requiere mucho tiempo y no resulta práctico para conjuntos de datos de gran tamaño.
Extracción automatizada
La extracción automatizada es la forma más eficiente de recopilar datos, especialmente para proyectos a gran escala. Veremos cómo extraer datos utilizando BeautifulSoup, Scrapy y Selenium.
Uso de BeautifulSoup
Fragmentos de código de ejemplo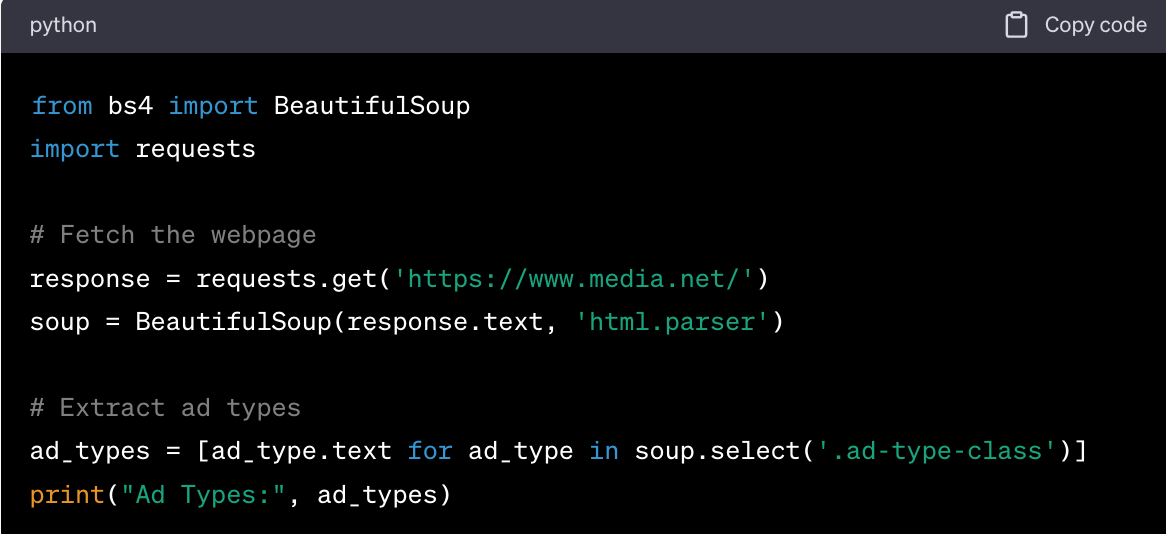
Explicación del código
- Importa la biblioteca BeautifulSoup y el módulo requests.
- Obtén el contenido de la página web utilizando
requests.get().
- Analiza el contenido HTML utilizando BeautifulSoup.
- Extraer los tipos de anuncios mediante el método
.select(), centrándose en la clase específica que contiene esta información.
Uso de Scrapy
Fragmentos de código de ejemplo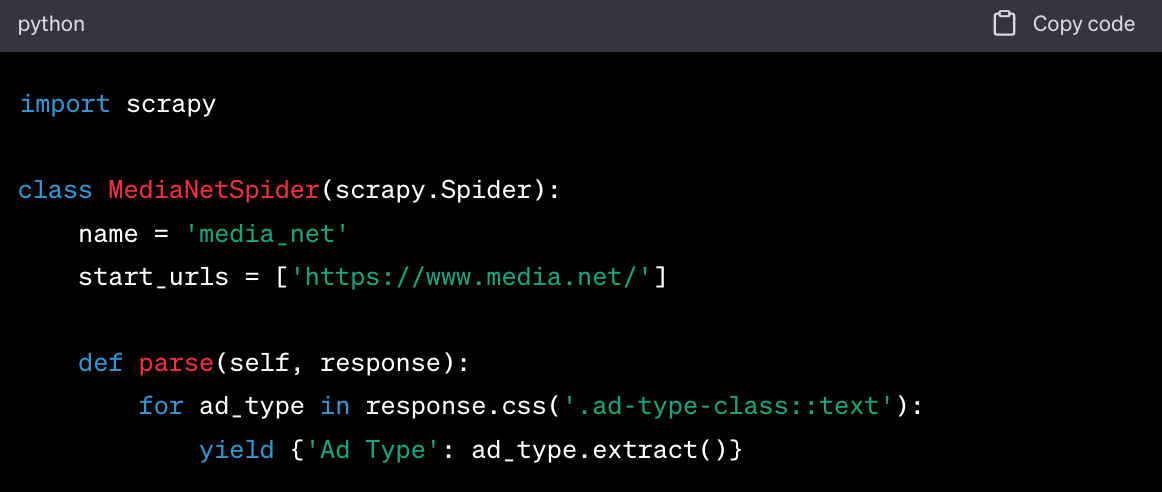
Explicación del código
- Importar la biblioteca Scrapy.
- Define una clase de araña que herede de
scrapy.Spider.
- Especifica la URL que se va a rastrear en
start_urls.
- Define el método
parse para extraer los tipos de anuncios utilizando el método .css().
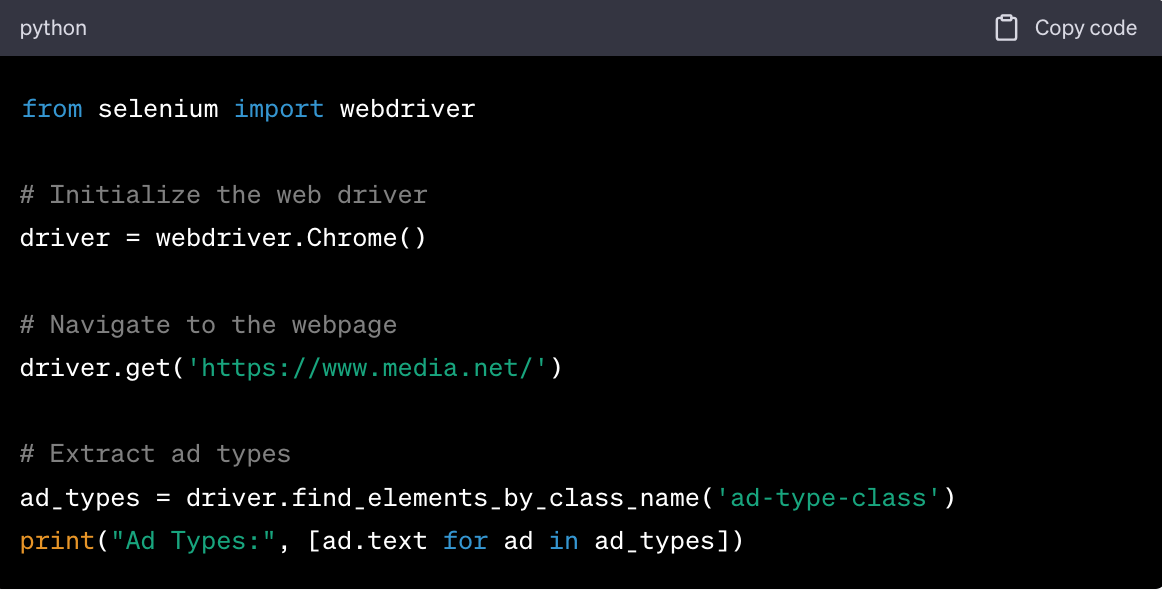
Uso de Selenium
Fragmentos de código de ejemplo
CSV
Puedes utilizar la biblioteca integrada de Python csv para almacenar los datos extraídos en un archivo CSV.
Base de datos
Para proyectos más complejos, es recomendable almacenar los datos en una base de datos como MySQL o MongoDB.
Siguiendo estos pasos y utilizando estos fragmentos de código como guía, podrás crear un proceso sólido de extracción de datos web para recopilar información de Media.net.
Uso de extractores de datos de creación propia
Los extractores de datos web de creación propia ofrecen un mayor grado de personalización y control sobre los datos que recopilas.
Con conocimientos de programación, puedes escribir líneas de código específicas para centrarte en elementos concretos del sitio web de Media.net, lo que permite una recopilación de datos más matizada.
Los modelos de rastreadores personalizados son ideales para quienes tienen necesidades de datos específicas que las herramientas de rastreo genéricas quizá no puedan satisfacer.
Uso de servicios de extracción de datos
Los servicios de extracción de datos suelen incluir API y herramientas de scraping preconfiguradas, diseñadas para el scraping en profundidad de contenidos web.
Los servicios de scraping pueden gestionar escenarios complejos de extracción de datos sin que sea necesario escribir líneas de código.
Resultan especialmente útiles para empresas que carecen de conocimientos de programación, pero que, aun así, desean recabar información valiosa de plataformas como Media.net.
Solución de problemas y preguntas frecuentes
El web scraping es una herramienta muy potente, pero presenta una serie de retos.
Errores comunes y soluciones
IP bloqueada
Solución: El uso de proxies es una buena forma de evitar que te bloqueen la IP.
Geonode ofrece una variedad de servicios de proxy que pueden ayudarte a extraer datos de forma anónima, reduciendo así las posibilidades de que te bloqueen la IP.
Límite de frecuencia superado
Solución: Implementa una limitación de frecuencia en tu código para controlar la frecuencia de tus solicitudes.
También puedes utilizar los proxies de Geonode para rotar las direcciones IP, lo que te ayudará a evitar alcanzar los límites de frecuencia.
Datos incompletos o inexactos
Solución: Esto suele ocurrir cuando cambia la estructura del sitio web.
Asegúrate siempre de actualizar tu código según el diseño más reciente del sitio web.
Errores de tiempo de espera
Solución: Aumenta el límite de tiempo de espera en tu código.
Además, plantéate utilizar proxies de Geonode para disfrutar de una conectividad más fiable.
Preguntas frecuentes
¿Cómo extraer datos de Media.net sin que te bloqueen?
El uso de proxies de Geonode puede ayudarte a extraer datos de Media.net sin que te bloqueen.
Estos proxies ocultan tu dirección IP, lo que dificulta que los sitios web detecten la actividad de scraping.
¿Es legal hacer scraping en Media.net?
Consulta siempre las Condiciones de servicio de Media.net para conocer su política sobre el scraping web. Por lo general, si la política de «robots.txt» de un sitio web lo permite y no infringes ninguna condición, suele estar permitido.
¿Cómo puedo extraer datos de Media.net más rápido?
El uso de una biblioteca más eficiente, como Scrapy, puede acelerar el proceso de extracción de datos.
Además, los proxies de Geonode pueden proporcionar conexiones más rápidas.
¿Cuáles son las mejores bibliotecas para extraer datos de Media.net?
BeautifulSoup, Scrapy y Selenium son bibliotecas de uso común para la extracción de datos web, cada una con sus propias ventajas.
¿Cómo mejoran los proxies de Geonode el rastreo web?
Los proxies de Geonode ofrecen rotación de IP, proxies de centros de datos de alta velocidad y proxies residenciales, lo que los hace ideales para el rastreo web.
Ayudan a eludir los bloqueos de IP y los límites de velocidad, mejorando así la eficiencia de tus tareas de rastreo web.
Prácticas recomendadas
Limitación de velocidad
Implementa siempre la limitación de velocidad en tu código para evitar sobrecargar el servidor. No solo es una cuestión de cortesía, sino que también te ayuda a evitar que te bloqueen.
Rotación de IP
Utiliza los proxies de Geonode para la rotación de IP. Esto te permite realizar solicitudes a través de diferentes direcciones IP, lo que reduce la probabilidad de que te bloqueen.
Almacenamiento y uso de datos
Almacena los datos extraídos en un formato estructurado, como CSV o una base de datos. Respeta siempre las condiciones de uso de los datos, especialmente si tienes pensado publicarlos.
Atribución
Si utilizas los datos para investigación o elaboración de informes, indica siempre debidamente a Media.net como fuente de los datos.
Si sigues estas buenas prácticas y consejos para la resolución de problemas, podrás hacer que tu proyecto de extracción de datos web sea más eficaz y menos propenso a sufrir problemas habituales.
Conclusión
El web scraping es una herramienta de gran valor para recopilar datos de Media.net, ya que ofrece información que puede resultar fundamental para diversas aplicaciones empresariales, como el análisis de la competencia, los estudios de mercado y las estrategias de precios.
A lo largo de este artículo, hemos abordado los pasos esenciales para configurar tu entorno de scraping, escribir el código y resolver problemas habituales.
También hemos destacado la importancia de respetar las directrices legales y éticas, haciendo especial hincapié en cómo los proxies de Geonode pueden mejorar tus tareas de scraping al proporcionar anonimato y eludir los límites de frecuencia.
Próximos pasos
Limpieza y análisis de datos
Una vez que hayas extraído los datos con éxito, el siguiente paso es limpiarlos y analizarlos. La limpieza de datos implica eliminar duplicados, gestionar los valores que faltan y convertir los tipos de datos.
Tras la limpieza, puedes proceder a analizar los datos utilizando métodos estadísticos para obtener información útil.
Implementación estratégica
La información obtenida de los datos puede implementarse estratégicamente en tu negocio.
Ya sea para ajustar tus modelos de precios o para identificar nuevas oportunidades de mercado, los datos que has recopilado pueden servir como un recurso valioso para la toma de decisiones.
Seguimiento y actualización
El web scraping no es una actividad puntual. Los sitios web actualizan su contenido y estructura con regularidad, por lo que es esencial mantener actualizado el código de scraping.
Realizar un seguimiento del proceso de scraping te ayudará a identificar y solucionar rápidamente cualquier problema que surja.
Recursos adicionales
Tutoriales
- Extracción de datos web con Python: una guía completa
- Cómo utilizar proxies para la extracción de datos web
Documentación
- Documentación de BeautifulSoup
- Documentación de Scrapy
- Servicios de proxy de Geonode
Foros de apoyo de la comunidad
- Stack Overflow
- Comunidad de extracción de datos web de Reddit
- Foro de la comunidad de Geonode
Si sigues las directrices y las mejores prácticas descritas en este artículo, estarás en el buen camino para dominar el web scraping. Los datos que recopiles de Media.net pueden ofrecerte una ventaja competitiva, siempre y cuando los utilices de forma responsable y ética.

