Ventajas de extraer datos de Walmart
Walmart, uno de los minoristas más importantes, gestiona una cadena de hipermercados, grandes almacenes de descuento y tiendas de alimentación. Cuenta con una amplia presencia en línea con millones de productos que abarcan desde alimentos hasta ropa, artículos para el hogar, electrónica y mucho más, lo que convierte a Walmart en una fuente de datos increíblemente valiosa para la extracción de datos web.
La extracción de datos de Walmart puede servir para múltiples fines, especialmente para empresas e investigadores. A continuación se presentan algunas aplicaciones prácticas de la extracción de datos de Walmart:
• Estudio de mercado. La amplia oferta de productos de Walmart ofrece una visión completa del mercado en numerosas categorías. Al extraer estos datos, puedes obtener información sobre las tendencias de los productos, las preferencias de los consumidores y las estrategias de precios.
• Análisis de la competencia. Los datos extraídos de Walmart pueden utilizarse para comprender qué productos se venden, a qué precio y cómo se comercializan. Esta información puede ayudarte a posicionar tus propios productos de forma competitiva.
• Seguimiento de precios. Puedes utilizar los datos extraídos para supervisar los precios de los productos de Walmart en tiempo real, de modo que puedas ajustar tus propios precios en consecuencia y mantenerte competitivo.
• Optimización del surtido de productos. Al analizar la gama de productos que ofrece Walmart, puedes optimizar tu propio surtido de productos para satisfacer mejor la demanda de los consumidores.
• Análisis de opinión. Las reseñas y valoraciones en la página web de Walmart proporcionan una gran cantidad de información sobre la opinión de los consumidores respecto a los productos. Estos datos pueden utilizarse para mejorar la calidad de los productos y el servicio al cliente.
Extracción de datos de Walmart sin esfuerzo con Geonode
La API de extracción de datos de
Geonode
es una herramienta potente y fácil de usar diseñada para simplificar las tareas de extracción de datos web. Gracias a su amplia gama de funciones clave, permite a los usuarios extraer de forma eficiente grandes cantidades de datos de sitios web como Walmart sin necesidad de escribir líneas de código complejas.
Entre sus características más destacadas se incluyen:
• Modo de depuración. Ofrece información detallada en formato de respuesta JSON, lo que ayuda a los usuarios a comprender cómo gestionan los sitios web las solicitudes de extracción de datos y les permite ahorrar tiempo y recursos.
• Representación de JavaScript. Facilita el scraping de aplicaciones de página única (SPA) mediante la captura dinámica de elementos, lo que garantiza una extracción de datos exhaustiva.
• Ejecución de fragmentos de código JS personalizados. Permite a los desarrolladores interactuar con formularios, botones y otros elementos generados por JavaScript para un mayor control sobre el proceso de scraping.
• Proxies rotativos. Utiliza un amplio conjunto de proxies para evitar bloqueos de IP y eludir las restricciones geográficas, lo que mejora la fiabilidad de la recuperación de datos.
• Segmentación geográfica. Garantiza el acceso a más sitios web sin ser detectado como rastreador.
• API de capturas de pantalla. Permite capturar fácilmente capturas de pantalla de páginas web con fines de prueba, resolución de problemas y documentación.
• Precios por GB. Ofrece precios rentables y control sobre los gastos del rastreador.
• Formatos de respuesta. Ofrece flexibilidad a la hora de elegir entre los formatos HTML o JSON para su uso en aplicaciones integradas.
• Recopilación de datos a partir de respuestas HTTP. Recopila sin esfuerzo datos específicos, como respuestas JSON, para extraer la información necesaria.
• Modo de scraping. Ofrece varios modos de scraping para un rendimiento y una eficiencia óptimos, adaptados a las diferentes necesidades de scraping.
Cómo extraer datos de Walmart con Geonode
Comprender la estructura de la web de Walmart
Walmart es uno de los minoristas más grandes del mundo; su web es una amplia plataforma de comercio electrónico con un diseño bien estructurado y organizado que cuenta con miles de millones de páginas de productos. Comprender su estructura es fundamental para realizar una extracción de datos web eficiente y eficaz. A continuación, se ofrece una descripción general básica de cómo se organizan los datos en el sitio web de Walmart:
• Página de inicio. La página de inicio ofrece una visión general de lo que ofrece Walmart. Contiene diversas categorías de productos, ofertas promocionales y mucho más.
• Páginas de categorías. Al hacer clic en una categoría desde la página de inicio o el menú de navegación, se accede a una página de categoría. Estas páginas muestran una lista de productos de una categoría específica, como Electrónica, Ropa o Artículos para el hogar. Cada página de categoría cuenta con múltiples subcategorías para tipos de productos más específicos.
• Listas de productos. Cada página de categoría o subcategoría contiene una lista de productos. Cada lista de productos incluye información básica, como el nombre del producto, el precio, una imagen y la valoración de los clientes.
• Páginas de productos. Al hacer clic en un producto de la lista, se accede a la página individual del producto. Estas páginas contienen información detallada sobre el producto, incluida una descripción más detallada, las características del producto, imágenes adicionales, opiniones de los clientes y, a menudo, una lista de productos relacionados.
• Funcionalidad de búsqueda. La página web también cuenta con una barra de búsqueda que permite a los usuarios buscar productos específicos. Los resultados de la búsqueda se muestran en un formato similar al de las listas de productos de las páginas de categorías.
A la hora de extraer datos de la página web de Walmart, es importante tener en cuenta que la información se encuentra principalmente en estas secciones. Las páginas de productos, en particular, suelen ser las más valiosas, ya que contienen la información más detallada.
Sin embargo, el sitio web de Walmart es dinámico; parte del contenido se carga mediante JavaScript una vez cargada la página HTML inicial, lo que puede complicar el rastreo. Afortunadamente, la API de rastreo de Geonode puede gestionar la representación de JavaScript y evitar este problema.
Identificación de los datos clave que se deben extraer
Al extraer datos de un sitio web de comercio electrónico como el de Walmart, los datos clave que te interese extraer dependerán de los requisitos específicos de tu proyecto. A continuación se indican algunos datos comunes que suelen resultar valiosos:
• Nombre del producto. El título del producto es uno de los datos más básicos, pero también uno de los más cruciales. Ayuda a identificar la variedad de productos que ofrece el sitio web.
• Precio. El precio del producto es otro dato fundamental. Los precios de la competencia pueden utilizarse para comparar precios, realizar un seguimiento de los cambios de precio a lo largo del tiempo o identificar tendencias de precios.
• Imágenes. Las imágenes ofrecen una representación visual del producto. Pueden resultar útiles para diversos fines, como tareas de reconocimiento de imágenes o para proporcionar material visual en un catálogo de productos.
• Descripción. La descripción del producto ofrece información detallada sobre el mismo, incluidas sus características, especificaciones y otros detalles relevantes.
• Reseñas y valoraciones del producto. Las reseñas y valoraciones ofrecen información sobre la satisfacción de los clientes y la calidad del producto. Pueden utilizarse para el análisis de opiniones o para evaluar la opinión pública sobre un producto.
• Categoría del producto. La categoría o subcategoría del producto puede proporcionar contexto sobre qué tipo de producto es y dónde encaja dentro de la gama más amplia de productos.
• SKU o ID del producto. El SKU o ID es un identificador único para cada producto. Esto puede resultar útil para el seguimiento de productos específicos.
• Estado de disponibilidad. La información sobre si el producto está en stock, agotado o disponible para reserva puede resultar valiosa para el análisis de la cadena de suministro o la investigación de mercado.
• Información de envío. Los detalles sobre las opciones y los costes de envío pueden ser importantes para comprender el coste total de un producto.
• Información del vendedor. Si el producto lo vende un tercero, la información sobre el vendedor puede resultar relevante.
Configuración del entorno
A continuación se ofrece una guía paso a paso para configurar el entorno de la API de scraping de Geonode:
1. Crea una cuenta en Geonode. El primer paso es crear una cuenta en la página web de Geonode. Esto te dará acceso a su API y a otros servicios.
2. Obtén tu clave API. Una vez que hayas creado una cuenta y hayas iniciado sesión, podrás encontrar tu clave API en la configuración de tu cuenta o en el panel de control. Esta clave se utiliza para autenticar tus solicitudes a la API.
3. Instala las bibliotecas necesarias. Dependiendo del lenguaje de programación que utilices, es posible que tengas que instalar ciertas bibliotecas para enviar solicitudes HTTP y gestionar las respuestas.
• Biblioteca de cliente HTTP: Para enviar solicitudes a la API de Geonode y recibir respuestas, necesitarás una biblioteca de cliente HTTP. La biblioteca concreta que utilices dependerá de tu lenguaje de programación. Por ejemplo, si utilizas Python, podrías usar la biblioteca Requests. Si utilizas JavaScript, podrías usar Axios o Fetch.
• Biblioteca de análisis de JSON: La API de Geonode suele devolver datos en formato JSON, por lo que necesitarás una biblioteca para analizar estos datos. La mayoría de los lenguajes de programación modernos cuentan con soporte integrado para el análisis de JSON. Por ejemplo, en Python puedes utilizar el módulo json, y en JavaScript, puedes utilizar JSON.parse().
• Entorno de desarrollo: Necesitarás un entorno de desarrollo para escribir y ejecutar tu código. Puede ser un editor de texto como Sublime Text o Atom, o un entorno de desarrollo integrado (IDE) como PyCharm o Visual Studio Code.
4. Configura tu entorno de desarrollo. Asegúrate de que tu entorno de desarrollo esté configurado para enviar solicitudes a la API y gestionar las respuestas. Esto puede implicar crear un nuevo proyecto en tu entorno de desarrollo integrado (IDE) o editor de texto preferido.
5. Prueba la API. Antes de empezar a crear tu rastreador web, es recomendable probar la API para asegurarte de que todo funciona correctamente. Puedes hacerlo enviando una sencilla solicitud GET a la API y comprobando la respuesta.
6. Lee la documentación de la API: La documentación de la API de Geonode te proporcionará información detallada sobre cómo utilizar la API, incluidos los puntos finales disponibles, los parámetros de solicitud, los formatos de respuesta y mucho más. Leer esta documentación te ayudará a comprender cómo utilizar la API de forma eficaz.
Obtener una página de producto de Walmart
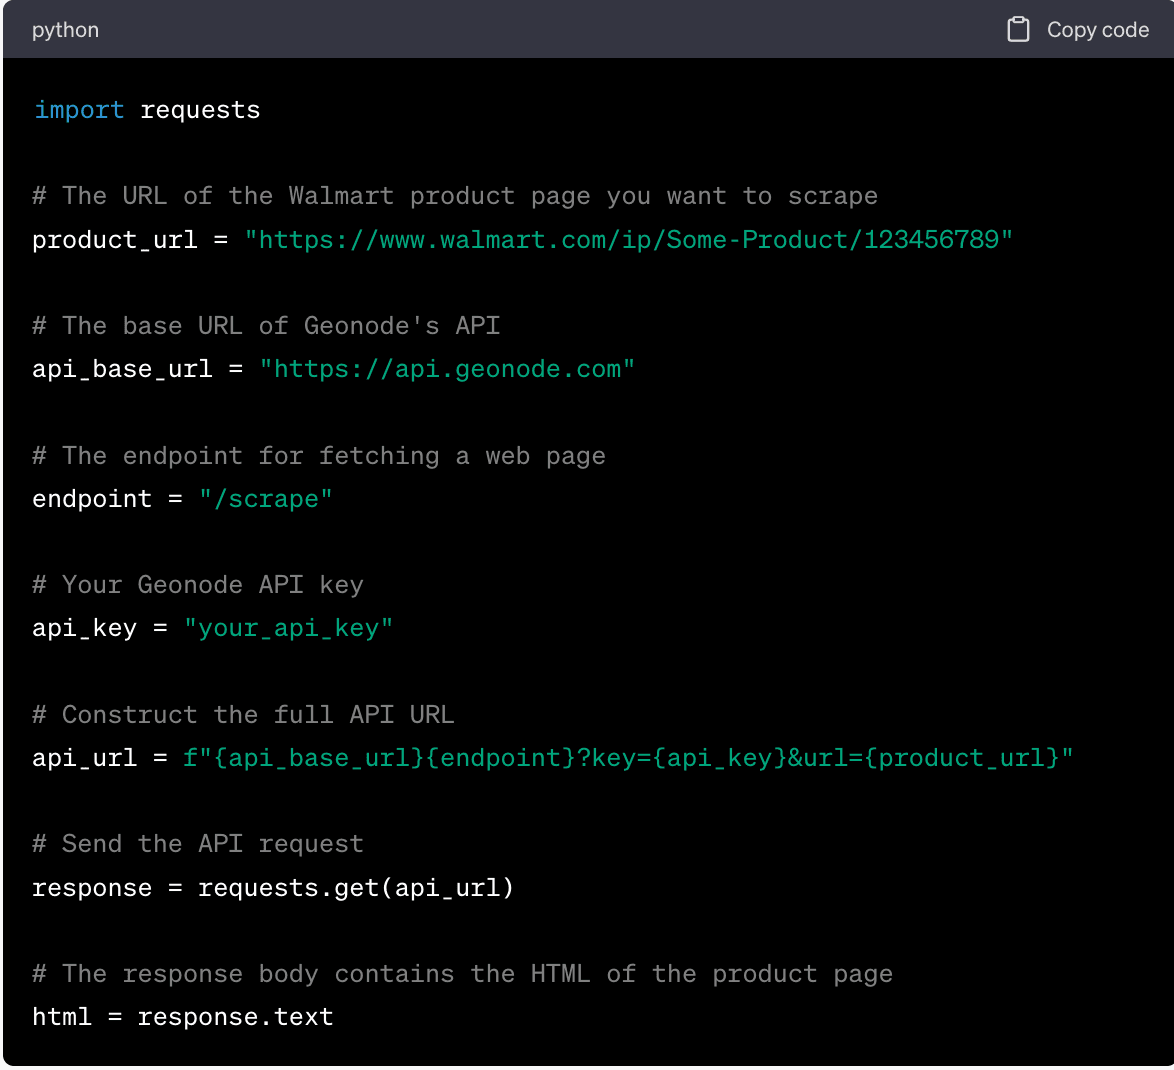
Para recuperar una página de producto de Walmart utilizando la API de scraping de Geonode, hay que enviar una solicitud HTTP GET a la API con la URL de la página de producto que se desea extraer. A continuación se ofrece una descripción general:
1. Identifica la URL de la página de producto. Identifica la URL de la página de producto de Walmart que deseas extraer. Para ello, acceda a la página del producto en su navegador web y copie la URL de la barra de direcciones.
2. Prepare la solicitud a la API. Cree la URL del punto final de la API, que incluye la URL base de la API de Geonode, el punto final para recuperar una página web y cualquier parámetro necesario. Uno de los parámetros será la URL de la página del producto de Walmart que deseas extraer.
3. Envía la solicitud a la API. Envía la solicitud a la API utilizando tu biblioteca de cliente HTTP. Para ello, deberás llamar a una función o método proporcionado por la biblioteca, pasarle la URL del punto final de la API y establecer el método en GET.
4. Gestiona la respuesta de la API. Una vez enviada la solicitud a la API, esta devolverá una respuesta. Dicha respuesta contendrá los datos de la página del producto de Walmart, normalmente en formato HTML. Tendrás que gestionar esta respuesta en tu código, lo que puede implicar analizar el código HTML y extraer los datos que te interesen.
A continuación se muestra un ejemplo de cómo se podría hacer esto en Python utilizando la biblioteca Requests:
Extracción de datos de la página del producto
Una vez que hayas obtenido una página de producto de Walmart mediante la API de scraping de Geonode, el siguiente paso es extraer los datos clave de la página. Esto suele implicar analizar el código HTML de la página y seleccionar los elementos que contienen los datos que te interesan.
A continuación se ofrece una descripción general de cómo se puede hacer esto:
1. Analizar el código HTML. El primer paso consiste en analizar el código HTML de la página. Esto implica convertir la cadena HTML en una estructura por la que puedas navegar y realizar búsquedas. El método específico para hacerlo puede depender del lenguaje de programación y de las bibliotecas que utilices. Por ejemplo, en Python, puedes utilizar la biblioteca BeautifulSoup para analizar el código HTML.
2. Identificar los puntos de datos. A continuación, tendrás que identificar los elementos HTML que contienen los puntos de datos que te interesan. Esto suele implicar inspeccionar el código HTML de la página y localizar las etiquetas, clases o identificadores de dichos elementos. Puedes hacerlo utilizando las herramientas de desarrollo de tu navegador web.
3. Selecciona los elementos. Una vez identificados los elementos, puedes seleccionarlos del código HTML analizado. Esto suele implicar llamar a una función o método proporcionado por tu biblioteca de análisis de HTML, pasando la etiqueta, la clase o el identificador del elemento. Esto devolverá el elemento y su contenido.
4. Extrae los datos. Una vez seleccionados los elementos, puedes extraer los datos de los mismos. Esto suele implicar llamar a una función o método proporcionado por tu biblioteca de análisis de HTML, pasando como parámetro el elemento. Esto devolverá los datos contenidos en el elemento.
A continuación se muestra un ejemplo de cómo se puede analizar HTML en Python utilizando la biblioteca BeautifulSoup:
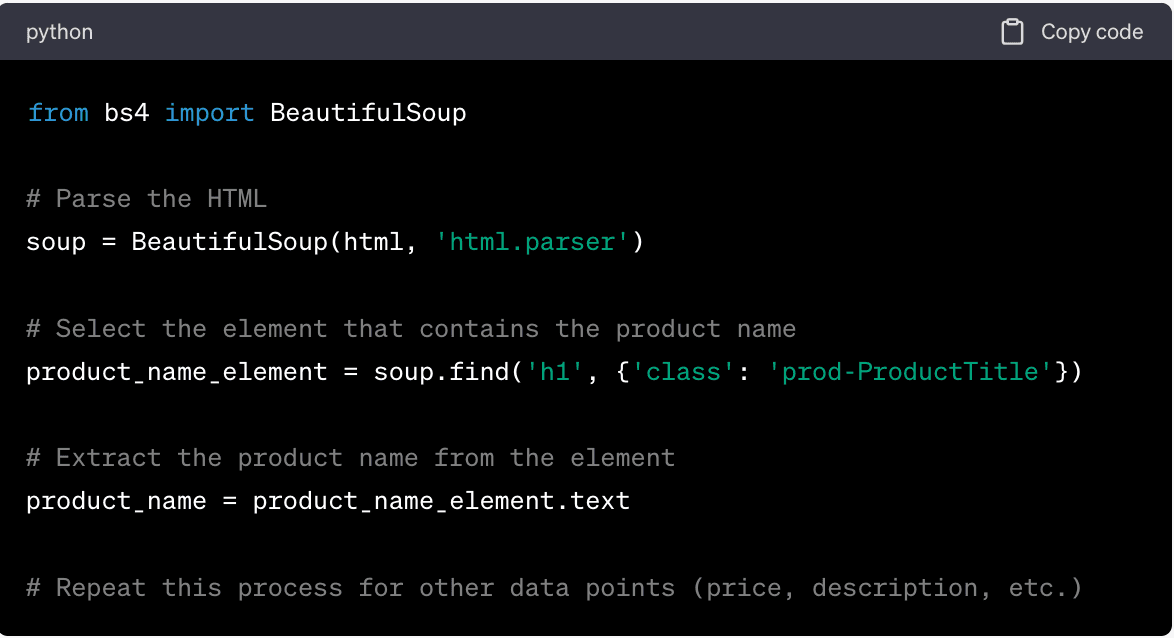
(Este es un ejemplo básico y la implementación real puede variar en función de la estructura específica de las páginas de productos de Walmart y de las características y capacidades de tu biblioteca de análisis de HTML. Consulta siempre la documentación oficial de tu biblioteca para obtener la información más precisa y actualizada.)
Análisis de los datos HTML y JSON
El análisis de datos HTML y JSON son tareas habituales en el web scraping. El análisis es el proceso de tomar datos sin procesar (en este caso, texto HTML o JSON) y convertirlos a un formato con el que sea más fácil trabajar en tu lenguaje de programación.
Análisis de HTML
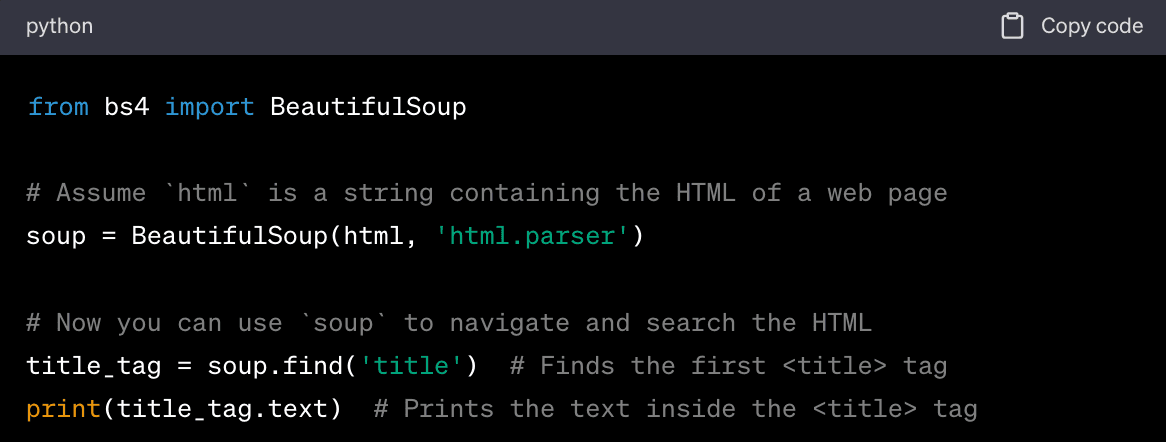
El HTML es el lenguaje de marcado estándar para crear páginas web. Utiliza etiquetas para indicar diferentes tipos de contenido, lo que hace que sea relativamente fácil navegar por él y extraer datos específicos.
A continuación se muestra un ejemplo de cómo se puede analizar HTML en Python utilizando la biblioteca BeautifulSoup:
Análisis de JSON
JSON (JavaScript Object Notation) es un formato ligero de intercambio de datos que resulta fácil de leer y escribir para las personas, y fácil de analizar y generar para las máquinas. Las API suelen utilizarlo para enviar datos.
A continuación se muestra un ejemplo de cómo se puede analizar JSON en Python:
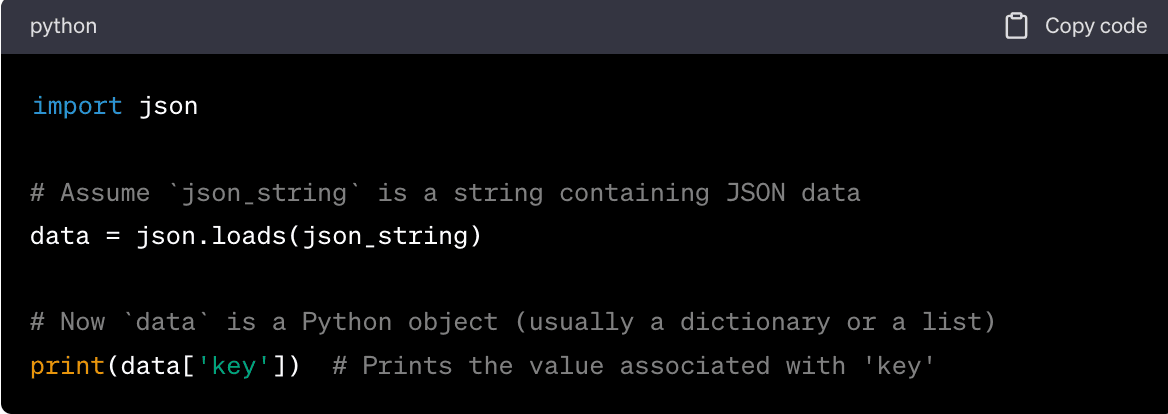
En ambos casos, el objetivo del análisis es convertir los datos HTML o JSON sin procesar a un formato con el que resulte más fácil trabajar en tu lenguaje de programación. Una vez analizados los datos, puedes explorarlos para encontrar los datos específicos que te interesan.
Consejos para gestionar datos de forma eficiente
Gestionar grandes cantidades de datos de forma eficiente es un aspecto crucial del web scraping en grandes plataformas de comercio electrónico como Walmart. A continuación te ofrecemos algunos consejos sobre cómo manejar grandes conjuntos de datos:
• Utiliza una base de datos. Almacenar los datos en una base de datos puede facilitar su gestión, especialmente si se trata de grandes cantidades de datos. Las bases de datos están diseñadas para gestionar grandes conjuntos de datos y ofrecen funciones como la indexación, que permite realizar consultas más rápidas.
• Procesamiento por lotes. En lugar de procesar cada punto de datos a medida que se extrae, plantéate recopilar los datos en lotes y procesar cada lote de una sola vez. Esto puede resultar más eficiente y reducir la carga sobre tu sistema.
• Compresión de datos. Si el espacio de almacenamiento es un problema, plantéate comprimir tus datos. Muchos formatos de datos comunes, como CSV y JSON, pueden comprimirse hasta alcanzar una fracción de su tamaño original.
• Procesamiento paralelo. Si estás extrayendo datos de varias páginas o sitios web a la vez, plantéate utilizar el procesamiento paralelo para acelerar el proceso. Esto implica ejecutar varias tareas de extracción simultáneamente, lo que puede reducir significativamente el tiempo total de extracción.
• Extracción incremental. En lugar de extraer todos los datos de una sola vez, plantéate hacerlo de forma incremental. Esto implica llevar un registro de los datos que ya has extraído y extraer únicamente los datos nuevos o actualizados. Esto puede resultar más eficiente y reducir la carga tanto en tu sistema como en el sitio web del que estás extrayendo datos.
• Utiliza una solución basada en la nube. Las soluciones basadas en la nube pueden proporcionar almacenamiento y potencia de procesamiento escalables, lo que puede resultar especialmente útil al gestionar grandes cantidades de datos. Servicios como Amazon Web Services (AWS), Google Cloud y Microsoft Azure ofrecen diversas soluciones de almacenamiento y procesamiento de datos capaces de gestionar grandes conjuntos de datos.
• Limpieza y validación de datos. Limpia y valida tus datos lo antes posible en el flujo de datos. Esto puede incluir la eliminación de duplicados, el tratamiento de valores perdidos y la comprobación de la coherencia de los datos. Limpiar y validar tus datos desde el principio puede evitar errores e ineficiencias más adelante.
Recuerda que el objetivo es gestionar tus datos de una forma eficiente, escalable y adecuada a tus necesidades específicas. El mejor enfoque puede depender del tamaño de tu conjunto de datos, de los recursos de los que dispongas y de los requisitos específicos de tu proyecto.
Cómo evitar que te bloqueen
Aunque el web scraping es una herramienta muy eficaz para extraer datos de sitios web, Walmart no ve con buenos ojos esta práctica.
A continuación, te indicamos algunos motivos habituales por los que te pueden bloquear al realizar web scraping, junto con consejos para evitarlos:
• Demasiadas solicitudes. Enviar demasiadas solicitudes en un breve periodo de tiempo puede sobrecargar los servidores de Walmart y afectar negativamente al rendimiento del sitio web. A menudo se considera una forma de abuso y es un motivo habitual para que te bloqueen. Para evitarlo, limita la frecuencia de tus solicitudes e introduce retrasos entre ellas.
• Ignorar el archivo robots.txt. El archivo robots.txt es una forma que tienen los sitios web de comunicarse con los rastreadores y los programas de extracción de datos. Especifica qué partes del sitio web no deben ser objeto de extracción. Ignorar las reglas de este archivo puede provocar que tu programa de extracción de datos sea bloqueado. Comprueba y respeta siempre el archivo robots.txt del sitio web del que estás extrayendo datos.
• No rotar las direcciones IP. Si todas tus solicitudes proceden de la misma dirección IP, puede ser una señal clara de que estás extrayendo datos del sitio web. Walmart bloqueará tu dirección IP si envía demasiadas solicitudes. Para evitarlo, plantéate utilizar un conjunto de proxies residenciales rotativos para distribuir tus solicitudes entre varias direcciones IP.
- La API de scraping de Geonode utiliza un conjunto de proxies rotativos. Cada solicitud que envías a través de la API se realiza desde una dirección IP diferente. Esto puede ayudar a evitar el bloqueo basado en la IP y la limitación de velocidad, ya que dificulta que los sitios web identifiquen y bloqueen tu scraper. La rotación de IP también ayuda a distribuir tus solicitudes de forma más uniforme, reduciendo la carga sobre cualquier servidor concreto y haciendo que tu scraping sea más eficiente.
• No utilizar una cadena User-Agent o utilizar una sospechosa. La cadena User-Agent indica al sitio web qué tipo de dispositivo y navegador está realizando la solicitud. Sitios web como Walmart bloquearán las solicitudes que no incluyan una cadena User-Agent o que utilicen una cadena User-Agent conocida por estar asociada a rastreadores. Utiliza una cadena «User-Agent» legítima que imite a un navegador real.
• Extraer datos protegidos. Algunos datos de un sitio web pueden estar protegidos por derechos de autor u otras protecciones legales. Extraer estos datos puede dar lugar a que te bloqueen y también puede acarrear consecuencias legales. Asegúrate siempre de que tienes derecho a extraer y utilizar los datos que te interesan.
Por supuesto, la mejor forma de evitar que te bloqueen es extraer datos de forma responsable. Respeta las normas del sitio web, no sobrecargues el servidor y asegúrate siempre de que tienes derecho a extraer y utilizar los datos que te interesan.

