Los procesos ETL son esenciales porque ofrecen un enfoque optimizado para el procesamiento de datos, lo que permite a las empresas obtener información sobre sus operaciones y tomar decisiones fundamentadas.
Un ejemplo de proceso ETL es el que utiliza una empresa minorista para extraer datos de ventas de una base de datos, transformarlos a un formato adecuado para su análisis y cargarlos en un almacén de datos con fines de inteligencia empresarial.
El proceso podría utilizar una herramienta como Apache NiFi o Talend para extraer los datos, transformarlos mediante herramientas como Apache Spark o Python, y cargarlos en un almacén de datos como Amazon Redshift o Google BigQuery.
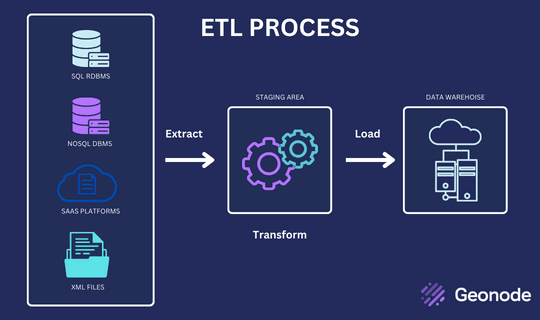
3 Los componentes de un proceso ETL
El funcionamiento de un proceso ETL consta de tres componentes principales: extracción, transformación y carga.
Extracción
La fase de extracción consiste en obtener datos de diversas fuentes, como bases de datos, almacenamiento en la nube, API y archivos planos. Los datos extraídos pueden estar en diferentes formatos, como JSON, CSV o XML.
Transformación
La fase de transformación consiste en convertir los datos extraídos a un formato utilizable, limpiarlos y enriquecerlos con información adicional. Esta fase implica la aplicación de diversas técnicas de procesamiento de datos, como el filtrado, la agregación, la unión y la clasificación.
Carga
La fase de carga consiste en almacenar los datos transformados en un destino final, como una base de datos, un almacén de datos o un lago de datos. Los datos cargados pueden utilizarse para diversos fines, como la elaboración de informes, el análisis o el aprendizaje automático.
Canalización de datos frente a canalización ETL
Una canalización de datos es un término general que hace referencia a una serie de pasos o procesos utilizados para trasladar datos de un sistema o aplicación a otro. Puede incluir diversos componentes, como la ingesta, el procesamiento, el almacenamiento y el análisis de datos.
Un proceso ETL (Extract, Transform, Load) es un tipo específico de proceso de datos que se utiliza para extraer datos de una o más fuentes, transformarlos en un formato más útil o estructurado y cargarlos en un sistema o aplicación de destino. Los procesos ETL se utilizan habitualmente para aplicaciones de almacenamiento de datos, inteligencia empresarial y análisis.
Aunque los flujos de trabajo ETL son un tipo específico de flujo de datos, en la práctica ambos términos suelen utilizarse indistintamente. Un flujo de datos es, en general, cualquier conjunto de procesos o herramientas que se utilizan para trasladar, procesar y analizar datos. Por el contrario, un flujo de trabajo ETL se refiere específicamente a la extracción de datos, la transformación y la carga.
Tipos de procesos ETL
Los dos tipos distintos de procesos ETL (Extracción, Transformación, Carga) son:
Procesamiento por lotes: este tipo de canalización consiste en procesar grandes volúmenes de datos por lotes, normalmente de forma diaria o semanal. Los datos se extraen de los sistemas de origen, se transforman al formato deseado y se cargan en un sistema de destino mediante un proceso por lotes. El ETL por lotes resulta útil para el almacenamiento de datos, la inteligencia empresarial y las aplicaciones analíticas.
Procesamiento en tiempo real: este tipo de canalización consiste en procesar los datos casi en tiempo real, a medida que se generan o se reciben desde el sistema de origen. Los datos se extraen de los sistemas de origen, se transforman en tiempo real y se cargan en un sistema de destino mediante un proceso continuo.
Las ventajas de utilizar un proceso ETL
Los procesos ETL ofrecen varias ventajas, entre las que se incluyen:
Procesamiento de datos optimizado
Los procesos ETL proporcionan un enfoque optimizado para el procesamiento de datos, lo que permite a las empresas procesar grandes cantidades de datos de forma rápida y eficiente.
Mejora de la calidad de los datos
Los procesos ETL permiten a las empresas mejorar la calidad de sus datos al eliminar registros duplicados, corregir errores y aplicar normas de datos.
Reducción de la complejidad
Los procesos ETL reducen la complejidad del procesamiento de datos al proporcionar una única interfaz para gestionar las tareas de integración de datos.
Mejora de la toma de decisiones
Los flujos de trabajo ETL proporcionan a las empresas información oportuna, precisa y útil sobre sus operaciones, lo que les permite tomar decisiones fundamentadas.
Lenguajes ETL
Los procesos ETL pueden implementarse utilizando diversos lenguajes de programación y herramientas, en función de los requisitos específicos del proceso y de las tecnologías que se utilicen. Entre los lenguajes y herramientas ETL más habituales se incluyen:
SQL (Structured Query Language): SQL es un lenguaje estándar que se utiliza para gestionar y consultar datos en bases de datos relacionales. Los procesos ETL suelen utilizarlo para extraer y transformar datos de las bases de datos.
Python: Python es un lenguaje de programación muy popular que se utiliza para una amplia gama de tareas de procesamiento y análisis de datos, incluidos los flujos de trabajo ETL. Python cuenta con numerosas bibliotecas y marcos de trabajo disponibles para la manipulación, transformación y carga de datos, como Pandas, NumPy y Apache Airflow.
Java: Java es un lenguaje de programación muy extendido que puede utilizarse para crear flujos ETL. Existen varias herramientas ETL basadas en Java, como Apache NiFi, Talend y Apache Beam.
R: R es un lenguaje de programación que se utiliza habitualmente para el análisis estadístico y la visualización de datos. Cuenta con numerosas bibliotecas y paquetes disponibles para la manipulación y transformación de datos, y puede utilizarse para crear procesos ETL.
Herramientas ETL: También existen numerosas herramientas ETL que ofrecen una interfaz gráfica de usuario para crear y gestionar flujos de trabajo ETL, como Talend, Informatica y Microsoft SSIS. Estas herramientas suelen ser compatibles con diversos lenguajes de programación y fuentes de datos, y pueden simplificar el proceso de creación y mantenimiento de flujos de trabajo ETL.
Buenas prácticas para el diseño y la implementación de procesos ETL
Las empresas deben seguir ciertas buenas prácticas para garantizar el éxito de un proceso ETL, entre las que se incluyen:
Definir las fuentes de datos y los requisitos
Antes de diseñar un proceso ETL, las empresas deben definir sus fuentes de datos y sus requisitos. Esto implica identificar las fuentes de datos que deben integrar, sus formatos de datos y los estándares de calidad de datos que deben cumplir.
Elegir las herramientas adecuadas
Elegir las herramientas adecuadas es fundamental para diseñar e implementar un proceso ETL. Además, las empresas deben tener en cuenta la escalabilidad, la flexibilidad y la rentabilidad de las herramientas elegidas.
Crea un flujo de datos claro
Un flujo de datos claro es esencial para diseñar un proceso ETL eficiente y eficaz. Además, el flujo de datos debe ser fácil de entender, y las diferentes etapas del proceso deben estar claramente definidas.
Implementa un manejo robusto de los errores
Un manejo robusto de los errores es esencial para garantizar la fiabilidad de un proceso ETL. Por lo tanto, las empresas deben implementar mecanismos de gestión de errores capaces de detectar y resolver los errores.
Probar y supervisar el proceso de forma regular
Probar y supervisar un proceso ETL de forma regular es esencial para garantizar su eficacia e identificar posibles incidencias antes de que causen problemas.
Retos habituales de los procesos ETL y cómo superarlos
A pesar de sus ventajas, los procesos ETL también pueden plantear ciertos retos, entre los que se incluyen:
Inconsistencias en los datos
Las inconsistencias en los datos pueden producirse cuando las fuentes de datos utilizadas en un proceso ETL contienen errores o inconsistencias. Para solucionar este problema, es necesario llevar a cabo comprobaciones de calidad de los datos y aplicar mecanismos de limpieza.
Problemas de calidad de los datos
Los problemas de calidad de los datos pueden surgir cuando los datos utilizados en un proceso ETL son de mala calidad o contienen inexactitudes. Las empresas deben implementar comprobaciones de calidad de los datos y mecanismos de validación para garantizar la precisión y la coherencia de los datos.
Cuellos de botella en el rendimiento
Los cuellos de botella en el rendimiento pueden producirse cuando un proceso ETL está sobrecargado o cuando no es capaz de escalar para gestionar un mayor volumen de datos. Para evitar este problema, las empresas deben optimizar sus procesos ETL en cuanto a rendimiento y escalabilidad.
Escalabilidad limitada
La escalabilidad limitada puede darse cuando un proceso ETL es incapaz de gestionar grandes volúmenes de datos. Los procesos ETL deben diseñarse para ser escalables y utilizar tecnologías de computación distribuida para resolver este problema.
Conclusión
En conclusión, un proceso ETL es un componente fundamental de un sistema integral de procesamiento de datos. Permite a las empresas recopilar, transformar y cargar grandes cantidades de datos procedentes de diversas fuentes, así como obtener información valiosa sobre sus operaciones. Sin embargo, para diseñar e implementar un proceso ETL eficaz, las empresas deben seguir ciertas prácticas recomendadas, como definir sus fuentes de datos y requisitos, elegir las herramientas adecuadas, crear un flujo de datos claro, implementar un sistema robusto de gestión de errores y realizar pruebas y supervisar su proceso de forma regular.
Preguntas frecuentes
-
¿En qué se diferencia el ETL del «data pipeline»?
El ETL y el «data pipeline» son dos conceptos relacionados, pero distintos. ETL son las siglas de «Extract, Transformar y Cargar, y hace referencia a un proceso específico que consiste en extraer datos de diversas fuentes, transformarlos a un formato utilizable y cargarlos en un destino final. Por otro lado, un «data pipeline» se refiere a un concepto más amplio que consiste en mover datos entre diferentes sistemas y aplicaciones, y que puede incluir el proceso ETL como un subconjunto del proceso global.
-
¿Es SQL una herramienta ETL?
SQL no es una herramienta ETL en sí misma, pero se utiliza habitualmente en los procesos ETL para manipular y transformar datos. SQL puede utilizarse para realizar diversas transformaciones de datos, como filtrar, agregar y unir registros, que son componentes esenciales de la fase de transformación en un pipeline ETL.
-
¿Cómo se crea un proceso ETL?
La creación de un proceso ETL implica varios pasos, entre los que se incluyen definir las fuentes de datos y los requisitos, elegir las herramientas adecuadas, crear un flujo de datos claro, implementar un manejo de errores robusto y realizar pruebas y supervisión periódicas del proceso. Entre las herramientas más habituales para crear procesos ETL se encuentran Apache Kafka, Apache Spark y Talend Open Studio.
-
¿Qué es el ETL en DevOps?
En DevOps, ETL se refiere al proceso de integrar datos de diversas fuentes en el proceso de DevOps. Esto puede incluir la extracción de datos de repositorios de código fuente, herramientas de compilación y marcos de automatización de pruebas, su transformación a un formato utilizable y su carga en un destino final, como un almacén de datos o una herramienta de inteligencia empresarial. El ETL en DevOps es esencial para proporcionar a los equipos información en tiempo real sobre sus procesos de desarrollo de software y permitirles tomar decisiones basadas en datos.
Referencias
Sharma, V. (13 de junio de 2022). Guía completa sobre cómo crear un proceso ETL para principiantes. Analytics Vidhya. Consultado el 10 de marzo de 2023, en https://www.analyticsvidhya.com/blog/2022/06/a-complete-guide-on-building-an-etl-pipeline-for-beginners/
¿Qué es un proceso ETL? (s. f.). Snowflake. Consultado el 10 de marzo de 2023, en https://www.snowflake.com/guides/etl-pipeline
¿Qué es un proceso ETL? Comparación entre un proceso de datos y un proceso ETL. (s. f.). Qlik. Consultado el 10 de marzo de 2023, en https://www.qlik.com/us/etl/etl-pipeline

