Immobiliare.it est l'une des principales plateformes immobilières en ligne d'Italie.
Avec un vaste choix d'annonces comprenant des biens résidentiels, commerciaux et de vacances, ce site web constitue une ressource complète pour toute personne souhaitant investir dans l'immobilier italien.
Pour les agents immobiliers et les acheteurs américains, Immobiliare.it offre une opportunité unique d'accéder à un marché diversifié qui peut s'avérer difficile à appréhender depuis l'étranger.
L'importance des données immobilières
Dans le secteur immobilier, les données sont primordiales. Des informations précises et actualisées peuvent faire la différence entre un investissement réussi et une erreur coûteuse.
Pour les agents immobiliers américains et les acheteurs immobiliers, comprendre le marché italien nécessite une source de données fiable.
Immobiliare.it répond à ce besoin en proposant des annonces immobilières, des tendances de prix, des informations sur les quartiers, et bien plus encore.
Les filtres de recherche performants de la plateforme permettent aux utilisateurs d’affiner leurs options en fonction de divers critères, tels que l’emplacement, le type de bien et la fourchette de prix, ce qui facilite la recherche de biens répondant à des objectifs d’investissement spécifiques.
Cas d’utilisation des données immobilières d’Immobiliare.it
-
Études de marché. Les agents immobiliers américains peuvent utiliser ces données pour mieux comprendre le marché immobilier italien, en identifiant les tendances et les opportunités susceptibles de profiter à leurs clients.
-
Décisions d’investissement. Les acheteurs immobiliers américains peuvent utiliser Immobiliare.it pour prendre des décisions d’investissement éclairées. L
Les données de la plateforme peuvent aider à repérer des biens sous-évalués, des quartiers en plein essor ou des locations de vacances rentables.
-
Analyse comparative. Les données peuvent servir à comparer le marché italien au marché américain.
Cela s’avère particulièrement utile pour les investisseurs cherchant à diversifier leur portefeuille à l’international.
-
Services à la clientèle. Les agents immobiliers peuvent proposer des services supplémentaires à leurs clients américains intéressés par le marché italien, tels que des rapports et des analyses personnalisés basés sur les données d’Immobiliare.it.
-
Stratégie marketing. En extrayant les données d’Immobiliare.it, les entreprises peuvent identifier les tendances actuelles en matière de caractéristiques et d’emplacements immobiliers, ce qui les aide à élaborer une stratégie de marché plus efficace.
Cette approche peut rendre les sites web immobiliers plus compétitifs sur le marché.
-
Analyse des prix. L'extraction des données sur les prix et de l'historique des prix d'Immobiliare.it permet une analyse complète des prix.
Comprendre les fluctuations des prix du marché, les nouveaux prix et les prix actuels du marché peut aider les entreprises et les consommateurs à prendre des décisions plus éclairées.
-
Informations juridiques et réglementaires. Immobiliare.it propose souvent des articles et des ressources expliquant les lois et réglementations immobilières italiennes, ce qui peut s’avérer inestimable pour les investisseurs américains peu familiers avec le paysage juridique italien.
En tirant parti des données et des ressources disponibles sur Immobiliare.it, les agents immobiliers et les acheteurs américains peuvent acquérir un avantage concurrentiel sur un marché à la fois exigeant et gratifiant.
Aspects juridiques
Lorsqu'il s'agit de collecter des données sur des plateformes en ligne, il est essentiel de bien comprendre le cadre juridique et éthique afin de s'assurer que vous agissez dans le respect de la loi et des droits des propriétaires des données.
Est-il légal d'effectuer du scraping sur Immobiliare.it ?
Avant de procéder au scraping d'un site web, il est essentiel de consulter son fichier robots.txt, qui définit les règles applicables aux robots d'indexation.
Le fichier robots.txt d’Immobiliare.it contient plusieurs directives « Disallow », indiquant les zones du site web qui ne doivent pas être scrapées.
Par exemple, il interdit notamment le scraping des cartes de recherche, des espaces utilisateurs et de certains types d’annonces.
Le non-respect de ces règles pourrait entraîner une exclusion du site ou des poursuites judiciaires.
Il est donc essentiel de respecter les directives énoncées dans le fichier robots.txt lorsque l’on envisage toute activité de collecte de données sur Immobiliare.it.
Considérations éthiques
Au-delà des aspects juridiques, des considérations éthiques entrent également en jeu lors de l’extraction de données à partir de sites web.
Une extraction de données éthique respecte à la fois la lettre et l’esprit de la loi, ainsi que le fichier robots.txt du site web, qui précise les zones du site qui ne doivent pas être exploitées.
De plus, un scraping éthique implique de ne pas surcharger les serveurs du site web, de respecter la vie privée des utilisateurs et d’utiliser les données de manière responsable.
Le non-respect de ces principes éthiques peut nuire à votre réputation et pourrait également avoir des répercussions juridiques.
Aperçu de la légalité du web scraping
Voici trois articles traitant de la légalité du web scraping, accompagnés de leurs résumés :
La Cour d’appel du neuvième circuit des États-Unis a statué que l’extraction de données accessibles au public ne constituait pas une violation de la loi sur la fraude et les abus informatiques (Computer Fraud and Abuse Act, CFAA). Cette décision revêt une importance particulière pour les archivistes, les universitaires, les chercheurs et les journalistes qui utilisent des outils de web scraping.
Toutefois, l’article mentionne également que le web scraping a, dans certains cas, soulevé des préoccupations en matière de confidentialité et de sécurité. L’affaire avait initialement été portée devant les tribunaux par LinkedIn contre Hiq Labs, une entreprise qui avait extrait les profils d’utilisateurs de LinkedIn. LinkedIn avait perdu le procès en 2019, et la Cour d’appel du neuvième circuit a confirmé sa décision initiale.
Cet article indique qu’il n’existe aucune loi fédérale interdisant le web scraping aux États-Unis tant que les données extraites sont accessibles au public.
Il souligne toutefois l’importance des considérations éthiques et conseille aux praticiens du web scraping d’opérer dans le respect des conditions d’utilisation et des fichiers robots.txt des sites web.
L'article explique que, selon la plupart des législations, la collecte, l'utilisation ou le stockage d'informations personnelles identifiables (PII) sans le consentement explicite de leur propriétaire sont illégaux.
Il mentionne également que le web scraping peut parfois se situer dans des zones grises juridiques, en particulier lorsqu'il implique la collecte d'informations sensibles.
Outils et technologies utilisés pour la collecte de données
Dans le domaine du web scraping, il existe une grande variété d’outils et de technologies adaptés à différents besoins. Que vous soyez débutant ou data scientist expérimenté, vous trouverez certainement un outil qui répondra aux exigences de votre projet. Nous vous présentons ci-dessous certains des outils les plus couramment utilisés. 
Bibliothèques Python (BeautifulSoup, Selenium)
Python est un langage très répandu pour le web scraping, et il propose plusieurs bibliothèques pour faciliter le processus :
-
BeautifulSoup : Il s’agit d’une bibliothèque Python permettant d’extraire des données de fichiers HTML et XML. Elle fournit des idiomes Python pour itérer, rechercher et modifier l’arbre d’analyse.
BeautifulSoup est souvent utilisée pour le web scraping afin d’extraire des données de pages web et est relativement facile à prendre en main pour les débutants.
-
Selenium : Contrairement à BeautifulSoup, qui se contente d’extraire le code source, Selenium interagit avec la page web exactement comme le ferait un utilisateur humain.
Il est souvent utilisé pour le web scraping de sites web dynamiques dont le contenu est chargé via JavaScript et peut également servir aux tests automatisés.
Ces deux bibliothèques peuvent être utilisées conjointement, offrant ainsi une boîte à outils puissante pour tout projet de web scraping.
Services de web scraping
Les services de web scraping constituent une alternative pratique pour ceux qui préfèrent ne pas se lancer dans la programmation.
Ces services sont souvent dotés d’interfaces utilisateur intuitives qui vous permettent de spécifier les données que vous souhaitez extraire, sans avoir à écrire la moindre ligne de code.
Ils prennent tout en charge, de l’extraction à le stockage des données, ce qui vous permet de vous concentrer plus facilement sur l’analyse et l’exploitation de ces données. P
Référentiels GitHub à consulter
GitHub est une véritable mine d’or de ressources pour le web scraping. Vous y trouverez de nombreux référentiels proposant des scripts de scraping prêts à l’emploi, des frameworks et des tutoriels.
Voici quelques types de référentiels qui pourraient vous être utiles :
-
Dépôts de tutoriels. Ces dépôts fournissent des guides étape par étape et des extraits de code pour vous aider à vous lancer dans le web scraping.
-
Dépôts de frameworks. Ceux-ci contiennent des frameworks prêts à l’emploi conçus pour extraire des types spécifiques de sites web ou de données.
-
Référentiels de projets. Il s’agit de projets à part entière qui illustrent des tâches de scraping plus complexes, impliquant souvent plusieurs sites web ou technologies.
En étudiant ces référentiels, vous pourrez vous familiariser avec les meilleures pratiques et les techniques avancées en matière de web scraping.
Guide étape par étape
Cette section propose un guide complet expliquant comment collecter des données sur Immobiliare.it à l’aide de bibliothèques Python et d’autres outils.
Suivez ces étapes pour configurer votre environnement, écrire le code et découvrir des exemples sur GitHub afin d’approfondir vos connaissances.
Configuration de l'environnement
-
Installez Python. Si ce n'est pas déjà fait, téléchargez et installez Python depuis le site officiel.
-
Installez les bibliothèques. Ouvrez votre terminal et installez BeautifulSoup et Selenium en exécutant les commandes suivantes :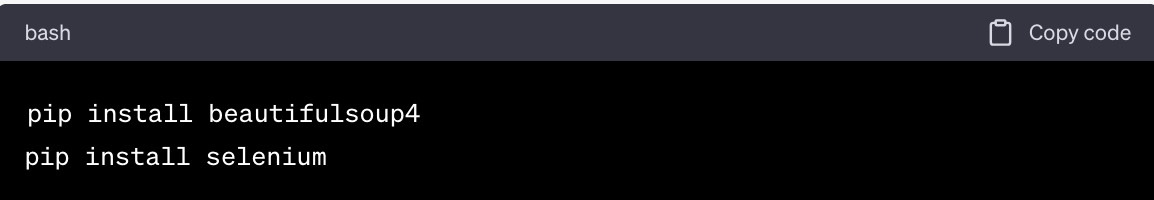
-
Pilote Web. Téléchargez le pilote Web compatible avec votre navigateur (par exemple, ChromeDriver pour Chrome) et placez-le dans le répertoire de votre projet.
-
Clé API pour Geonode. Si vous utilisez le scraper Pay-As-You-Go d’Geonode, demandez une clé API sur leur site web.
Écriture du code permettant de collecter des données sur Immobiliare.it
-
Importer les bibliothèques. Importez les bibliothèques Python nécessaires au début de votre script.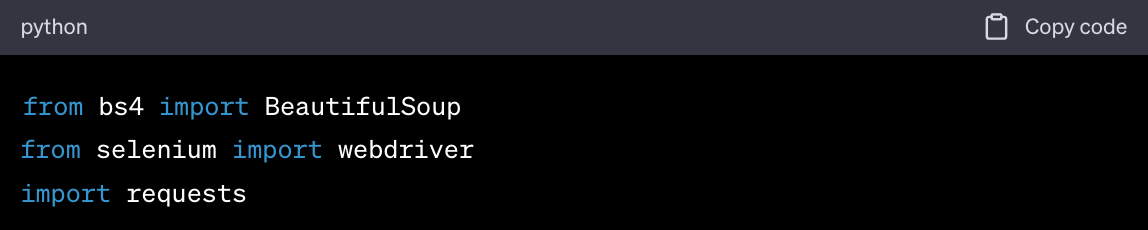
-
Initialiser WebDriver. Initialisez Selenium WebDriver. 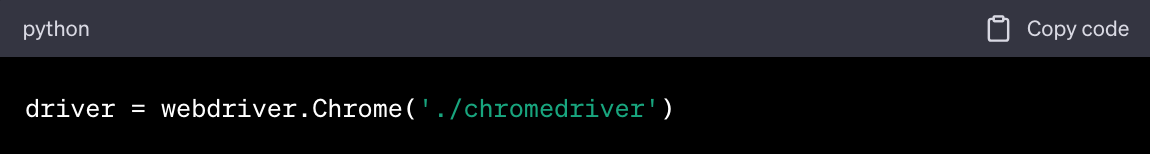
-
Accéder à Immobiliare.it. Utilisez WebDriver pour accéder à la page Web d’Immobiliare.it que vous souhaitez extraire. 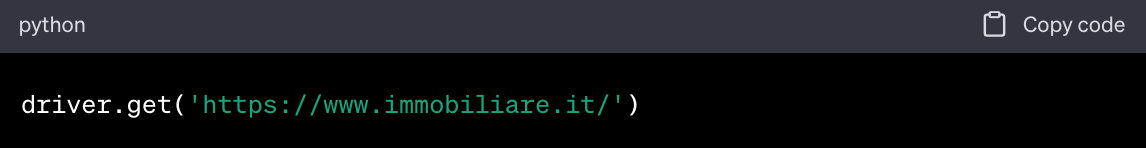
-
Localiser les éléments. Utilisez BeautifulSoup ou les fonctions de Selenium pour localiser les éléments HTML contenant les données que vous souhaitez extraire.
-
Extrayez les données. Extrayez les données et stockez-les dans une variable ou un fichier.
-
APIGeonode. Si vous utilisez Geonode, effectuez un appel API pour gérer les proxys, les navigateurs et les captchas.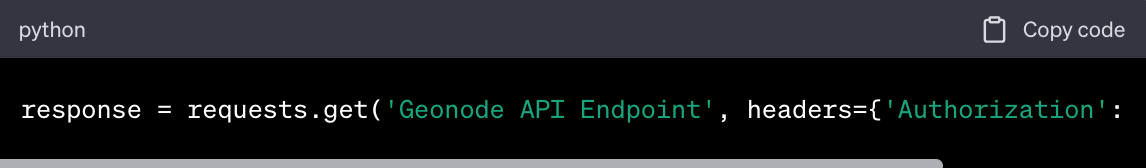
-
Fermez WebDriver. N’oubliez pas de fermer WebDriver une fois que vous avez terminé 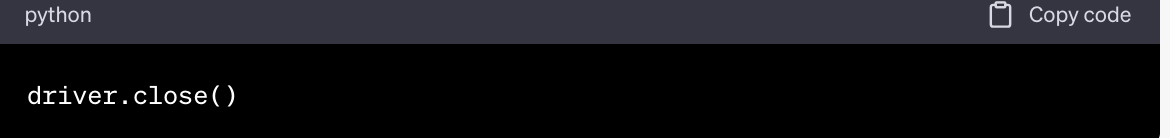
Exemples et tutoriels sur GitHub
-
Recherchez des dépôts. Utilisez la fonctionnalité de recherche de GitHub pour trouver des dépôts liés au web scraping avec Python, BeautifulSoup et Selenium.
-
Étudiez le code. Recherchez des exemples spécialement conçus pour les sites immobiliers ou Immobiliare.it.
-
Suivez les tutoriels. Certains dépôts GitHub proposent des tutoriels étape par étape qui peuvent vous aider à mieux comprendre le code.
-
Clonez et expérimentez. N’hésitez pas à cloner des dépôts et à modifier le code pour l’adapter à vos besoins spécifiques.
Techniques avancées
À mesure que vous vous familiariserez avec les techniques de base du web scraping, vous pourriez être amené à relever des défis plus complexes. Cette section présente quelques techniques avancées qui peuvent vous aider à gérer ces situations plus compliquées.
Gestion des sites web dynamiques
Les sites web dynamiques chargent leur contenu de manière asynchrone, souvent à l’aide de JavaScript. Cela peut rendre le scraping plus difficile. Voici quelques techniques avancées pour gérer les sites web dynamiques :
-
Selenium WebDriver. Comme mentionné précédemment, Selenium peut interagir avec des pages web dynamiques, ce qui vous permet d’extraire des données chargées via JavaScript.
-
Navigation en mode « headless ». Utilisez des navigateurs « headless » tels que PhantomJS ou exécutez Selenium en mode « headless » pour extraire des données de sites web sans ouvrir de fenêtre de navigateur.
-
Requêtes AJAX. Certains sites web chargent des données via des requêtes AJAX. Vous pouvez utiliser des outils de développement pour inspecter ces requêtes et les reproduire à l’aide de la bibliothèque requests de Python.
-
Commandes d’attente. Utilisez les commandes d’attente explicites et implicites de Selenium pour vous assurer que la page web s’est entièrement chargée avant de procéder au scraping.
Extraction de données sur les agents immobiliers
L'extraction de données relatives aux agents immobiliers peut s'avérer un peu plus complexe en raison de la précision requise et des considérations éthiques qui entrent en jeu. Voici quelques conseils :
-
Ciblez des sections spécifiques. Utilisez BeautifulSoup ou des expressions XPath pour cibler des sections spécifiques d'un site web où sont stockées les données des agents.
-
Pagination. De nombreux sites web répertorient les agents sur plusieurs pages. Assurez-vous que votre code est capable de naviguer à travers cette pagination.
-
Limitation du débit. Respectez les conditions générales d’utilisation du site web. Intégrez une limitation du débit dans votre code pour éviter de surcharger leurs serveurs.
-
Validation des données. Validez toujours les données que vous avez extraites pour vous assurer qu’elles sont exactes et complètes.
Conseils de StackOverflow sur la gestion des modifications de code
Les sites web mettent fréquemment à jour leur structure HTML, ce qui peut rendre votre code de scraping inopérant. Voici comment vous pouvez vous adapter :
-
Mises à jour régulières : Suivez de près les fils de discussion StackOverflow liés au site web que vous scrapez. Les utilisateurs y partagent souvent des informations sur les modifications apportées à la structure des sites.
-
Gestion des erreurs : intégrez une gestion robuste des erreurs dans votre code afin d’être alerté en cas d’échec du scraping, ce qui vous permettra de mettre à jour votre code en conséquence.
-
Conseils de la communauté : StackOverflow est un excellent endroit pour trouver des solutions de contournement ou des méthodes alternatives de scraping lorsqu’un site web modifie la structure de son code.
En maîtrisant ces techniques avancées, vous serez mieux préparé à relever un large éventail de défis liés au web scraping. Que vous ayez affaire à du contenu dynamique, à des données spécialisées ou à des structures de sites web changeantes, ces méthodes vous apporteront les compétences nécessaires pour une collecte de données efficace.
Analyse et exploitation des données
Une fois que vous avez réussi à collecter des données, l'étape suivante consiste à les analyser et à les exploiter efficacement.
Cette section vous guidera tout au long du processus d’analyse des données extraites, de création de votre propre modèle de tarification, ainsi que de création et de mise à jour des profils d’offres.
Comment analyser les données extraites
-
Nettoyage des données. La première étape de tout processus d’analyse des données consiste à nettoyer celles-ci. Supprimez les doublons, traitez les valeurs manquantes et convertissez les types de données si nécessaire.
-
Visualisation des données. Utilisez des bibliothèques telles que Matplotlib ou Seaborn pour visualiser les données. Cela peut vous aider à identifier des tendances, des valeurs aberrantes ou des schémas récurrents.
-
Analyse statistique. Utilisez des méthodes statistiques pour résumer les données. Calculez les moyennes, les médianes, les écarts-types, etc., afin de mieux comprendre la distribution des données.
-
Analyse de texte. Si vous avez extrait des données textuelles, envisagez d’utiliser des techniques de traitement du langage naturel (NLP) pour en tirer des enseignements.
-
Analyse de corrélation. Identifiez les variables fortement corrélées entre elles. Cela peut s’avérer particulièrement utile dans l’immobilier pour comprendre comment différents facteurs influencent les prix des biens immobiliers.
Défis courants et solutions
Le web scraping n'est pas sans difficultés. Des CAPTCHA aux limites de débit, en passant par les préoccupations liées à la qualité et à la fiabilité des données, cette section a pour objectif de vous préparer à certains des obstacles que vous pourriez rencontrer et de vous proposer des solutions pour les surmonter.
CAPTCHA
-
- Problème : De nombreux sites web utilisent des CAPTCHA pour empêcher le scraping automatisé.
- Solution : Vous pouvez utiliser des services tels que 2Captcha ou Anti-Captcha pour résoudre automatiquement les CAPTCHA. Sinon, Selenium peut être utilisé pour résoudre manuellement le CAPTCHA pendant le processus de scraping.
Limites de débit
-
- Problème : les sites web imposent souvent des limites de débit afin de restreindre le nombre de requêtes provenant d’une même adresse IP.
- Solution : Implémentez une limitation de débit dans votre code afin de respecter les conditions d’utilisation du site web. Vous pouvez également utiliser des services de proxy pour faire tourner les adresses IP. Les proxys résidentiels d’Geonode constituent un excellent service à cet effet.
Données incomplètes
-
- Problème : Il arrive parfois que les données extraites soient incomplètes en raison d’un chargement dynamique ou d’autres problèmes.
- Solution : Utilisez Selenium pour vous assurer que la page est entièrement chargée avant de procéder à l’extraction. Vous pouvez également utiliser ses fonctions d’attente pour mettre le code en pause jusqu’à ce que certains éléments soient chargés.
Données incohérentes
-
- Problème : La structure du site web peut évoluer au fil du temps, ce qui entraîne des données incohérentes.
- Solution : Mettez régulièrement à jour votre code de scraping afin de l'adapter à toute modification de la structure du site web. Mettez en place une gestion robuste des erreurs pour être alerté en cas d'échec du scraping.
Validation des données
-
- Problème : les données extraites peuvent contenir des erreurs ou des inexactitudes.
- Solution : Validez toujours vos données en les recoupant avec plusieurs sources ou utilisez des sommes de contrôle pour garantir leur intégrité.
Considérations juridiques et éthiques
-
- Problème : Le scraping de données peut parfois aller à l’encontre des conditions d’utilisation du site web.
- Solution : Lisez toujours et respectez les conditions d’utilisation du site web ainsi que le fichier robots.txt. Respectez les règles et les politiques du site web.
En prenant conscience de ces défis courants et de leurs solutions, vous serez mieux préparé à faire face à tout problème pouvant survenir lors de vos opérations de web scraping.
Questions fréquentes
Comment extraire des données de sites immobiliers sans savoir programmer ?
Vous pouvez utiliser des outils de web scraping sans code tels que WebHarvy, Octoparse ou Import.io. Ces outils proposent des interfaces conviviales permettant d’extraire des données par simple clic.
Quelles sont les meilleures bibliothèques Python pour le web scraping ?
Les bibliothèques Python les plus couramment utilisées pour le web scraping sont BeautifulSoup, pour l’analyse syntaxique du HTML et du XML, et Selenium, pour interagir avec des sites web faisant un usage intensif de JavaScript. Scrapy constitue une autre option pour les projets plus complexes.
Le web scraping est-il légal ?
La légalité du web scraping dépend des conditions d'utilisation du site web et de la manière dont vous utilisez les données. Consultez toujours les conditions générales du site web et envisagez de demander un avis juridique pour vous assurer de respecter la législation.
Ressources complémentaires
Après avoir parcouru les différents aspects du web scraping, de la mise en place de votre environnement à la résolution des difficultés, il est temps de conclure et d’envisager la suite.
Documentation officielle. C’est toujours un bon point de départ. BeautifulSoup, Selenium et d’autres bibliothèques disposent d’une documentation complète pour vous aider à mieux comprendre leurs fonctionnalités.
Cours en ligne. Des sites web comme Udemy, Coursera et edX proposent des cours sur le web scraping et l’analyse de données.
Tutoriels YouTube. Il existe d’innombrables tutoriels couvrant tous les sujets, des bases aux techniques avancées.
Forums et communautés. Des sites web comme StackOverflow et Reddit abritent des communautés actives où vous pouvez poser des questions et partager vos connaissances.
Livres. Il existe également plusieurs ouvrages consacrés au web scraping et aux techniques de collecte de données.
Conclusion
Maintenant que vous disposez des connaissances et des outils nécessaires pour réaliser efficacement du web scraping, il est temps de les mettre en pratique.
Commencez modestement, expérimentez et n'hésitez pas à vous lancer dans des projets plus complexes à mesure que vous gagnez en confiance.
N'oubliez pas que la clé d'un web scraping réussi ne réside pas seulement dans la collecte de données, mais aussi dans leur transformation en informations exploitables.

