Geonode logo

Crawl. Rejoignez la bêta gratuite

Crawlez un site entier et obtenez des données propres de chaque page
Envoyez une URL
Crawle tout le site ou une section
Tarif mensuel fixe ou à la requête
Gratuit1,500 requêtes/mois
Données propres par page
  • HTML
  • Markdown

Passez à l'illimité, ou payez à la requête

Un seul palier couvre Scraper, Map, Crawl et Search. Pas de crédits, pas de multiplicateurs, pas de factures surprises.

  • Forfait gratuit

    $0/ mois

    1,500 requêtes / mois

    • Concurrence1
    • Taille du lot5 URLs
    • Pages par crawl10
    • Réinitialisé chaque mois
    • Aucune carte bancaire requise
    • Les requêtes échouées ne sont jamais facturées – sur tous les endpoints
  • Forfaits à la requête

    $62.50/ mois

    250,000 requêtes / mois

    Requêtes :
    • Concurrence50
    • Taille du lot100 URLs
    • Pages par crawl200
    • Les requêtes non utilisées sont reportées
    • Les requêtes échouées ne sont jamais facturées – sur tous les endpoints
  • Forfaits illimités

    $1,000/ mois

    Volume de requêtes illimité

    Threads :
    • Idéal jusqu'à7M requêtes/mois
    • Taille du lot1,000 URLs
    • Pages par crawl1,000
    • Requêtes illimitées, prix fixe
    • Tous les endpoints inclus
  • Paiement à l'usage

    à partir de $0.40/ 1k requêtes

    Nombre de requêtes personnalisé

    • Concurrence100
    • Taille du lot500 URLs
    • Pages par crawl500
    • Les requêtes non utilisées sont reportées
    • Commande minimum de $50
    • Les requêtes échouées ne sont jamais facturées – sur tous les endpoints

Voici comment nous offrons des prix bas pour une qualité de classe mondiale

La plupart des API de scraping fonctionnent sur un approvisionnement loué avec une tarification par crédits. C'est pourquoi votre facture est imprévisible. Nous avons choisi la voie opposée, et la logique s'accumule.
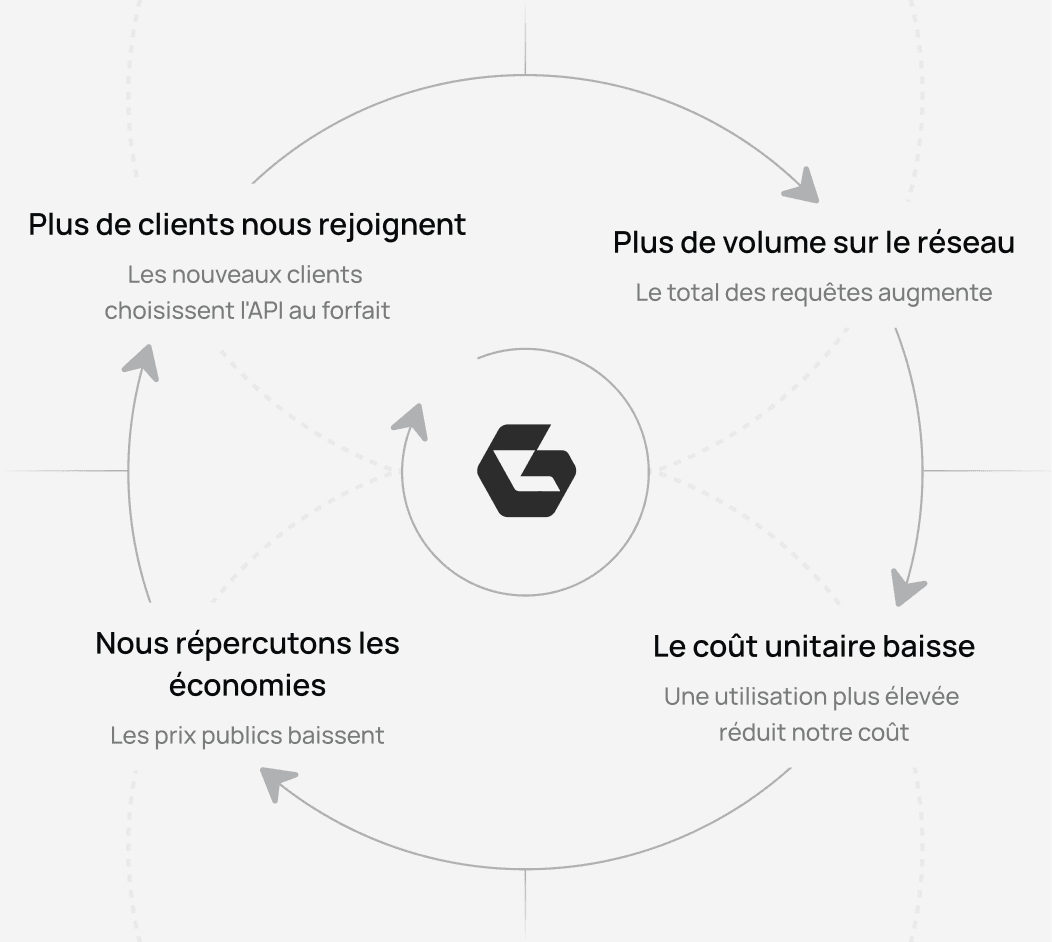
Comment plus de clients, l'exploitation de notre propre réseau, les prix de gros et la baisse des coûts se renforcent mutuellement

Démarrage rapide en code

Ajoutez la Crawl API de Geonode à votre application et récupérez tout un site en un seul job

import requests

r = requests.post(
  "https://scraper.geonode.io/v1/extract",
  headers={"X-Api-Key": "YOUR_API_KEY", "Content-Type": "application/json"},
  json={"url": "https://example.com", "formats": ["markdown"], "processing_mode": "sync"},
)
print(r.json())

Commencez à scraper en quelques secondes

Créez votre compte

Inscrivez-vous et obtenez 1,500 requêtes gratuites pour démarrer. Sans carte bancaire
Formulaire d'inscription avec champs e-mail et mot de passe dans le tableau de bord

Envoyez une requête

Envoyez n'importe quelle URL à l'endpoint de scraping avec un simple appel API

Contrôles de pays de la passerelle et de type de session dans le tableau de bord

Obtenez des données propres

Recevez du HTML ou du Markdown analysé

Format d'endpoint proxy et détails de connexion

Passez à l'illimité en évoluant

Passez à un forfait mensuel fixe selon la concurrence, ou restez à la requête. Sans crédits, sans surprises de comptage.

Exemples de code et extraits d'intégration dans le tableau de bord

FAQ

Envoyez une requête POST à /v1/crawl avec votre clé API Geonode et l'URL à crawler. L'URL est le seul champ requis ; les paramètres tels que la profondeur, la limite de pages, le format de sortie et le rendu JavaScript sont optionnels.

Chaque crawl renvoie un job_id unique. Utilisez-le pour récupérer le statut du crawl et suivre le nombre total, terminé et échoué de pages jusqu'à la fin du job.

Oui. Vous pouvez configurer le crawl pour renvoyer le contenu extrait dans les formats pris en charge, y compris Markdown. Le format sélectionné s'applique aux pages traitées par le crawl.

Oui. Les requêtes de crawl prennent en charge la configuration proxy, y compris le ciblage par pays, afin de récupérer le contenu tel qu'il apparaît depuis un emplacement sélectionné lorsque c'est pris en charge.

Oui. Pour les sites dynamiques, vous pouvez utiliser le rendu JavaScript avec wait_config pour contrôler quand une page est prête à l'extraction, par exemple en attendant la fin de l'activité réseau ou l'apparition d'un élément spécifique.

Oui. Vous pouvez lister les jobs de crawl précédents avec GET /v1/crawl/jobs. La réponse inclut le statut du job, les statistiques de crawl, les détails de configuration et les informations de pagination.

Arrêtez de calculer des crédits. Commencez à crawler.

1,500 requêtes/mois gratuites. Sans carte bancaire.