Media.net est une entreprise de pointe spécialisée dans les technologies publicitaires qui propose une large gamme de solutions destinées aux éditeurs, aux annonceurs et aux agences. 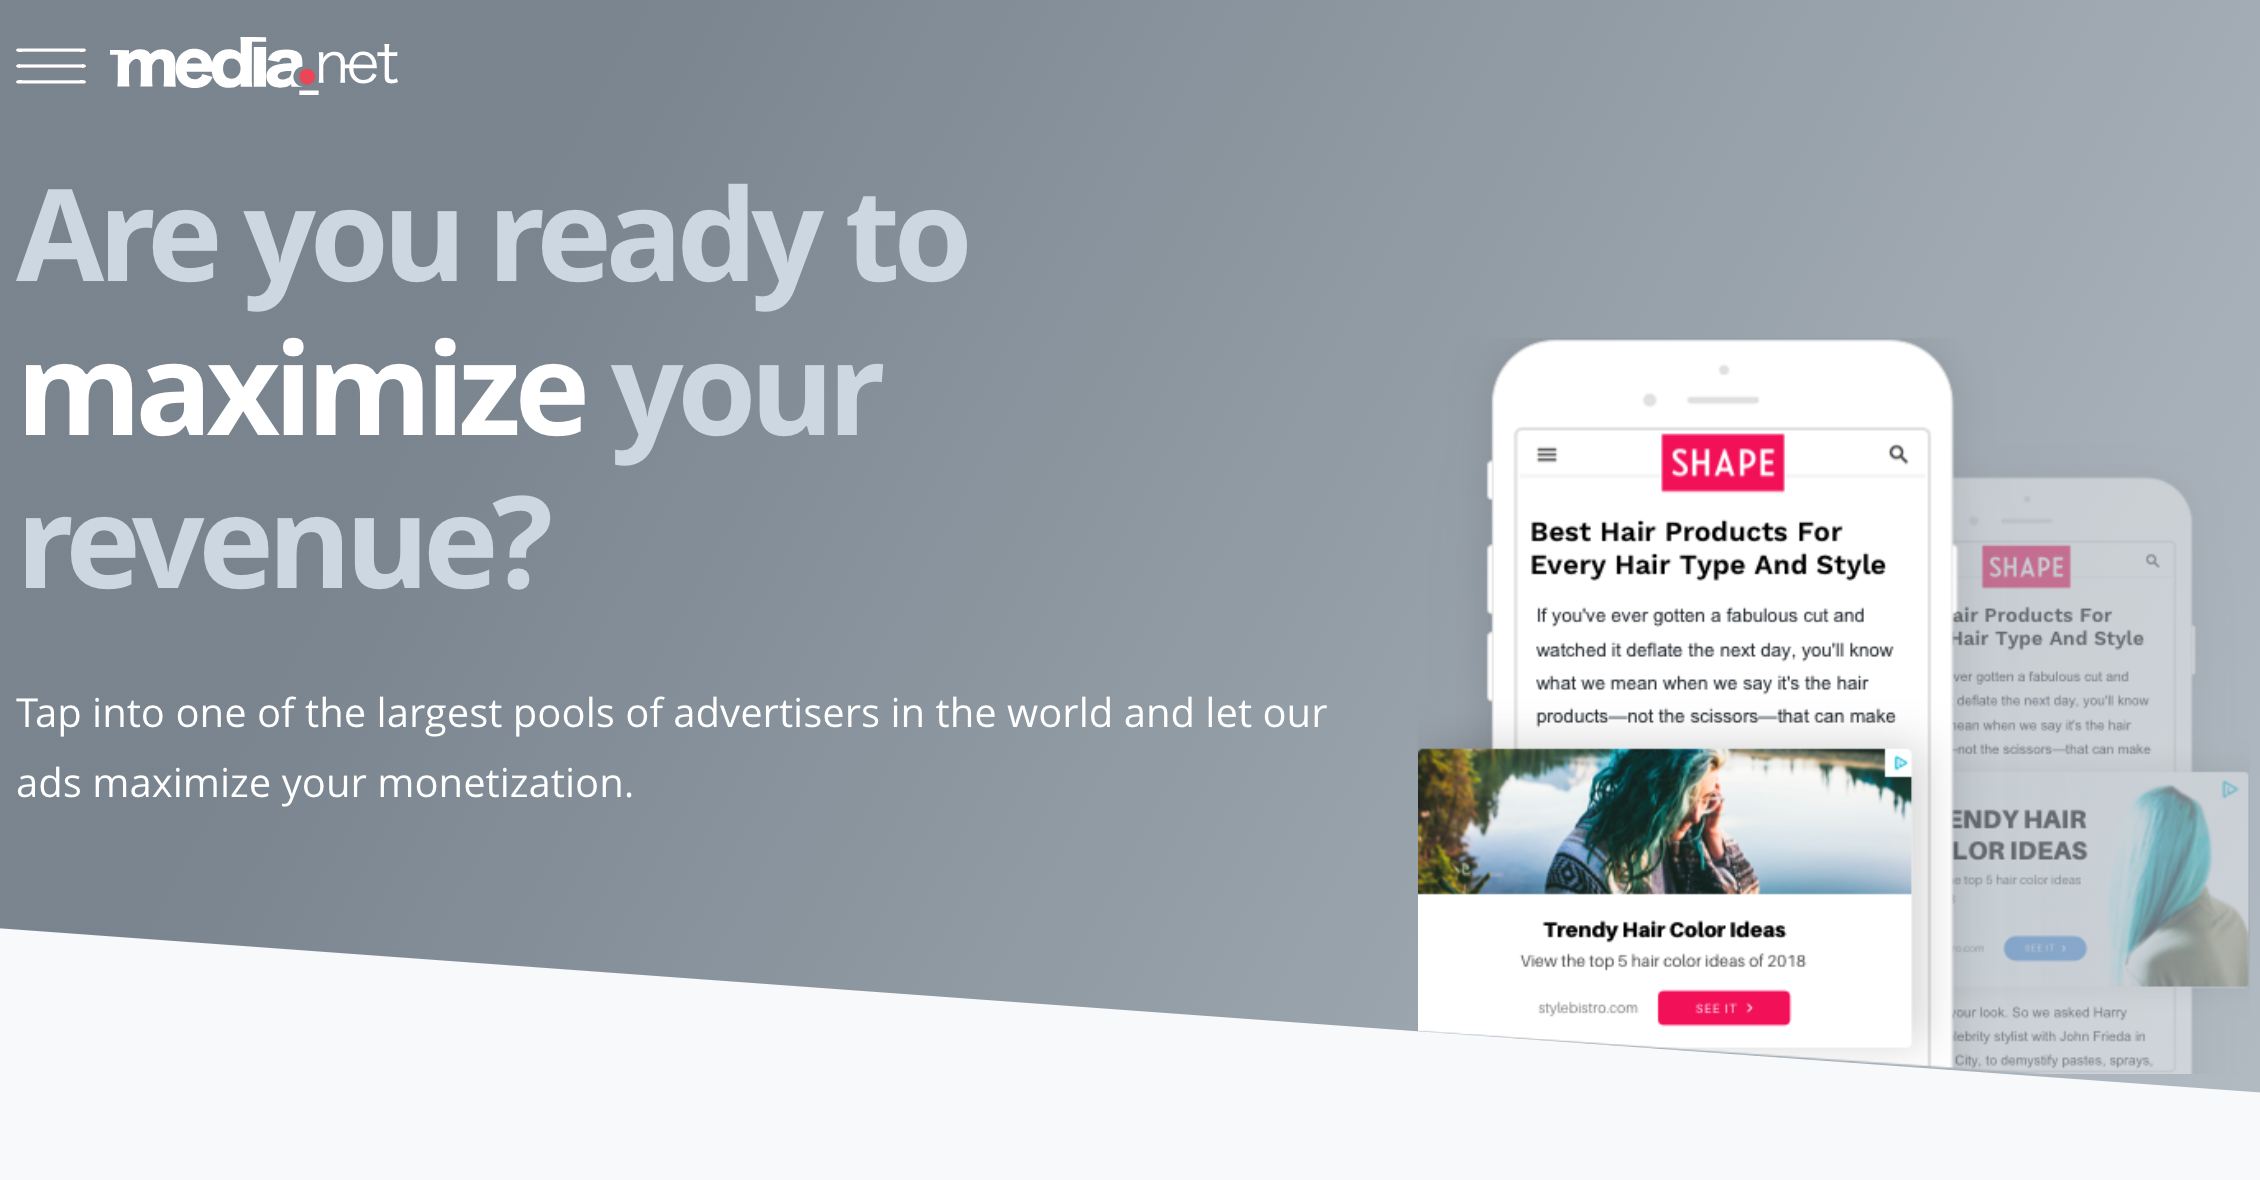
Spécialisée dans la publicité contextuelle, Media.net s'est imposée comme un acteur incontournable de l'écosystème de la publicité numérique.
Elle propose une plateforme permettant de monétiser le contenu des sites web grâce à des publicités hautement pertinentes, créant ainsi une situation gagnant-gagnant tant pour les éditeurs que pour les annonceurs.
Pourquoi extraire des données de Media.net ?
Optimisation des revenus
L'extraction de données sur Media.net permet aux éditeurs et aux annonceurs de comprendre les types de publicités et les modèles tarifaires disponibles, ce qui les aide à élaborer des stratégies marketing et des plans d'affaires plus efficaces pour optimiser leurs revenus.
Veille concurrentielle
Media.net est un leader mondial du secteur des technologies publicitaires. La collecte de données sur cette plateforme fournit des informations concurrentielles qui peuvent s’avérer cruciales pour comprendre les tendances du marché et définir votre stratégie commerciale.
Indicateurs d’engagement
Media.net accorde la priorité à l’expérience utilisateur en proposant des publicités natives personnalisées. L’analyse d’indicateurs d’engagement, tels que les taux d’engagement des utilisateurs réels, peut vous aider à optimiser vos propres stratégies d’engagement utilisateur.
Aperçu technologique
Media.net utilise des technologies de pointe telles que le « header bidding » multi-formats. La compréhension de ces technologies peut vous conférer un avantage concurrentiel lorsque vous exploitez des technologies similaires.
Conformité juridique et éthique
Le respect des conditions d’utilisation et des politiques de qualité de Media.net est essentiel. L’extraction de données doit être effectuée dans le respect de ces directives afin de garantir des pratiques éthiques.
Cas d'utilisation du scraping de Media.net
Analyse concurrentielle
Le scraping de Media.net fournit des informations sur ses offres publicitaires, ses modèles tarifaires et son positionnement sur le marché. Ces renseignements concurrentiels sont inestimables pour les entreprises qui souhaitent comprendre leur position dans le secteur.
Étude de marché
Les données issues de Media.net peuvent révéler les tendances du marché et les préférences des consommateurs, aidant ainsi les entreprises à établir un profil client idéal et à adapter leurs offres en conséquence.
Stratégies tarifaires
L'extraction des données tarifaires de Media.net permet d'élaborer des stratégies tarifaires plus compétitives en offrant une compréhension claire des tarifs du marché pour différents types de publicités.
Analyse des sentiments
Lorsqu’ils sont disponibles, les avis ou commentaires des utilisateurs sur Media.net peuvent offrir un aperçu du sentiment du marché et de la satisfaction client. Ces données peuvent aider tant Media.net que ses concurrents à identifier les axes d’amélioration ou à tirer parti de leurs points forts.
En intégrant l’extraction de données à vos opérations commerciales, vous pouvez rationaliser l’ensemble du processus de collecte d’informations exploitables pour la prise de décisions stratégiques.
Considérations juridiques et éthiques
Il est essentiel de bien cerner le cadre juridique et éthique du processus de collecte de données pour toute personne souhaitant extraire des données depuis Media.net.
Bien que le web scraping puisse fournir des informations précieuses, il est important de l'aborder de manière responsable afin d'éviter toute répercussion juridique.
Respecter le fichier robots.txt
Le fichier robots.txt est une norme utilisée par les sites web pour indiquer aux robots d'exploration et de scraping quelles pages peuvent ou ne peuvent pas être récupérées.
Avant de lancer tout projet de scraping sur Media.net, il est impératif de consulter le fichier robots.txt du site.
Ce fichier indique les zones du site web qui sont interdites d’accès et celles qui peuvent être consultées à des fins de scraping de données.
Ignorer les directives contenues dans ce fichier peut non seulement entraîner le blocage de votre adresse IP, mais aussi vous exposer à des risques juridiques.
Comprendre les conditions générales d'utilisation de Media.net
Les conditions générales d'utilisation (CGU) de Media.net constituent un accord juridique qui définit les règles, les conditions et les directives relatives à l'utilisation de leur plateforme.
Il est essentiel de lire et de comprendre ces conditions avant de commencer à extraire des données du site.
Le non-respect des CGU peut entraîner diverses conséquences, allant de la suspension temporaire de votre compte à des poursuites judiciaires.
Recherchez dans les CGU les sections traitant spécifiquement de l’extraction de données ou de l’accès automatisé à la plateforme.
Si les CGU interdisent explicitement l’extraction de données, vous devez alors obtenir l’autorisation écrite de Media.net pour poursuivre.
Principes éthiques relatifs au web scraping
Au-delà des considérations juridiques, un comportement éthique est primordial lors de l’extraction de données depuis n’importe quel site web, y compris Media.net. Voici quelques principes éthiques à prendre en compte :
Réduire au minimum la charge sur le serveur
Veillez à ce que vos activités de web scraping ne surchargent pas ou ne perturbent pas les services de Media.net.
Utilisez la limitation de débit et effectuez vos requêtes à une fréquence qui imite le comportement de navigation d’un utilisateur humain.
Utilisation des données
Faites preuve de transparence quant à vos intentions concernant l’utilisation des données extraites. Si les données doivent être publiées ou utilisées à des fins commerciales, demandez l’autorisation de Media.net.
Confidentialité des utilisateurs
Si vous effectuez du web scraping sur du contenu généré par les utilisateurs, veillez à ne collecter aucune information personnelle, sauf si cela est absolument nécessaire pour votre projet.
Si des données personnelles sont collectées, elles doivent être anonymisées et stockées en toute sécurité.
Mention de la source
Si vous prévoyez de publier les données ou toute analyse qui en découle, veillez à mentionner correctement Media.net comme source des données.
En respectant ces directives juridiques et éthiques, vous pouvez mener vos activités de web scraping de manière responsable et respectueuse. Cela permet non seulement de minimiser les risques, mais contribue également à l’intégrité et à la crédibilité de votre analyse de données ou de votre projet de veille économique.
Outils et technologies
La réussite d’un projet de web scraping dépend souvent des outils et des technologies utilisés.
En tirant parti de ces outils et technologies, vous pouvez mettre en place un pipeline de web scraping robuste pour collecter des données sur Media.net.
Que vous soyez débutant ou expert, une bonne combinaison de ces ressources peut considérablement améliorer l’efficacité et la performance de vos projets de web scraping.
Langages de programmation
Python
Python est un langage polyvalent largement utilisé pour le web scraping en raison de sa facilité d’utilisation et de ses bibliothèques très complètes.
Il permet le développement et le déploiement rapides de scripts de web scraping, ce qui en fait un choix idéal tant pour les débutants que pour les experts disposant d’une grande expérience en programmation.
JavaScript
JavaScript, en particulier Node.js, est un autre langage puissant pour le web scraping.
Il est particulièrement utile pour traiter les sites web qui s’appuient fortement sur JavaScript pour charger leur contenu, car il peut interagir directement avec le DOM (Document Object Model).
Bibliothèques et frameworks
BeautifulSoup
BeautifulSoup est une bibliothèque Python idéale pour les débutants en extraction de données Web.
Elle permet de naviguer et de manipuler facilement des documents HTML et XML, ce qui simplifie l'extraction de données.
Scrapy
Scrapy est un framework Python plus avancé, conçu pour l'extraction et l'exploration de données Web.
Il offre une prise en charge intégrée de divers formats de données et permet d’exporter les données extraites, ce qui le rend adapté aux projets à grande échelle.
Selenium
Selenium est souvent utilisé pour extraire des données de sites web riches en JavaScript. Il automatise l’interaction avec le navigateur, ce qui vous permet d’extraire des données chargées dynamiquement.
Services de proxy
Importance de l’utilisation de proxys pour le scraping
L’utilisation de proxys est cruciale pour le scraping à grande échelle afin d’éviter la détection et le blocage d’adresses IP. Les proxys permettent également un scraping géolocalisé, ce qui peut s’avérer essentiel pour collecter des données spécifiques à un lieu.
Proxys Geonode
Les proxys Geonode offrent une couche d’anonymat et de sécurité, ce qui les rend idéaux pour les projets de scraping web.
Ils permettent de contourner les interdictions d’IP et les limitations de débit imposées par des sites web tels que Media.net.
Intégration des proxys Geonode dans votre code de scraping
La configuration des proxys Geonode implique la création d’un compte, puis son intégration dans votre code.
La plupart des langages de programmation et des bibliothèques de scraping proposent des méthodes simples pour configurer les proxys.
Par exemple, en Python, vous pouvez utiliser la bibliothèque Requests pour intégrer facilement les proxys Geonode.
Extensions de navigateur
Web Scraper
Web Scraper est une extension de navigateur qui permet de réaliser facilement du web scraping par simple clic.
Elle est idéale pour les projets à petite échelle et pour ceux qui débutent dans le web scraping.
Data Miner
Data Miner est une autre extension de navigateur qui propose des « recettes » prêtes à l’emploi pour l’extraction de données.
Elle est utile pour extraire des données de sites web sans avoir à écrire de code, même si elle peut ne pas convenir à des besoins d’extraction plus complexes.
Configuration de l'environnement
Avant de se lancer dans le processus de web scraping proprement dit, il est essentiel de mettre en place un environnement de développement adapté.
Cela implique d'installer les logiciels et bibliothèques indispensables qui seront utilisés tout au long du projet.
Installation de Python et de pip
-
Téléchargez Python. Rendez-vous sur le site officiel de Python et téléchargez la dernière version adaptée à votre système d'exploitation.
-
Installation. Lancez le programme d'installation et suivez les instructions à l'écran. Veillez à cocher la case « Ajouter Python au PATH » lors de l'installation.
-
Vérification de l'installation. Ouvrez votre invite de commande ou votre terminal et tapez python --version pour vous assurer que Python a bien été installé.
-
Installer pip. Pip (Package Installer for Python) est généralement préinstallé avec Python.
Vous pouvez vérifier son installation en tapant pip --version dans l’invite de commande ou le terminal.
Configurer un éditeur de code
- Téléchargez Visual Studio Code. Rendez-vous sur le site web de Visual Studio Code et téléchargez la version compatible avec votre système d’exploitation.
- Installation. Lancez le programme d’installation et suivez les instructions de configuration.
- Extensions. Une fois l'installation terminée, vous pouvez ajouter des extensions telles que Python, Beautify et IntelliSense pour améliorer votre expérience de programmation.
Installation des bibliothèques et des frameworks requis
Ouvrez votre terminal et installez les bibliothèques Python suivantes :
- BeautifulSoup :
pip install beautifulsoup4
- Scrapy :
pip install scrapy
- Selenium :
pip install selenium
Identification des points de données
Navigation sur le site web de Media.net
Avant d’écrire le moindre code, prenez le temps de naviguer sur le site web de Media.net afin d’en comprendre la structure et d’identifier les points de données que vous souhaitez extraire.
Comprendre la structure du site web de Media.net
Le site web de Media.net sert de plateforme pour la publicité contextuelle et les solutions programmatiques. Il s'adresse à la fois aux annonceurs et aux éditeurs, en proposant une variété de services visant à maximiser les revenus. Le site web est organisé en plusieurs sections principales, notamment :
- Accueil. Présentation de Media.net et de ses services.
- Marketplace. Informations sur la demande concurrentielle provenant de diverses sources afin de maximiser le rendement.
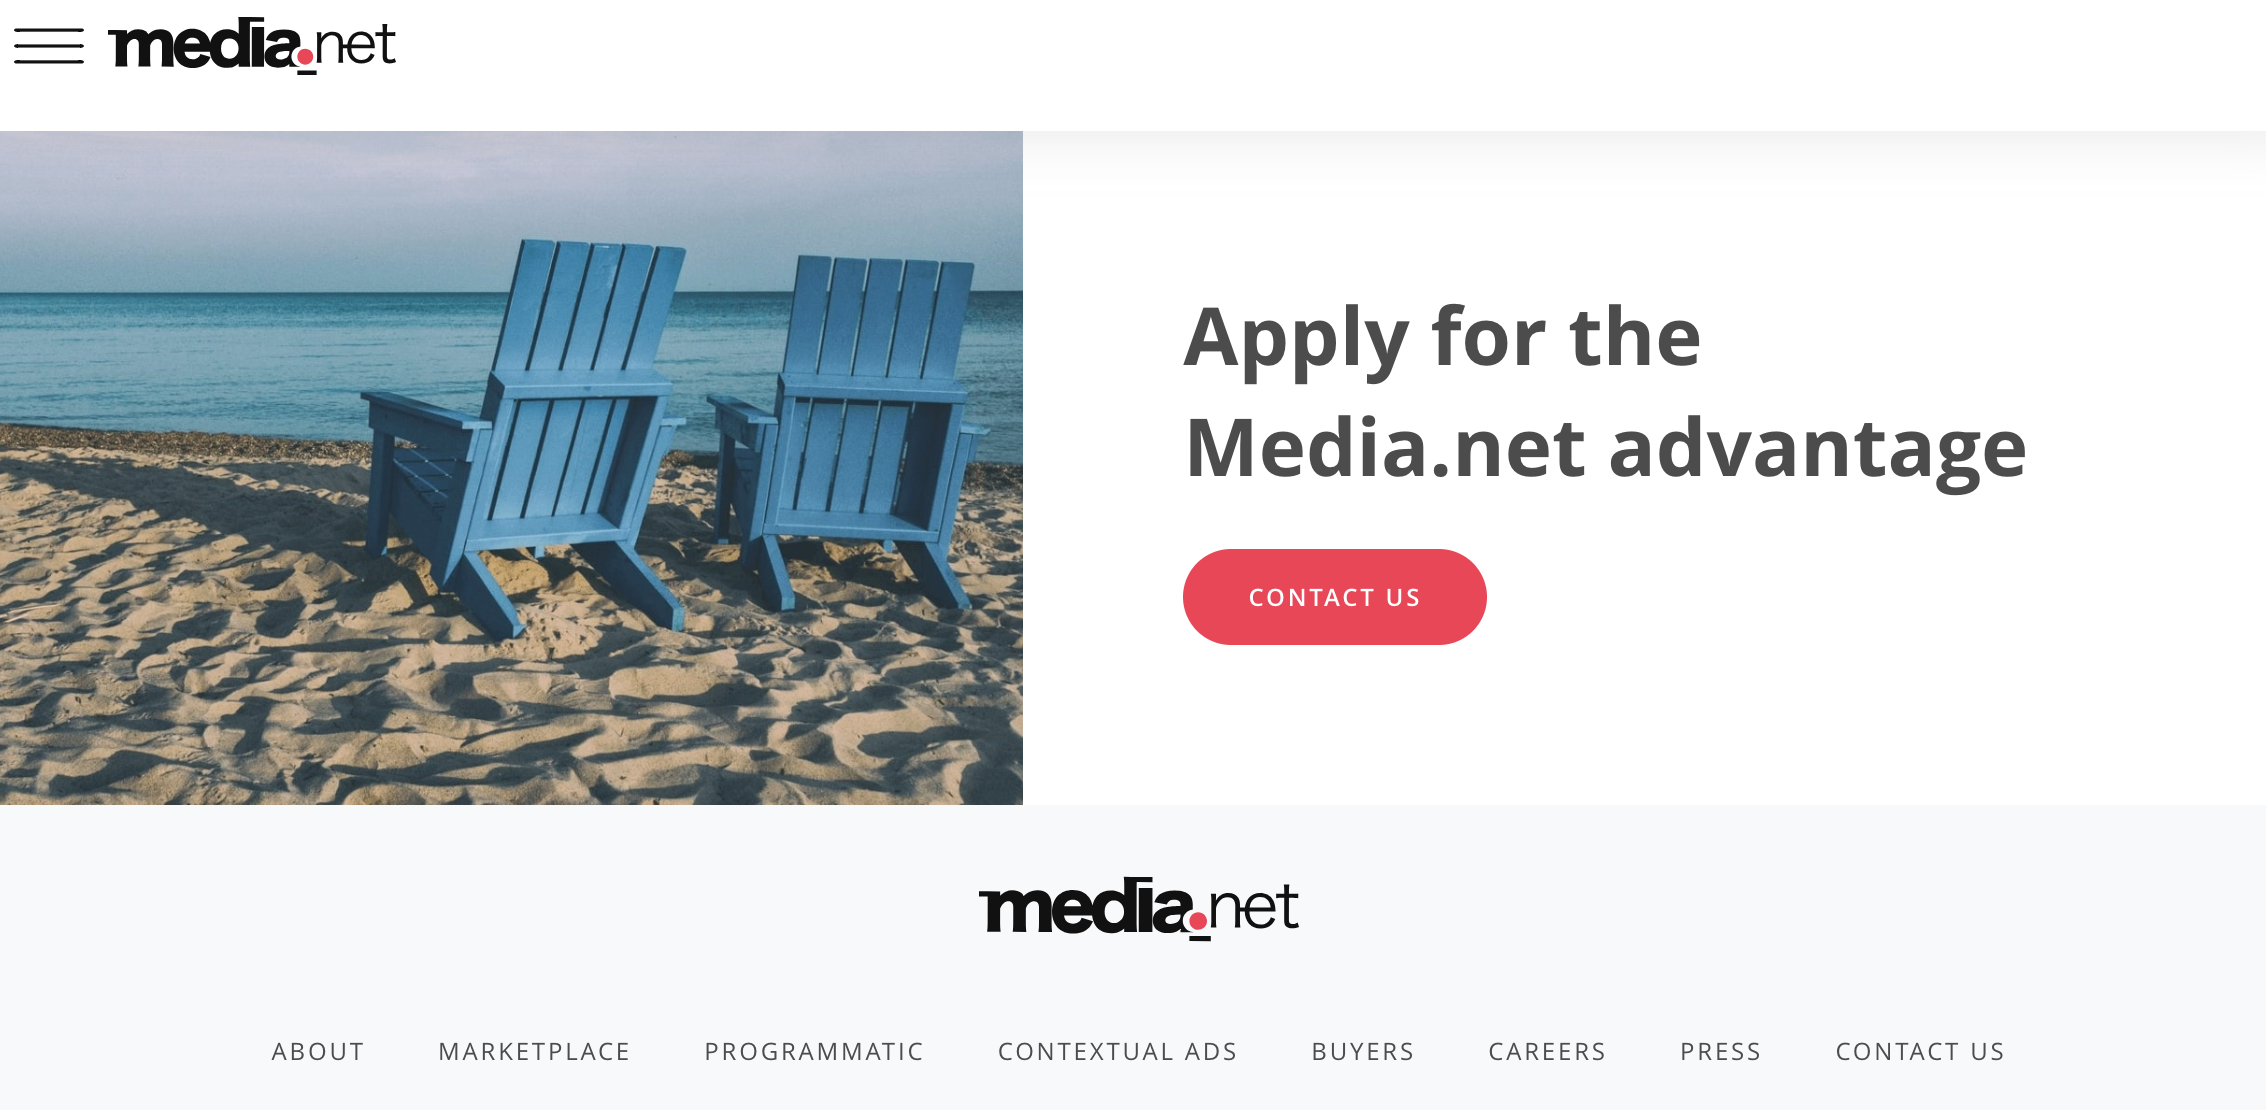
- Publicités contextuelles. Détails sur le format publicitaire propriétaire de Media.net qui exploite les mots-clés de recherche pour une publicité ciblée.
- Programatique. Informations sur leur plateforme de header bidding inter-formats de nouvelle génération.
- Acheteurs. Une rubrique probablement dédiée aux annonceurs potentiels.
- À propos. Informations générales sur Media.net.
- Connexion. Permet aux utilisateurs existants de se connecter à leur compte.
- Nous contacter. Pour toute demande de renseignements ou d’assistance.
Le site web fournit également des informations supplémentaires sur les publicités display et les publicités natives, expliquant en quoi elles peuvent être bénéfiques pour les éditeurs.
Identification des données clés à extraire
Déterminez quelles données spécifiques vous souhaitez extraire de Media.net. Cela peut aller des types de publicités proposées aux modèles de tarification, en passant par les articles de blog et autres publications. Dressez une liste de ces éléments, car ils guideront votre logique d’extraction.
Écrire le code
Une fois votre environnement configuré et les données que vous souhaitez extraire identifiées, l'étape suivante consiste à écrire le code.
Le web scraping peut être effectué manuellement ou à l'aide de méthodes automatisées. Ci-dessous, nous allons explorer ces deux approches et fournir des exemples de code pour chacune d'entre elles.
Extraction manuelle
Étapes et limites
L'extraction manuelle consiste à parcourir le site web et à copier manuellement les données dans un tableur ou un support de stockage similaire.
Bien que cette méthode soit simple, elle prend beaucoup de temps et n'est pas pratique pour les grands ensembles de données.
Extraction automatisée
L’extraction automatisée est le moyen le plus efficace de collecter des données, en particulier pour les projets à grande échelle. Nous verrons comment extraire des données à l’aide de BeautifulSoup, Scrapy et Selenium.
Utilisation de BeautifulSoup
Exemples de fragments de code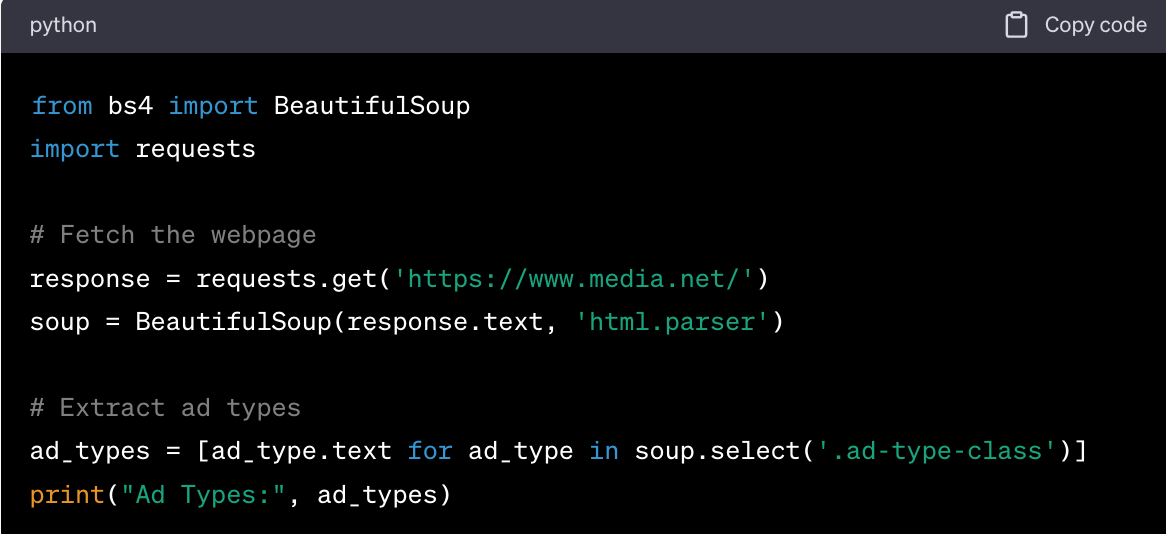
Explication du code
- Importez la bibliothèque BeautifulSoup et le module requests.
- Récupérez le contenu de la page web à l'aide de la méthode
requests.get().
- Analysez le contenu HTML à l'aide de BeautifulSoup.
- Extraire les types d’annonces à l’aide de la méthode
.select(), en ciblant la classe spécifique qui contient ces informations.
Utilisation de Scrapy
Exemples de code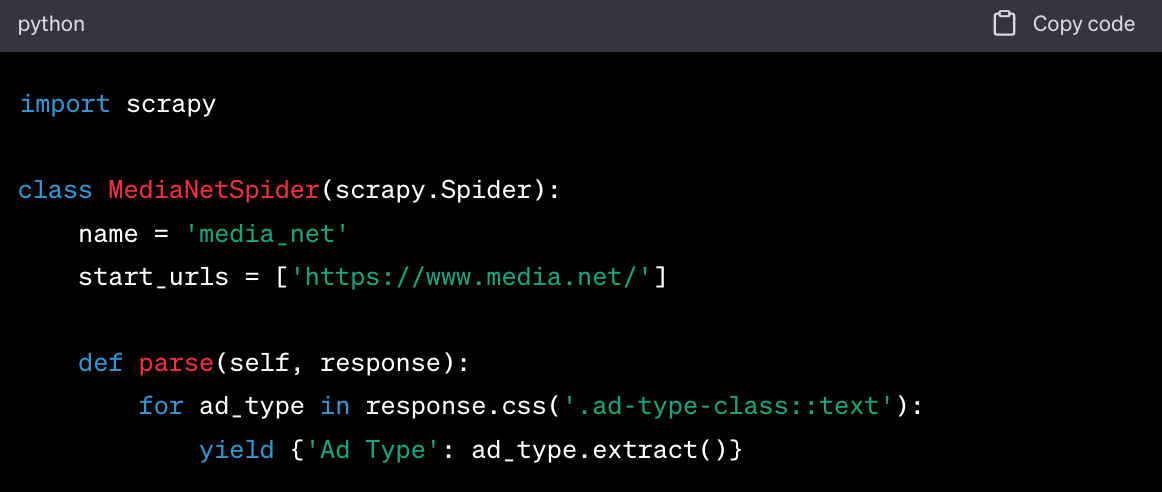
Explication du code
- Importer la bibliothèque Scrapy.
- Définissez une classe de spider héritant de
scrapy.Spider.
- Spécifiez l'URL à extraire dans
start_urls.
- Définissez la méthode
parse pour extraire les types d'annonces à l'aide de la méthode .css().
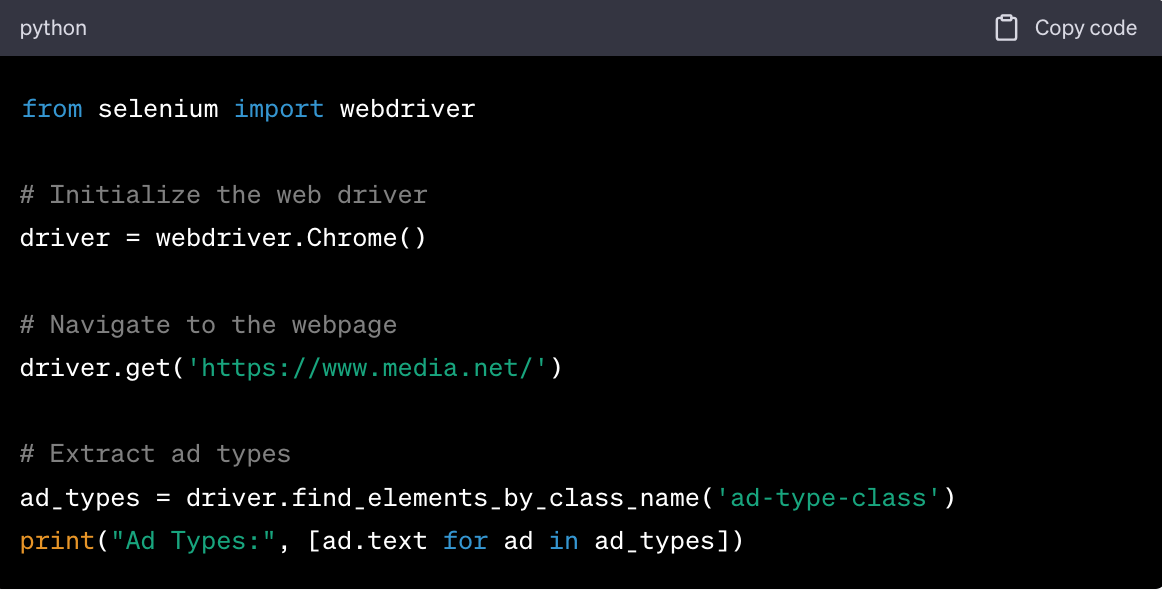
Utilisation de Selenium
Exemples de fragments de code
CSV
Vous pouvez utiliser la bibliothèque intégrée à Python csv pour stocker les données extraites dans un fichier CSV.
Base de données
Pour les projets plus complexes, il est conseillé de stocker les données dans une base de données telle que MySQL ou MongoDB.
En suivant ces étapes et en vous inspirant de ces extraits de code, vous pouvez mettre en place un pipeline de scraping web robuste pour collecter des données sur Media.net.
Utilisation de scrapers personnalisés
Les scrapers web personnalisés offrent un degré plus élevé de personnalisation et de contrôle sur les données que vous collectez.
Si vous disposez de connaissances en programmation, vous pouvez écrire des lignes de code spécifiques pour cibler des éléments uniques sur le site web de Media.net, ce qui permet une collecte de données plus nuancée.
Les modèles de scrapers personnalisés sont idéaux pour ceux qui ont des besoins spécifiques en matière de données que les outils de scraping génériques ne sont pas toujours en mesure de satisfaire.
Utilisation de services d’extraction de données
Les services d’extraction de données sont souvent fournis avec des API de scraping prêtes à l’emploi et des outils conçus pour un scraping approfondi du contenu web.
Les services de scraping peuvent gérer des scénarios d’extraction de données complexes sans que vous ayez à écrire la moindre ligne de code.
Ils sont particulièrement utiles pour les entreprises qui ne disposent pas de connaissances en programmation mais qui souhaitent tout de même recueillir des informations précieuses à partir de plateformes telles que Media.net.
Dépannage et FAQ
Le web scraping est un outil puissant, mais il comporte son lot de difficultés.
Erreurs courantes et solutions
Adresse IP bloquée
Solution : L'utilisation de proxys est un bon moyen d'éviter que votre adresse IP ne soit bloquée.
Geonode propose divers services de proxy qui peuvent vous aider à extraire des données de manière anonyme, réduisant ainsi les risques de blocage de votre adresse IP.
Limite de débit dépassée
Solution : Implémentez une limitation de débit dans votre code pour contrôler la fréquence de vos requêtes.
Vous pouvez également utiliser les proxys de Geonode pour alterner les adresses IP, ce qui peut vous aider à éviter d’atteindre les limites de débit.
Données incomplètes ou inexactes
Solution : cela se produit généralement lorsque la structure du site web change.
Veillez toujours à mettre à jour votre code en fonction de la dernière mise en page du site web.
Erreurs de délai d'expiration
Solution : augmentez le délai d'expiration dans votre code.
Envisagez également d’utiliser des proxys Geonode pour une connectivité plus fiable.
Questions fréquentes
Comment extraire des données de Media.net sans se faire bloquer ?
L’utilisation de proxys Geonode peut vous aider à extraire des données de Media.net sans vous faire bloquer.
Ces proxys masquent votre adresse IP, ce qui rend difficile pour les sites web de détecter une activité de scraping.
Le scraping de Media.net est-il légal ?
Consultez toujours les Conditions générales d’utilisation de Media.net pour comprendre leur politique en matière de scraping. En général, si l'robots.txte d'un site web l'autorise et que vous n'enfreignez aucune condition, cela est généralement autorisé.
Comment scraper Media.net plus rapidement ?
L'utilisation d'une bibliothèque plus efficace comme Scrapy peut accélérer le processus de scraping.
De plus, les proxys Geonode peuvent offrir des connexions plus rapides.
Quelles sont les meilleures bibliothèques pour le scraping de Media.net ?
BeautifulSoup, Scrapy et Selenium sont des bibliothèques couramment utilisées pour le scraping web, chacune présentant ses propres avantages.
En quoi les proxys d’Geonode améliorent-ils le scraping Web ?
Les proxys d’Geonode proposent une rotation d’adresses IP, des proxys de centres de données haut débit et des proxys résidentiels, ce qui les rend idéaux pour le scraping Web.
Ils permettent de contourner les blocages d’adresses IP et les limitations de débit, améliorant ainsi l’efficacité de vos tâches de scraping Web.
Bonnes pratiques
Limitation de débit
Intégrez toujours une limitation de débit dans votre code pour éviter de surcharger le serveur. Ce n’est pas seulement une question de courtoisie, cela vous aide également à éviter d’être bloqué.
Rotation d’adresses IP
Utilisez les proxys Geonode pour la rotation d’adresses IP. Cela vous permet d’effectuer des requêtes via différentes adresses IP, réduisant ainsi le risque d’être bloqué.
Stockage et utilisation des données
Stockez les données extraites dans un format structuré tel que CSV ou dans une base de données. Respectez toujours les conditions d’utilisation des données, en particulier si vous prévoyez de les publier.
Mention de la source
Si vous utilisez ces données à des fins de recherche ou de reporting, veillez à toujours mentionner correctement Media.net comme source des données.
En suivant ces bonnes pratiques et ces conseils de dépannage, vous pourrez rendre votre projet de scraping Web plus efficace et moins sujet aux problèmes courants.
Conclusion
Le web scraping est un outil précieux pour collecter des données sur Media.net, offrant des informations qui peuvent s'avérer cruciales pour diverses applications commerciales telles que l'analyse concurrentielle, les études de marché et les stratégies de tarification.
Tout au long de cet article, nous avons abordé les étapes essentielles pour configurer votre environnement de scraping, écrire le code et résoudre les problèmes courants.
Nous avons également souligné l'importance de respecter les directives juridiques et éthiques, en mentionnant tout particulièrement comment les proxys Geonode peuvent améliorer vos opérations de scraping en garantissant l'anonymat et en contournant les limites de débit.
Prochaines étapes
Nettoyage et analyse des données
Une fois que vous avez réussi à extraire les données, l'étape suivante consiste à les nettoyer et à les analyser. Le nettoyage des données implique de supprimer les doublons, de traiter les valeurs manquantes et de convertir les types de données.
Une fois le nettoyage terminé, vous pouvez procéder à l’analyse des données à l’aide de méthodes statistiques afin d’en tirer des enseignements exploitables.
Mise en œuvre stratégique
Les enseignements tirés des données peuvent être mis en œuvre de manière stratégique au sein de votre entreprise.
Qu’il s’agisse d’ajuster vos modèles de tarification ou d’identifier de nouvelles opportunités de marché, les données que vous avez collectées peuvent constituer une ressource précieuse pour la prise de décision.
Suivi et mise à jour
Le web scraping n’est pas une activité ponctuelle. Les sites web mettent régulièrement à jour leur contenu et leur structure ; il est donc essentiel de maintenir votre code de scraping à jour.
Le suivi de votre processus de scraping vous aidera à identifier et à résoudre rapidement tout problème éventuel.
Ressources supplémentaires
Tutoriels
- Le web scraping avec Python : un guide complet
- Comment utiliser des proxys pour le web scraping
Documentation
- Documentation BeautifulSoup
- Documentation Scrapy
- Services de proxy Geonode
Forums d’aide communautaire
- Stack Overflow
- Communauté Reddit dédiée au web scraping
- Forum de la communauté Geonode
En suivant les consignes et les bonnes pratiques décrites dans cet article, vous êtes sur la bonne voie pour maîtriser le web scraping. Les données que vous collectez sur Media.net peuvent vous offrir un avantage concurrentiel, à condition de les utiliser de manière responsable et éthique.

