Avantages du scraping des données de Walmart
Walmart, l’un des plus grands détaillants, exploite une chaîne d’hypermarchés, de grands magasins discount et de supermarchés. L’entreprise bénéficie d’une présence en ligne considérable, avec des millions de produits allant des produits alimentaires aux vêtements, en passant par les articles pour la maison, l’électronique et bien plus encore — ce qui fait de Walmart une source de données extrêmement précieuse pour le scraping Web.
L'extraction de données de Walmart peut servir à de multiples fins, en particulier pour les entreprises et les chercheurs. Voici quelques applications pratiques de l'extraction de données de Walmart :
• Études de marché. La vaste gamme de produits de Walmart offre une vue d'ensemble complète du marché dans de nombreuses catégories. En récupérant ces données, vous pouvez obtenir des informations sur les tendances des produits, les préférences des consommateurs et les stratégies de tarification.
• Analyse concurrentielle. Les données extraites de Walmart peuvent être utilisées pour comprendre quels produits sont vendus, à quel prix et comment ils sont commercialisés. Ces informations peuvent vous aider à positionner vos propres produits de manière compétitive.
• Suivi des prix. Vous pouvez utiliser les données extraites pour surveiller en temps réel les prix des produits chez Walmart, ce qui vous permet d’ajuster vos propres prix en conséquence et de rester compétitif.
• Optimisation de la gamme de produits. En analysant la gamme de produits proposée par Walmart, vous pouvez optimiser votre propre gamme de produits afin de mieux répondre à la demande des consommateurs.
• Analyse des sentiments. Les avis et les notes publiés sur le site web de Walmart fournissent une mine d’informations sur l’opinion des consommateurs à l’égard des produits. Vous pouvez utiliser ces données pour améliorer la qualité de vos produits et votre service client.
Extraction de données sans effort sur Walmart avec Geonode
L'API de scraping d'
Geonode
est un outil puissant et convivial conçu pour simplifier les tâches de scraping Web. Grâce à un éventail de fonctionnalités clés, elle permet aux utilisateurs d'extraire efficacement de grandes quantités de données à partir de sites Web tels que Walmart, sans avoir à écrire de lignes de code complexes.
Parmi ses fonctionnalités phares, on peut citer :
• Mode débogage. Fournit des informations détaillées au format JSON, aidant ainsi les utilisateurs à comprendre comment les sites web gèrent les requêtes de scraping, ce qui leur permet de gagner du temps et d’économiser des ressources.
• Rendu JavaScript. Facilite le scraping d’applications monopages grâce à la capture d’éléments dynamiques, garantissant ainsi une extraction complète des données.
• Exécution d’extraits de code JS personnalisés. Permet aux développeurs d’interagir avec des formulaires, des boutons et d’autres éléments générés par JavaScript pour un meilleur contrôle du processus de scraping.
• Rotation des proxys. Utilise un vaste pool de proxys pour éviter les blocages d’adresses IP et contourner les restrictions géographiques, améliorant ainsi la fiabilité de la récupération des données.
• Ciblage géographique. Garantit l’accès à davantage de sites web sans être détecté comme un scraper.
• API de capture d’écran. Permet de capturer facilement des captures d’écran de pages web à des fins de test, de dépannage et de documentation.
• Tarification au Go. Propose une tarification économique et un contrôle des dépenses liées au scraping.
• Formats de réponse. Offre une grande flexibilité dans le choix entre les formats HTML ou JSON pour une utilisation intégrée dans des applications.
• Collecte de données à partir de réponses HTTP. Permet de collecter sans effort des données spécifiques, telles que des réponses JSON, afin d’extraire les informations requises.
• Mode de scraping. Propose différents modes de scraping pour des performances et une efficacité optimales, adaptées à divers besoins de scraping.
Comment extraire les données de Walmart avec l'Geonode
Comprendre la structure du site web de Walmart
Walmart est l'un des plus grands détaillants au monde ; son site web est une vaste plateforme de commerce électronique dotée d'une mise en page bien structurée et organisée, comprenant des milliards de pages de produits. Il est essentiel de comprendre sa structure pour effectuer un web scraping efficace et performant. Voici un aperçu général de la manière dont les données sont organisées sur le site web de Walmart :
• Page d’accueil. La page d’accueil offre un aperçu général de l’offre de Walmart. Elle contient différentes catégories de produits, des offres promotionnelles et bien plus encore.
• Pages de catégories. Lorsque vous cliquez sur une catégorie depuis la page d’accueil ou le menu de navigation, vous êtes redirigé vers une page de catégorie. Ces pages répertorient les produits d’une catégorie spécifique, telle que « Électronique », « Vêtements » ou « Articles pour la maison ». Chaque page de catégorie comporte plusieurs sous-catégories correspondant à des types de produits plus spécifiques.
• Fiches produits. Chaque page de catégorie ou de sous-catégorie contient une liste de produits. Chaque fiche produit comprend des informations de base telles que le nom du produit, son prix, une image et l’avis des clients.
• Pages produits. En cliquant sur un produit dans la liste, vous accédez à la page dédiée à ce produit. Ces pages contiennent des informations détaillées sur le produit, notamment une description plus complète, les caractéristiques du produit, des images supplémentaires, les avis clients et, souvent, une liste de produits associés.
• Fonctionnalité de recherche. Le site web dispose également d’une barre de recherche permettant aux utilisateurs de rechercher des produits spécifiques. Les résultats de recherche s’affichent dans un format similaire à celui des listes de produits sur les pages de catégories.
Lors du scraping du site web de Walmart, il est important de noter que les données se trouvent principalement dans ces sections. Les pages produits, en particulier, sont probablement les plus précieuses, car elles contiennent les informations les plus détaillées.
Cependant, le site web de Walmart est dynamique ; certains contenus sont chargés à l’aide de JavaScript après le chargement initial de la page HTML, ce qui peut compliquer le scraping. Heureusement, l’API de scraping d’Geonode est capable de gérer le rendu JavaScript et d’éviter ce problème.
Identification des données clés à extraire
Lors de l’extraction de données sur un site de commerce électronique comme Walmart, les données clés que vous souhaiterez extraire dépendront des exigences spécifiques de votre projet. Voici quelques données courantes qui s’avèrent souvent précieuses :
• Nom du produit. Le nom du produit est l’une des informations les plus élémentaires, mais aussi les plus cruciales. Il permet d’identifier la gamme de produits proposés par le site web.
• Prix. Le prix du produit est un autre élément de données essentiel. Les prix pratiqués par la concurrence peuvent servir à comparer les prix, à suivre leur évolution dans le temps ou à identifier les tendances en matière de tarification.
• Images. Les images offrent une représentation visuelle du produit. Elles peuvent être utiles à diverses fins, telles que des tâches de reconnaissance d’images ou l’illustration d’un catalogue de produits.
• Description. La description du produit fournit des informations détaillées sur celui-ci, notamment ses caractéristiques, ses spécifications et d’autres détails pertinents.
• Avis et notes sur les produits. Les avis et les notes donnent un aperçu de la satisfaction des clients et de la qualité du produit. Ils peuvent être utilisés pour l’analyse des sentiments ou pour évaluer l’opinion publique à l’égard d’un produit.
• Catégorie du produit. La catégorie ou sous-catégorie du produit peut fournir un contexte sur la nature du produit et sa place au sein de la gamme de produits plus large.
• Référence ou identifiant du produit. La référence ou l’identifiant est un identifiant unique pour chaque produit. Cela peut être utile pour le suivi de produits spécifiques.
• Statut de disponibilité. Les informations indiquant si le produit est en stock, en rupture de stock ou disponible en précommande peuvent s’avérer précieuses pour l’analyse de la chaîne d’approvisionnement ou les études de marché.
• Informations sur la livraison. Les détails concernant les options et les frais de livraison peuvent être importants pour comprendre le coût total d’un produit.
• Informations sur le vendeur. Si le produit est vendu par un vendeur tiers, les informations le concernant peuvent s’avérer pertinentes.
Configuration de l’environnement
Voici un guide étape par étape pour configurer l’environnement de l’API de scraping d’Geonode :
1. Créez un compte sur Geonode. La première étape consiste à créer un compte sur le site web de Geonode. Cela vous donnera accès à leur API et à d’autres services.
2. Récupérez votre clé API. Une fois que vous avez créé un compte et que vous vous êtes connecté, vous pouvez trouver votre clé API dans les paramètres de votre compte ou sur votre tableau de bord. Cette clé sert à authentifier vos requêtes auprès de l’API.
3. Installez les bibliothèques nécessaires. Selon le langage de programmation que vous utilisez, vous devrez peut-être installer certaines bibliothèques pour envoyer des requêtes HTTP et gérer les réponses.
• Bibliothèque client HTTP : pour envoyer des requêtes à l’API de Geonode et recevoir des réponses, vous aurez besoin d’une bibliothèque client HTTP. La bibliothèque spécifique que vous utiliserez dépendra de votre langage de programmation. Par exemple, si vous utilisez Python, vous pouvez utiliser la bibliothèque Requests. Si vous utilisez JavaScript, vous pouvez utiliser Axios ou Fetch.
• Bibliothèque d’analyse JSON : l’API de Geonode renvoie généralement des données au format JSON ; vous aurez donc besoin d’une bibliothèque pour analyser ces données. La plupart des langages de programmation modernes intègrent une prise en charge native de l’analyse JSON. Par exemple, en Python, vous pouvez utiliser le module json, et en JavaScript, vous pouvez utiliser JSON.parse().
• Environnement de développement : vous aurez besoin d’un environnement de développement pour écrire et exécuter votre code. Il peut s’agir d’un éditeur de texte comme Sublime Text ou Atom, ou d’un environnement de développement intégré (IDE) comme PyCharm ou Visual Studio Code.
4. Configurez votre environnement de développement. Assurez-vous que votre environnement de développement est configuré pour envoyer des requêtes à l’API et gérer les réponses. Cela peut impliquer la création d’un nouveau projet dans votre environnement de développement intégré (IDE) ou votre éditeur de texte préféré.
5. Testez l’API. Avant de commencer à développer votre outil de scraping, il est recommandé de tester l’API pour vous assurer que tout fonctionne correctement. Pour ce faire, envoyez une simple requête GET à l’API et vérifiez la réponse.
6. Lisez la documentation de l’API : la documentation de l’API de Geonode fournit des informations détaillées sur l’utilisation de l’API, notamment les points de terminaison disponibles, les paramètres de requête, les formats de réponse, etc. La lecture de cette documentation vous aidera à comprendre comment utiliser efficacement l’API.
Récupération d’une page produit Walmart
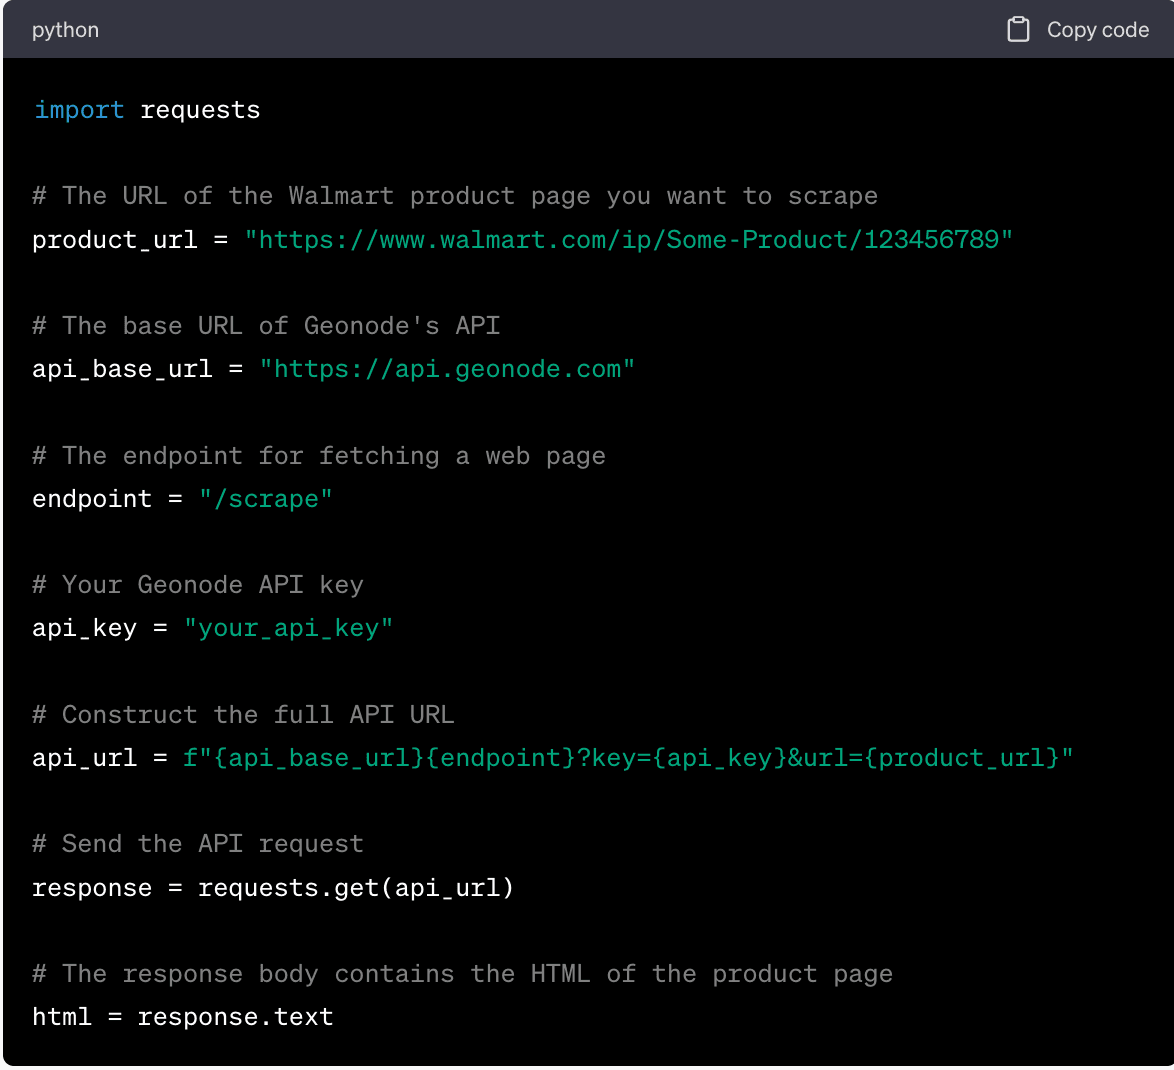
Pour récupérer une page produit Walmart à l’aide de l’API de scraping d’Geonode, vous devez envoyer une requête HTTP GET à l’API en indiquant l’URL de la page produit que vous souhaitez extraire. Voici les grandes lignes de la procédure :
1. Identifiez l’URL de la page produit. Identifiez l’URL de la page produit Walmart que vous souhaitez extraire. Pour ce faire, accédez à la page produit dans votre navigateur Web et copiez l’URL depuis la barre d’adresse.
2. Préparez la requête API. Construisez l’URL du point de terminaison de l’API, qui comprend l’URL de base de l’API de Geonode, le point de terminaison permettant de récupérer une page Web et tous les paramètres nécessaires. L’un de ces paramètres sera l’URL de la page produit Walmart que vous souhaitez extraire.
3. Envoyez la requête API. Envoyez la requête API à l’aide de votre bibliothèque client HTTP. Cela implique d’appeler une fonction ou une méthode fournie par la bibliothèque, de lui transmettre l’URL du point de terminaison de l’API et de définir la méthode sur GET.
4. Traitez la réponse de l’API. Une fois la requête envoyée, l’API renverra une réponse. Cette réponse contiendra les données de la page produit Walmart, généralement au format HTML. Vous devrez traiter cette réponse dans votre code, ce qui peut impliquer d’analyser le code HTML et d’extraire les données qui vous intéressent.
Voici un exemple illustrant comment procéder en Python à l’aide de la bibliothèque Requests :
Extraction des données de la page produit
Une fois que vous avez récupéré une page produit Walmart à l’aide de l’API de scraping d’Geonode, l’étape suivante consiste à extraire les données clés de la page. Cela implique généralement d’analyser le code HTML de la page et de sélectionner les éléments contenant les données qui vous intéressent.
Voici un aperçu général de la manière dont vous pouvez procéder :
1. Analyser le code HTML. La première étape consiste à analyser le code HTML de la page. Cela implique de convertir la chaîne HTML en une structure que vous pouvez parcourir et dans laquelle vous pouvez effectuer des recherches. La méthode spécifique pour y parvenir peut dépendre de votre langage de programmation et des bibliothèques que vous utilisez. Par exemple, en Python, vous pouvez utiliser la bibliothèque BeautifulSoup pour analyser le code HTML.
2. Identifier les éléments de données. Ensuite, vous devrez identifier les éléments HTML qui contiennent les données qui vous intéressent. Cela implique généralement d’inspecter le code HTML de la page et de repérer les balises, les classes ou les identifiants de ces éléments. Vous pouvez le faire à l’aide des outils de développement de votre navigateur web.
3. Sélectionner les éléments. Une fois les éléments identifiés, vous pouvez les sélectionner dans le code HTML analysé. Cela implique généralement d’appeler une fonction ou une méthode fournie par votre bibliothèque d’analyse HTML, en lui transmettant la balise, la classe ou l’identifiant de l’élément. Cela renverra l’élément et son contenu.
4. Extraire les données. Une fois les éléments sélectionnés, vous pouvez en extraire les données. Cela implique généralement d’appeler une fonction ou une méthode fournie par votre bibliothèque d’analyse HTML, en lui transmettant l’élément. Cela renverra les données contenues dans l’élément.
Voici un exemple illustrant comment analyser du code HTML en Python à l’aide de la bibliothèque BeautifulSoup :
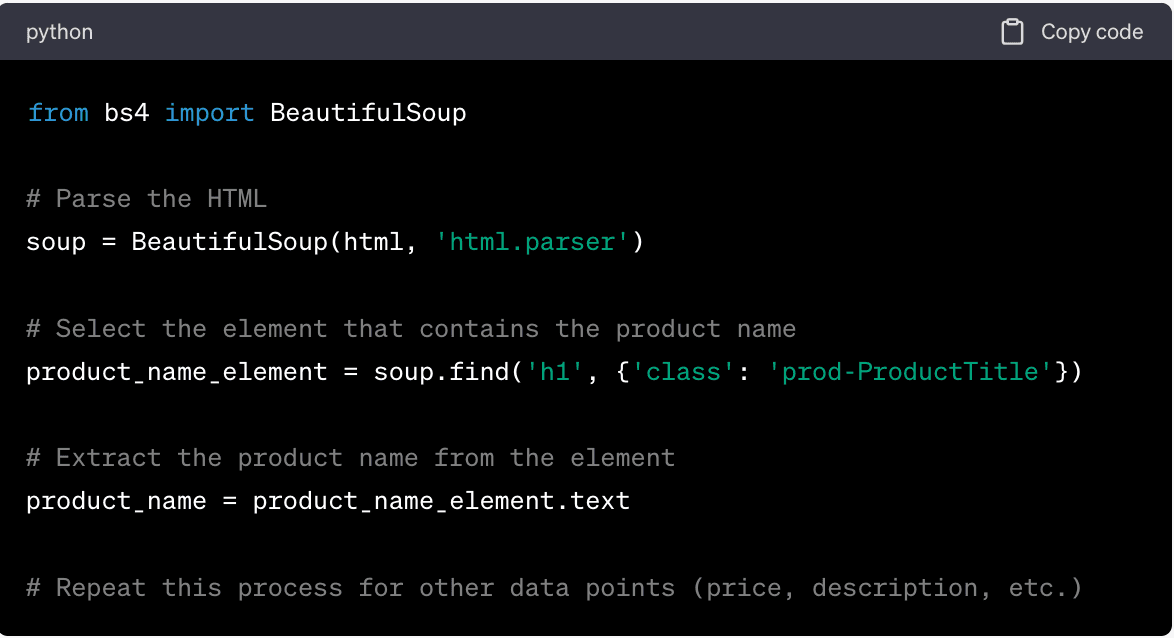
(Il s’agit d’un exemple basique et la mise en œuvre réelle peut varier en fonction de la structure spécifique des pages produits de Walmart ainsi que des fonctionnalités et capacités de votre bibliothèque d’analyse HTML. Consultez toujours la documentation officielle de votre bibliothèque pour obtenir les informations les plus précises et les plus récentes.)
Analyse des données HTML et JSON
L’analyse des données HTML et JSON est une tâche courante dans le web scraping. L’analyse consiste à prendre des données brutes (dans ce cas, du texte HTML ou JSON) et à les convertir dans un format plus facile à exploiter dans votre langage de programmation.
Analyse du HTML
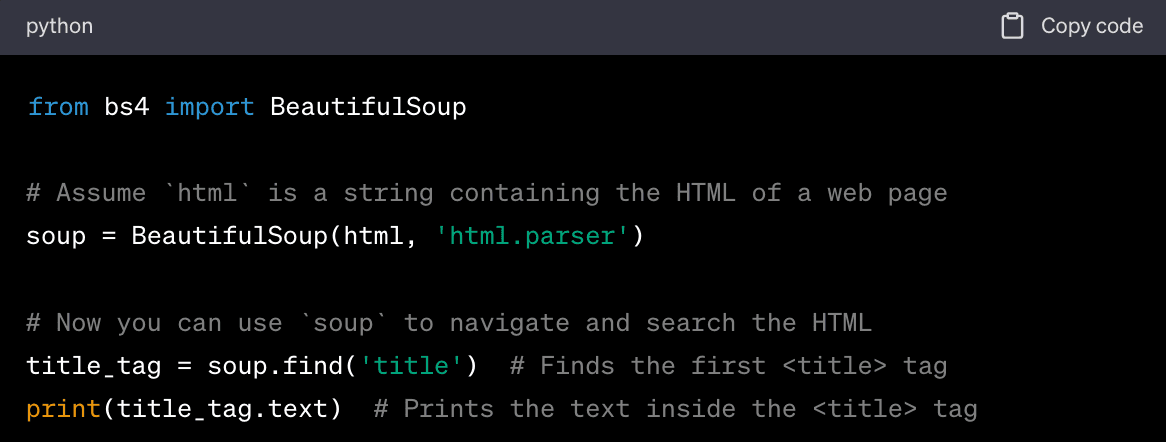
Le HTML est le langage de balisage standard utilisé pour créer des pages web. Il utilise des balises pour désigner différents types de contenu, ce qui facilite relativement la navigation et l’extraction de données spécifiques.
Voici un exemple illustrant comment analyser du code HTML en Python à l’aide de la bibliothèque BeautifulSoup :
Analyse de données JSON
Le JSON (JavaScript Object Notation) est un format d'échange de données léger, facile à lire et à écrire pour les humains, et facile à analyser et à générer pour les machines. Il est souvent utilisé par les API pour envoyer des données.
Voici un exemple illustrant comment analyser du JSON en Python :
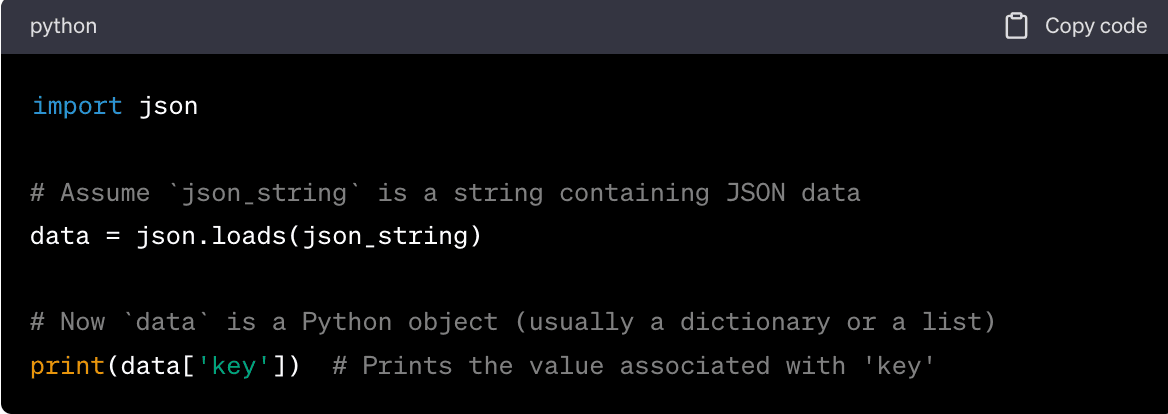
Dans les deux cas, l’objectif de l’analyse est de convertir les données HTML ou JSON brutes en un format plus facile à exploiter dans votre langage de programmation. Une fois les données analysées, vous pouvez les parcourir pour trouver les éléments spécifiques qui vous intéressent.
Conseils pour une gestion efficace des données
La gestion efficace de grandes quantités de données est un aspect crucial du web scraping sur les grandes plateformes de commerce électronique telles que Walmart. Voici quelques conseils pour gérer des ensembles de données volumineux :
• Utilisez une base de données. Le stockage de vos données dans une base de données peut faciliter leur gestion, en particulier si vous traitez de grandes quantités de données. Les bases de données sont conçues pour gérer des ensembles de données volumineux et offrent des fonctionnalités telles que l'indexation, qui permet d'accélérer les requêtes sur vos données.
• Traitement par lots. Au lieu de traiter chaque donnée au fur et à mesure de son extraction, envisagez de regrouper vos données en lots et de traiter chaque lot en une seule fois. Cette méthode peut s’avérer plus efficace et réduire la charge sur votre système.
• Compression des données. Si l’espace de stockage est un problème, pensez à compresser vos données. De nombreux formats de données courants, tels que CSV et JSON, peuvent être compressés jusqu’à atteindre une fraction de leur taille d’origine.
• Traitement parallèle. Si vous effectuez le scraping de plusieurs pages ou sites web à la fois, pensez à utiliser le traitement parallèle pour accélérer le processus. Cela implique d’exécuter plusieurs tâches de scraping simultanément, ce qui peut réduire considérablement la durée totale du scraping.
• Scraping incrémental. Au lieu d’extraire toutes les données en une seule fois, envisagez de procéder de manière incrémentale. Cela consiste à garder une trace des données déjà extraites et à ne récupérer que les données nouvelles ou mises à jour. Cette approche peut s’avérer plus efficace et réduire la charge tant sur votre système que sur le site web que vous explorez.
• Utilisez une solution basée sur le cloud. Les solutions basées sur le cloud offrent un stockage et une puissance de traitement évolutifs, ce qui peut s’avérer particulièrement utile lorsque vous traitez de grandes quantités de données. Des services tels qu’Amazon Web Services (AWS), Google Cloud et Microsoft Azure proposent diverses solutions de stockage et de traitement des données capables de gérer de grands ensembles de données.
• Nettoyage et validation des données. Nettoyez et validez vos données le plus tôt possible dans le pipeline de données. Cela peut inclure la suppression des doublons, le traitement des valeurs manquantes et la vérification de la cohérence des données. Nettoyer et valider vos données dès le début permet d’éviter des erreurs et des pertes d’efficacité par la suite.
N’oubliez pas que l’objectif est de gérer vos données de manière efficace, évolutive et adaptée à vos besoins spécifiques. La meilleure approche peut dépendre de la taille de votre ensemble de données, des ressources dont vous disposez et des exigences spécifiques de votre projet.
Comment éviter d'être bloqué
Bien que le web scraping soit un outil puissant pour extraire des données de sites web, Walmart ne voit pas d'un bon œil cette pratique.
Voici quelques raisons courantes pour lesquelles on peut se faire bloquer lors d'une opération de scraping, ainsi que des conseils pour les éviter :
• Trop de requêtes. Envoyer trop de requêtes en peu de temps peut surcharger les serveurs de Walmart et nuire aux performances du site web. Souvent considéré comme une forme d’abus, c’est une raison courante de blocage. Pour éviter cela, limitez votre fréquence de requêtes et ajoutez des délais entre chacune d’elles.
• Non-respect du fichier robots.txt. Le fichier robots.txt permet aux sites web de communiquer avec les robots d’indexation et les scrapers. Il précise quelles parties du site ne doivent pas être scrapées. Ignorer les règles de ce fichier peut entraîner le blocage de votre scraper. Vérifiez et respectez toujours le fichier robots.txt du site web que vous scrapez.
• Ne pas alterner les adresses IP. Si toutes vos requêtes proviennent de la même adresse IP, cela peut être un signe évident que vous scrapez le site web. Walmart bloquera votre adresse IP si elle envoie trop de requêtes. Pour éviter cela, pensez à utiliser un pool de proxys résidentiels tournants afin de répartir vos requêtes sur plusieurs adresses IP.
- L’API de scraping d’Geonode utilise un pool de proxys tournants. Chaque requête que vous envoyez via l’API est effectuée à partir d’une adresse IP différente. Cela peut vous aider à éviter les blocages basés sur l’adresse IP et la limitation de débit, car cela complique la tâche des sites web pour identifier et bloquer votre outil de scraping. La rotation des adresses IP permet également de répartir vos requêtes de manière plus homogène, ce qui réduit la charge sur chaque serveur et rend votre scraping plus efficace.
• Ne pas utiliser de chaîne User-Agent ou en utiliser une suspecte. La chaîne User-Agent indique au site web quel type d’appareil et de navigateur effectue la requête. Des sites web comme Walmart bloquent les requêtes qui ne comportent pas de chaîne User-Agent, ou qui utilisent une chaîne User-Agent connue pour être associée à des scrapers. Utilisez une chaîne User-Agent légitime qui imite un véritable navigateur.
• Extraction de données protégées. Certaines données d’un site web peuvent être protégées par le droit d’auteur ou d’autres protections juridiques. L’extraction de ces données peut entraîner un blocage et peut également avoir des conséquences juridiques. Assurez-vous toujours que vous disposez du droit de récupérer et d’utiliser les données que vous ciblez.
Bien sûr, le meilleur moyen d’éviter d’être bloqué est de procéder au scraping de manière responsable. Respectez les règles du site web, ne surchargez pas le serveur et assurez-vous toujours que vous disposez du droit de récupérer et d’utiliser les données que vous ciblez.

