Les pipelines ETL sont essentiels car ils offrent une approche rationalisée du traitement des données, permettant ainsi aux entreprises de mieux comprendre leurs activités et de prendre des décisions éclairées.
Un exemple de pipeline ETL est celui utilisé par une entreprise de distribution pour extraire des données de vente d’une base de données, les transformer en un format adapté à l’analyse, puis les charger dans un entrepôt de données à des fins de veille stratégique.
Le pipeline peut utiliser un outil tel qu’Apache NiFi ou Talend pour extraire les données, les transformer à l’aide d’outils comme Apache Spark ou Python, puis les charger dans un entrepôt de données tel qu’Amazon Redshift ou Google BigQuery.
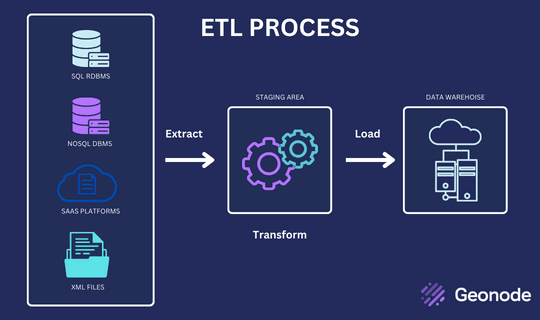
3 Les composants d’un pipeline ETL
Un pipeline ETL comporte trois composantes principales : l’extraction, la transformation et le chargement.
Extraction
La phase d’extraction consiste à extraire des données de diverses sources, telles que des bases de données, des espaces de stockage dans le cloud, des API et des fichiers plats. Les données extraites peuvent se présenter sous différents formats, tels que JSON, CSV ou XML.
Transformation
La phase de transformation consiste à convertir les données extraites en un format exploitable, à les nettoyer et à les enrichir avec des informations supplémentaires. Cette phase implique l’application de diverses techniques de traitement des données, telles que le filtrage, l’agrégation, la jointure et le tri.
Chargement
La phase de chargement consiste à stocker les données transformées dans une destination cible, telle qu’une base de données, un entrepôt de données ou un lac de données. Les données chargées peuvent être utilisées à diverses fins, telles que le reporting, l’analyse ou l’apprentissage automatique.
Pipeline de données vs pipeline ETL
Un pipeline de données est un terme général qui désigne une série d’étapes ou de processus utilisés pour transférer des données d’un système ou d’une application vers un autre. Il peut inclure divers composants tels que l’ingestion, le traitement, le stockage et l’analyse des données.
Un pipeline ETL (Extract, Transform, Load) est un type spécifique de pipeline de données utilisé pour extraire des données d’une ou plusieurs sources, les transformer en un format plus utile ou mieux structuré, puis les charger dans un système ou une application de destination. Les pipelines ETL sont couramment utilisés pour le stockage de données (data warehousing), la veille économique (business intelligence) et les applications d’analyse.
Bien que les pipelines ETL constituent un type spécifique de pipeline de données, ces deux termes sont souvent utilisés de manière interchangeable dans la pratique. Un pipeline de données désigne généralement tout ensemble de processus ou d’outils utilisés pour transférer, traiter et analyser des données. En revanche, un pipeline ETL fait spécifiquement référence à l’extraction de données, à la transformation et au chargement.
Types de pipelines ETL
Les deux types distincts de pipelines ETL (Extract, Transform, Load) sont les suivants :
Traitement par lots : ce type de pipeline consiste à traiter de grands volumes de données par lots, généralement au quotidien ou chaque semaine. Les données sont extraites des systèmes sources, transformées au format souhaité, puis chargées dans un système de destination au cours d’un processus par lots. L’ETL par lots est utile pour le stockage de données, la veille économique et les applications d’analyse.
Traitement en temps réel : ce type de pipeline consiste à traiter les données en temps quasi réel, au fur et à mesure qu'elles sont générées ou reçues par le système source. Les données sont extraites des systèmes sources, transformées en temps réel, puis chargées dans un système de destination dans le cadre d'un processus continu.
Les avantages de l'utilisation d'un pipeline ETL
Les pipelines ETL offrent plusieurs avantages, notamment :
Un traitement des données rationalisé
Les pipelines ETL offrent une approche rationalisée du traitement des données, permettant aux entreprises de traiter rapidement et efficacement de vastes quantités de données.
Amélioration de la qualité des données
Les pipelines ETL permettent aux entreprises d’améliorer la qualité de leurs données en éliminant les enregistrements en double, en corrigeant les erreurs et en appliquant des normes de données.
Réduction de la complexité
Les pipelines ETL réduisent la complexité du traitement des données en fournissant une interface unique pour la gestion des tâches d’intégration des données.
Amélioration de la prise de décision
Les pipelines ETL fournissent aux entreprises des informations opportunes, précises et exploitables sur leurs opérations, leur permettant ainsi de prendre des décisions éclairées.
Langages ETL
Les pipelines ETL peuvent être mis en œuvre à l'aide de divers langages de programmation et outils, en fonction des exigences spécifiques du pipeline et des technologies utilisées. Parmi les langages et outils ETL couramment utilisés, on peut citer :
SQL (Structured Query Language) : le SQL est un langage standard utilisé pour gérer et interroger les données dans les bases de données relationnelles. Les pipelines ETL y ont souvent recours pour extraire et transformer les données issues de bases de données.
Python : Python est un langage de programmation très répandu, utilisé pour un large éventail de tâches de traitement et d’analyse de données, y compris les pipelines ETL. Python dispose de nombreuses bibliothèques et frameworks dédiés à la manipulation, à la transformation et au chargement des données, tels que Pandas, NumPy et Apache Airflow.
Java : Java est un langage de programmation largement répandu qui peut servir à créer des pipelines ETL. Plusieurs outils ETL basés sur Java sont disponibles, tels qu’Apache NiFi, Talend et Apache Beam.
R : R est un langage de programmation couramment utilisé pour l’analyse statistique et la visualisation de données. Il dispose de nombreuses bibliothèques et modules dédiés à la manipulation et à la transformation des données, et peut être utilisé pour créer des pipelines ETL.
Outils ETL : Il existe également de nombreux outils ETL proposant une interface utilisateur graphique pour la création et la gestion de pipelines ETL, tels que Talend, Informatica et Microsoft SSIS. Ces outils prennent souvent en charge divers langages de programmation et sources de données, et permettent de simplifier le processus de création et de maintenance des pipelines ETL.
Bonnes pratiques pour la conception et la mise en œuvre de pipelines ETL
Les entreprises doivent respecter certaines bonnes pratiques pour garantir le succès d’un pipeline ETL, notamment :
Définir vos sources de données et vos exigences
Avant de concevoir un pipeline ETL, les entreprises doivent définir leurs sources de données et leurs exigences. Cela implique d’identifier les sources de données à intégrer, leurs formats et les normes de qualité des données auxquelles elles doivent se conformer.
Choisir les bons outils
Le choix des bons outils est essentiel pour la conception et la mise en œuvre d’un pipeline ETL. De plus, les entreprises doivent tenir compte de l’évolutivité, de la flexibilité et de la rentabilité des outils sélectionnés.
Créer un flux de données clair
Un flux de données clair est essentiel pour concevoir un pipeline ETL efficace et performant. De plus, ce flux doit être facile à comprendre, et les différentes étapes du pipeline doivent être clairement définies.
Mettre en place une gestion robuste des erreurs
Une gestion robuste des erreurs est essentielle pour garantir la fiabilité d’un pipeline ETL. Par conséquent, les entreprises doivent mettre en place des mécanismes de gestion des erreurs capables de détecter et de résoudre les erreurs.
Tester et surveiller régulièrement votre pipeline
Il est essentiel de tester et de surveiller régulièrement un pipeline ETL pour garantir son efficacité et identifier les problèmes potentiels avant qu’ils ne causent des difficultés.
Défis courants liés aux pipelines ETL et comment les surmonter
Malgré leurs avantages, les pipelines ETL peuvent également présenter certains défis, notamment :
Incohérences dans les données
Des incohérences dans les données peuvent survenir lorsque les sources de données utilisées dans un pipeline ETL contiennent des erreurs ou des incohérences. Des contrôles de qualité des données et des mécanismes de nettoyage doivent être mis en place pour remédier à ce problème.
Problèmes de qualité des données
Des problèmes de qualité des données peuvent survenir lorsque les données utilisées dans un pipeline ETL sont de mauvaise qualité ou contiennent des inexactitudes. Les entreprises doivent mettre en œuvre des contrôles de qualité des données et des mécanismes de validation afin de garantir l’exactitude et la cohérence des données.
Goulots d’étranglement au niveau des performances
Des goulots d’étranglement au niveau des performances peuvent se produire lorsqu’un pipeline ETL est surchargé ou lorsqu’il ne parvient pas à s’adapter pour gérer des volumes de données croissants. Pour éviter ce problème, les entreprises doivent optimiser leurs pipelines ETL en termes de performances et d’évolutivité.
Évolutivité limitée
Une évolutivité limitée peut se produire lorsqu’un pipeline ETL est incapable de traiter de grands volumes de données. Les pipelines ETL doivent être conçus pour être évolutifs et utiliser des technologies de calcul distribué afin de résoudre ce problème.
Conclusion
En conclusion, un pipeline ETL est un élément essentiel d’un système complet de traitement des données. Il permet aux entreprises de collecter, de transformer et de charger de vastes quantités de données provenant de diverses sources, et ainsi d’obtenir des informations utiles sur leurs activités. Toutefois, pour concevoir et mettre en œuvre un pipeline ETL efficace, les entreprises doivent respecter certaines bonnes pratiques, telles que définir leurs sources de données et leurs besoins, choisir les outils adaptés, établir un flux de données clair, mettre en place une gestion robuste des erreurs, ainsi que tester et surveiller régulièrement leur pipeline.
Questions fréquentes
-
Quelle est la différence entre l'ETL et le pipeline de données ?
L'ETL et le pipeline de données sont deux concepts liés mais distincts. L'acronyme ETL signifie « Extract, Transform (transformation) et Load (chargement) ; il désigne un processus spécifique consistant à extraire des données de diverses sources, à les transformer en un format exploitable, puis à les charger dans une destination cible. En revanche, un pipeline de données renvoie à un concept plus large de transfert de données entre différents systèmes et applications, qui peut inclure l’ETL en tant que sous-ensemble du processus global.
-
Le SQL est-il un outil ETL ?
Le SQL n’est pas un outil ETL en soi, mais il est couramment utilisé dans les processus ETL pour manipuler et transformer les données. Le SQL permet d’effectuer diverses transformations de données, telles que le filtrage, l’agrégation et la jointure, qui constituent des éléments essentiels de l’étape de transformation dans un pipeline ETL.
-
Comment créer un pipeline ETL ?
La création d’un pipeline ETL comporte plusieurs étapes, notamment la définition des sources de données et des exigences, le choix des outils adaptés, la mise en place d’un flux de données clair, la mise en œuvre d’une gestion robuste des erreurs, ainsi que le test et la surveillance réguliers du pipeline. Parmi les outils couramment utilisés pour créer des pipelines ETL, on trouve Apache Kafka, Apache Spark et Talend Open Studio.
-
Qu’est-ce que l’ETL dans le cadre du DevOps ?
Dans le cadre du DevOps, l’ETL désigne le processus d’intégration de données provenant de diverses sources dans le pipeline DevOps. Cela peut inclure l’extraction de données à partir de référentiels de code source, d’outils de build et de frameworks d’automatisation des tests, leur transformation en un format exploitable, puis leur chargement vers une destination cible, telle qu’un entrepôt de données ou un outil de business intelligence. L'ETL dans le DevOps est essentiel pour fournir aux équipes des informations en temps réel sur leurs processus de développement logiciel et leur permettre de prendre des décisions fondées sur les données.
Références
Sharma, V. (13 juin 2022). Guide complet sur la création d’un pipeline ETL pour les débutants. Analytics Vidhya. Consulté le 10 mars 2023, sur https://www.analyticsvidhya.com/blog/2022/06/a-complete-guide-on-building-an-etl-pipeline-for-beginners/
Qu’est-ce qu’un pipeline ETL ? (s.d.). Snowflake. Consulté le 10 mars 2023 sur https://www.snowflake.com/guides/etl-pipeline
Qu'est-ce qu'un pipeline ETL ? Comparaison entre un pipeline de données et un pipeline ETL. (s.d.). Qlik. Consulté le 10 mars 2023 sur https://www.qlik.com/us/etl/etl-pipeline

