Immobiliare.itは、イタリアを代表するオンライン不動産プラットフォームの一つです。
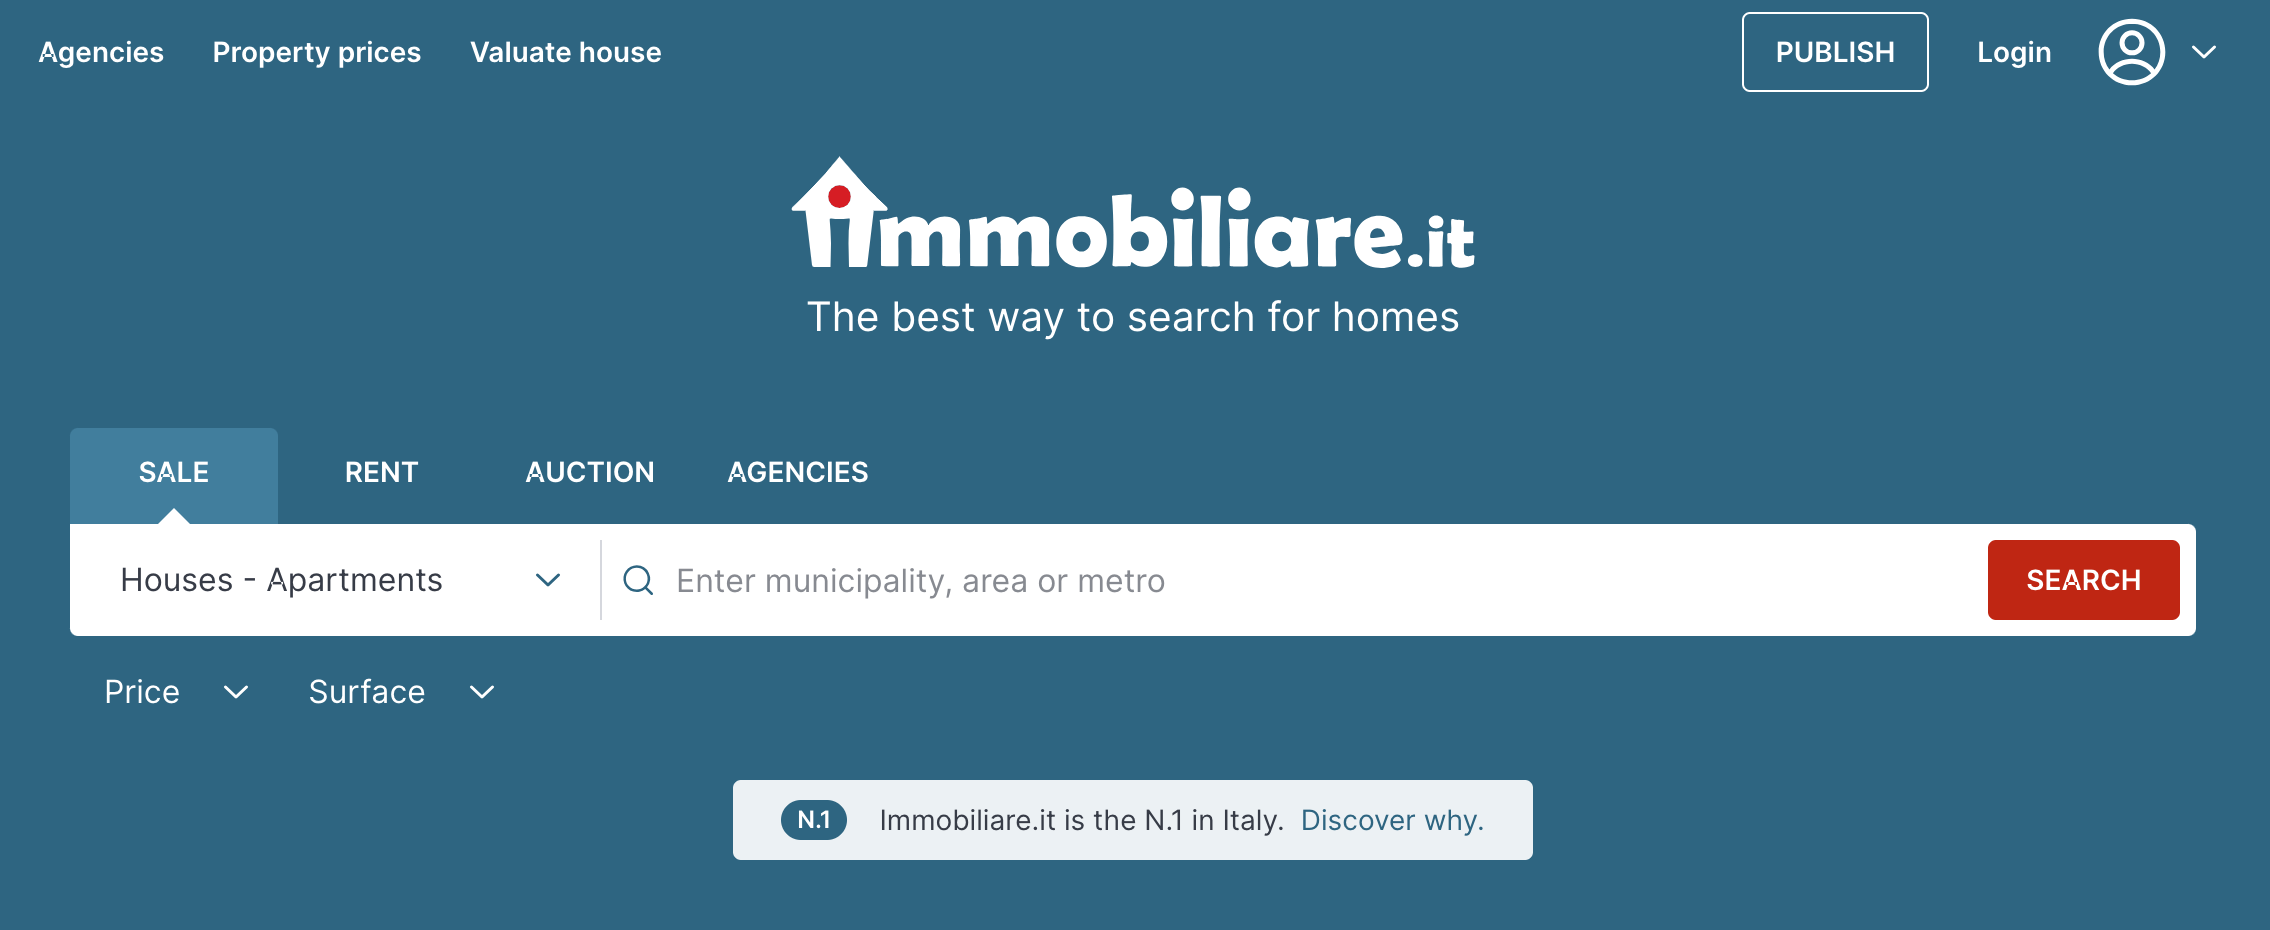
住宅、商業用、バケーション用物件など、幅広い物件情報を掲載しており、イタリアの不動産への投資を検討している方にとって、包括的な情報源となっています。
米国の不動産業者や購入希望者にとって、Immobiliare.itは、海外からでは通常アクセスが困難な多様な市場に参入できる、またとない機会を提供しています。

Maricor Bunal
更新日:2026年10月7日
公開日:2023年9月7日
Immobiliare.itから不動産データをスクレイピングするための究極のガイドをご紹介します。貴重な不動産情報を手間なく収集するためのテクニック、ツール、ベストプラクティスを学びましょう。今すぐ不動産分析のスキルを向上させましょう!
Immobiliare.itは、イタリアを代表するオンライン不動産プラットフォームの一つです。
住宅、商業用、バケーション用物件など、幅広い物件情報を掲載しており、イタリアの不動産への投資を検討している方にとって、包括的な情報源となっています。
米国の不動産業者や購入希望者にとって、Immobiliare.itは、海外からでは通常アクセスが困難な多様な市場に参入できる、またとない機会を提供しています。
不動産業界において、データは最も重要な要素です。正確かつタイムリーな情報は、投資の成功と多大な損失を招く失敗を分ける鍵となります。
米国の不動産業者や物件購入者にとって、イタリア市場を理解するには信頼できるデータ源が必要です。
Immobiliare.itは、物件情報、価格動向、地域に関する分析などを通じて、こうした情報を提供しています。
当プラットフォームの充実した検索フィルターにより、ユーザーは立地、物件タイプ、価格帯などのさまざまな条件に基づいて選択肢を絞り込むことができ、特定の投資目標に合った物件を容易に見つけることができます。
Immobiliare.itの不動産データの活用例
市場調査。 米国の不動産仲介業者は、このデータを活用してイタリアの不動産市場をより深く理解し、顧客にとって有益なトレンドや機会を特定することができます。
投資判断。 米国からの不動産購入者は、Immobiliare.it を利用して、十分な情報に基づいた投資判断を下すことができます。
このプラットフォームのデータは、過小評価されている物件、注目度が高まりつつある地域、あるいは収益性の高いバケーションレンタル物件を特定するのに役立ちます。
比較分析。 このデータを活用して、イタリア市場と米国市場を比較することができます。
これは、ポートフォリオを国際的に分散させようとしている投資家にとって特に有用です。
顧客サービス。 不動産仲介業者は、イタリア市場に関心を持つ米国の顧客に対し、Immobiliare.itのデータに基づいたカスタマイズされたレポートや分析など、追加のサービスを提供できます。
マーケティング戦略。 Immobiliare.itからデータをスクレイピングすることで、企業は物件の特徴や立地に関する最新のトレンドを把握でき、より効果的な市場戦略の策定に役立てることができます。
このアプローチにより、不動産ウェブサイトの市場における競争力を高めることができます。
価格分析。 Immobiliare.itから価格データや価格履歴をスクレイピングすることで、包括的な価格分析が可能になります。
市場価格の変動、最新の価格、現在の市場価格を把握することは、企業や消費者がより情報に基づいた意思決定を行う上で役立ちます。
法規制に関する知見。 Immobiliare.itでは、イタリアの不動産関連法や規制を解説する記事や資料が頻繁に掲載されており、イタリアの法制度に不慣れな米国人投資家にとって極めて貴重な情報源となります。
Immobiliare.itで入手可能なデータやリソースを活用することで、米国の不動産業者や不動産購入者は、困難であると同時に大きな見返りのある市場において、競争上の優位性を獲得することができます。
オンラインプラットフォームからデータを収集する際には、法律の範囲内で活動し、データ所有者の権利を尊重するために、法的および倫理的な状況を正しく理解することが極めて重要です。
ウェブサイトをスクレイピングする前に、ウェブクローラー向けのルールを定めた「robots.txt」ファイルを確認することが不可欠です。
Immobiliare.itのrobots.txtファイルには、スクレイピングしてはならないウェブサイトの領域を示す「Disallow」ディレクティブがいくつか含まれています。
例えば、検索マップ、ユーザーエリア、特定の種類の物件情報などのスクレイピングが禁止されています。
これらのルールに違反すると、サイトへのアクセス禁止措置を受けたり、法的措置の対象となる可能性があります。
したがって、Immobiliare.it でのデータ収集活動を検討する際は、robots.txt ファイルに定められたガイドラインを遵守することが不可欠です。
法的側面に加え、ウェブサイトからデータをスクレイピングする際には、倫理的配慮も重要となります。
倫理的なウェブスクレイピングとは、法律の条文と精神の両方を尊重するとともに、スクレイピングしてはならないサイト内の領域を定めたrobots.txtファイルの規定を遵守することを指します。
さらに、倫理的なスクレイピングには、ウェブサイトのサーバーに過度な負荷をかけないこと、ユーザーのプライバシーを尊重すること、そしてデータを責任を持って利用することが含まれます。
これらの倫理的ガイドラインを遵守しない場合、評判を損なうだけでなく、法的措置を招く可能性もあります。
以下に、ウェブスクレイピングの合法性について論じた3つの記事とその要約を掲載します:
米国第9巡回控訴裁判所は、一般に公開されているデータをスクレイピングすることは「コンピュータ詐欺・濫用防止法(CFAA)」の違反には当たらないとの判決を下しました。この判決は、ウェブスクレイピングツールを利用するアーキビスト、学者、研究者、ジャーナリストにとって重要な意味を持ちます。
ただし、記事では、ウェブスクレイピングがプライバシーやセキュリティ上の懸念を引き起こした事例もあったと述べられています。この訴訟は当初、LinkedInが、同社のユーザープロフィールをスクレイピングしていた企業Hiq Labsを相手取って提起したものでした。LinkedInは2019年に敗訴し、第9巡回控訴裁判所はその当初の判決を再確認しました。
この記事では、スクレイピングされたデータが一般に公開されている限り、米国にはウェブスクレイピングを禁止する連邦法は存在しないと述べている。
ただし、倫理的配慮の重要性を強調し、ウェブスクレイパーに対しては、ウェブサイトの利用規約やrobots.txtファイルの範囲内で操作を行うよう助言しています。
この記事では、ほとんどの法律において、個人を特定できる情報(PII)を、所有者の明示的な同意なしに収集、使用、または保存することは違法であると論じています。
また、特に機密情報の収集が関わる場合、ウェブスクレイピングは法的なグレーゾーンに該当することがあるとも述べています。
ウェブスクレイピングの分野では、さまざまなニーズに合わせて利用できるツールや技術が数多く存在します。初心者から経験豊富なデータサイエンティストまで、プロジェクトの要件に合ったツールが見つかるはずです。以下では、最も一般的に使用されているツールをいくつか紹介します。
Pythonはウェブスクレイピングで広く使われている言語であり、作業を容易にするためのライブラリがいくつか提供されています:
BeautifulSoup: これは、HTML や XML ファイルからデータを抽出するための Python ライブラリです。解析ツリーの反復処理、検索、変更を行うための Python らしいイディオムを提供しています。
BeautifulSoup は、Web ページからデータを抽出する Web スクレイピングによく使用され、初心者でも比較的習得しやすいです。
Selenium: ソースコードのみをスクレイピングするBeautifulSoupとは異なり、Seleniumは人間のユーザーと同じようにWebページとやり取りします。
JavaScriptを介してコンテンツが読み込まれる動的なWebサイトのスクレイピングによく使用され、自動テストにも活用できます。
これらのライブラリは組み合わせて使用することができ、あらゆるウェブスクレイピングプロジェクトに強力なツールキットを提供します。
ウェブスクレイピングサービスは、コーディングに深く関わりたくない人にとって便利な選択肢となります。
これらのサービスには、多くの場合、直感的なユーザーインターフェースが備わっており、コードを一切書くことなく、スクレイピングしたいデータを指定することができます。
データの抽出から保存までをすべて処理してくれるため、ユーザーはデータの分析や活用に集中しやすくなります。P
GitHub は、ウェブスクレイピングに関するリソースの宝庫です。あらかじめ作成されたスクレイピングスクリプト、フレームワーク、チュートリアルを提供する数多くのリポジトリを見つけることができます。
以下に、役立つと思われるリポジトリの種類をいくつか紹介します:
チュートリアルリポジトリ。 ウェブスクレイピングを始めるのに役立つ、ステップバイステップのガイドやコードスニペットが提供されています。
フレームワークリポジトリ。 特定の種類のウェブサイトやデータをスクレイピングするために設計された、あらかじめ構築されたフレームワークが含まれています。
プロジェクトリポジトリ。 これらは、複数のウェブサイトや技術を組み合わせた、より複雑なスクレイピングタスクを実演する本格的なプロジェクトです。
これらのリポジトリを研究することで、Webスクレイピングのベストプラクティスや高度なテクニックに関する知見を得ることができます。
このセクションでは、Pythonライブラリやその他のツールを使用してImmobiliare.itからデータを収集する方法について、包括的なガイドを提供します。
以下の手順に従って、環境を設定し、コードを記述し、さらに学習を進めるためのGitHubのサンプルを見つけてください。
Pythonのインストール。 まだインストールしていない場合は、公式サイトからPythonをダウンロードしてインストールしてください。
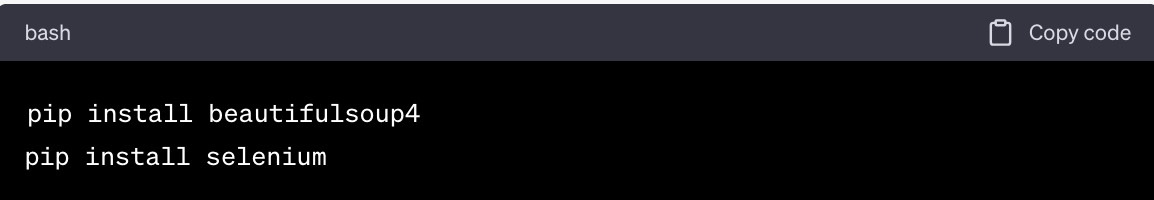
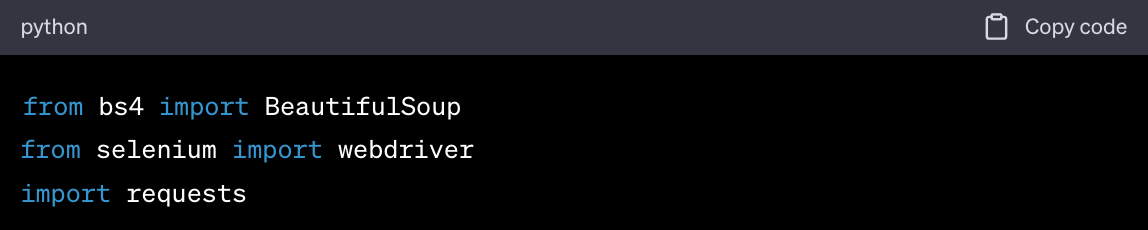
ライブラリのインストール。 ターミナルを開き、以下のコマンドを実行してBeautifulSoupとSeleniumをインストールしてください:
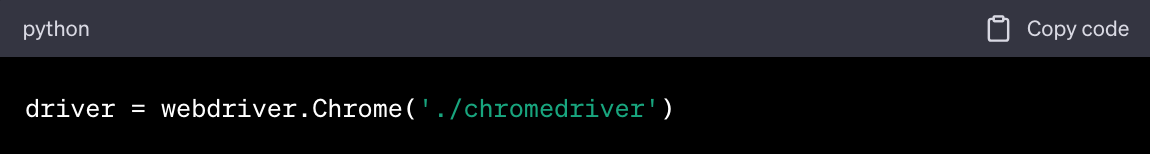
Webドライバー。 お使いのブラウザに対応したWebドライバー(例:Chromeの場合はChromeDriver)をダウンロードし、プロジェクトディレクトリに配置してください。
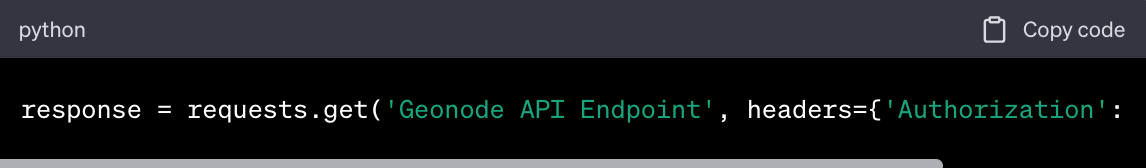
GeonodeのAPIキー。 GeonodeのPay-As-You-Goスクレイパーを使用する場合は、同サイトのウェブサイトからAPIキーを取得してください。
ライブラリのインポート。 スクリプトの冒頭で、必要な Python ライブラリをインポートしてください。
WebDriver の初期化。 Selenium WebDriver を初期化します。
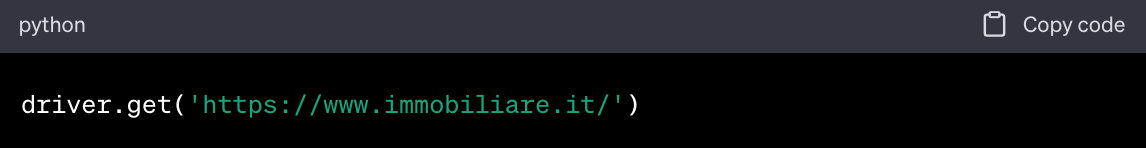
Immobiliare.it への移動。 WebDriver を使用して、スクレイピングしたい Immobiliare.it のウェブページに移動します。
要素の特定。 BeautifulSoup または Selenium の関数を使用して、スクレイピングしたいデータを含む HTML 要素を特定します。
データのスクレイピング。 データを抽出し、変数またはファイルに保存します。
Geonode API。 Geonode を使用する場合は、API 呼び出しを行い、プロキシ、ブラウザ、キャプチャを処理します。
WebDriver を終了します。 作業が完了したら、WebDriverを閉じるのを忘れないでください。
リポジトリを検索する。 GitHubの検索機能を使用して、Python、BeautifulSoup、Seleniumを用いたウェブスクレイピングに関連するリポジトリを探します。
コードを研究する。 不動産サイトやImmobiliare.it向けに特別に設計された例を探しましょう。
チュートリアルに従う。 GitHubのリポジトリの中には、コードをより深く理解するのに役立つステップバイステップのチュートリアルを提供しているものもあります。
リポジトリをクローンして試してみましょう。 遠慮せずにリポジトリをクローンし、自分のニーズに合わせてコードを調整してみてください。
基本的なウェブスクレイピングのテクニックに慣れてくると、より複雑な課題に取り組む必要が出てくるかもしれません。このセクションでは、こうした複雑なシナリオに対処するのに役立つ高度なテクニックをいくつか紹介します。
動的ウェブサイトは、多くの場合JavaScriptを使用してコンテンツを非同期で読み込みます。これにより、スクレイピングがより困難になることがあります。ここでは、動的ウェブサイトに対処するための高度なテクニックをいくつか紹介します。
Selenium WebDriver。 前述の通り、Seleniumは動的なウェブページと対話できるため、JavaScriptを介して読み込まれるデータをスクレイピングすることができます。
ヘッドレスブラウジング。 PhantomJS などのヘッドレスブラウザを使用するか、Selenium をヘッドレスモードで実行することで、実際のブラウザウィンドウを開かずにウェブサイトをスクレイピングできます。
AJAXリクエスト。 一部のウェブサイトは、AJAXリクエストを介してデータを読み込みます。開発者ツールを使用してこれらのリクエストを調査し、Pythonのrequestsライブラリを使って再現することができます。
待機コマンド。 Seleniumの明示的および暗黙的な待機コマンドを使用して、スクレイピングを行う前にウェブページが完全に読み込まれていることを確認します。
不動産エージェントに関するデータのスクレイピングは、正確性が求められることや倫理的な配慮が必要なことから、やや複雑になる場合があります。以下にいくつかのヒントを紹介します:
特定のセクションをターゲットにする。 BeautifulSoup や XPath 式を使用して、エージェントデータが保存されているウェブサイトの特定のセクションをターゲットにします。
ページネーション。 多くのウェブサイトでは、不動産エージェントが複数のページにまたがって掲載されています。コードでページネーションを適切に処理できるようにしてください。
レート制限。 ウェブサイトの利用規約を遵守してください。サーバーへの過度な負荷を避けるため、コードにレート制限を実装しましょう。
データの検証。 スクレイピングしたデータは常に検証し、正確かつ完全であることを確認してください。
ウェブサイトは頻繁にHTML構造を更新するため、スクレイピングコードが動作しなくなる可能性があります。以下に、その対応方法をご紹介します:
定期的な更新:スクレイピング対象のウェブサイトに関連するStackOverflowのスレッドを常にチェックしましょう。ユーザーは、ウェブサイトの構造変更に関する最新情報をよく共有しています。
エラー処理:スクレイピングに失敗した際に通知されるよう、コードに堅牢なエラー処理を実装し、それに応じてコードを更新できるようにしましょう。
コミュニティの知見:ウェブサイトのコード構造が変更された際、スクレイピングの回避策や代替手法を見つけるには、StackOverflowが最適な場所です。
これらの高度なテクニックを習得することで、幅広いウェブスクレイピングの課題に立ち向かう準備が整います。動的なコンテンツ、特殊なデータ、あるいは変化するウェブサイトの構造など、どのような状況であっても、これらの手法は効果的なデータ収集に必要なスキルを身につけるのに役立ちます。
データの収集が完了したら、次のステップは、そのデータを効果的に分析し、活用することです。
このセクションでは、スクレイピングしたデータの分析、独自の価格設定モデルの構築、およびオファープロファイルの作成と更新のプロセスについて解説します。
データクレンジング。 あらゆるデータ分析プロセスの第一歩は、データのクレンジングです。 重複データを削除し、欠損値を処理し、必要に応じてデータ型を変換します。
データの可視化。 Matplotlib や Seaborn などのライブラリを使用して、データを可視化します。これにより、傾向、外れ値、またはパターンを特定するのに役立ちます。
統計分析。 統計的手法を用いてデータを要約します。平均、中央値、標準偏差などを算出し、データの分布をより深く理解します。
**テキスト分析。 **テキストデータをスクレイピングした場合は、自然言語処理(NLP)の手法を用いて知見を抽出することを検討してください。
相関分析。 互いに強い相関関係にある変数を特定します。これは、不動産分野において、さまざまな要因が物件価格にどのように影響するかを理解する上で特に有用です。
ウェブスクレイピングには、いくつかの課題があります。CAPTCHAやレート制限から、データの品質や信頼性に関する懸念に至るまで、このセクションでは、直面する可能性のある課題に備え、それらを克服するための解決策を紹介します。
これらの一般的な課題とその解決策を把握しておくことで、ウェブスクレイピングを行う際に発生するあらゆる問題に、より適切に対処できるようになります。
WebHarvy、Octoparse、Import.io などのノーコードのウェブスクレイピングツールを利用できます。 これらのツールは、ポイント&クリックでデータ抽出ができる使いやすいインターフェースを備えています。
ウェブスクレイピングで最も一般的に使用されるPythonライブラリは、HTMLやXMLの解析に用いるBeautifulSoupと、JavaScriptを多用するウェブサイトとのやり取りに用いるSeleniumです。 より複雑なプロジェクトには、Scrapyも選択肢の一つです。
ウェブスクレイピングの合法性は、ウェブサイトの利用規約やデータの使用方法によって異なります。コンプライアンスを確保するため、必ずウェブサイトの利用規約を確認し、必要に応じて法律の専門家に相談することを検討してください。
環境のセットアップから課題の克服まで、ウェブスクレイピングのさまざまな側面について見てきました。ここではまとめを行い、今後の展望について考えてみましょう。
公式ドキュメント。 常に良い出発点となります。 BeautifulSoup、Selenium、その他のライブラリには、その機能をより深く理解するのに役立つ充実したドキュメントが用意されています。
オンライン講座。 Udemy、Coursera、edX などのウェブサイトでは、ウェブスクレイピングやデータ分析に関する講座が提供されています。
YouTubeのチュートリアル。 基礎から高度なテクニックまで、あらゆる内容を網羅したチュートリアルが無数に公開されています。
フォーラムやコミュニティ。 StackOverflowやRedditなどのウェブサイトには、質問をしたり知識を共有したりできる活発なコミュニティがあります。
書籍。 ウェブスクレイピングやデータ収集のテクニックに焦点を当てた書籍も数多く出版されています。
効果的なウェブスクレイピングに必要な知識とツールを身につけたところで、いよいよ実践に移す時が来ました。
まずは小規模なプロジェクトから始め、試行錯誤を重ね、自信がついてきたら、より複雑なプロジェクトにも躊躇なく挑戦してみてください。
覚えておいていただきたいのは、ウェブスクレイピングを成功させる鍵は、単にデータを収集することではなく、それを実用的な知見に変えることにあるということです。