Media.netは、パブリッシャー、広告主、広告代理店向けに幅広いソリューションを提供する、業界をリードする広告テクノロジー企業です。
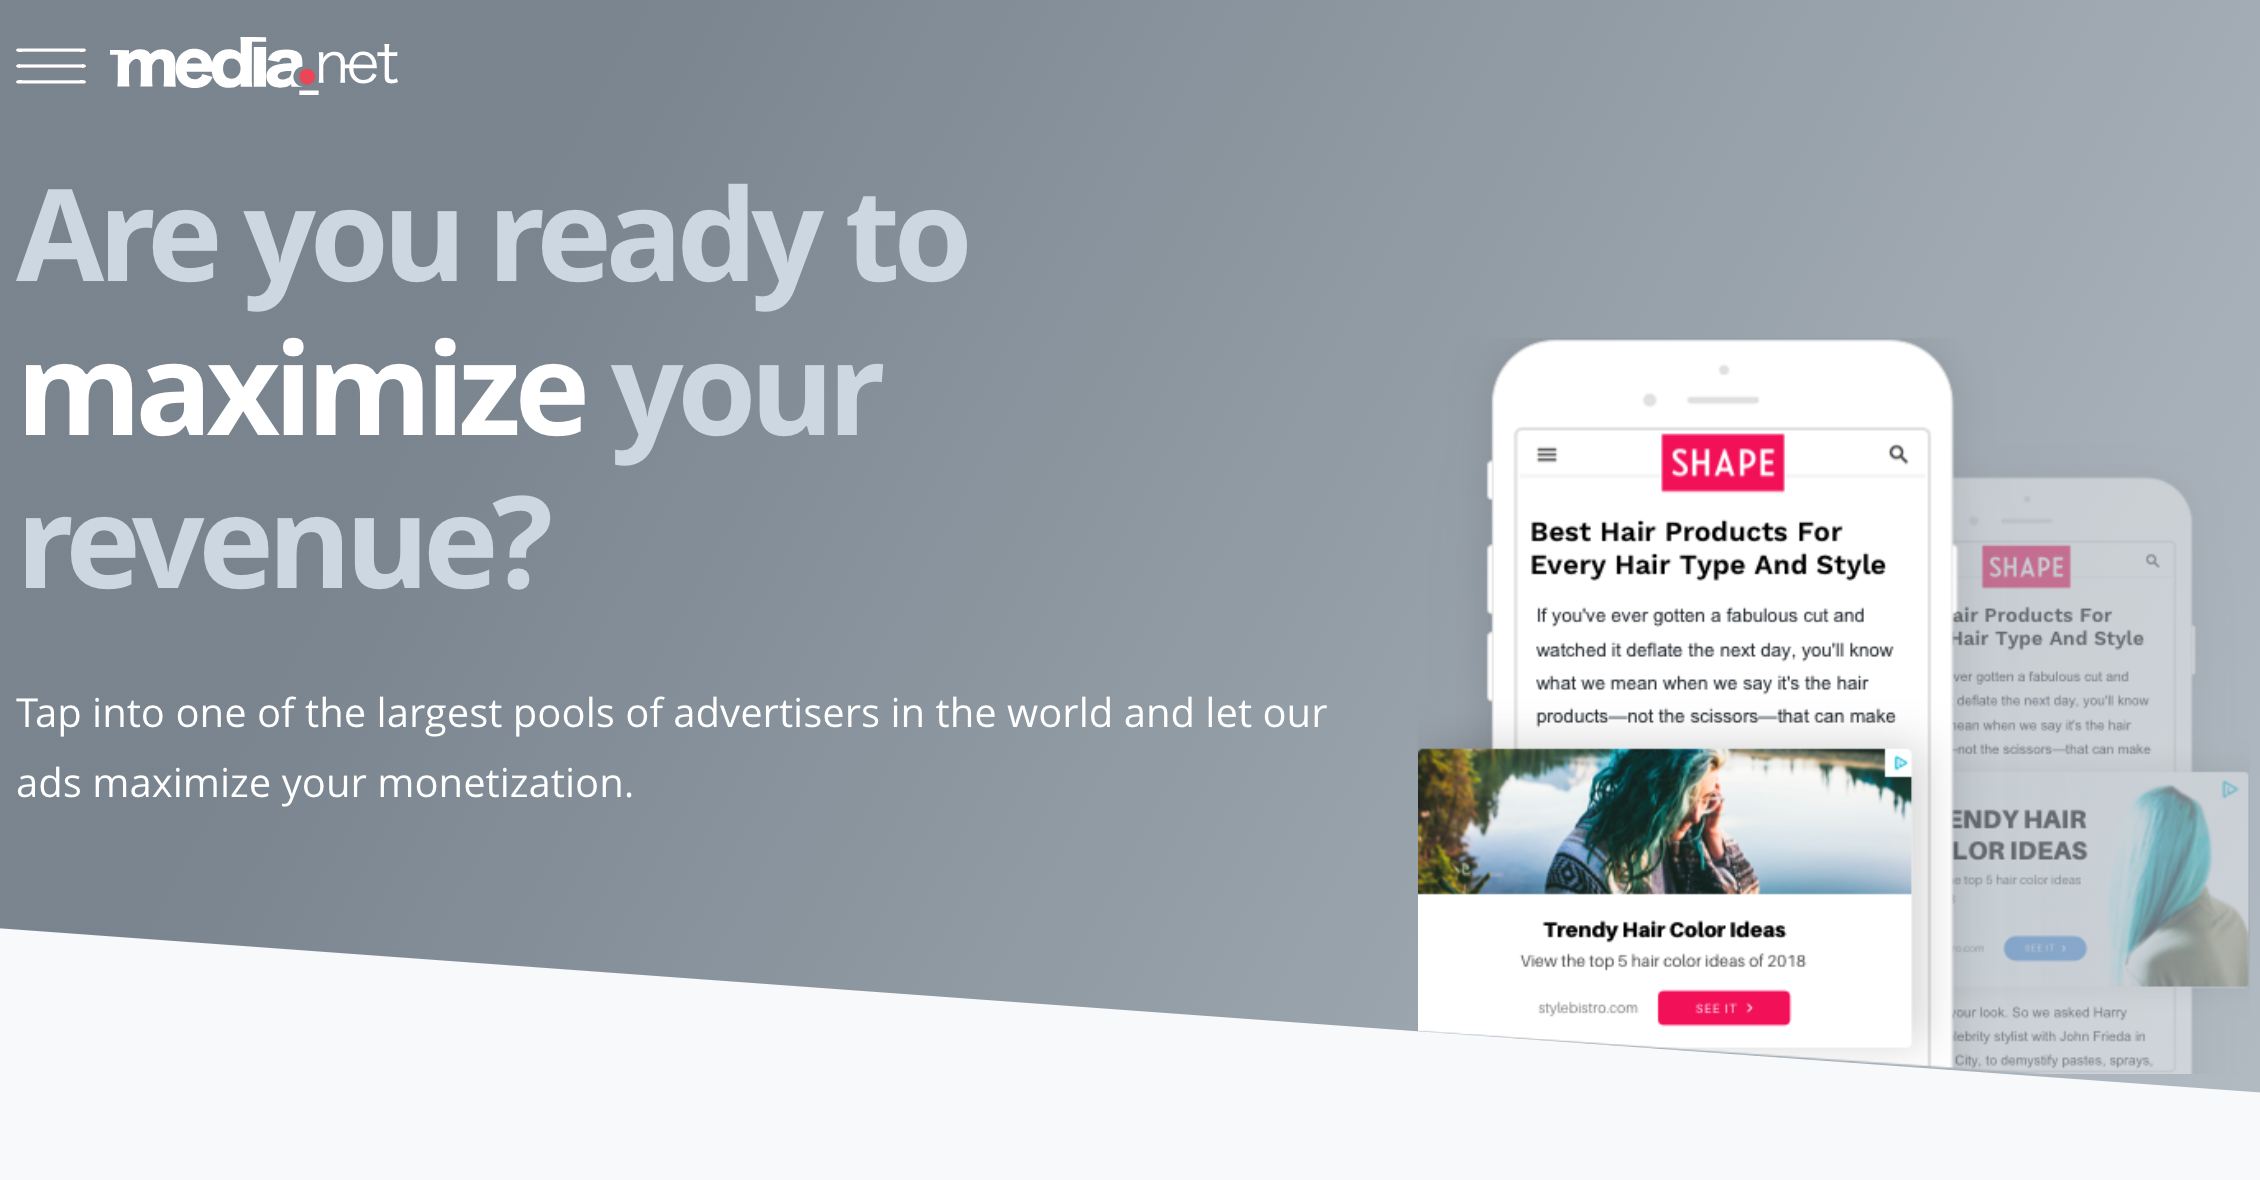
コンテキスト広告に重点を置くMedia.netは、デジタル広告エコシステムにおいて主要なプレイヤーとしての地位を確立しています。
同社は、関連性の高い広告を通じてウェブサイトのコンテンツを収益化できるプラットフォームを提供しており、それによってパブリッシャーと広告主の双方にとってメリットのある関係を築いています。

Maricor Bunal
更新日:2026年10月7日
公開日:2023年9月7日
この包括的なガイドでは、Media.netからのデータ収集に関する技術的および倫理的な側面について解説します。法的および倫理的な基準を遵守しつつ、効果的にデータを収集するためのツール、言語、およびベストプラクティスについて学びましょう。
Media.netは、パブリッシャー、広告主、広告代理店向けに幅広いソリューションを提供する、業界をリードする広告テクノロジー企業です。
コンテキスト広告に重点を置くMedia.netは、デジタル広告エコシステムにおいて主要なプレイヤーとしての地位を確立しています。
同社は、関連性の高い広告を通じてウェブサイトのコンテンツを収益化できるプラットフォームを提供しており、それによってパブリッシャーと広告主の双方にとってメリットのある関係を築いています。
Media.netからデータをスクレイピングすることで、パブリッシャーや広告主は、利用可能な広告の種類や価格モデルを把握でき、収益最大化に向けたより効果的なマーケティング戦略や事業計画の策定に役立てることができます。
Media.netは、アドテック業界における世界的なリーダーです。 このプラットフォームからデータを収集することで、市場動向の把握や事業戦略の策定に不可欠となる競合情報を得ることができます。
Media.netは、カスタマイズされたネイティブ広告を提供することでユーザー体験を重視しています。実際のユーザーからのエンゲージメント率などの指標を分析することで、自社のユーザーエンゲージメント戦略を最適化することができます。
Media.netは、クロスフォーマット・ヘッダービディングなどの最先端技術を採用しています。これらを理解することで、同様の技術を活用する際の競争優位性を得ることができます。
Media.netの利用規約および品質ポリシーへの準拠は不可欠です。倫理的な実践を確保するため、データスクレイピングはこれらのガイドラインに準拠した方法で行わなければなりません。
Media.netのデータをスクレイピングすることで、同社の広告サービス、価格モデル、市場での位置づけに関する洞察が得られます。この競合分析情報は、業界における自社の立ち位置を把握したい企業にとって極めて貴重なものです。
Media.netのデータからは、市場のトレンドや消費者の嗜好が明らかになり、企業が理想的な顧客プロファイルを作成し、それに応じて提供サービスを調整するのに役立ちます。
Media.netから価格データをスクレイピングすることで、各種広告タイプの市場相場を明確に把握でき、より競争力のある価格戦略の策定に役立ちます。
入手可能であれば、Media.net上のユーザーレビューやコメントは、市場のセンチメントや顧客満足度に関する洞察を提供します。このデータは、Media.netおよびその競合他社にとって、改善すべき点を特定したり、強みを活かしたりするための指針となります。
データスクレイピングを業務に組み込むことで、戦略的な意思決定に役立つ実用的な洞察を収集するプロセス全体を効率化することができます。
Media.netからデータを収集しようとする者にとって、データ収集プロセスの法的および倫理的な側面を理解することは極めて重要です。
ウェブスクレイピングは極めて貴重な知見をもたらす可能性がありますが、法的トラブルを避けるためにも、責任を持って取り組むことが重要です。
robots.txt ファイルは、Web サイトが Web クローリングやスクレイピングボットに対し、どのページを取得可能か、あるいは不可かを指示するために使用する標準規格です。
Media.net で Web スクレイピングプロジェクトを開始する前に、必ずサイトの robots.txt ファイルを確認する必要があります。
このファイルには、アクセスが禁止されているウェブサイトの領域と、データスクレイピングのためにアクセスが許可されている領域が明記されています。
このファイルの指示を無視すると、IPアドレスがブロックされるだけでなく、法的リスクにさらされる可能性もあります。
Media.netの利用規約(ToS)は、同プラットフォームの利用に関する規則、条件、およびガイドラインを定めた法的契約です。
サイトからデータをスクレイピングする前に、これらの規約を読み、理解しておくことが極めて重要です。
利用規約に違反すると、アカウントの一時停止から法的措置に至るまで、さまざまな結果を招く可能性があります。
利用規約の中で、データのスクレイピングやプラットフォームへの自動アクセスについて具体的に言及している箇所を確認してください。
利用規約でウェブスクレイピングが明示的に禁止されている場合は、作業を進めるためにMedia.netから書面による許可を得る必要があります。
法的考慮事項に加え、Media.netを含むあらゆるウェブサイトからデータをスクレイピングする際には、倫理的な行動が最優先されます。以下に、考慮すべき倫理的ガイドラインをいくつか示します。
ウェブスクレイピング活動によって、Media.netのサービスに過負荷がかかったり、サービスが妨げられたりしないようにしてください。
レート制限を設け、人間のブラウジング行動を模倣した頻度でリクエストを行ってください。
スクレイピングしたデータの利用目的について透明性を保ってください。データを公開したり、商用目的で使用したりする場合は、Media.netから許可を得てください。
ユーザー生成コンテンツをスクレイピングする場合は、プロジェクトに絶対に必要でない限り、個人情報を収集しないよう注意してください。
個人データを収集する場合は、匿名化を行い、安全に保管してください。
データまたはそこから導き出された知見を公開する場合は、データの出所としてMedia.netを適切に明記してください。
これらの法的および倫理的ガイドラインを順守することで、責任ある態度と敬意を持ってウェブスクレイピング活動を行うことができます。これにより、リスクを最小限に抑えるだけでなく、データ分析やビジネスインテリジェンスプロジェクトの完全性と信頼性の向上にも寄与します。
ウェブスクレイピングプロジェクトの成否は、多くの場合、採用するツールや技術にかかっています。
これらのツールや技術を活用することで、Media.netからデータを収集するための堅牢なウェブスクレイピングパイプラインを構築できます。
初心者でもエキスパートでも、これらのリソースを適切に組み合わせることで、ウェブスクレイピング作業の効率と効果を大幅に向上させることができます。
Pythonは、その使いやすさと豊富なライブラリにより、ウェブスクレイピングで広く使用されている汎用性の高い言語です。
Webスクレイピングスクリプトの迅速な開発とデプロイが可能であるため、初心者からプログラミング経験が豊富なエキスパートまで、あらゆるユーザーに最適です。
JavaScript、特にNode.jsは、Webスクレイピングに利用できるもう一つの強力な言語です。
コンテンツの読み込みに JavaScript を多用しているウェブサイトを扱う場合、DOM(Document Object Model)と直接やり取りできるため、特に有用です。
BeautifulSoupは、ウェブスクレイピングの初心者にとって最適なPythonライブラリです。
HTMLやXMLドキュメントのナビゲーションや操作を容易にし、データ抽出をシンプルに行えます。
Scrapyは、ウェブスクレイピングやクローリングのために設計された、より高度なPythonフレームワークです。
さまざまなデータ形式の処理やスクレイピングしたデータのエクスポートを標準でサポートしており、大規模なプロジェクトに適しています。
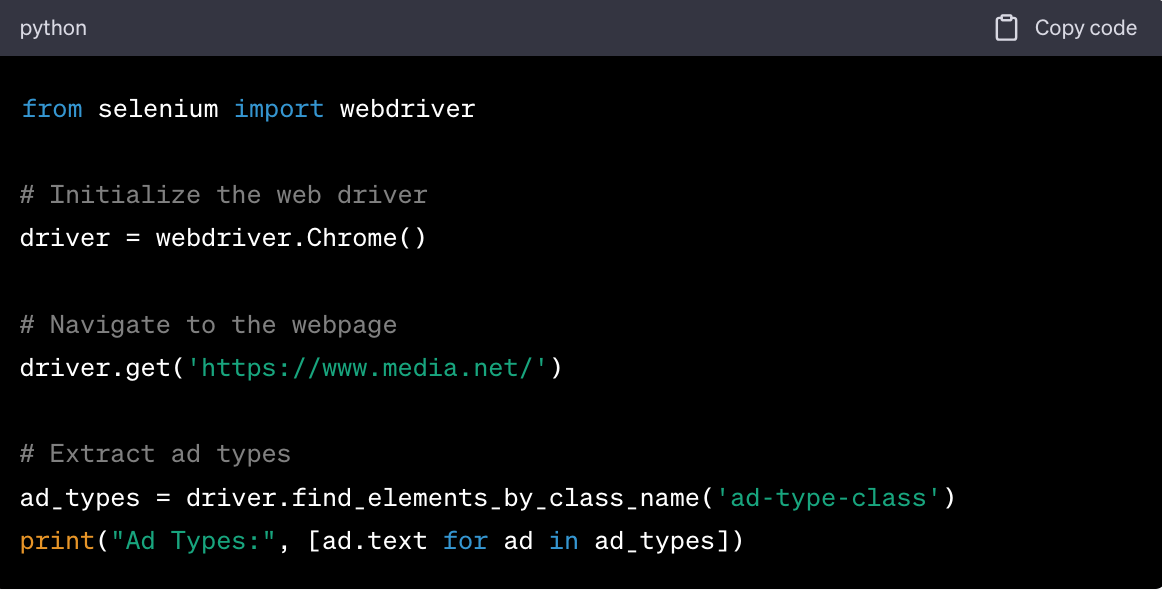
Seleniumは、JavaScriptを多用したウェブサイトのスクレイピングによく使用されます。ブラウザ操作を自動化することで、動的に読み込まれるデータのスクレイピングが可能になります。
大規模なスクレイピングにおいて、検出やIPブロッキングを回避するためには、プロキシの利用が不可欠です。また、プロキシを使用することで地域をターゲットにしたスクレイピングが可能になり、地域固有のデータを収集する際に不可欠となります。
Geonode のプロキシは、匿名性とセキュリティの層を提供するため、ウェブスクレイピングプロジェクトに最適です。
Media.net などのウェブサイトによって課される IP ブロックやレート制限を回避するのに役立ちます。
Geonodeプロキシの設定には、アカウントの作成と、それをコードに組み込む作業が含まれます。
ほとんどのプログラミング言語やスクレイピングライブラリでは、プロキシ設定を簡単に行う方法が用意されています。
たとえば、Pythonでは、Requestsライブラリを使用してGeonodeプロキシを簡単に組み込むことができます。
Web Scraperは、ポイント&クリック操作で簡単にウェブスクレイピングを行えるブラウザ拡張機能です。
小規模なプロジェクトや、ウェブスクレイピングが初めての方には最適です。
Data Minerは、あらかじめ用意されたデータスクレイピングの「レシピ」を提供するもう一つのブラウザ拡張機能です。
コードを一切書かずにウェブサイトからデータを抽出するのに役立ちますが、より複雑なスクレイピングのニーズには適さない場合があります。
実際のウェブスクレイピング作業に取り掛かる前に、適切な開発環境を整えておくことが重要です。
これには、プロジェクト全体を通じて使用される必須のソフトウェアやライブラリのインストールが含まれます。
Python をダウンロードします。 公式の Python ウェブサイト にアクセスし、お使いのオペレーティングシステムに適した最新バージョンをダウンロードしてください。
インストール。 インストーラーを実行し、画面の指示に従ってください。インストール中に、「Add Python to PATH」というチェックボックスに必ずチェックを入れてください。
インストールの確認。 コマンドプロンプトまたはターミナルを開き、python --version と入力して、Pythonが正しくインストールされたことを確認してください。
pipのインストール。 pip(Package Installer for Python)は通常、Pythonに同梱されています。
コマンドプロンプトまたはターミナルで pip --version と入力して、インストールされているか確認できます。
ターミナルを開き、以下の Python ライブラリをインストールしてください:
pip install beautifulsoup4pip install scrapypip install seleniumコードを記述する前に、少し時間をかけてMedia.netのウェブサイトを閲覧し、その構造を理解するとともに、スクレイピングしたいデータポイントを特定しておきましょう。
Media.net のウェブサイトは、コンテキスト広告およびプログラマティックソリューションのためのプラットフォームとして機能しています。広告主とパブリッシャーの双方に対応し、収益を最大化するためのさまざまなサービスを提供しています。このウェブサイトは、以下のようないくつかの主要セクションで構成されています。
また、このウェブサイトではディスプレイ広告やネイティブ広告に関する追加情報も提供されており、それらがパブリッシャーにどのようなメリットをもたらすかが説明されています。
Media.netからどの具体的なデータをスクレイピングしたいかを決定します。これには、提供されている広告の種類や価格モデルから、ブログ記事や記事内容まで多岐にわたります。これらのデータ項目をリストアップしておきましょう。これらがスクレイピングロジックの指針となります。
環境のセットアップが完了し、スクレイピングしたいデータポイントが特定できたら、次のステップはコードを記述することです。
ウェブスクレイピングは、手動で行うことも、自動化された方法で行うこともできます。以下では、両方のアプローチについて解説し、それぞれについてサンプルコードを掲載します。
手動によるスクレイピングでは、Webサイトを閲覧しながら、データを手作業でスプレッドシートや同様の保存媒体にコピーします。
この方法は単純明快ですが、時間がかかり、大規模なデータセットには現実的ではありません。
自動スクレイピングは、特に大規模なプロジェクトにおいて、データを収集する最も効率的な方法です。ここでは、BeautifulSoup、Scrapy、Selenium を使用してデータをスクレイピングする方法について見ていきます。
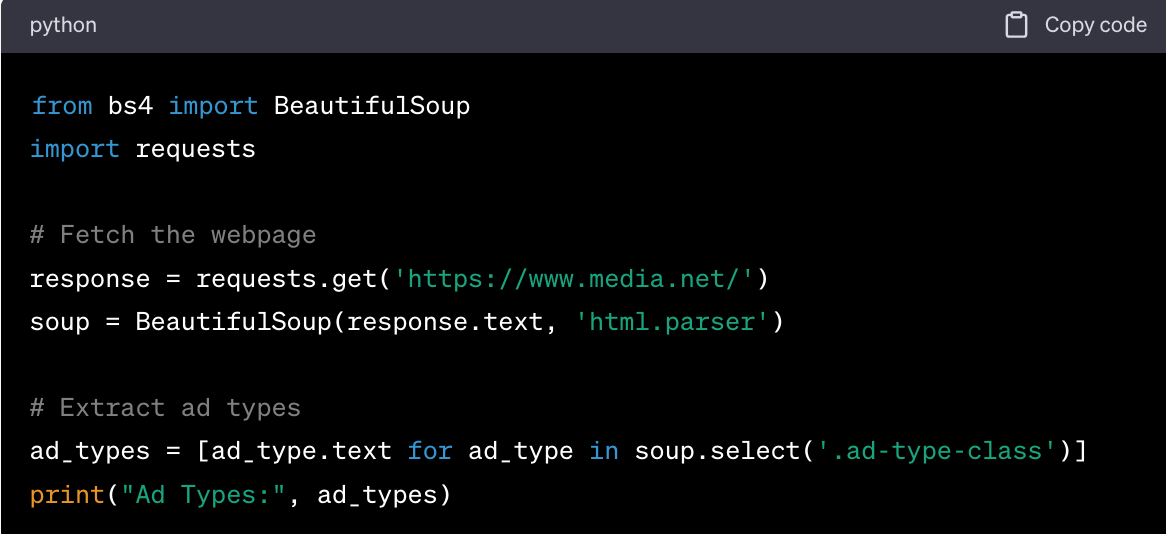
サンプルコードスニペット
コードの説明
requests.get()を使用してウェブページのコンテンツを取得します。.select()メソッドを使用して広告の種類を抽出します。サンプルコードスニペット
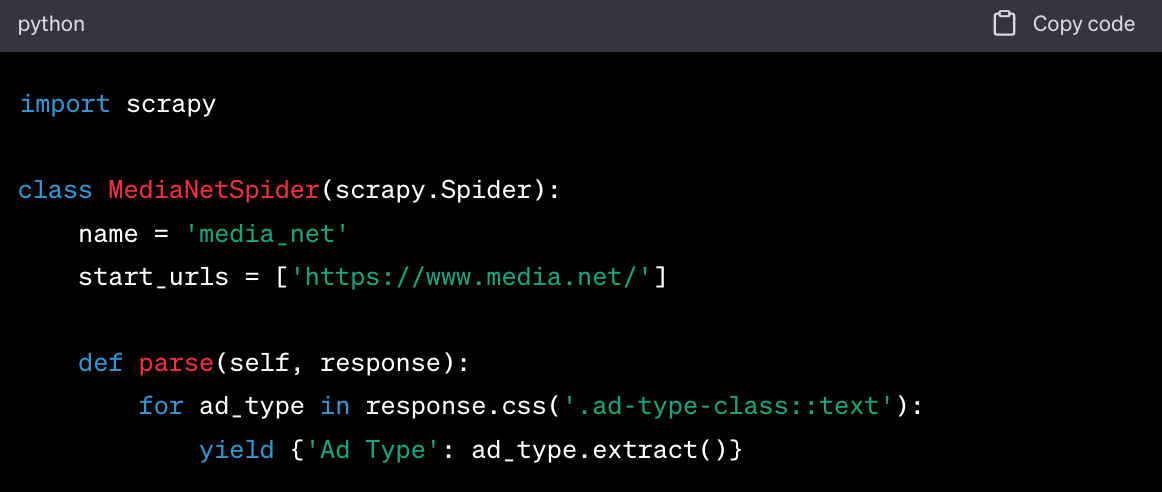
コードの説明
scrapy.Spiderを継承するスパイダークラスを定義します。start_urlsでスクレイピングするURLを指定します。.css()メソッドを使用して広告の種類を抽出するparseメソッドを定義します。サンプルコードスニペット
Pythonに組み込まれているcsvライブラリを使用して、スクレイピングしたデータをCSVファイルに保存できます。
より複雑なプロジェクトでは、MySQLやMongoDBなどのデータベースにデータを保存することをお勧めします。
これらの手順に従い、これらのコードスニペットを参考にすれば、Media.netからデータを収集するための堅牢なウェブスクレイピングパイプラインを構築できます。
自作のウェブスクレイパーを使用すると、収集するデータに対してより高度なカスタマイズと制御が可能になります。
プログラミングの知識があれば、Media.netのウェブサイト上の特定の要素を対象としたコードを記述でき、よりきめ細かなデータ収集が可能になります。
カスタムスクレイパーモデルは、汎用的なスクレイパーツールでは満たせないような特定のデータニーズを持つ方に最適です。
データ抽出サービスには、多くの場合、Webコンテンツの詳細なスクレイピング用に設計された、あらかじめ構築済みのスクレイパーAPIやツールが付属しています。
スクレイピングサービスを利用すれば、コードを1行も記述することなく、複雑なデータ抽出シナリオに対応できます。
これらは、プログラミングの知識がないものの、Media.netのようなプラットフォームから貴重なインサイトを得たいと考えている企業にとって特に有用です。
ウェブスクレイピングは強力なツールですが、それには特有の課題も伴います。
解決策: プロキシを使用することは、IPアドレスのブロックを回避する有効な手段です。
Geonodeでは、匿名でデータをスクレイピングできるさまざまなプロキシサービスを提供しており、これによりIPアドレスがブロックされるリスクを低減できます。
解決策: コードにレート制限を実装し、リクエストの頻度を制御してください。
また、Geonodeのプロキシを使用してIPをローテーションさせることで、レート制限に引っかかるのを防ぐことができます。
解決策: これは通常、ウェブサイトの構造が変更された際に発生します。
常に、最新のウェブサイトレイアウトに合わせてコードを更新するようにしてください。
解決策: コード内のタイムアウト制限を延長してください。
また、より安定した接続を確保するために、Geonodeのプロキシの利用も検討してください。
Geonodeのプロキシを使用すれば、ブロックされることなくMedia.netをスクレイピングできます。
これらのプロキシはIPアドレスを隠蔽するため、ウェブサイト側がスクレイピング活動を検知しにくくなります。
ウェブスクレイピングに関するポリシーを理解するには、常にMedia.netの利用規約を参照してください。 一般的に、ウェブサイトのrobots.txtで許可されており、利用規約に違反していない限り、スクレイピングは通常許容されます。
Scrapyのようなより効率的なライブラリを使用することで、スクレイピング処理を高速化できます。
さらに、Geonodeのプロキシを利用することで、より高速な接続が得られます。
BeautifulSoup、Scrapy、Seleniumは、ウェブスクレイピングで一般的に使用されるライブラリであり、それぞれ独自の利点があります。
Geonodeのプロキシは、IPローテーション、高速データセンタープロキシ、およびレジデンシャルプロキシを提供しており、ウェブスクレイピングに最適です。
これらはIPブロックやレート制限を回避するのに役立ち、ウェブスクレイピング作業の効率を高めます。
サーバーに過度な負荷をかけないよう、コードには常にレート制限を実装してください。これはマナーであるだけでなく、ブロックされるのを防ぐのにも役立ちます。
IPローテーションには、Geonodeのプロキシをご利用ください。これにより、異なるIPアドレスを通じてリクエストを行うことが可能になり、ブロックされる可能性を低減できます。
スクレイピングしたデータは、CSVやデータベースなどの構造化された形式で保存してください。特にデータを公開する予定がある場合は、必ずデータの利用規約を遵守してください。
データを研究やレポートに使用する場合は、必ずMedia.netをデータの出典として適切に明記してください。
これらのベストプラクティスとトラブルシューティングのヒントに従うことで、ウェブスクレイピングプロジェクトの効率を高め、よくある問題を未然に防ぐことができます。
ウェブスクレイピングは、Media.netからデータを収集するための非常に有用なツールであり、競合分析、市場調査、価格戦略など、さまざまなビジネス用途において極めて重要な洞察を提供してくれます。
本記事では、スクレイピング環境の構築、コードの作成、およびよくある問題のトラブルシューティングに必要な手順について解説してきました。
また、法的および倫理的なガイドラインを遵守することの重要性を強調するとともに、Geonodeのプロキシが匿名性を確保し、レート制限を回避することで、スクレイピング作業をどのように強化できるかについても特に言及しました。
データのスクレイピングが成功したら、次のステップはデータのクリーニングと分析です。データのクリーニングには、重複データの削除、欠損値の処理、データ型の変換などが含まれます。
クリーニングが完了したら、統計的手法を用いてデータを分析し、実用的な知見を導き出すことができます。
データから得られた知見は、ビジネスに戦略的に活用することができます。
価格モデルの調整であれ、新たな市場機会の特定であれ、収集したデータは意思決定のための貴重なリソースとなります。
ウェブスクレイピングは1回限りの作業ではありません。ウェブサイトはコンテンツや構造を定期的に更新するため、スクレイピングコードを常に最新の状態に保つことが不可欠です。
スクレイピングプロセスを監視することで、発生した問題を迅速に特定し、修正することができます。
この記事で説明したガイドラインとベストプラクティスに従うことで、ウェブスクレイピングの熟練者への第一歩を踏み出せます。Media.netから収集したデータは、責任を持って倫理的に利用すれば、競争上の優位性をもたらすでしょう。