
消費者の行動や市場動向の秘密を解き明かすのは、決して簡単なことではありません。しかし、今日人気のあるウェブサイトの1つに、発掘されるのを待っている膨大なデータが隠されているとしたらどうでしょうか?
この記事では、意外な情報源――ウォルマートのオンラインストア――から貴重な知見を引き出す方法をご紹介します。GeonodeのスクレイピングAPIを活用すれば、消費者の行動や市場動向に関する知見を得て、より的確なビジネス判断を下すことができます。

Maricor Bunal
更新日:2026年10月7日
公開日:2023年8月2日
GeonodeのスクレイピングAPIを使ってウォルマートのデータをスクレイピングし、消費者の行動や市場動向の秘密を解き明かしましょう。このガイドでは、その手順とメリットについて包括的に解説します。
消費者の行動や市場動向の秘密を解き明かすのは、決して簡単なことではありません。しかし、今日人気のあるウェブサイトの1つに、発掘されるのを待っている膨大なデータが隠されているとしたらどうでしょうか?
この記事では、意外な情報源――ウォルマートのオンラインストア――から貴重な知見を引き出す方法をご紹介します。GeonodeのスクレイピングAPIを活用すれば、消費者の行動や市場動向に関する知見を得て、より的確なビジネス判断を下すことができます。
ウェブスクレイピングは、ウェブハーベスティングやウェブデータ抽出とも呼ばれ、ウェブサイトからデータを収集するプロセスです。この手法を用いることで、商品の詳細、価格、レビューなど、多種多様なデータを収集することができます。
ウェブサイトのデータ量は膨大であり、特にそのデータが整理されていないため、その量は圧倒的です。ウェブスクレイピングを利用すれば、抽出したデータを構造化された形式に変換し、自分のニーズに合わせて活用することができます。
大手小売企業のひとつであるウォルマートは、ハイパーマーケット、ディスカウントデパート、食料品店のチェーンを展開しています。同社はオンライン上でも圧倒的な存在感を示しており、食料品、衣料品、家庭用品、家電製品など、数百万点に及ぶ商品を扱っています。そのため、ウォルマートはウェブスクレイピングにおいて極めて価値の高いデータソースとなっています。
ウォルマートのデータスクレイピングは、特に企業や研究者にとって、多岐にわたる目的に活用できます。以下に、ウォルマートからデータをスクレイピングする実用的な活用例をいくつか紹介します。
• 市場調査。ウォルマートの膨大な商品ラインナップは、数多くのカテゴリーにわたる市場の全体像を把握するのに役立ちます。 このデータをスクレイピングすることで、商品のトレンド、消費者の嗜好、価格戦略に関する洞察を得ることができます。
• 競合分析。ウォルマートからスクレイピングしたデータを活用すれば、どのような商品が、どの価格で、どのように販売されているかを把握できます。この情報は、自社の商品を競争力のある位置に置くのに役立ちます。
• 価格モニタリング。スクレイピングしたデータを活用して、ウォルマートの商品価格をリアルタイムで監視することで、自社の価格を適切に調整し、競争力を維持できます。
• 商品ラインナップの最適化。ウォルマートが提供する商品ラインナップを分析することで、消費者の需要により的確に応えるよう、自社の商品ラインナップを最適化できます。
• センチメント分析。ウォルマートのウェブサイト上のレビューや評価は、製品に対する消費者の感情に関する豊富な情報を提供します。このデータを活用して、製品の品質や顧客サービスの向上に役立てることができます。
ウォルマートは、他の多くのウェブサイトと同様、ウェブスクレイピング活動を阻止または抑制するための対策を講じていることを覚えておくことが重要です。これらの措置は、データを保護し、大量のボットトラフィックによってサイトのパフォーマンスが低下しないようにするとともに、法的規制やプライバシー規制を遵守するために設けられています。
したがって、ブロックや利用停止を避けるためには、倫理的なスクレイピング手法を採用し、ウォルマートの利用規約を遵守するとともに、GeonodeのスクレイピングAPIのような効率的で適切なスクレイピングツールを使用することが極めて重要です。
」でウォルマートのデータを簡単にスクレイピング
Geonode のスクレイピングAPIは、ウェブスクレイピング作業を簡素化するために設計された、強力かつ使いやすいツールです。さまざまな主要機能を備えており、ユーザーは複雑なコードを記述することなく、ウォルマートなどのウェブサイトから大量のデータを効率的に抽出することができます。
その際立った機能には、次のようなものがあります。
• デバッグモード。JSONレスポンス形式で詳細な情報を提供し、ウェブサイトがスクレイピングリクエストをどのように処理しているかをユーザーが理解するのに役立ち、時間とリソースを節約します。
• JavaScriptレンダリング。 動的な要素のキャプチャにより、シングルページアプリケーション(SPA)のスクレイピングを容易にし、包括的なデータ抽出を保証します。
• カスタムJSスニペットの実行。開発者がフォーム、ボタン、その他のJavaScriptで生成された要素とやり取りできるようにし、スクレイピングプロセスをより細かく制御できます。
• プロキシのローテーション。 大規模なプロキシプールを活用し、IPブロックを回避するとともに、地域制限をバイパスすることで、データ取得の信頼性を高めます。
• ジオターゲティング。スクレイパーとして検出されることなく、より多くのウェブサイトへのアクセスを確保します。
• スクリーンショットAPI。 テスト、トラブルシューティング、およびドキュメント作成の目的で、ウェブページのスクリーンショットを簡単に取得できます。
• GB単位の料金体系。費用対効果の高い料金体系を提供し、スクレイパーの費用管理を可能にします。
• レスポンス形式。統合アプリケーションでの利用に際し、HTML形式またはJSON形式から柔軟に選択できます。
• HTTPレスポンスからのデータ収集。JSONレスポンスなどの特定のデータを簡単に収集し、必要な情報を抽出できます。
• スクレイピングモード。さまざまなスクレイピングニーズに合わせて、最適なパフォーマンスと効率を実現する多彩なスクレイピングモードを提供します。
ウォルマートは世界最大級の小売企業の一つであり、そのウェブサイトは、数十億もの商品ページを擁し、よく構造化され整理されたレイアウトを備えた大規模なECプラットフォームです。効率的かつ効果的なウェブスクレイピングを行うためには、その構造を理解することが不可欠です。 以下に、ウォルマートのウェブサイトにおけるデータの構成に関する基本的な概要を示します。
• トップページ。トップページには、ウォルマートが提供する商品の全体像が示されています。さまざまなカテゴリーの商品やプロモーション情報などが掲載されています。
• カテゴリページ。トップページやナビゲーションメニューからカテゴリをクリックすると、カテゴリページに移動します。これらのページには、「家電」、「衣料品」、「家庭用品」など、特定のカテゴリに属する商品が一覧表示されます。各カテゴリページには、より具体的な商品タイプごとに複数のサブカテゴリが設けられています。
• 商品一覧。各カテゴリページやサブカテゴリページには、商品のリストが表示されます。各商品リストには、商品名、価格、画像、顧客評価などの基本情報が含まれています。
• 商品一覧ページ。一覧から商品をクリックすると、その商品の詳細ページに移動します。これらのページには、より詳細な説明、商品の属性、追加画像、顧客レビュー、そして多くの場合、関連商品のリストなど、商品に関する詳細情報が掲載されています。
• 検索機能。ウェブサイトには、ユーザーが特定の商品を検索できる検索バーも備わっています。検索結果は、カテゴリページの商品一覧と同様の形式で表示されます。
ウォルマートのウェブサイトをスクレイピングする際は、データが主にこれらの領域にあることに留意することが重要です。 特に商品ページは、最も詳細な情報が含まれているため、最も価値が高いと考えられます。
ただし、ウォルマートのウェブサイトは動的な構造をしており、初期のHTMLページが読み込まれた後にJavaScriptを使用して一部のコンテンツが読み込まれるため、スクレイピングが難しくなる場合があります。幸いなことに、GeonodeのスクレイピングAPIはJavaScriptによるレンダリングに対応しており、この問題を回避できます。
ウォルマートのようなECサイトをスクレイピングする場合、抽出したい主要なデータポイントはプロジェクトの具体的な要件によって異なります。以下に、一般的に価値のあるデータポイントをいくつか挙げます:
• 商品名。 商品名は、最も基本的でありながら極めて重要な情報の一つです。これにより、ウェブサイトに掲載されているさまざまな商品を特定することができます。
• 価格。商品の価格は、もう一つの重要なデータポイントです。競合他社の価格情報は、価格比較、経時的な価格変動の追跡、あるいは価格動向の把握に活用できます。
• 画像。画像は商品を視覚的に表現するものです。画像認識タスクや、商品カタログでの視覚的表現など、さまざまな目的に役立ちます。
• 商品説明。商品説明には、機能、仕様、その他の関連情報を含む、商品に関する詳細情報が記載されています。
• 商品レビューと評価。レビューや評価は、顧客満足度や商品の品質に関する洞察を与えてくれます。これらは、感情分析や、商品に対する世論の把握に活用できます。
• 商品カテゴリ。商品のカテゴリやサブカテゴリは、その商品がどのような種類のものであるか、またより広範な商品ラインナップの中でどのような位置づけにあるかについての文脈を提供します。
• 商品SKUまたはID。SKUまたはIDは、各商品に割り当てられた一意の識別子です。特定の商品を追跡する際に役立ちます。
• 在庫状況。商品が在庫あり、在庫切れ、または予約注文可能であるかという情報は、サプライチェーン分析や市場調査において有用です。
• 配送情報。配送オプションや送料の詳細は、商品の総コストを把握する上で重要です。
• 販売者情報。商品がサードパーティの販売者によって販売されている場合、販売者に関する情報が重要になることがあります。
GeonodeのスクレイピングAPIの環境を設定するための手順を以下に示します:
1. Geonodeでアカウントを作成する。 まず最初に、Geonodeのウェブサイトでアカウントを作成します。これにより、同社のAPIやその他のサービスを利用できるようになります。
2. APIキーを取得する。アカウントを作成してログインすると、アカウント設定またはダッシュボードでAPIキーを確認できます。このキーは、APIへのリクエストを認証するために使用されます。
3. 必要なライブラリをインストールする。使用しているプログラミング言語によっては、HTTPリクエストを送信したりレスポンスを処理したりするために、特定のライブラリをインストールする必要がある場合があります。
• HTTPクライアントライブラリ:GeonodeのAPIにリクエストを送信し、レスポンスを受信するには、HTTPクライアントライブラリが必要です。 使用する具体的なライブラリは、プログラミング言語によって異なります。たとえば、Python を使用している場合は Requests ライブラリを使用できます。JavaScript を使用している場合は、Axios や Fetch を使用できます。
• JSON パースライブラリ:GeonodeのAPIは通常、JSON形式でデータを返すため、このデータをパースするためのライブラリが必要です。最近のプログラミング言語のほとんどは、JSONパース機能を標準で備えています。たとえば、Pythonではjsonモジュールを、JavaScriptではJSON.parse()を使用できます。
• 開発環境:コードを記述・実行するには、開発環境が必要です。Sublime Text や Atom などのテキストエディタ、あるいは PyCharm や Visual Studio Code などの統合開発環境(IDE)が利用できます。
4. 開発環境のセットアップ。API へのリクエスト送信やレスポンスの処理ができるよう、開発環境が適切にセットアップされていることを確認してください。これには、お好みの統合開発環境(IDE)やテキストエディタで新しいプロジェクトを作成することが含まれる場合があります。
5. APIのテスト。ウェブスクレイパーの構築を始める前に、APIをテストしてすべてが正しく動作していることを確認することをお勧めします。これを行うには、APIに簡単なGETリクエストを送信し、レスポンスを確認します。
6. APIドキュメントを読む:GeonodeのAPIドキュメントには、利用可能なエンドポイント、リクエストパラメータ、レスポンス形式など、APIの使用方法に関する詳細な情報が記載されています。このドキュメントを読むことで、APIを効果的に活用する方法を理解するのに役立ちます。
GeonodeのスクレイピングAPIを使用してウォルマートの商品ページを取得するには、スクレイピングしたい商品ページのURLを指定して、APIにHTTP GETリクエストを送信します。一般的な手順は以下の通りです。
1. 商品ページのURLを特定する。スクレイピングしたいウォルマートの商品ページのURLを特定します。 これを行うには、ウェブブラウザで商品ページにアクセスし、アドレスバーからURLをコピーします。
2. APIリクエストを準備する。APIエンドポイントURLを構築します。これには、GeonodeのAPIのベースURL、ウェブページを取得するためのエンドポイント、および必要なパラメータが含まれます。 パラメータの一つには、スクレイピングしたいウォルマートの商品ページのURLを指定します。
3. APIリクエストの送信。HTTPクライアントライブラリを使用してAPIリクエストを送信します。これには、ライブラリが提供する関数またはメソッドを呼び出し、APIエンドポイントURLを渡して、メソッドをGETに設定することが含まれます。
4. APIレスポンスの処理。APIリクエストを送信すると、APIからレスポンスが返されます。このレスポンスには、通常HTML形式で、ウォルマートの商品ページからのデータが含まれています。コード内でこのレスポンスを処理する必要があり、その際にはHTMLを解析して、必要なデータを抽出する処理が必要になる場合があります。
以下に、PythonのRequestsライブラリを使用してこれを行う例を示します:
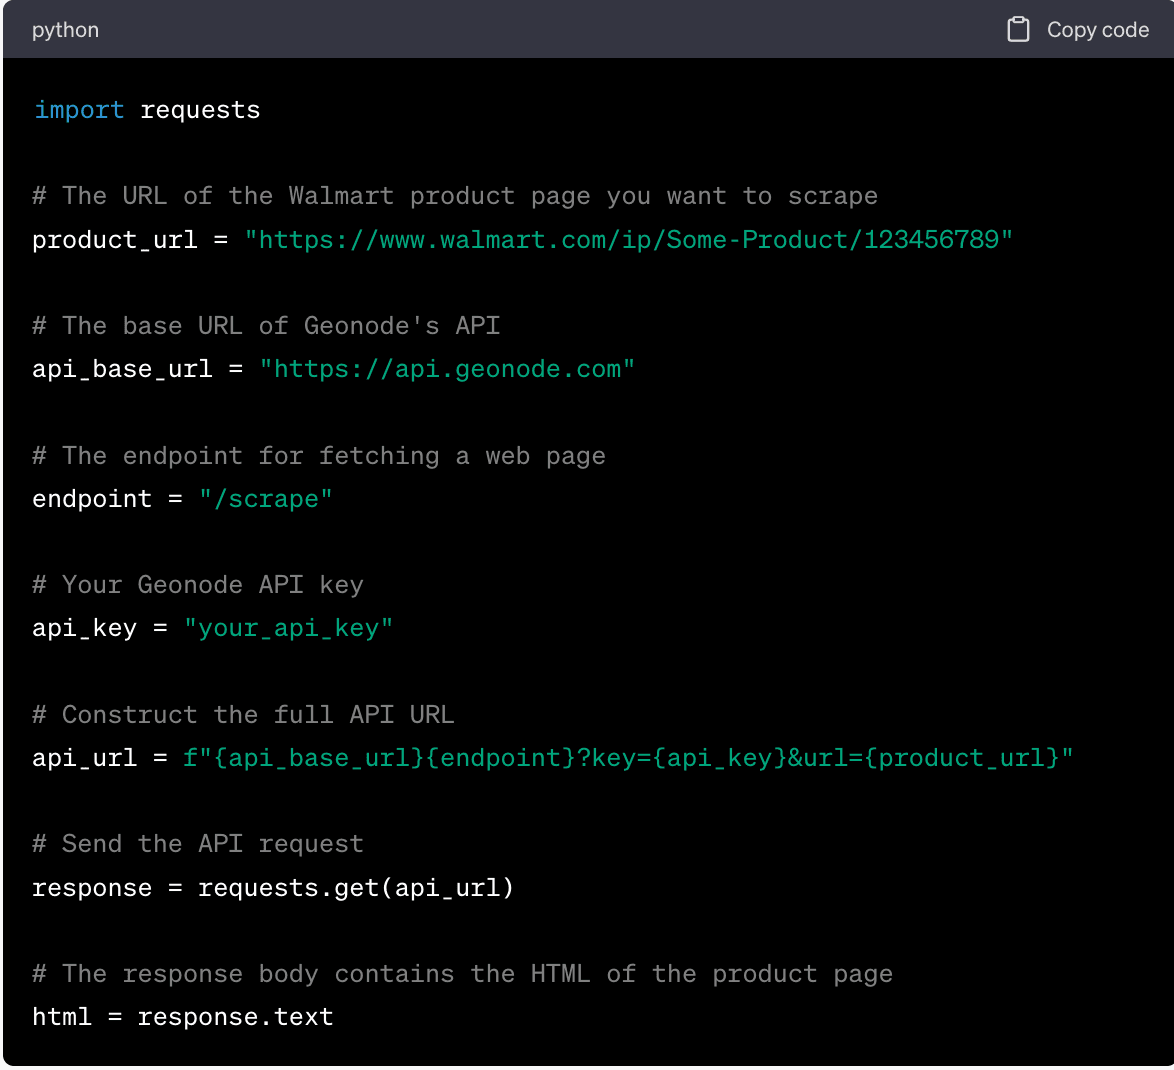
GeonodeのスクレイピングAPIを使用してウォルマートの商品ページを取得したら、次のステップはページから重要なデータポイントを抽出することです。これには通常、ページのHTMLを解析し、目的のデータを含む要素を選択する作業が含まれます。
その一般的な手順は以下の通りです:
1. HTMLの解析。最初のステップは、ページのHTMLを解析することです。これには、HTML文字列を、ナビゲートや検索が可能な構造に変換することが含まれます。具体的な方法は、使用しているプログラミング言語やライブラリによって異なります。 たとえば、Python では、BeautifulSoup ライブラリを使用して HTML を解析することができます。
2. データポイントの特定。次に、関心のあるデータポイントを含む HTML 要素を特定する必要があります。 これには通常、ページのHTMLを調査し、これらの要素のタグ、クラス、またはIDを見つける作業が含まれます。この作業は、Webブラウザのデベロッパーツールを使用して行うことができます。
3. 要素の選択。要素を特定したら、解析済みのHTMLからそれらを選択します。 これには通常、HTML解析ライブラリが提供する関数やメソッドを呼び出し、要素のタグ、クラス、またはIDを引数として渡します。これにより、要素とその内容が返されます。
4. データの抽出。要素を選択したら、そこからデータを抽出できます。 これには通常、HTML解析ライブラリが提供する関数やメソッドを呼び出し、要素を引数として渡します。これにより、要素に含まれるデータが返されます。
以下は、BeautifulSoupライブラリを使用してPythonでHTMLを解析する方法の例です:
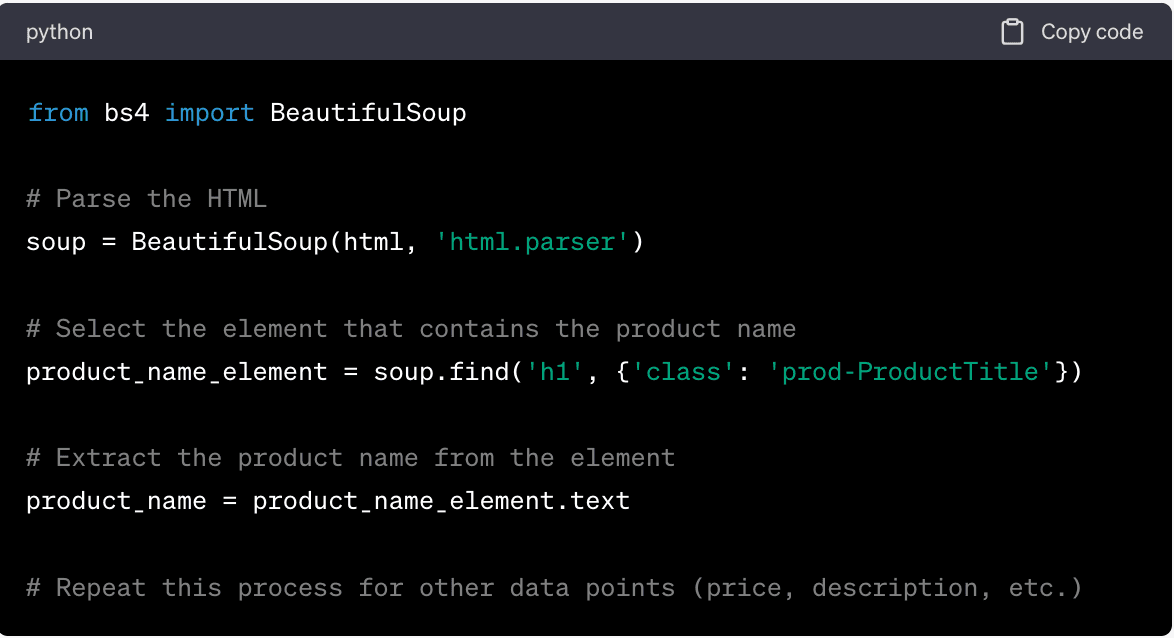
(これは基本的な例であり、実際の実装は、ウォルマートの商品ページの具体的な構造や、使用しているHTML解析ライブラリの機能・性能によって異なる場合があります。最も正確で最新の情報については、必ず使用しているライブラリの公式ドキュメントを参照してください。)
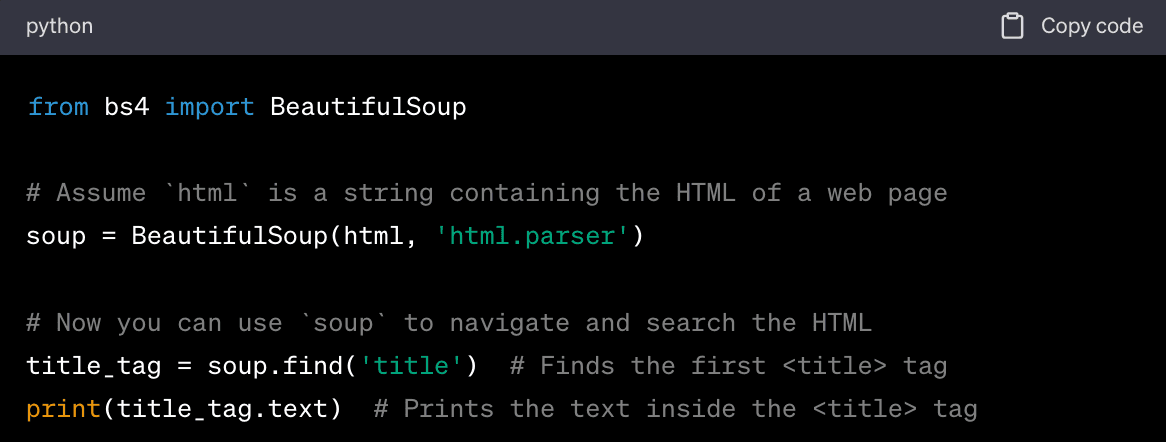
HTMLおよびJSONデータの解析は、ウェブスクレイピングにおいて一般的な作業です。解析とは、生データ(この場合はHTMLやJSONテキスト)を取り込み、プログラミング言語で扱いやすい形式に変換するプロセスのことです。
HTMLの解析
HTMLは、ウェブページを作成するための標準的なマークアップ言語です。タグを使用してさまざまな種類のコンテンツを区別するため、特定のデータを比較的容易に検索・抽出することができます。
以下は、BeautifulSoupライブラリを使用してPythonでHTMLを解析する例です:
JSONの解析
JSON(JavaScript Object Notation)は、人間が読み書きしやすく、機械が解析・生成しやすい軽量なデータ交換フォーマットです。APIによるデータ送信によく使用されます。
以下は、PythonでJSONを解析する方法の例です:
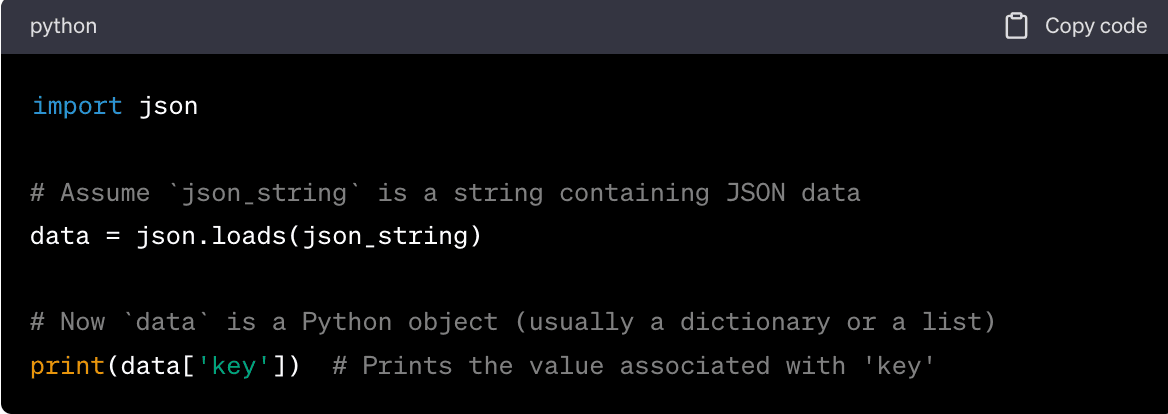
どちらの場合も、解析の目的は、生のHTMLやJSONデータを、プログラミング言語で扱いやすい形式に変換することです。データが解析されれば、その中を探索して、関心のある特定のデータを見つけることができます。
ウォルマートのような大規模なECプラットフォームからデータをスクレイピングする際、大量のデータを効率的に管理することは極めて重要です。ここでは、大規模なデータセットを扱うためのヒントをいくつか紹介します。
• データベースを活用する。 データをデータベースに保存することで、特に大量のデータを扱う場合、管理が容易になります。データベースは大量のデータセットを処理するように設計されており、インデックス作成などの機能により、データへのクエリ処理を高速化できます。
• バッチ処理。スクレイピングしたデータポイントを1つずつ処理するのではなく、データをバッチごとにまとめて、各バッチをまとめて処理することを検討してください。これにより効率が向上し、システムへの負荷を軽減できます。
• データ圧縮。保存容量が懸念される場合は、データの圧縮を検討してください。 CSVやJSONなど、一般的なデータ形式の多くは、元のサイズのわずか数分の1にまで圧縮可能です。
• 並列処理。複数のページやウェブサイトを同時にスクレイピングする場合は、処理を高速化するために並列処理の利用を検討してください。これは複数のスクレイピングタスクを同時に実行するもので、スクレイピングの総時間を大幅に短縮できます。
• 増分スクレイピング。すべてのデータを一度にスクレイピングするのではなく、増分的にスクレイピングすることを検討してください。これは、すでにスクレイピング済みのデータを追跡し、新規または更新されたデータのみをスクレイピングする手法です。これにより効率が向上し、システムとスクレイピング対象のウェブサイトの双方への負荷を軽減できます。
• クラウドベースのソリューションの活用。クラウドベースのソリューションは、スケーラブルなストレージと処理能力を提供するため、大量のデータを扱う際に特に役立ちます。Amazon Web Services(AWS)、Google Cloud、Microsoft Azure などのサービスは、大規模なデータセットを処理できるさまざまなデータストレージおよび処理ソリューションを提供しています。
• データのクリーニングと検証。データパイプラインのできるだけ早い段階で、データのクリーニングと検証を行ってください。これには、重複データの削除、欠損値の処理、データの一貫性チェックなどが含まれます。早い段階でデータのクリーニングと検証を行うことで、後々のエラーや非効率性を防ぐことができます。
重要なのは、効率的でスケーラブルであり、かつ特定のニーズに適した方法でデータを管理することです。最適なアプローチは、データセットの規模、利用可能なリソース、およびプロジェクトの具体的な要件によって異なります。
ウェブスクレイピングはウェブサイトからデータを抽出するための強力なツールですが、ウォルマートはこの行為を快く思っていません。
ここでは、スクレイピング中にアクセスブロックされる一般的な理由と、それを回避するためのヒントを紹介します:
• リクエストが多すぎる。 短期間に過度のリクエストを送信すると、ウォルマートのサーバーに過負荷がかかり、ウェブサイトのパフォーマンスに悪影響を及ぼす可能性があります。これはしばしば不正利用の一形態と見なされ、アクセス制限を受ける一般的な理由となっています。これを避けるには、リクエストの頻度を制限し、リクエストの間に遅延を設けてください。
• robots.txt を無視する。robots.txt ファイルは、ウェブサイトがウェブクローラーやスクレイパーと通信するための手段です。このファイルには、ウェブサイトのどの部分をスクレイピングしてはいけないかが指定されています。このファイルのルールを無視すると、スクレイパーがブロックされる原因となります。 スクレイピングを行う際は、必ず対象ウェブサイトのrobots.txtファイルを確認し、そのルールを遵守してください。
• IPアドレスのローテーションを行わない。すべてのリクエストが同じIPアドレスから送信されている場合、そのウェブサイトからデータをスクレイピングしていることが明らかになります。ウォルマートでは、リクエスト数が多すぎるとIPアドレスをブロックします。 これを回避するには、ローテーションする住宅用プロキシのプールを使用して、リクエストを複数のIPアドレスに分散させることを検討してください。
• User-Agent文字列を使用しない、または不審なものを使用すること。User-Agent文字列は、どの種類のデバイスやブラウザがリクエストを行っているかをウェブサイトに伝えます。ウォルマートなどのウェブサイトは、User-Agent文字列が含まれていないリクエストや、スクレイパーに関連していると知られるUser-Agent文字列を使用しているリクエストをブロックします。 実際のブラウザを模倣した、正当な User-Agent 文字列を使用してください。
• 保護されたデータのスクレイピング。ウェブサイト上のデータの中には、著作権やその他の法的保護の対象となっているものがあります。こうしたデータをスクレイピングすると、アクセスがブロックされるだけでなく、法的措置の対象となる可能性もあります。 対象とするデータをスクレイピングし、使用する権利を常に確認してください。
もちろん、アクセスをブロックされないようにする最善の方法は、責任を持ってスクレイピングを行うことです。ウェブサイトのルールを遵守し、サーバーに過度な負荷をかけず、対象とするデータをスクレイピングし、使用する権利を常に確認してください。
ウェブスクレイピングは、ウォルマートなどのウェブサイトから膨大なデータを抽出できる強力なツールであり、消費者の行動、市場の動向、競合状況に関する貴重な知見を提供してくれます。ただし、ウェブスクレイピングを行う際には、対象となるウェブサイトとその利用規約を尊重することが極めて重要です。
ウェブスクレイピングの目的は、常に責任を持って倫理的にデータを収集することにあることを忘れないでください。ガイドラインに従い、GeonodeのスクレイピングAPIなどのツールを活用することで、責任ある倫理的なスクレイピングを実践しつつ、ビジネス上の意思決定を後押しする貴重な知見を得ることができます。
デジタル時代が進むにつれ、ウェブデータを活用し解釈する能力は、今後も重要なスキルであり続けるでしょう。このガイドが、ウォルマートのウェブスクレイピング活動を行う上での確かな基礎となることを願っています。