何千ものパズルのピースが詰め込まれた巨大な箱を手渡されたと想像してみてください。それが、このデジタル時代において私たちが収集するデータなのです。その量は膨大で、圧倒的であり、一見しただけではあまり意味がわからないかもしれません。
そこで登場するのが「データ解析」です。これを、数え切れないほどのパズルのピースをすべて仕分けし、絵が意味を成すようにグループ分けしてくれる「パズルの達人」だと考えてみてください。
データ解析は、その混乱した情報の寄せ集めを、調査や分析に活用できるビジネス向けのデータへと変えます。 それはまるで、演劇の舞台裏のスタッフのようなものです。目には見えないことが多いですが、ショーを成立させるために不可欠な存在です。
この記事では、データ解析がいかに脚光を浴び、生データの混沌を、洞察に満ちた発見に満ちたストーリーへと変容させるかを紹介していきます。
データパーシングの理解
データパーシングは、データ分析の分野において重要な要素です。これは、膨大な量の生データを、読みやすく理解しやすいように整理されたデータ形式に変換するものです。
毎秒膨大な量のデータが生成される現代において、この変換は極めて重要です。
データを解析することで、機械と人間の双方が理解できる形で情報を構造化することができます。その結果、データ処理や分析が円滑に行われ、貴重な知見が得られます。
データパーシングの意義は、非構造化データを、読み取り可能なデータ形式に変換できる点にあります。
ビジネス分析、ソフトウェア開発、研究のいずれにおいても、パーシングされたデータは明確さを提供し、情報に基づいた意思決定を支援します。
データ解析の実用例
-
ウェブスクレイピング。 開発者がウェブサイトから情報を抽出する場合、データは多くの場合HTML形式で提供されます。
データ解析により、このHTMLデータはJSONやXMLといった構造化された形式に変換され、分析や保存が容易になります。
-
ログ分析。 システム管理者は、特定の情報を抽出するためにログファイルを解析することがよくあります。
たとえば、サーバーがクラッシュした場合、ログを解析することで、クラッシュの正確な時刻や、それに至るまでの経緯を特定するのに役立ちます。
-
Eコマースプラットフォーム。 オンラインショッピングサイトで商品を検索すると、プラットフォームは検索クエリを解析して、最も関連性の高い商品を表示します。
これには、ユーザーの入力内容を分解し、商品データと照合する処理が含まれます。
-
天気アプリ。 天気アプリは、気象情報源からのデータを解析し、気温、湿度、予報などを表示する、ユーザーフレンドリーな形式で提供します。
-
金融取引。 銀行アプリは取引データを解析し、口座の取引履歴を整理された形で表示します。購入、入金、その他の取引を分類することで、追跡を容易にします。
これらの例はいずれも、データが意味のある整理された形で提示されるよう、データ解析が極めて重要な役割を果たしています。
データ解析は、効率的なデータ分析を可能にするだけでなく、ユーザー体験の向上にも寄与します。
データ解析の仕組み
乱雑なデータを明確な情報に変えるには、特定の手順が必要です。
これらの手順、すなわち「仕組み」は、データを理解しやすい形に分解し、整理するのに役立ちます。
データ解析プロセスで使用される主な分析の種類を見ていきましょう:
字句解析
字句解析は、データ解析の基礎となるものです。
このプロセスでは、生データをスキャンして、個々の要素(トークンや個々の語彙単位と呼ばれることが多い)を識別し、分類します。
これは、文を単語に分解する作業だと考えてください。各単語、つまりトークンには、それぞれ特定の役割があります。
データ解析において、字句解析は生データからこれらのトークンを特定し、その後の解析段階で正しく処理されるようにします。
次のような生データの文字列があると仮定しましょう:
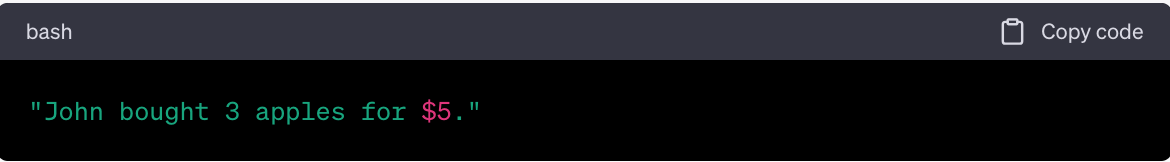
語彙解析の分解
語彙解析の段階では、この文字列がスキャンされ、個々のトークンに分解されます。そのプロセスは次のようなものになります:
- "John" - 固有名詞(この場合は名前)として識別されます。
- "bought" - 動詞として識別される。
- "3" - 数値として識別される。
- "apples" - 名詞として識別される。
- "for" - 前置詞として識別される。
- "$" - 通貨記号として識別されます。
- "5" - 数値として識別されます。
これらのトークンはそれぞれ、その型とデータ文字列内での役割に基づいて分類されます。
語彙解析のプロセスでは、これらのトークン間の関係や文字列全体の意味については考慮されません。
その代わりに、次の解析段階でデータを活用できるよう、各データを認識・分類することにのみ焦点を当てています。
構文解析
データがトークンに分解されると、構文解析が行われます。
この段階では、意味のある文を構成するために単語を並べるのと同様に、これらのトークンを一貫性のある構造を形成するように配置します。
この構造を構築することで、構文解析は、機械と人間の双方が解釈できる形でデータが整理されることを保証します。
先ほど使用したデータ文字列を覚えていますか?!
語彙解析では、これをトークンに分解します: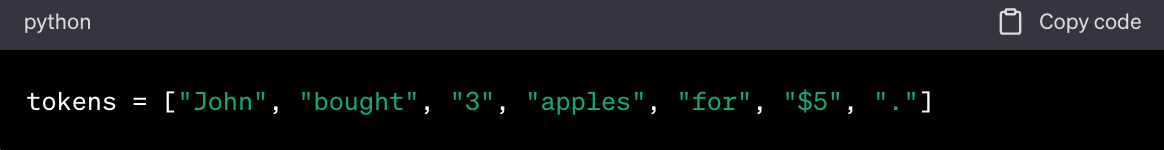
構文解析の図解
これらのトークンを用いて、構文解析はそれらを意味のある順序に構造化し、ツリー構造として表現します: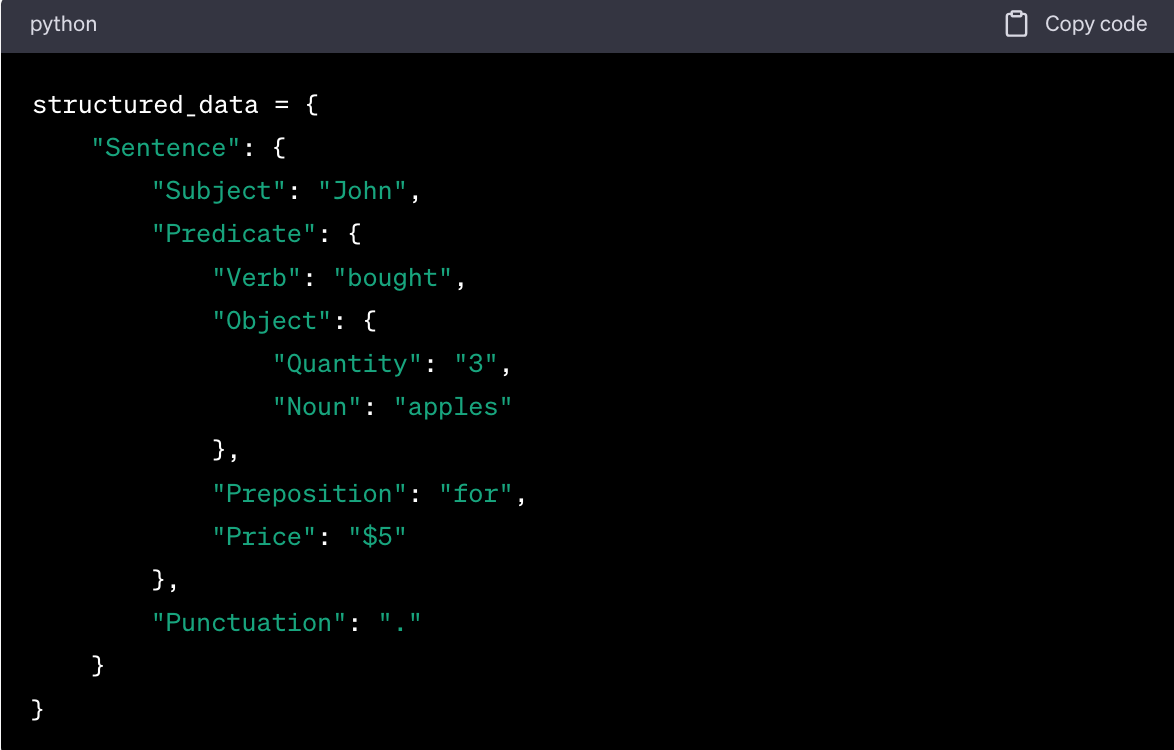
この構文解析ツリー構造では:
- 「John」は文の主語として識別されます。
- 「bought」は主動詞、つまり動作を表します。
- 「3 apples」は目的語であり、さらに数量(「3」)と名詞(「apples」)に分解されます。
- 「for」は前置詞句を示しています。
- 「$5」は、その動作に関連する価格または費用を表しています。
- 「.」は、文の終わりを示す句読点です。
構文解析を通じて導き出されたこの構造化された表現は、トークン間の明確な階層関係と関連性を示し、元のデータ文字列の意味をより深く理解することを可能にします。
意味解析
次のステップは意味解析です。
このステップでは、構造化されたデータの背後にある意味を理解することに重点が置かれます。
これにより、異なるデータ要素間の関係が明確になり、データ全体として意味をなすことが保証されます。
意味解析の具体例
構文解析を経て、データの構造化された表現が得られます。
ここで、意味解析によってこの構造の背後にある意味が解釈されます。
出力:
この意味解析では、構造化データを解釈して意味のある情報を抽出します。
購入者の名前、実行されたアクション、購入された商品、商品の数量、および合計金額は、すべて構造化データから導き出されます。
この解釈により、元のデータ文字列に記述された事象を明確に理解することができます。
データ解析の種類
データ解析に取り組む際には、データ解析の2つの主な種類、すなわち「文法駆動型データ解析」と「データ駆動型データ解析」を理解することが重要です。
これらの方法にはそれぞれ独自の利点と、適切な使用場面があります。
これらを理解することで、特定のニーズに合った適切な方法を選択するのに役立ちます。
文法駆動型データ解析
文法駆動型解析は、その名前が示す通り、あらかじめ定義された文法規則に基づいてデータを構造化します。
この手法は綿密かつ正確であり、解析されたデータが設定されたガイドラインに厳密に従うことを保証します。
例えば、プログラミング言語では、コードを解釈するために文法駆動型のパーサーがよく使用され、開発者がその言語の構文や形式的な文法規則に従うことを確実にしています。
このアプローチは高い精度を誇りますが、見慣れないデータパターンや不規則なデータパターンに遭遇した場合、柔軟性に欠ける可能性があります。
具体例:
特定のレゴの組み立て説明書に従っておもちゃのお城を作っていると想像してみてください。
説明書の各ステップには、どのパーツを使い、どこに配置すべきかが正確に記されています。
説明書を正確に守れば、完璧な城が出来上がります。
しかし、説明書に記載されていないパーツを使ったり、指定されていない場所に置いたりしようとすると、城は正しく組み立てられません。
この例えにおいて、レゴの組み立て説明書は文法規則を表しており、城を組み立てるプロセスは文法駆動型構文解析に似ています。
レゴの城が特定の場所に特定のブロックを必要とするのと同様に、文法駆動型構文解析では、データがあらかじめ定義されたルールに正確に適合することが求められます。
データが適合しない場合、間違ったレゴのブロックと同じように、構文解析プロセスは正しく進行できません。
データ駆動型データ解析
一方、データ駆動型解析では、統計的手法を用いてデータを解釈します。
固定されたルールだけに依存するのではなく、大規模なデータセットに見られるパターンを活用して、新しいデータの構造について合理的な推測を行います。
このアプローチは、自然言語処理のタスクを扱う場合や、データソースが多様で予測不可能な場合に特に有用です。
膨大な量のデータを活用することで、この手法は状況に適応し、より広範な範囲をカバーできるため、多様なデータ入力の処理においてより汎用性が高くなります。
例を挙げて説明すると:
レゴの例えを続けると、特定の組み立て説明書のない、さまざまなパーツが混在したレゴの箱があると想像してください。
セットの組み立てガイドの代わりに、あなたはこれまで、多くの人が似たようなレゴセットを使って様々な構造物を組み立てている様子を観察してきました。
これらの観察に基づいて、壁や塔、橋など、人々がよく作る共通のパターンや構造を認識し始めます。
そのバラエティボックスから何かを作ることを決めたとき、あなたはこれらの観察されたパターンに頼ることになります。
過去の作品で、特定の種類のパーツが窓やドアとして頻繁に使われているのを見かけたら、あなたも同じように使うことを決めるかもしれません。
単一の組み立て説明書を厳密に守るのではなく、これまでの数多くの組み立て経験から得た知識を、組み立ての指針として活用しているのです。
このシナリオにおいて、観察されたパターンに基づいて組み立てるプロセスは、データ駆動型解析に似ています。
過去のレゴの組み立て例を組み立ての指針とするのと同様に、データ駆動型パーシングでは、既存のデータセットに含まれるパターンを用いて、新しいデータを解釈し、構造化します。
これは柔軟で適応性が高く、固定されたマニュアルなしにレゴで遊ぶのと同じように、創造性やバリエーションを可能にします。
データ解析とデータスクレイピング
「データ解析」と「データスクレイピング」は、しばしば同じ意味で使用されることがありますが、これらは異なるデータ分析プロセスです。
両者の違いや、それぞれが持つ重要性を理解することは、データを扱うすべての人にとって極めて重要です。
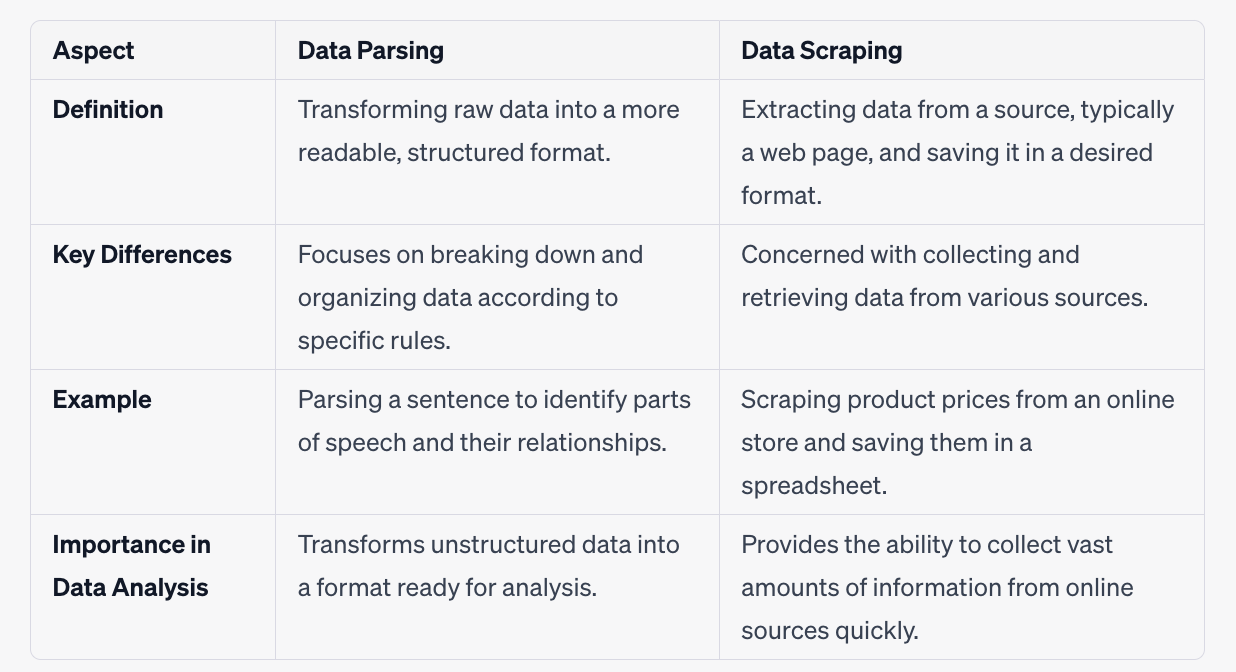
データパーシングとデータスクレイピングは、データ分析の分野において、異なるものの互いに補完し合うプロセスです。
パーシングとは、分析に備えてデータを変換・構造化することであり、一方、スクレイピングとは、さまざまなソースからデータを収集・取得することです。
どちらも、生の情報を実用的な知見に変える上で不可欠な段階です。
データパーシングの応用
データパーシングは、無秩序な情報と実用的な知見をつなぐ架け橋としての役割を果たし、現代の産業がデータを効果的に分析・活用することを可能にします。
本節では、データ解析の多様な応用例を探り、自然言語処理(NLP)から電子商取引、医療、財務分析に至るまで、幅広い分野におけるその不可欠な役割に焦点を当てます。
-
自然言語処理(NLP)。 NLPにおけるデータ解析とは、人間の言語を単語やフレーズといったより小さな単位に分解し、それらの関係性を理解することです。
このプロセスは、発話された言葉をテキストに変換する音声認識や、テキストをある言語から別の言語に翻訳する機械翻訳など、さまざまな用途において極めて重要です。
-
データ変換およびETL(抽出、変換、ロード)プロセス。ETLプロセスでは、データ解析を用いてさまざまなソースからデータを取得し、統一された形式に変換します。
この統一性は、さまざまなソースからのデータを比較・分析できるようにするため、データ分析において不可欠です。これは、データウェアハウジングやビジネスインテリジェンスにおいて極めて重要なステップです。
-
データベースにおけるクエリの最適化。 データパーシングは、データベースクエリを分析し、その構造を理解し、実行を最適化するために使用されます。
データを取得するための最も効率的な方法を選択することで、パーシングはクエリへの応答にかかる時間を短縮し、データベースシステムのパフォーマンス向上に寄与します。
-
金融データの分析。 金融分野では、データパーシングが複雑な金融データの分析や解釈に活用されています。
これにより、財務報告書や同様の非構造化データを、トレンドの発見、リスク評価、投資判断といった様々な分析に活用できる、読みやすい形式に変換することが可能になります。
-
医療データの標準化。 医療データは、多くの場合、さまざまなソースから、異なる形式で提供されます。データパーシングは、医療業界がこの情報を標準化し、異なるシステム間で一貫性を保つのに役立ちます。
この標準化は、医療従事者が正確かつ統一されたデータを利用できるようにするため、患者ケアにとって不可欠です。
-
検索エンジン最適化(SEO)分析。データパーシングは、ウェブページを分析し、そのコンテンツ、構造、メタデータを理解する上で重要な役割を果たします。
この理解は、ウェブページのさまざまな要素を最適化し、オンライン上での可視性を高めるのに役立ちます。
-
ソーシャルメディアデータ分析。 ソーシャルメディアプラットフォームでは、膨大な量の非構造化データが生成されます。データ解析は、このデータを構造化するのに役立ち、トレンド、感情、ユーザーの行動を分析することを可能にします。
この分析は、ターゲット層を理解し、マーケティング戦略を最適化したいと考えている企業にとって有益です。
-
科学データの解釈。 科学研究では、さまざまなファイル形式の複雑なデータが扱われることが多く、それらを正確に解釈する必要があります。
データパーシングは、生物学におけるゲノム情報であれ、気候科学における気象データであれ、こうしたデータを構造化するのに役立ち、研究者が有意義な知見を導き出すことを可能にします。
-
地理情報システム(GIS)データの取り扱い。 GISは空間データに依存しており、そのデータは正確に解析・構造化されなければなりません。
データ解析により、座標、地図レイヤー、その他の地理情報が正しく処理され、マッピング、空間分析、環境モニタリングなどの作業が円滑に行われます。
-
Eコマースの商品情報の構造化。 Eコマースプラットフォームでは、膨大な量の商品情報が扱われます。データ解析は、この情報を構造化するのに役立ち、商品説明、仕様、価格が異なるプラットフォーム間で一貫性を保つことを保証します。
この一貫性により、消費者のショッピング体験が向上し、商品の検索や比較が容易になります。
データパーサーの理解
データパーサーとは、一貫性のないデータ形式を、構造化された正しい形式に変換するために設計された、特殊なソフトウェアまたはアルゴリズムのことで、しばしば「パーシング機構」とも呼ばれます。
データパーサーは生データを読み取り、特定の要素を認識し、あらかじめ定義されたルールやパターンに従ってそれらを整理します。
この解析プロセスは、高品質なデータを、さまざまなアプリケーションで理解・利用可能な形式に変換するために不可欠です。
データパーサーには、主に「自社開発型」と「サードパーティ製」の2種類があります。
自社開発型パーサーは、特定のニーズを満たすために組織が独自に設計したものであり、一方、サードパーティ製パーサーは外部ベンダーが提供する既製のソリューションです。
データパーサーの重要性
- アクセシビリティ。 データを正しい形式に構造化することで、パーサーは分析、レポート作成、意思決定のためにデータを利用可能な状態にします。
- 相互運用性。 パーサーは異なるシステム間のデータ統合を可能にし、データ形式に一貫性がない場合でも、整合性と互換性を確保します。
- 効率性。 強力なデータパーサーは、変換を自動化することでパーシング作業を高速化し、手作業の負担を軽減します。
- 正確性。 パーサーはデータが正しく解釈されることを保証し、エラーを最小限に抑え、高品質なデータの信頼性を高めます。
自社開発のパーサー
自社開発のパーサーは、特定のニーズを満たすために組織が独自に設計したものであり、データ処理のための強力なツールとなります。
サードパーティ製ソリューションとは異なり、自社開発のパーサーでは、独自かつ複雑な要件に対応できるようカスタマイズされた専用のパーサーシステムを構築することが可能です。
-
専用パーサー。 自社内でパーサーを構築することで、組織は自社のデータ構造や要件に完全に合致した専用の解析メカニズムを作成できます。
これにより、組織が日常的に扱う特定のデータ形式やパターンに合わせてパーサーを微調整することが保証され、正確な分析につながります。
-
複雑なニーズに対する理想的なソリューション。 高度に専門化されたデータや複雑なデータを扱う業務においては、自社開発のパーサーが、情報に基づいたビジネス上の意思決定を支援する理想的なソリューションとなることがよくあります。
これらは、複雑なデータ構造を処理したり、厳格な業界規制やビジネス要件に準拠したりするように設計することができ、サードパーティ製のパーサーでは提供できないレベルのカスタマイズ性を実現します。
-
最適化のための強力なツール。 自社開発のパーサーは単なる機能的なユーティリティではなく、長期的なビジネスの成功に向けた正確な洞察を引き出すよう最適化できる強力なツールです。
解析プロセスのあらゆる側面を制御することで、組織はパーサーが最高の効率で動作し、ボトルネックを生じさせることなく大量のデータを処理できるようにすることができます。
-
課題と考慮事項。 自社開発のパーサーには多くの利点がある一方で、課題も伴います。
専用のパーサーを構築するには専門的な知識が必要であり、多大なリソースを要する可能性があります。また、複雑なソリューションに対応できるパーサーを設計する作業は複雑であるため、開発コストの増加や導入期間の長期化につながる恐れもあります。
サードパーティ製データパーサー
サードパーティ製データパーサーとは、外部ベンダーが提供する既製のソリューションであり、組織によるデータの収集プロセスや、構造化された形式への変換を支援するように設計されています。
最も一般的なサードパーティ製パーサーには、次のようなものがあります。
- Apache Commons CSV - CSV ファイルの読み書きを行うためのライブラリ。
- Jackson - 高性能かつ柔軟性を備えた、Java用のJSONパーサー。
- Beautiful Soup - HTMLおよびXMLの解析が可能な、ウェブスクレイピング用のPythonライブラリ。
- TinyXML - 小規模なプロジェクトや組み込みシステムに適した、軽量なXMLパーサーです。
- Pandas - 大規模なデータセットを効率的に格納するためのデータ構造を提供し、データ解析用の関数も備えたPythonライブラリです。
これらのパーサーはさまざまな機能を備えており、次のような異なる目的に使用できます。
- XML 解析。 サードパーティ製のパーサーは XML ドキュメントを処理し、一連のコマンドを、読みやすく管理しやすい形式に変換します。
- ドキュメント解析。 ドキュメントパーサーは、さまざまなドキュメント形式から有益な情報を抽出するために使用されます。
- プロキシパーシング。 Webデータや通信プロトコルを扱う際、データフローを管理するためにプロキシパーサーを活用できます。
メリット
- 平易な仕様。 多くのサードパーティ製パーサーは平易な用語で設計されているため、高度な技術的専門知識を持たないユーザーでも利用しやすいです。この簡潔さにより、収集プロセスが加速されることがよくあります。
- きめ細かな制御:自社開発のパーサーほどカスタマイズ性は高くありませんが、多くの高度なパーサーはきめ細かな制御機能を備えており、詳細な分析や特定のデータ処理を可能にします。
- 専用サーバーオプション:一部のサードパーティ製パーサーは専用サーバーオプションを提供しており、パーシング環境を完全に制御し、パフォーマンスを向上させることができます。
- 継続的なメンテナンス:ベンダーは多くの場合、継続的なメンテナンスを提供しており、パーサーが常に最新の通信プロトコルや標準に準拠していることを保証します。
課題
- カスタマイズの制限。 自作パーサーのカスタムスクリプトとは異なり、サードパーティ製ソリューションでは、極めて特殊なニーズに対して完全な制御が得られない場合があります。
- 潜在的なセキュリティ上の懸念。 パーサーによっては、データのセキュリティや業界規制への準拠に関して懸念が生じる可能性があります。
- ライセンスとコスト。 サードパーティ製の適切なパーサーを利用する場合、ライセンス料や、メンテナンスおよびサポートにかかる継続的な費用が発生する可能性があります。
データ解析の未来
データ解析の未来は、新たな技術や手法に牽引され、絶え間ない進化と革新によって特徴づけられています。
クラウドコンピューティングとの統合、リアルタイム解析機能、強化されたセキュリティ対策、そしてカスタマイズ可能なソリューションが、よりスケーラブルで柔軟かつ効率的な解析ツールへの道を切り開いています。
人工知能(AI)と機械学習(ML)は、この変革において重要な役割を果たしています。
AIを活用したパーサーは、データを構造化するだけでなく、その意味を解釈することも可能であり、より高度な分析を可能にする意味論的な理解の層を追加します。
さらに、リアルタイム分析への需要の高まりや、データプライバシーに対する懸念の増大が、より堅牢かつ俊敏な解析ソリューションの開発を後押ししています。
データをその場で解析する能力と、堅牢なセキュリティ対策の組み込みは、現代の解析ツールにとって不可欠な機能となりつつあります。
技術の進歩とAI・MLの統合により、データ解析はより自動化され、適応性が高まり、洞察力に富んだものとなるため、データ解析の将来は明るいと言えます。
こうした進展により、データ解析は、将来のデータ駆動型意思決定プロセスにおいて、より重要かつダイナミックな要素となることが確実視されています。
まとめ
データパースは、単なる技術的な必要性を超え、実用的なビジネスインサイトを引き出すことができる戦略的資産です。
生データや非構造化データを構造化され理解しやすい形式に変換することで、データ解析は、意思決定やイノベーションを推進する情報の分析と解釈を企業に可能にします。
顧客行動の把握、業務効率の向上、あるいは新たな市場機会の発見など、どのような場面においても、データ解析は有意義な知見を引き出すための強力なツールとなります。
自社開発であれサードパーティ製ソリューションであれ、適切な解析メカニズムに投資することで、企業は情報に基づいたデータ駆動型の意思決定を行う能力を高めることができます。
単なる数字にとどまらず、データに隠されたストーリーや機会を見出すことをお勧めします。データ解析を活用すれば、ビジネスを変革し、成長と成功につながるような方法で情報を探索、理解、活用することが可能になります。

