ETLパイプラインは、データ処理を効率化する手段を提供し、企業が自社の業務に関する洞察を得て、情報に基づいた意思決定を行えるようにするため、不可欠なものです。
ETLパイプラインの例として、小売企業がデータベースから売上データを抽出し、分析に適した形式に変換し、ビジネスインテリジェンスの目的でデータウェアハウスにロードする場合が挙げられます。
このパイプラインでは、Apache NiFi や Talend などのツールを使用してデータを抽出し、Apache Spark や Python などのツールで変換した後、Amazon Redshift や Google BigQuery などのデータウェアハウスにロードすることができます。
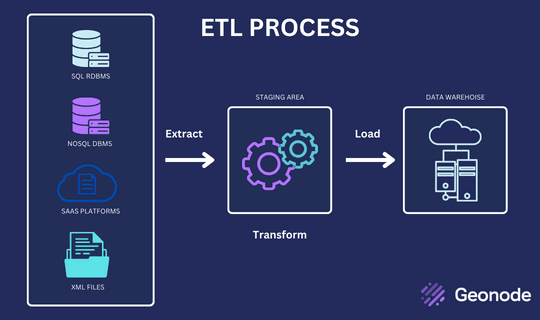
3 ETL パイプラインの構成要素
ETLパイプラインの運用には、抽出(Extraction)、変換(Transformation)、ロード(Loading)という3つの主要な構成要素があります。
抽出
抽出フェーズでは、データベース、クラウドストレージ、API、フラットファイルなど、さまざまなソースからデータを取得します。抽出されたデータは、JSON、CSV、XMLなど、さまざまな形式をとることがあります。
変換
変換フェーズでは、抽出されたデータを利用可能な形式に変換し、クリーニングを行い、追加情報でデータを充実させます。このフェーズでは、フィルタリング、集計、結合、ソートなど、さまざまなデータ処理手法が適用されます。
ロード
ロードフェーズでは、変換されたデータをデータベース、データウェアハウス、データレイクなどのターゲット先に格納します。ロードされたデータは、レポート作成、分析、機械学習など、さまざまな目的に利用できます。
データパイプラインとETLパイプライン
データパイプラインとは、あるシステムやアプリケーションから別のシステムやアプリケーションへデータを移動させるために用いられる一連のステップやプロセスを指す総称です。これには、データの取り込み、処理、保存、分析など、さまざまな要素が含まれます。
ETL(Extract, Transform, Load)パイプラインは、1つ以上のソースからデータを抽出し、より有用な形式や構造化された形式に変換し、宛先となるシステムやアプリケーションにロードするために使用される、データパイプラインの特定のタイプです。ETLパイプラインは、データウェアハウス、ビジネスインテリジェンス、および分析アプリケーションで一般的に使用されています。
ETLパイプラインはデータパイプラインの特定の形態ですが、実際にはこの2つの用語はしばしば同じ意味で使用されます。データパイプラインとは、一般的に、データの移動、処理、分析を行うために使用される一連のプロセスやツールの総称です。対照的に、ETLパイプラインは、特にデータ抽出、変換、およびロードを指します。
ETLパイプラインの種類
ETL(抽出、変換、ロード)パイプラインには、主に以下の2つの種類があります。
バッチ処理:このタイプのパイプラインでは、通常は毎日または毎週、大量のデータをバッチ単位で処理します。データはソースシステムから抽出され、所望の形式に変換された後、バッチ処理によって宛先システムにロードされます。バッチETLは、データウェアハウス、ビジネスインテリジェンス、および分析アプリケーションに有用です。
リアルタイム処理:このタイプのパイプラインでは、データが生成されたりソースシステムに受信されたりすると同時に、ほぼリアルタイムで処理が行われます。データはソースシステムから抽出され、リアルタイムで変換された後、継続的なプロセスとして宛先システムにロードされます。
ETLパイプラインを利用するメリット
ETLパイプラインには、以下のようなメリットがあります。
データ処理の効率化
ETLパイプラインは、データ処理を効率化する手法を提供し、企業が膨大な量のデータを迅速かつ効率的に処理できるようにします。
データ品質の向上
ETLパイプラインにより、重複レコードの排除、エラーの修正、データ標準の徹底を通じて、企業のデータ品質を向上させることができます。
複雑さの軽減
ETLパイプラインは、データ統合タスクを管理するための単一のインターフェースを提供することで、データ処理の複雑さを軽減します。
意思決定の向上
ETLパイプラインは、業務に関するタイムリーで正確かつ実用的な洞察を企業に提供し、情報に基づいた意思決定を可能にします。
ETL言語
ETLパイプラインは、パイプラインの具体的な要件や使用される技術に応じて、さまざまなプログラミング言語やツールを使用して実装できます。一般的に使用されるETL言語やツールには、次のようなものがあります。
SQL (Structured Query Language):SQLは、リレーショナルデータベース内のデータを管理および照会するために使用される標準的な言語です。ETLパイプラインでは、データベースからデータを抽出・変換するために、しばしばSQLが使用されます。
Python:Pythonは、ETLパイプラインを含む幅広いデータ処理および分析タスクに使用される人気のあるプログラミング言語です。Pythonには、Pandas、NumPy、Apache Airflowなど、データの操作、変換、ロードに利用できる多くのライブラリやフレームワークがあります。
Java: Javaは広く使用されているプログラミング言語であり、ETLパイプラインの構築にも利用できます。Apache NiFi、Talend、Apache Beamなど、JavaベースのETLツールがいくつか利用可能です。
R: Rは、統計分析やデータ可視化に一般的に使用されるプログラミング言語です。データ操作や変換のためのライブラリやパッケージが多数用意されており、ETLパイプラインの構築にも利用できます。
ETLツール: Talend、Informatica、Microsoft SSISなど、ETLパイプラインの構築や管理のためのグラフィカルユーザーインターフェース(GUI)を提供するETLツールも数多く存在します。これらのツールは、多くの場合、さまざまなプログラミング言語やデータソースに対応しており、ETLパイプラインの構築や保守のプロセスを簡素化することができます。
ETLパイプラインの設計・実装におけるベストプラクティス
ETLパイプラインを成功させるためには、企業は次のようなベストプラクティスに従う必要があります。
データソースと要件の定義
ETLパイプラインを設計する前に、企業はデータソースと要件を定義する必要があります。 これには、統合が必要なデータソース、そのデータ形式、および満たすべきデータ品質基準の特定が含まれます。
適切なツールの選定
適切なツールの選定は、ETLパイプラインの設計と実装において極めて重要です。さらに、企業は選定したツールの拡張性、柔軟性、および費用対効果を考慮する必要があります。
明確なデータフローの構築
効率的かつ効果的なETLパイプラインを設計するには、明確なデータフローが不可欠です。さらに、データフローは理解しやすく、パイプラインの各段階が明確に定義されている必要があります。
堅牢なエラー処理の実装
ETLパイプラインの信頼性を確保するには、堅牢なエラー処理が不可欠です。 したがって、企業はエラーを検出して解決できるエラー処理メカニズムを実装する必要があります。
パイプラインの定期的なテストと監視
ETLパイプラインの有効性を確保し、問題を引き起こす前に潜在的な課題を特定するためには、定期的なテストと監視が不可欠です。
ETLパイプラインの一般的な課題と、その克服方法
ETLパイプラインには多くの利点がある一方で、以下のような課題も生じることがあります。
データの不整合
ETLパイプラインで使用されるデータソースにエラーや不整合が含まれている場合、データの不整合が発生する可能性があります。 この問題に対処するには、データ品質チェックやクレンジングの仕組みを導入する必要があります。
データ品質の問題
ETLパイプラインで使用されるデータの品質が低かったり、不正確な情報が含まれていたりすると、データ品質の問題が発生する可能性があります。企業は、データの正確性と一貫性を確保するために、データ品質チェックや検証の仕組みを導入すべきです。
パフォーマンスのボトルネック
ETLパイプラインに過負荷がかかったり、データ量の増加に対応するためのスケーリングに失敗したりすると、パフォーマンスのボトルネックが発生する可能性があります。この問題を回避するために、企業はパフォーマンスとスケーラビリティの観点からETLパイプラインを最適化する必要があります。
スケーラビリティの制限
ETLパイプラインが大量のデータを処理できない場合、スケーラビリティの制限が生じることがあります。この問題に対処するため、ETLパイプラインはスケーラブルになるよう設計し、分散コンピューティング技術を活用する必要があります。
まとめ
結論として、ETLパイプラインは包括的なデータ処理システムにおいて不可欠な要素です。これにより、企業はさまざまなソースから膨大な量のデータを収集、変換、ロードし、業務に関する洞察を得ることができます。 しかし、効果的なETLパイプラインを設計・実装するためには、企業はデータソースや要件の定義、適切なツールの選定、明確なデータフローの構築、堅牢なエラー処理の実装、そしてパイプラインの定期的なテストと監視といった、特定のベストプラクティスに従う必要があります。
よくある質問
-
ETLとデータパイプラインの違いは?
ETLとデータパイプラインは、関連しているものの、異なる概念です。ETLは「Extract(抽出)」、 Transform、Loadの頭文字をとったもので、さまざまなソースからデータを抽出し、利用可能な形式に変換し、ターゲット先へロードするという特定のプロセスを指します。一方、データパイプラインは、異なるシステムやアプリケーション間でデータを移動させるというより広範な概念を指し、その全体プロセスの一部としてETLが含まれることもあります。
-
SQLはETLツールですか?
SQLはそれ自体がETLツールというわけではありませんが、ETLプロセスにおいてデータを操作・変換するために一般的に使用されています。SQLを使用すると、フィルタリング、集計、結合など、ETLパイプラインの変換段階で不可欠な要素となるさまざまなデータ変換を実行できます。
-
ETLパイプラインはどのように作成しますか?
ETLパイプラインの作成には、データソースや要件の定義、適切なツールの選択、明確なデータフローの構築、堅牢なエラー処理の実装、そしてパイプラインの定期的なテストと監視など、いくつかのステップが含まれます。 ETLパイプラインの構築によく使用されるツールには、Apache Kafka、Apache Spark、Talend Open Studioなどがあります。
-
DevOpsにおけるETLとは?
DevOpsにおけるETLとは、さまざまなソースからのデータをDevOpsパイプラインに統合するプロセスを指します。これには、ソースコードリポジトリ、ビルドツール、テスト自動化フレームワークからのデータ抽出、利用可能な形式への変換、およびデータウェアハウスやビジネスインテリジェンスツールなどのターゲット先へのロードが含まれます。 DevOpsにおけるETLは、チームにソフトウェア開発プロセスに関するリアルタイムの洞察を提供し、データに基づいた意思決定を可能にするために不可欠です。
参考文献
Sharma, V. (2022年6月13日)。 初心者向け ETL パイプライン構築の完全ガイド。Analytics Vidhya。2023年3月10日、https://www.analyticsvidhya.com/blog/2022/06/a-complete-guide-on-building-an-etl-pipeline-for-beginners/ から取得。
ETL パイプラインとは?(発行年不明)。Snowflake。 2023年3月10日に https://www.snowflake.com/guides/etl-pipeline から取得。
ETLパイプラインとは? データパイプラインとETLの比較 (発行年不明). Qlik. 2023年3月10日に https://www.qlik.com/us/etl/etl-pipeline から取得。

