O acesso a dados imobiliários a partir de plataformas como a redfin.com tornou-se uma necessidade para muitas empresas.
Quer seja um analista imobiliário, um cientista de dados ou apenas um entusiasta da tecnologia, compreender como extrair dados do Redfin pode proporcionar informações inestimáveis.
Este guia abrangente irá orientá-lo através das melhores práticas, ferramentas e métodos para extrair dados do Redfin de forma eficiente e ética.
Porquê fazer scraping do Redfin?
Redfin: uma excelente fonte de anúncios imobiliários
O Redfin é um site imobiliário de destaque que disponibiliza anúncios de casas à venda, dados sobre o mercado imobiliário e outros serviços relacionados.
Fundado em 2004, o Redfin cresceu e tornou-se uma das plataformas líderes no setor imobiliário, proporcionando aos utilizadores uma interface intuitiva para pesquisar imóveis com base em vários critérios, tais como tipo de imóvel, localização, gama de preços, número de quartos e muito mais.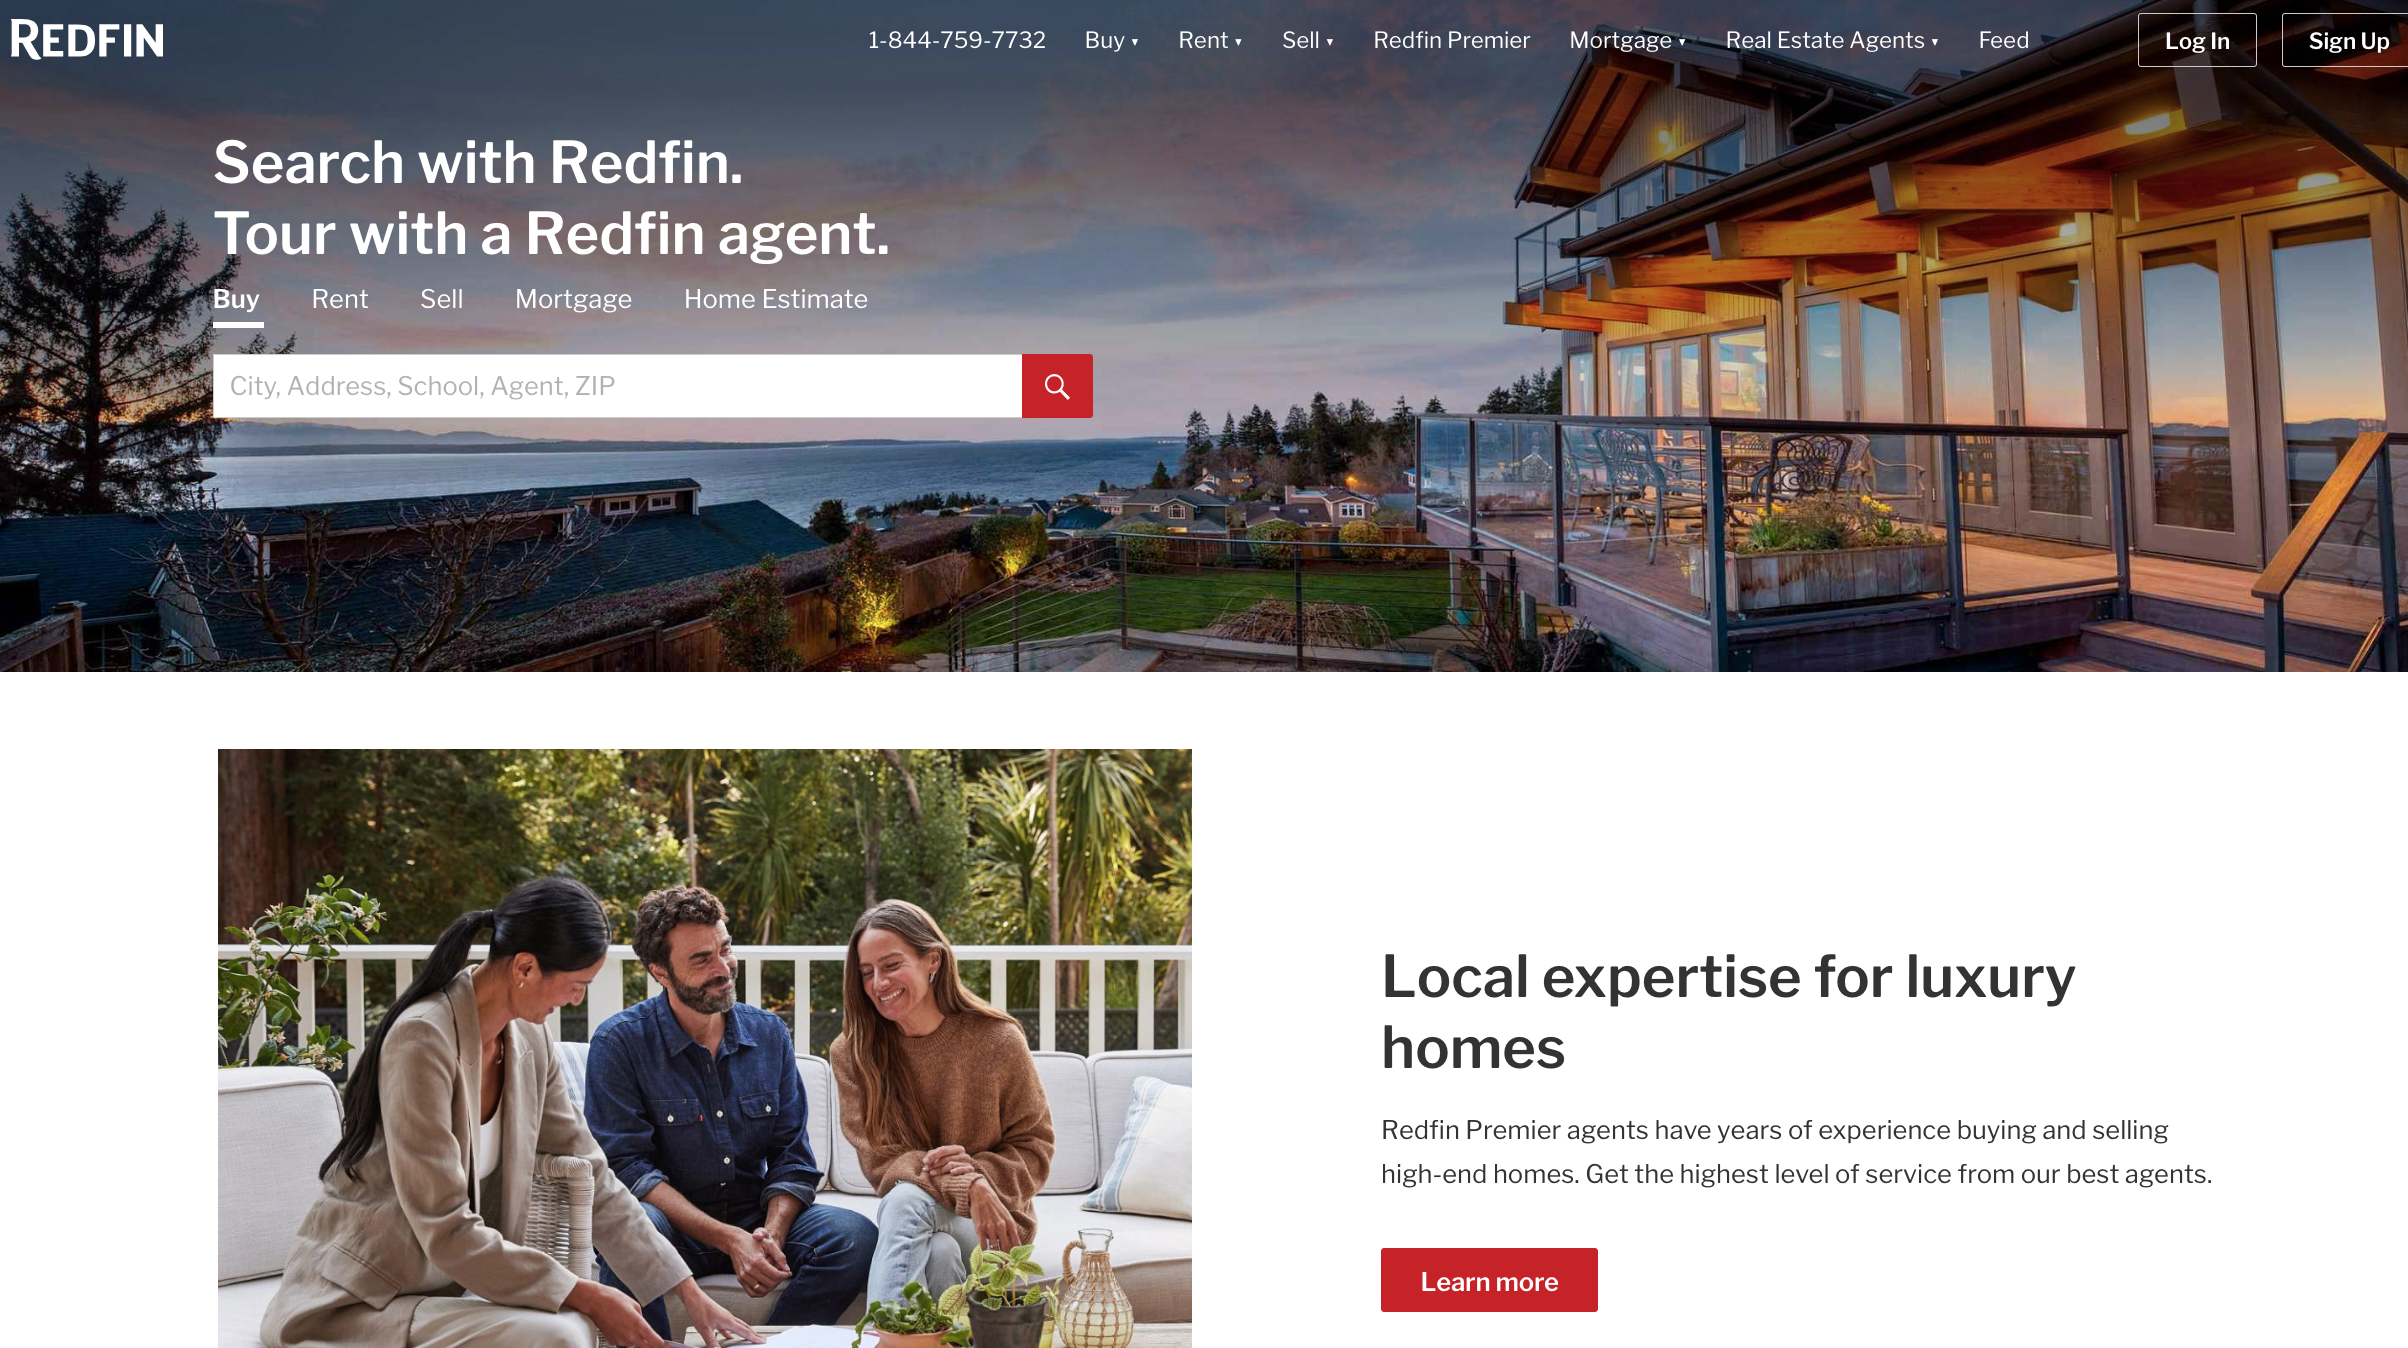
Uma das características distintivas da Redfin são as suas páginas detalhadas de imóveis, que fornecem informações abrangentes sobre cada imóvel, incluindo fotografias de alta resolução, histórico do imóvel e informações sobre o bairro.
Além disso, a Redfin oferece ferramentas como o «Redfin Estimate», que fornece uma estimativa do valor de mercado das casas, e pesquisas interativas em mapas que permitem aos utilizadores explorar imóveis em bairros ou regiões específicas.
Para corretores, agentes ou particulares que pretendam recolher dados sobre anúncios imobiliários, tendências de mercado ou outros detalhes sobre imóveis, a Redfin é um recurso valioso.
Importância dos dados imobiliários
Os dados imobiliários são mais do que apenas números e anúncios; são um reflexo do pulso do mercado.
Cada imóvel anunciado, cada alteração de preço e cada venda contam uma história sobre a comunidade, a economia e o comportamento do consumidor.
Ao extrair dados da Redfin, uma das principais plataformas imobiliárias, os agentes imobiliários e as empresas podem aceder a um verdadeiro tesouro de dados.
Estes dados podem oferecer informações sobre os valores dos imóveis, as tendências de mercado e as preferências da comunidade.
Num mundo impulsionado por dados, dispor de informação imobiliária oportuna e precisa pode ser um fator decisivo para muitas partes interessadas, desde investidores a urbanistas.
Aplicações do Scraper da Redfin na Análise de Mercado
A análise de mercado é crucial para qualquer empresa ou investidor que pretenda tomar decisões informadas. Com os dados imobiliários da Redfin, os analistas podem:
- Identificar tendências. Com um scraper imobiliário, é possível identificar quais os bairros que estão a tornar-se populares, quais os que estão a registar um declínio no interesse ou onde os valores dos imóveis estão a disparar.
- Análise da procura. A recolha de dados imobiliários na Web ajuda os agentes a compreender o que os compradores ou arrendatários procuram. Isto pode dizer respeito ao tamanho do imóvel, às comodidades, à proximidade de escolas ou locais de trabalho e muito mais.
- Decisões de investimento. Para os investidores imobiliários, os dados podem oferecer opções viáveis sobre onde comprar a seguir, em que tipo de imóveis investir ou quando vender.
- Elaboração de políticas. Para as autarquias e os urbanistas, compreender o mercado imobiliário pode ajudar na tomada de decisões sobre o desenvolvimento de infraestruturas, leis de zoneamento e projetos de renovação urbana.
Considerações éticas
Embora o scraping forneça uma grande quantidade de dados, é essencial abordá-lo de forma responsável. Aqui estão algumas diretrizes éticas a ter em conta:
Respeite o ficheiro robots.txt. Este ficheiro no site da Redfin indica quais as partes do site que podem ser acedidas e sujeitas a scraping. Ignorá-lo não é apenas antiético, mas também pode acarretar consequências legais.
Evite sobrecarregar os servidores. Enviar demasiados pedidos num curto espaço de tempo pode tornar o site da Redfin mais lento ou provocar a sua falha. É essencial espaçar as solicitações para evitar perturbar o funcionamento do site.
Privacidade dos dados. Tenha sempre cuidado com a forma como utiliza os dados extraídos da Redfin, especialmente se estes contiverem informações pessoais. O uso indevido desses dados pode acarretar graves consequências legais e éticas.
Diferentes formas de extrair dados imobiliários do Redfin
A extração de dados da Web tornou-se um método indispensável para obter informações valiosas a partir de fontes online, como a Redfin. Aqui estão algumas ferramentas e técnicas disponíveis, cada uma com os seus pontos fortes e limitações específicos:
Utilização de bibliotecas Python
-
- Requests e BeautifulSoup. Esta é uma combinação comum para a extração de dados da Web. O
Requests recupera a página Web e o BeautifulSoup analisa o conteúdo HTML.
- Scrapy. Uma estrutura de extração mais avançada e poderosa, capaz de lidar com tarefas complexas de extração, incluindo a gestão de sessões, cookies e até mesmo a simulação de interações do utilizador.
Utilização de serviços de scraping na Web
-
- ** O Scraper API daGeonode. Geonode** disponibiliza um scraper API que pode ser utilizado para interagir com páginas Web e extrair dados. Permite ações como clicar, percorrer a página e escrever, o que pode ser útil para extrair conteúdo dinâmico.
- Outros serviços de extração. Existem muitos fornecedores que oferecem serviços de extração de dados imobiliários da Redfin. Uma pesquisa rápida irá ajudá-lo a restringir as suas opções e, eventualmente, a selecionar aquele que melhor se adequa às suas necessidades.
Ferramentas de automatização do navegador
-
- Selenium: Uma ferramenta utilizada principalmente para testar aplicações web, mas que também é poderosa para a extração de dados da web, especialmente em sites que carregam conteúdo dinamicamente utilizando JavaScript.
Processo de extração manual
A extração manual envolve copiar manualmente os dados de um site e colá-los num formato ou ferramenta desejados.
Este método, também conhecido como screen scraping, é trabalhoso e demorado, mas pode ser utilizado para tarefas pequenas ou quando a extração automatizada não é viável.
Guia passo a passo para extrair dados do Redfin com Python
Passo 1: Configurar o ambiente
Instalar o Python. Certifique-se de que tem o Python instalado no seu sistema. Caso contrário, descarregue-o e instale-o a partir do site oficial do Python.
Instale as bibliotecas necessárias. Vai precisar de algumas bibliotecas Python para o ajudar na extração de dados. Instale-as utilizando o pip. 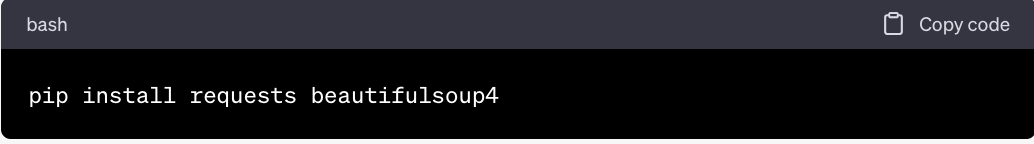
Passo 2: Identifique os URLs permitidos
Aqui está um subconjunto de URLs de pesquisa permitidos do ficheiro robots.txt do Redfin: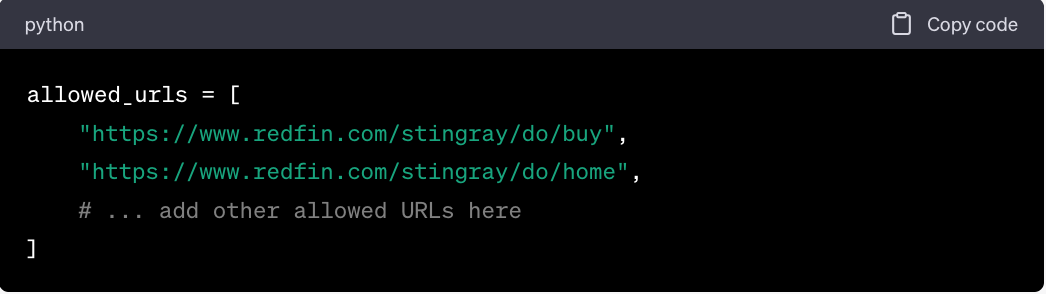
Passo 3: Escrever o programa de extração
Importar as bibliotecas necessárias 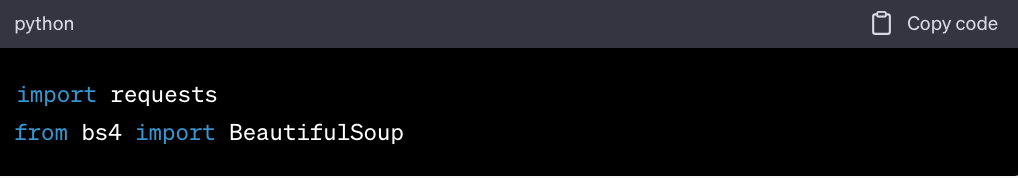
Definir a função de extração 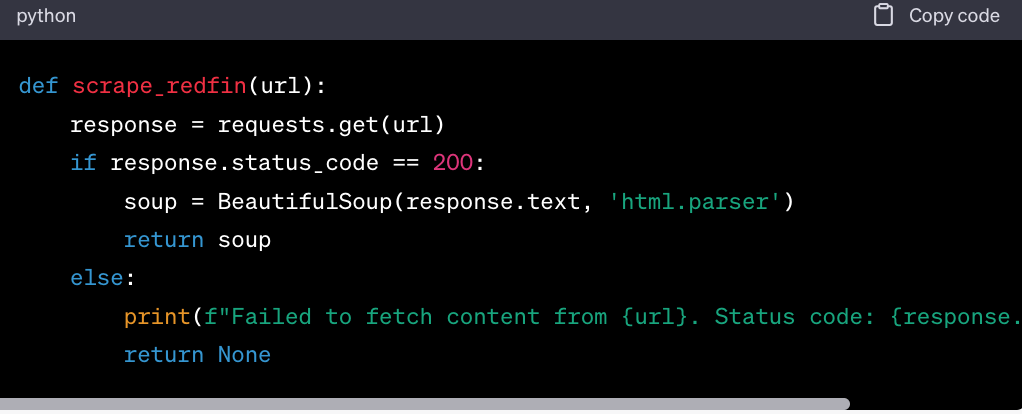
Percorrer as URLs permitidas e extrair os dados 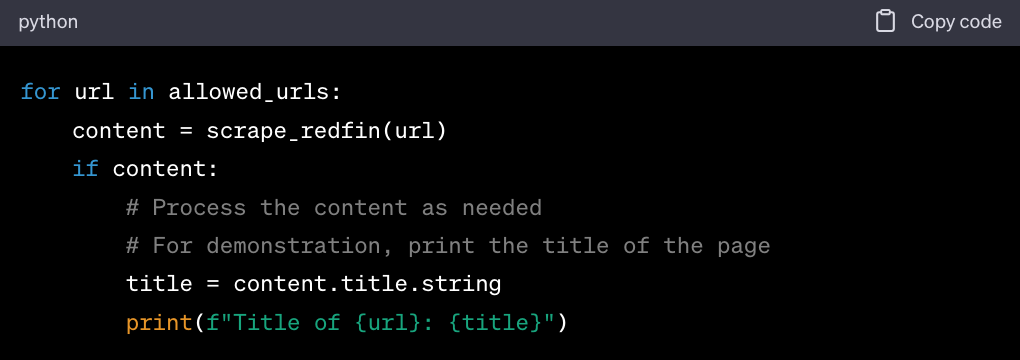
Passo 4: Processar e armazenar os dados
Depois de extrair o conteúdo, pode processá-lo conforme necessário. Por exemplo, poderá querer extrair pontos de dados específicos, limpar os dados ou armazená-los numa base de dados ou num ficheiro.
Extrair dados. Utilize funções do BeautifulSoup, como find(), find_all(), etc., para extrair dados específicos do conteúdo extraído.
Limpar os dados. Certifique-se de que os dados estão no formato pretendido, remova quaisquer caracteres indesejados ou espaços em branco e trate quaisquer dados em falta ou inconsistentes.
Armazenar os dados. Dependendo das suas necessidades, pode armazenar os dados numa base de dados, gravá-los num ficheiro CSV ou guardá-los em qualquer outro formato pretendido.
Como utilizar o Scrapy para recolher dados do Redfin
Passo 1: Configurar o ambiente
Instalar o Python. Se ainda não o fez, descarregue e instale o Python a partir do site oficial do Python.
Instale o Scrapy.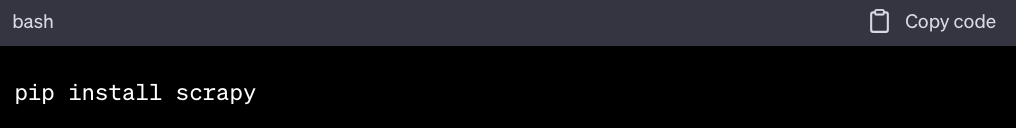
Passo 2: Criar um projeto Scrapy
Abra o seu terminal ou linha de comandos.
Navegue até ao diretório onde pretende criar o seu projeto Scrapy.
Execute o seguinte comando: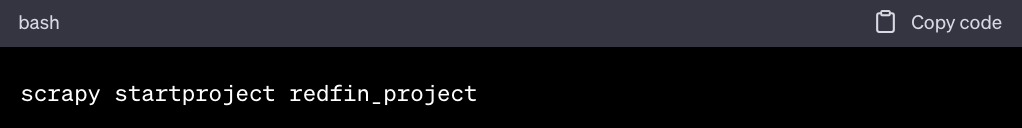
Passo 3: Definir o spider
Navegue até ao diretório spiders dentro de redfin_project: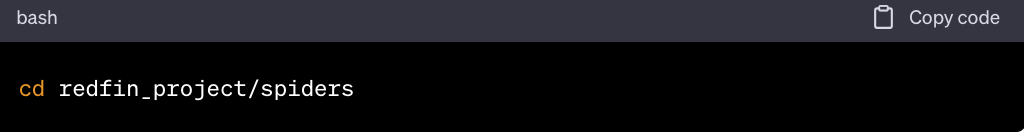
Crie um novo ficheiro chamado redfin_spider.py.
Abra redfin_spider.py no seu editor de texto preferido e adicione o seguinte código: 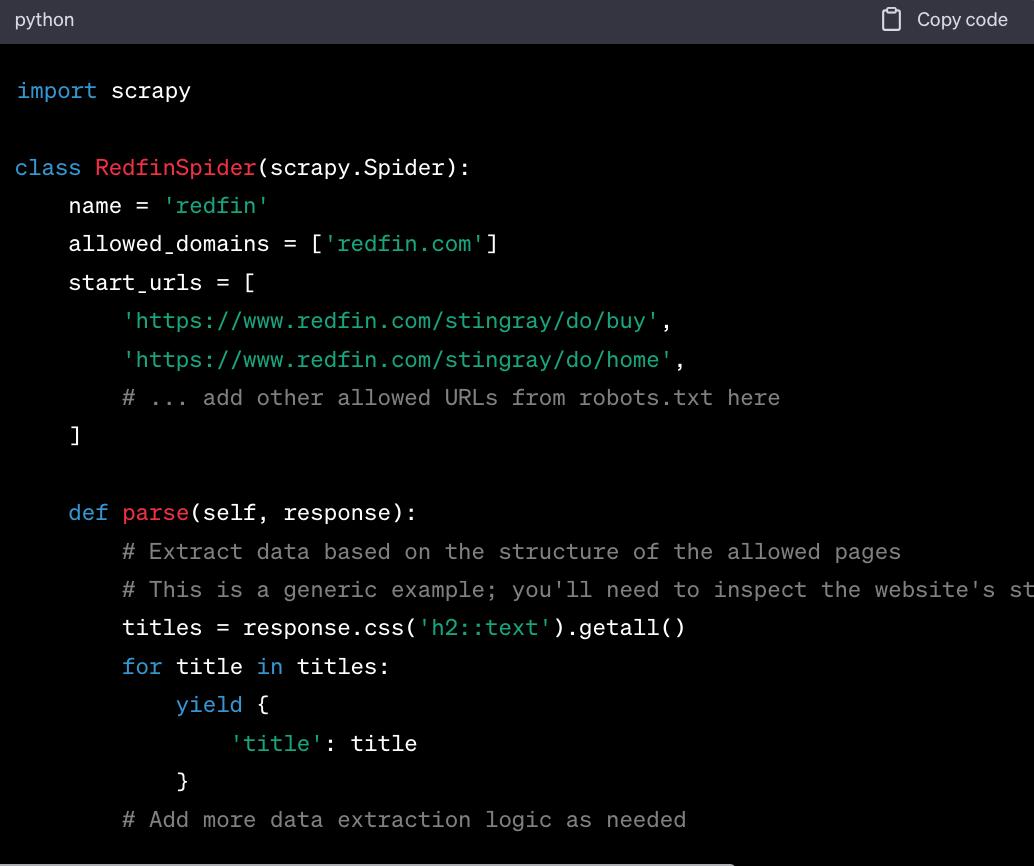
Passo 4: Configurar as definições do Scrapy
Volte à raiz do seu projeto Scrapy (redfin_project).
Abra settings.py num editor de texto.
Altere ou adicione as seguintes definições para respeitar a política de acesso do Redfin (robots.txt) e evitar ser banido: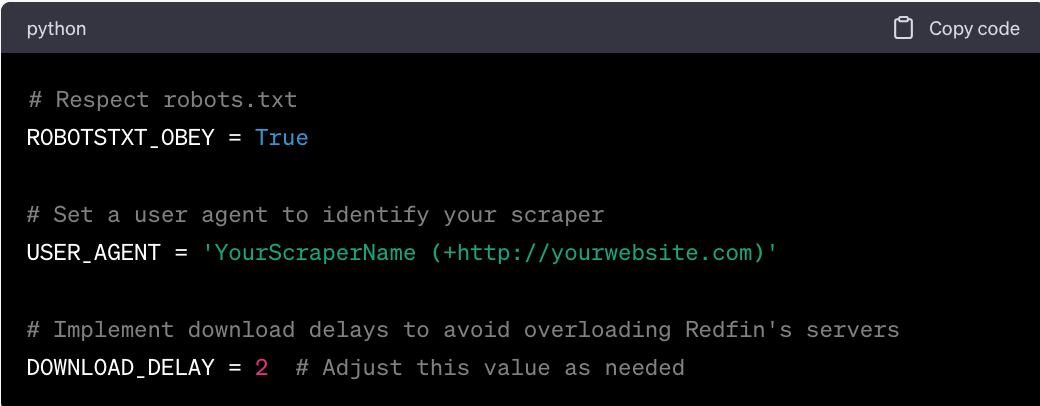
Passo 5: Executar o Spider
Abra o seu terminal ou linha de comandos.
Navegue até ao diretório raiz do seu projeto Scrapy (redfin_project).
Execute o spider com o seguinte comando: 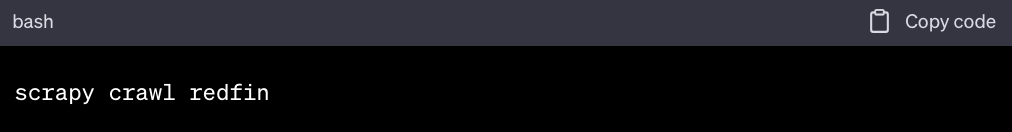
Passo 6: Guardar os dados extraídos
Por predefinição, o Scrapy apresenta os dados extraídos na consola. Se pretender guardar os dados num ficheiro:
Altere o comando para: 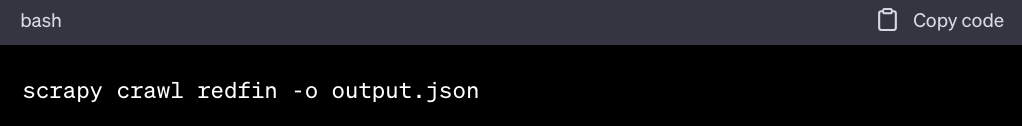
Isto irá guardar os dados extraídos num ficheiro denominado «output.json» no formato JSON. Também pode utilizar outros formatos, como o CSV, alterando a extensão do ficheiro.
Como utilizar o Geonode Scraper API para extrair dados do Redfin sem ser banido
Passo 1: Configurar o seu ambiente
Instalar o Python: Se ainda não o fez, descarregue e instale o Python a partir do site oficial do Python.
Instalar as bibliotecas necessárias: Vai precisar da biblioteca requests para efetuar chamadas à API do Geonode em Scraper API: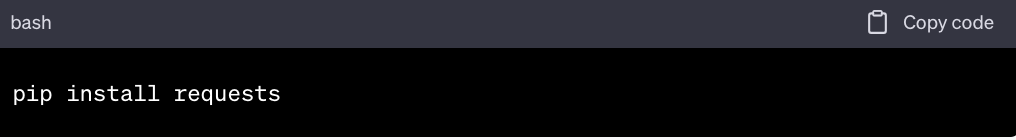
Passo 2: Obter uma chave de API dGeonode
- Registe-se ou inicie sessão em Geonode.
- Aceda às definições da sua conta ou ao painel de controlo para obter a sua chave API. Esta chave será necessária para a autenticação ao efetuar pedidos à API Scraper API.
Passo 3: Identifique os URLs permitidos da Redfin
Aqui está um subconjunto de URLs permitidos para extração: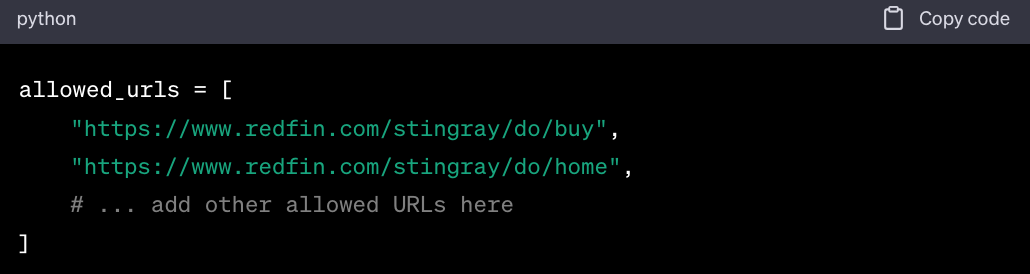
Passo 4: Escrever o script de extração
Importar as bibliotecas necessárias:
Definir a função de extração: 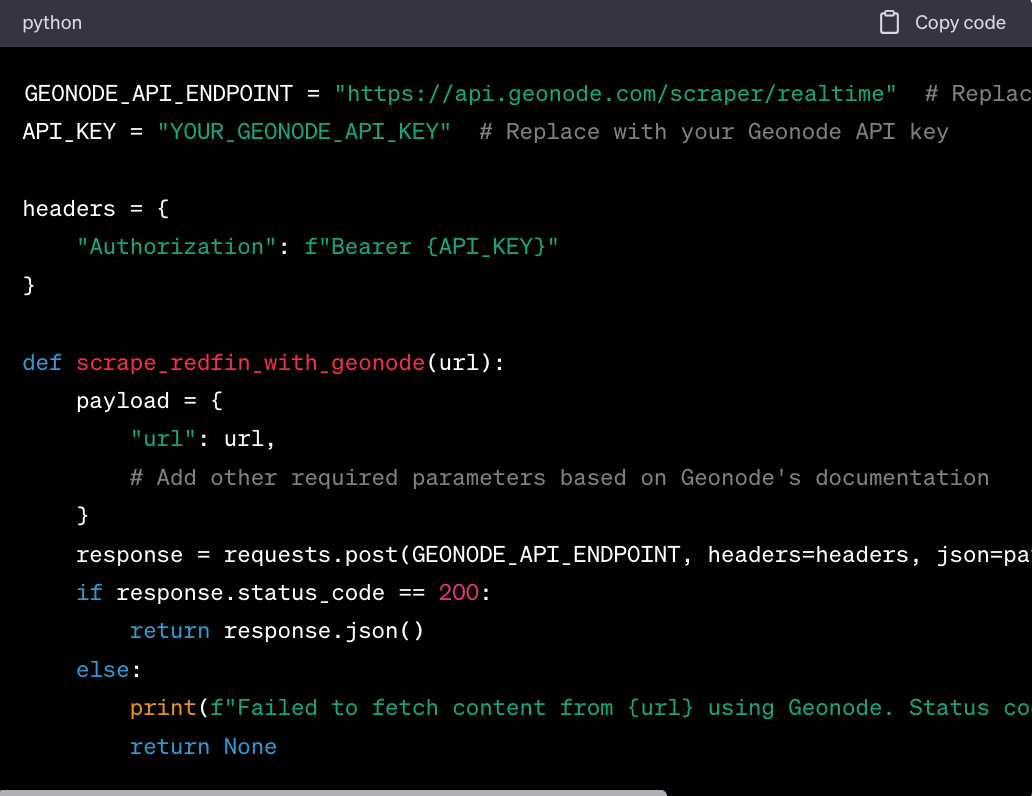
Percorrer as URLs permitidas e extrair os dados: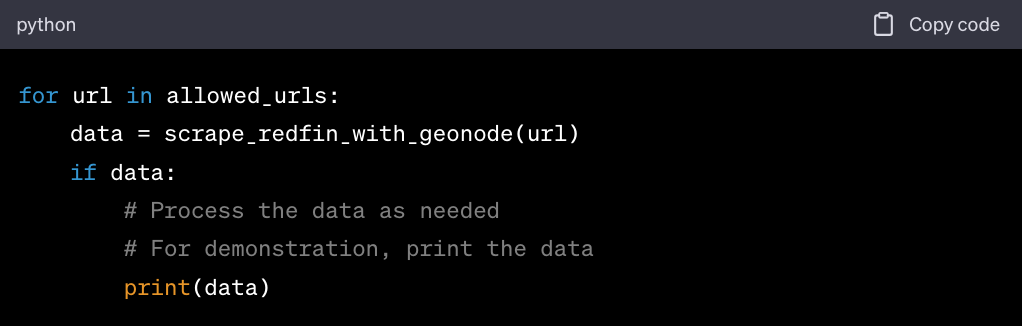
Passo 5: Processar e armazenar os dados
Depois de extrair o conteúdo, pode processá-lo conforme necessário. Por exemplo, poderá querer extrair pontos de dados específicos, limpar os dados ou armazená-los numa base de dados ou num ficheiro.
- Extrair dados. Dependendo da estrutura dos dados devolvidos por Geonode, poderá ser necessário analisá-los para extrair a informação pretendida.
- Limpar dados. Certifique-se de que os dados estão no formato pretendido, remova quaisquer caracteres indesejados ou espaços em branco e trate de quaisquer pontos de dados em falta ou inconsistentes.
- Armazenar dados. Dependendo das suas necessidades, pode armazenar os dados numa base de dados, gravá-los num ficheiro CSV ou guardá-los em qualquer outro formato desejado.
Passos adicionais após a extração de dados
Independentemente da ferramenta de extração de dados da Redfin que utilizar, certifique-se de que:
-
Analise e refine os dados. Após a extração inicial, reveja os dados que recolheu. Certifique-se de que estão corretos e completos.
Aperfeiçoe a sua lógica de extração, se necessário, para capturar quaisquer dados que tenham escapado ou para melhorar a qualidade dos dados.
-
Efetue uma monitorização regular. Se pretender extrair dados do Redfin regularmente, monitorize o desempenho do seu extrator e os dados que este recolhe.
Os sites podem alterar a sua estrutura, o que pode fazer com que o seu extrator deixe de funcionar. A monitorização regular irá ajudá-lo a detetar e resolver quaisquer problemas atempadamente.
Desafios e soluções na utilização de ferramentas de extração de dados imobiliários
A extração de dados da Web é uma ferramenta poderosa, mas apresenta um conjunto de desafios, especialmente quando se trata de sites complexos como o Redfin.
Lidar com conteúdo dinâmico
O desafio: sites modernos como o Redfin carregam conteúdo dinamicamente utilizando JavaScript. As ferramentas tradicionais de scraping, que apenas obtêm o código-fonte HTML, podem deixar escapar este conteúdo carregado dinamicamente.
Soluções:
-
Ferramentas de automatização do navegador. Ferramentas como o Selenium podem simular o comportamento de um navegador real, permitindo-lhe extrair conteúdo carregado dinamicamente.
Com o Selenium, pode aguardar que elementos específicos sejam carregados, interagir com menus suspensos e até mesmo percorrer as páginas para acionar o carregamento de conteúdo.
-
Inspecionar chamadas de rede. Utilizando as ferramentas de desenvolvimento do navegador, inspecione as chamadas de rede efetuadas pelo site. Frequentemente, o conteúdo dinâmico é carregado através de chamadas AJAX para APIs internas.
Se conseguir identificar estas chamadas, pode solicitar dados diretamente a partir delas, obtendo potencialmente dados num formato estruturado como o JSON.
Contornar medidas anti-scraping
O Desafio: A Redfin pode empregar medidas anti-scraping para impedir que bots automatizados acedam aos seus dados. Isto pode incluir CAPTCHAs, limites de taxa ou até mesmo bloqueios de IP.
Soluções:
-
Respeitar o ficheiro «robots.txt.» Comece sempre por verificar o ficheiro «robots.txt» do site. Este ficheiro fornece orientações sobre quais as partes do site que podem ser acedidas por rastreadores da Web.
-
Rotação de User-Agents. Alterne os user-agents para simular diferentes navegadores e dispositivos. Isto pode ajudar a contornar restrições que visam user-agents específicos.
-
Rotação de IP. Utilize Geonode proxies residenciais para alternar entre endereços IP. Se um IP for bloqueado, o scraper pode mudar para outro.
-
Limitação de taxa. Introduza intervalos entre os pedidos para evitar o envio de demasiados pedidos num curto espaço de tempo. Isto pode ajudar a evitar bloqueios de IP e a demonstrar respeito pelos servidores do site.
-
Tratamento de CAPTCHAs. Ferramentas como o 2Captcha ou o Anti-Captcha oferecem serviços para resolver CAPTCHAs. Em alternativa, considere a utilização de ferramentas de automatização do navegador para resolver manualmente os CAPTCHAs quando estes surgirem.
Garantir a precisão e a integridade dos dados
O desafio: O web scraping pode, por vezes, resultar em dados incompletos ou imprecisos, especialmente se a estrutura do site mudar ou se houver inconsistências na forma como os dados são apresentados.
Soluções:
-
Monitorização regular. Monitorize continuamente o desempenho do seu scraper. Se detetar dados em falta ou imprecisos, isso poderá dever-se a alterações na estrutura do site.
-
Tratamento de erros. Implemente um tratamento de erros robusto no seu scraper. Se o scraper encontrar um erro, deve ser capaz de o registar e prosseguir ou repetir a solicitação, garantindo que problemas temporários não resultem em perda de dados.
-
Validação de dados. Após a extração, valide os dados para garantir que cumprem determinados critérios ou formatos. Por exemplo, se estiver a extrair preços de imóveis, certifique-se de que os dados são numéricos e se encontram dentro de um intervalo razoável.
-
Cópia de segurança. Mantenha sempre cópias de segurança dos seus dados extraídos. Se detetar um problema com o seu scraper ou com os dados que este está a recolher, ter cópias de segurança permite-lhe reverter para um estado anterior.
Ao compreender e abordar estes desafios, pode garantir que os seus esforços de web scraping sejam mais bem-sucedidos, éticos e resilientes ao panorama em constante evolução da Web.
A evolução do web scraping
O web scraping começou por ser uma forma simples de extrair conteúdo estático de páginas web.
Os primeiros sites eram simples, e o scraping exigia pouco mais do que descarregar o HTML e analisá-lo.
Hoje em dia, sites como o Redfin são dinâmicos, interativos e repletos de funcionalidades. Carregam conteúdo em tempo real, respondem às interações dos utilizadores e até personalizam o conteúdo com base no comportamento dos utilizadores.
Esta evolução tornou o scraping mais desafiante, mas também mais gratificante. Ferramentas e técnicas modernas, desde a automatização do navegador até à aprendizagem automática, surgiram para responder a estes desafios.
O Futuro da Extração de Dados Imobiliários
O mercado imobiliário é dinâmico, com anúncios e tendências de preços a mudar rapidamente. A procura por dados em tempo real e insights úteis irá impulsionar inovações nas tecnologias de scraping, promovendo uma extração de dados mais rápida e frequente.
À medida que os dados se tornam mais valiosos, as considerações legais e éticas em torno da extração de dados passarão para o primeiro plano.
Podemos esperar diretrizes e regulamentos mais claros que regulem o que pode e o que não pode ser extraído, garantindo que a extração de dados respeite a privacidade e os direitos de propriedade intelectual.
Manter a ética
O web scraping é uma ferramenta poderosa, mas esse poder acarreta o dever de a utilizar de forma ética. Ao extrair dados de sites como o Redfin para as suas diversas necessidades, dê sempre prioridade ao respeito, à integridade e à equidade.
Ao fazer o scraping, garante que a procura de dados nunca comprometa os valores que unem a comunidade digital.

