Imagínate esto: con unas pocas líneas de código, puedes acceder a una gran cantidad de datos de Subito.it, el mercado online de referencia en Italia.
No se trata solo de un ingenioso truco tecnológico, sino de un paso revolucionario para cualquiera que se tome en serio la toma de decisiones basada en datos.
Tanto si te interesa comprender el comportamiento de los consumidores, como si quieres ir un paso por delante con una política de precios dinámica o superar a la competencia, el web scraping de Subito.it es tu billete de oro.
Sumérgete en esta guía para descubrir cómo puedes mejorar tu estrategia empresarial aprovechando el mundo repleto de datos de Subito.it.
¿Qué es Subito.it?
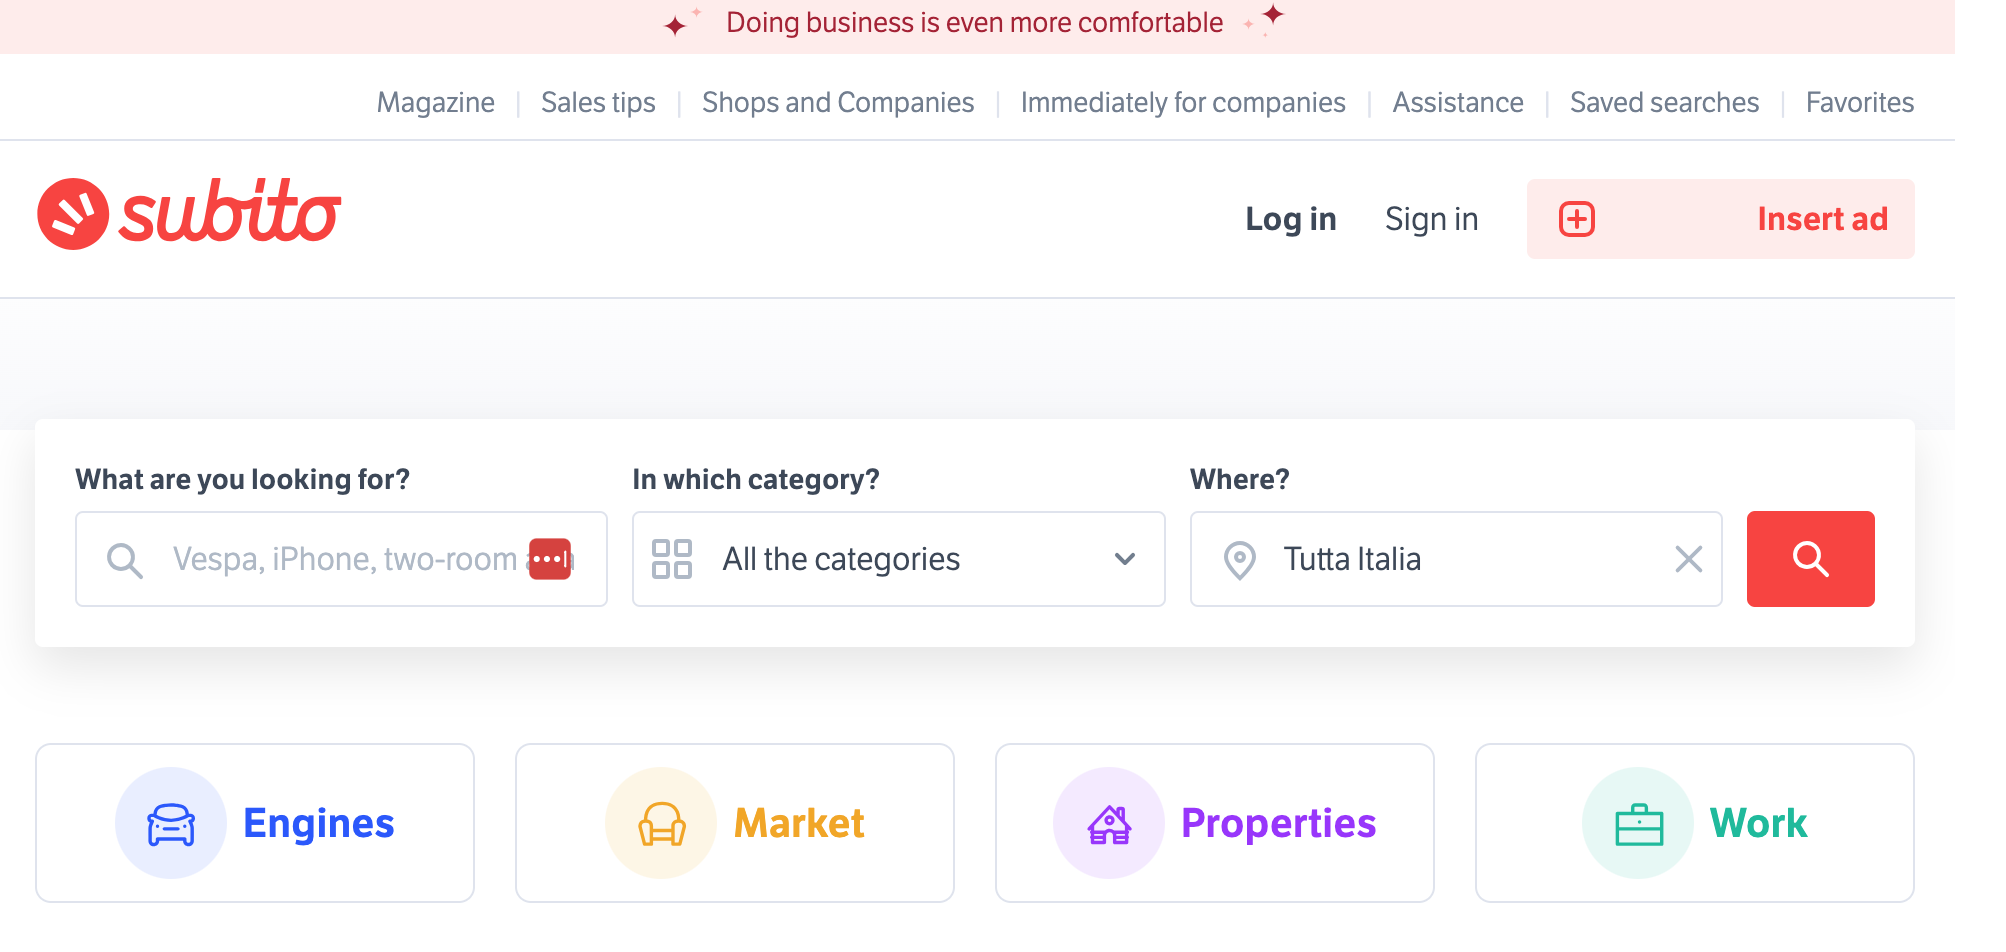
Subito.it es una plataforma online italiana en la que los usuarios pueden comprar y vender artículos nuevos y de segunda mano.
La web ofrece una amplia gama de categorías, entre las que se incluyen motor, mercadillo, inmobiliaria y empleo.
Los usuarios pueden publicar anuncios locales de coches, casas, productos electrónicos, muebles, mascotas y mucho más.
La plataforma también ofrece diversas funciones para que las transacciones sean más seguras y cómodas, como el seguimiento de envíos y opciones de pago seguras.
¿Por qué extraer datos de Subito.it?
La extracción de datos web se ha convertido en una herramienta esencial en el panorama empresarial actual, y Subito.it, como uno de los mercados online más grandes de Italia, ofrece una gran cantidad de datos que pueden resultar de un valor incalculable para diversas aplicaciones.
Importancia de los datos de Subito.it en el comercio electrónico
Subito.it no es solo otro mercado online más; es una mina de oro de datos para cualquiera que se dedique al comercio electrónico.
Con millones de anuncios en categorías como motor, inmobiliaria, empleo y bienes de consumo, la plataforma ofrece una visión completa de las tendencias del mercado, las preferencias de los consumidores y las estrategias de precios.
Al extraer datos de Subito.it, las empresas pueden acceder a esta información en tiempo real, lo que les permite tomar decisiones más ágiles y fundamentadas.
Por ejemplo, si eres un minorista online, puedes extraer datos de Subito.it para conocer el precio medio de productos similares a los tuyos y ajustar tu estrategia de precios en consecuencia.
Del mismo modo, las empresas inmobiliarias pueden extraer datos de los anuncios para evaluar el valor de mercado de las propiedades en diferentes regiones.
Los datos de Subito.it también pueden utilizarse para el análisis de opiniones, lo que ayuda a las empresas a comprender qué buscan los clientes y qué opinan sobre determinados productos o servicios.
Casos de uso de la extracción de datos de Subito.it
- Estudio de mercado. Comprender las tendencias del mercado es fundamental para cualquier empresa.
Al extraer datos de Subito.it, puedes recopilar información sobre los productos más populares, las tendencias estacionales y las demandas de los consumidores, lo que te ayudará a adaptar tu oferta en consecuencia.
- Análisis de la competencia. Estar al tanto de tus competidores es más fácil que nunca gracias al scraping web. Extrae datos sobre listados de productos, opiniones de clientes y estrategias de precios para ver cómo te sitúas frente a la competencia.
- Precios dinámicos. En un mercado tan cambiante, los precios fijos pueden suponer una desventaja. El scraping de Subito.it te permite supervisar las tendencias de precios en tiempo real, lo que te permite ajustar tus precios sobre la marcha para maximizar los beneficios o la cuota de mercado.
- Generación de clientes potenciales. Para los sectores basados en servicios o las empresas B2B, Subito.it puede ser una fuente de clientes potenciales. Extrae los datos de contacto y las solicitudes de servicio para crear un embudo de ventas específico.
- Análisis de opinión. Las reseñas y comentarios de los clientes en Subito.it pueden extraerse para realizar un análisis de opinión, lo que proporciona información sobre la opinión pública y las áreas de mejora.
Casos prácticos y ejemplos reales
-
Concesionario de automóviles. Un concesionario de coches local puede utilizar los datos de Subito.it para comprender la demanda de coches eléctricos en su región. Al extraer anuncios y consultas de clientes, puede abastecerse de los modelos más solicitados, lo que se traduce en un aumento del 20 % en las ventas.
-
Tienda de moda. Una tienda de moda puede extraer datos de Subito.it para analizar la popularidad de diferentes marcas y estilos de ropa. Este enfoque basado en datos permite adaptar su inventario, lo que da lugar a un sistema de gestión de existencias más eficiente y a un aumento de las ventas.
-
Empresa inmobiliaria. Una empresa inmobiliaria puede extraer datos de Subito.it para recopilar información sobre los precios de los inmuebles en distintos barrios. Esta información puede utilizarse para desarrollar un modelo de fijación de precios dinámico que ajuste los precios de los inmuebles en función de las condiciones del mercado en tiempo real, optimizando así significativamente sus ingresos.
Al comprender la importancia, los casos de uso y las aplicaciones prácticas del scraping de Subito.it, queda claro que esta práctica no es solo un ejercicio técnico, sino una necesidad estratégica para las empresas modernas.
Formas de extraer datos de Subito.it
La extracción de datos de Subito.it puede abordarse de varias maneras, cada una con sus propias ventajas y limitaciones.
Tanto si eres un principiante en programación como un desarrollador experimentado, hay un método que se adaptará a tus necesidades.
Extracción manual
En qué consiste: La extracción manual es el método más sencillo y no requiere conocimientos de programación.
Consiste en visitar manualmente la página web de Subito.it y copiar los datos que necesites.
Cómo hacerlo:
-
- Abre el navegador. Accede a Subito.it desde tu navegador web.
- Busca anuncios. Utiliza la barra de búsqueda o los filtros de categorías para encontrar los anuncios que te interesan.
- Copia los datos. Copia y pega manualmente los datos en una hoja de cálculo o un documento.
Ventajas e inconvenientes:
-
- Ventajas: Es fácil de hacer, no requiere conocimientos técnicos.
- Inconvenientes: Requiere mucho tiempo, no es práctico para conjuntos de datos grandes y es propenso a errores humanos.
Ideal para: Proyectos a pequeña escala o tareas rápidas y puntuales de recuperación de datos.
Escribir código
En qué consiste: Implica escribir scripts para automatizar el proceso de extracción de datos. Los lenguajes más utilizados para ello son Python y JavaScript.
Cómo hacerlo:
-
- Elige una biblioteca. Bibliotecas como BeautifulSoup para Python o Puppeteer para JavaScript son opciones muy populares.
- Inspecciona los elementos. Utiliza las herramientas de desarrollo de tu navegador para inspeccionar los elementos HTML que contienen los datos que deseas.
- Escribe el código. Escribe un script para acceder a Subito.it, localizar los puntos de datos y extraerlos.
- Ejecuta el script. Ejecuta el script para recopilar los datos.
Ventajas e inconvenientes:
-
- Ventajas: Altamente personalizable, puede gestionar grandes conjuntos de datos y minimiza el error humano.
- Inconvenientes: Requiere conocimientos de programación y puede necesitar mantenimiento a medida que cambian las estructuras de los sitios web.
Ideal para: Proyectos de mediana a gran escala en los que se requiera personalización y escalabilidad.
Uso de rastreadores de terceros
En qué consiste: Se trata de software o plataformas ya desarrolladas, diseñadas para extraer datos de sitios web.
Cómo hacerlo:
-
- Elige un extractor. Investiga y selecciona un extractor de terceros que se adapte a tus necesidades.
- Configúralo. La mayoría de estas herramientas ofrecen una interfaz gráfica de usuario (GUI) en la que puedes señalar y hacer clic en los datos que deseas extraer.
- Ejecuta el extractor. Inicia el proceso de extracción. Algunas herramientas ofrecen soluciones basadas en la nube, por lo que no es necesario ejecutar el extractor en tu propio equipo.
Ventajas e inconvenientes:
-
- Ventajas: Fácil de usar, no requiere programación y suele incluir funciones integradas como la rotación de direcciones IP.
- Inconvenientes: Puede resultar caro y es menos personalizable que programar tu propia solución.
Ideal para: Aquellos que necesitan una forma más sencilla y menos técnica de extraer datos a gran escala.
Al comprender estos métodos, podrás elegir el que mejor se adapte al alcance de tu proyecto y a tus conocimientos técnicos. Cada uno tiene sus ventajas e inconvenientes, pero todos son formas viables de aprovechar los abundantes recursos de datos que ofrece Subito.it.
Herramientas que necesitarás
Escribir código es una de las formas más habituales de extraer datos de Subito.it, ya que permite un alto grado de personalización.
Sin embargo, la programación es solo una parte del proceso. Para extraer datos de una página web de forma eficaz, necesitarás un conjunto de herramientas que puedan gestionar diversos aspectos del proceso de extracción.
Esta sección ofrece una guía general sobre las herramientas esenciales que necesitarás para extraer datos de Subito.it.
Bibliotecas de extracción de datos web
Las bibliotecas de extracción de datos web son paquetes de código ya escritos que simplifican el proceso de extracción de datos de sitios web.
Se encargan de los detalles más técnicos de la navegación por HTML y HTTP, lo que te permite centrarte en los datos que te interesan.
Bibliotecas de Python para extraer datos de Subito.it:
- Beautiful Soup. Ideal para principiantes, Beautiful Soup facilita la extracción de información de páginas web al proporcionar expresiones típicas de Python para iterar, buscar y modificar el árbol de análisis sintáctico.
- Scrapy. Más adecuado para el scraping web a gran escala, Scrapy es un marco de trabajo de código abierto que proporciona todas las herramientas necesarias para rastrear sitios web y extraer datos.
- Selenium. Aunque no es estrictamente una biblioteca de scraping web, Selenium resulta útil para sitios web que cargan datos de forma dinámica con JavaScript.
Proxies Premium
Los proxies actúan como intermediarios entre tu ordenador y el sitio web del que estás extrayendo datos, ocultando tu dirección IP. Los proxies de Geonode son conocidos por su eficiencia y seguridad.
Cómo los proxies de Geonode pueden hacer que tu extracción de datos sea más eficiente y segura:
- Rotación de IP. Los proxies de Geonode rotan automáticamente las direcciones IP, lo que reduce el riesgo de que Subito.it te bloquee.
- Velocidad. Geonode ofrece proxies de alta velocidad que garantizan que tus tareas de scraping se completen rápidamente.
- Seguridad. Con Geonode, tus datos se cifran, lo que proporciona una capa adicional de seguridad.
Geonode cuenta con un panel de control donde puedes configurar los ajustes de tus proxies. Una vez configurados, puedes integrarlos en tu código de scraping.
Extensiones de navegador imprescindibles
Las extensiones de navegador pueden facilitar el proceso de scraping web, ya que te ayudan a comprender la estructura de un sitio web o a automatizar algunas tareas manuales.
- Web Scraper: Esta extensión de Chrome te permite configurar un plan y extraer datos directamente desde tu navegador.
- Data Miner: Útil para extraer datos de tablas o listas, Data Miner puede ahorrarte tiempo a la hora de realizar una investigación preliminar.
- Selector Gadget: Esta extensión te ayuda a encontrar rápidamente selectores CSS, lo que puede resultar útil a la hora de escribir tu código de scraping.
Estas extensiones se pueden encontrar en la Chrome Web Store. Solo tienes que buscar la extensión y hacer clic en «Añadir a Chrome».
Al equiparte con estas herramientas esenciales, estarás bien encaminado para extraer datos de Subito.it de forma eficaz y eficiente. Tanto si eres principiante como si eres un programador experimentado, estas herramientas te proporcionan la base que necesitas para extraer datos valiosos de Subito.it.
Configuración del entorno
Antes de adentrarnos en el proceso de extracción de datos propiamente dicho, es fundamental configurar un entorno adecuado que permita realizar una extracción de datos web eficiente y eficaz. Esta sección sirve como guía general para ayudarte a preparar tu sistema para extraer datos de Subito.it.
Instalación del software necesario
Para extraer datos de Subito.it, necesitarás un editor de código, un entorno de Python y bibliotecas específicas que faciliten la extracción de datos web.
Configuración del software para extraer datos de Subito.it:
-
Editor de código. Elige un editor de código en el que escribirás tu script de extracción. Entre las opciones más populares se encuentran Visual Studio Code, PyCharm o Jupyter Notebook para proyectos más centrados en los datos.
-
Entorno de Python. Si aún no tienes Python instalado, descárgalo e instálalo desde la página web oficial. Asegúrate de instalar también pip (el instalador de paquetes de Python).
-
Bibliotecas de extracción de datos web: Instala las bibliotecas de Python que vas a utilizar para la extracción. Abre tu terminal y ejecuta los siguientes comandos: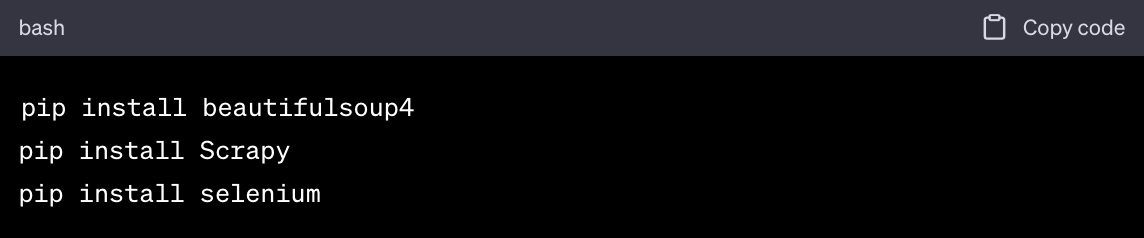
-
Navegador y controlador: Si utilizas Selenium, también necesitarás un controlador web que se corresponda con tu navegador (por ejemplo, ChromeDriver para Google Chrome).
Pasos de instalación:
- Descarga el editor de código que hayas elegido y sigue las instrucciones de instalación.
- Instala Python y asegúrate de marcar la casilla que añade Python a tu PATH.
- Abre tu terminal y ejecuta los comandos pip para instalar las bibliotecas de web scraping.
- Descarga el controlador web para Selenium y colócalo en un directorio que se encuentre en la variable PATH de tu sistema.
Configuración de los proxies de Geonode
-
Regístrate en Geonode. Visita el sitio web de Geonode y crea una cuenta. Elige un plan que se adapte a tus necesidades.
-
Accede al panel de control. Inicia sesión en tu cuenta de Geonode y ve al panel de control.
-
Crea un grupo de proxies. En el panel de control, busca la opción para crear un nuevo grupo de proxies. Sigue las instrucciones para configurar tu grupo, especificando los países o ciudades de los que quieres que procedan tus direcciones IP.
-
Obtén los detalles del proxy. Una vez configurado el grupo, se te proporcionará una lista de direcciones IP y puertos de proxy. Copia estos datos.
-
Integrar en el código. En tu código de scraping, tendrás que configurar tu biblioteca de scraping web para que redirija las solicitudes a través del proxy Geonode. Por ejemplo, si utilizas la biblioteca requests de Python, harías algo como esto: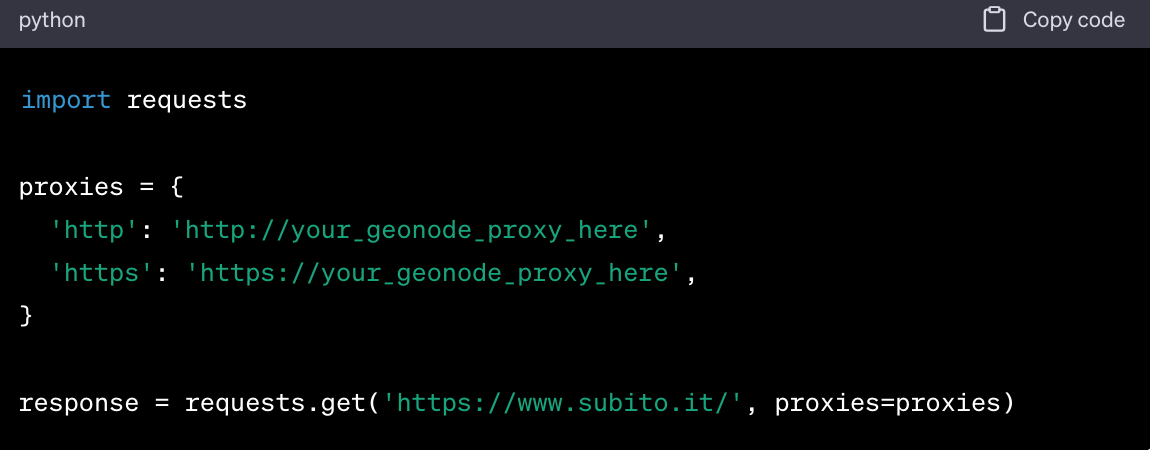
Si sigues estos pasos, dispondrás de un entorno sólido para extraer datos de Subito.it. Con el software adecuado y los proxies correctamente configurados, estarás perfectamente preparado para empezar a recopilar los datos que necesitas.
El proceso de extracción de datos
Una vez configurado tu entorno, ya estás listo para sumergirte en el proceso de extracción de datos propiamente dicho.
Identificación de los datos
El primer paso en cualquier proyecto de extracción de datos web es identificar exactamente qué datos quieres recopilar. Estos pueden ir desde los precios y las descripciones de los productos hasta las opiniones de los usuarios, entre otros.
Qué datos extraer de Subito.it:
- Fichas de productos. Información como el nombre del producto, el precio y la descripción.
- Información del vendedor. Detalles como el nombre del vendedor, la información de contacto y las valoraciones.
- Opiniones de los usuarios. Valoraciones y reseñas escritas por los usuarios.
- Resultados de búsqueda. Datos de las páginas de resultados de búsqueda, incluidas las métricas de clasificación y relevancia.
Cómo identificar estos datos:
- Examina el sitio web. Navega por Subito.it e identifica las páginas que contienen los datos que te interesan.
- Utiliza las herramientas de desarrollo. Abre las herramientas de desarrollo de tu navegador para inspeccionar la estructura HTML e identificar las etiquetas que contienen los datos que buscas.
Escribir el código de scraping
Esto implica escribir un script en Python (u otro lenguaje) que navegue hasta la página web y extraiga los datos que has identificado.
Aquí tienes un fragmento de código simplificado en Python que utiliza BeautifulSoup para extraer los nombres y precios de los productos de una página hipotética de Subito.it: 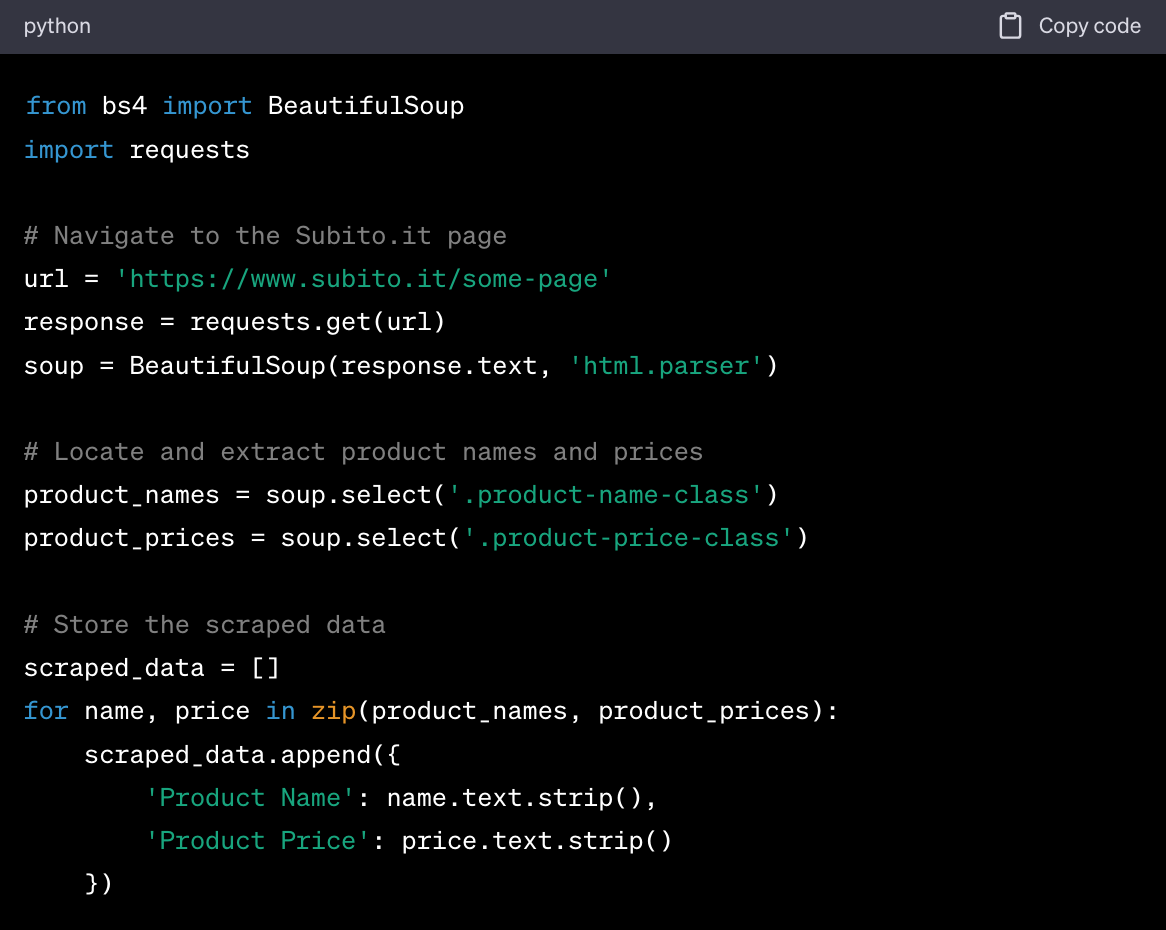
Ejecutar el extractor
Esta es la fase en la que ejecutas tu código de extracción para recopilar los datos que has seleccionado.
Cómo ejecutar tu código de extracción y recopilar datos
- Prueba a pequeña escala. Antes de ejecutar tu rastreador en cientos de páginas, pruébalo en unas pocas para asegurarte de que funciona según lo esperado.
- Ejecuta el código. Ejecuta tu script de Python. Normalmente, esto se puede hacer directamente desde tu editor de código o desde la línea de comandos ejecutando «
python your_script_name.py».
- Supervisa el proceso. Mantén un ojo en el script mientras se ejecuta para asegurarte de que no haya errores ni problemas.
- Almacena los datos. Asegúrate de que tu script esté configurado para almacenar los datos extraídos en un formato útil, como un archivo CSV o una base de datos.
Si sigues estos pasos, estarás en el buen camino para extraer con éxito datos valiosos de Subito.it. Con una preparación y ejecución adecuadas, la extracción de datos web puede proporcionarte la información que necesitas para tomar decisiones fundamentadas.
Buenas prácticas y consideraciones legales
A la hora de realizar scraping en Subito.it o en cualquier otra página web, es fundamental tener en cuenta tanto las buenas prácticas como las consideraciones legales.
Esto garantiza que tus actividades de scraping sean éticas y cumplan con las leyes y normativas pertinentes. En esta sección se analizarán estos aspectos en detalle.
Respetar el archivo robots.txt
El archivo robots.txt es un estándar utilizado por los sitios web para comunicarse con los rastreadores web y otros agentes automatizados, indicando qué partes del sitio no deben procesarse ni escanearse.
Ignorar las directrices establecidas en el archivo robots.txt puede provocar que se bloquee tu dirección IP y podría acarrear consecuencias legales.
Limitación de tasa y rotación de IP
La limitación de tasa consiste en restringir el número de solicitudes que puedes realizar a un sitio web en un intervalo de tiempo determinado. La rotación de IP consiste en cambiar periódicamente tu dirección IP para evitar ser detectado y bloqueado.
Cómo pueden ayudarte los proxies de Geonode con la limitación de tasa y la rotación de IP:
- Rotación de IP. Los proxies de Geonode rotan automáticamente tu dirección IP, lo que dificulta que los sitios web te identifiquen y te bloqueen.
- Limitación de tasa. El uso de varias direcciones IP a través de Geonode te permite distribuir tus solicitudes, eludiendo de forma eficaz los límites de tasa establecidos por el sitio web.
- Configuración. Los proxies de Geonode cuentan con ajustes que te permiten controlar la frecuencia y el patrón de tus solicitudes, lo que te ayuda a realizar el scraping de forma responsable.
No respetar los límites de frecuencia o no rotar las direcciones IP puede provocar que tu rastreador sea bloqueado, lo que haría que tus esfuerzos de rastreo resultaran ineficaces.
Almacenamiento y uso de los datos
Una vez que hayas rastreado los datos, la forma de almacenarlos y utilizarlos está sujeta a consideraciones tanto éticas como legales.
- Almacenamiento. Almacena los datos en un entorno seguro para evitar el acceso no autorizado. A menudo se recomienda el cifrado.
- Uso. Los datos que hayas extraído deben utilizarse de forma responsable. El uso indebido de los datos con fines de spam, fraude o cualquier forma de acoso no solo es poco ético, sino también ilegal.
- Compartir. Si tienes intención de compartir los datos extraídos, asegúrate de que tienes el derecho legal para hacerlo. Algunos sitios web tienen condiciones de uso que prohíben compartir datos extraídos.
- Atribución. Si utilizas los datos con fines de investigación o para elaborar informes, es una buena práctica citar la fuente.
El almacenamiento inadecuado o el uso poco ético de los datos extraídos pueden acarrear repercusiones legales y dañar tu reputación.
Si sigues estas buenas prácticas y consideraciones legales, te asegurarás de que tus actividades de web scraping se lleven a cabo de forma responsable y ética. Esto no solo minimiza el riesgo de problemas legales, sino que también contribuye a la integridad y fiabilidad de tus proyectos de web scraping.
Solución de problemas y preguntas frecuentes
Incluso con la mejor preparación, es posible que te encuentres con problemas al extraer datos de Subito.it. Esta sección tiene como objetivo abordar los errores más comunes y las preguntas frecuentes para ayudarte a resolver eficazmente los problemas que surjan durante tus actividades de extracción de datos.
Errores comunes y soluciones
Solución de problemas relacionados con el scraping de Subito.it:
-
IP bloqueada. Si observas que tus solicitudes son rechazadas, es probable que tu IP haya sido bloqueada.
- Solución: Utiliza un servicio de proxy como Geonode para rotar tus direcciones IP.
-
Límite de frecuencia superado. Si realizas demasiadas solicitudes en un breve periodo de tiempo, es posible que alcances el límite de frecuencia.
- Solución: Introduce un intervalo entre tus solicitudes o distribúyelas utilizando varias direcciones IP.
-
Datos incompletos o inexactos. A veces, es posible que el rastreador no recopile todos los datos necesarios o que recopile datos incorrectos.
- Solución: Revisa minuciosamente tu código para asegurarte de que estás seleccionando los elementos HTML correctos.
-
Errores de tiempo de espera. Tu scraper podría agotar el tiempo de espera si una página tarda demasiado en cargarse.
- Solución: Aumenta el límite de tiempo de espera en tu código o intenta optimizar tu scraper para que funcione más rápido.
Preguntas relacionadas
Preguntas frecuentes y sus respuestas:
-
¿Cómo extraer datos de Subito.it sin que te bloqueen?
- Utiliza proxies para rotar tus direcciones IP y aplica una limitación de frecuencia para evitar realizar demasiadas solicitudes en un periodo corto. Además, respeta las directrices del archivo «
robots.txt» de Subito.it.
-
¿Es legal extraer datos de Subito.it?
- Aunque la extracción de datos públicos suele ser legal, es fundamental respetar las condiciones de uso del sitio web y las directrices de
robots.txt. El uso indebido de los datos extraídos puede acarrear consecuencias legales.
-
¿Cómo puedo extraer datos de Subito.it más rápido?
- Para acelerar el proceso de extracción, puedes utilizar una biblioteca o un marco de trabajo de extracción más eficiente. Además, el uso de un servicio de proxy como Geonode puede ayudarte a distribuir tus solicitudes entre varias direcciones IP, eludiendo así de forma eficaz los límites de frecuencia.
Si tienes en cuenta estos problemas habituales y las preguntas frecuentes, podrás prepararte mejor para los retos que plantea el scraping web. Una resolución adecuada de los problemas puede ahorrarte tiempo y recursos, haciendo que tu proyecto de scraping sea más eficiente y eficaz.
Conclusión
El scraping de Subito.it ofrece un sinfín de oportunidades para empresas, investigadores y analistas de datos.
Al automatizar el proceso de recopilación de datos, puedes obtener información valiosa sobre las tendencias del mercado, el comportamiento de los consumidores y el panorama competitivo.
Tanto si buscas optimizar tu estrategia de precios, comprender a tu público objetivo o tomar decisiones basadas en datos, el scraping de Subito.it te proporciona la materia prima que necesitas.
Esta guía ha abarcado todo, desde la configuración de tu entorno y la elección de las herramientas adecuadas hasta las mejores prácticas y la resolución de problemas.
El objetivo ha sido dotarte de los conocimientos y habilidades necesarios para extraer datos de Subito.it de forma eficaz y responsable.
Qué hacer con los datos que has extraído y cómo aprovecharlos para el éxito empresarial:
-
Limpieza de datos: El primer paso tras la extracción es limpiar y organizar los datos. Esto implica eliminar duplicados, gestionar los valores que faltan y convertir los tipos de datos cuando sea necesario.
-
Análisis de datos. Utiliza métodos estadísticos o algoritmos de aprendizaje automático para analizar los datos. Esto podría ayudarte a identificar patrones, correlaciones o tendencias que podrían resultar beneficiosas para tu negocio.
-
Implementación estratégica. Aplica los conocimientos obtenidos del análisis a tus estrategias empresariales. Por ejemplo, si has extraído datos sobre precios, podrías utilizarlos para optimizar tu propia estrategia de precios.
-
Seguimiento y actualización. Internet es dinámico y los datos pueden quedar obsoletos rápidamente. Acostúmbrate a ejecutar tu rastreador periódicamente para mantener tus datos actualizados.
-
Cumplimiento normativo y ética. Asegúrate siempre de que el uso que haces de los datos extraídos cumpla con la normativa legal y las normas éticas. Esto incluye respetar las leyes de privacidad y los derechos de propiedad intelectual.
-
Comparte tus conclusiones. Si procede, plantéate compartir tus hallazgos con tu equipo, las partes interesadas o incluso con la comunidad en general. Esto no solo aporta valor, sino que también consolida tu experiencia en el sector.
Siguiendo estos pasos, podrás transformar los datos brutos que has extraído en información útil, aprovechándolos así para el éxito de tu negocio.
Con el enfoque adecuado y unas prácticas responsables, el web scraping puede ser una herramienta poderosa en tu arsenal de toma de decisiones basada en datos.

