¿Por qué extraer datos de Twitter?
Los datos de Twitter, dada su naturaleza en tiempo real y la enorme cantidad de opinión pública que recogen, pueden utilizarse de múltiples formas en diversos ámbitos, tales como:
• Monitorización de la marca. Las empresas pueden utilizar los datos de Twitter para supervisar en tiempo real lo que se dice sobre su marca. Esto puede ayudarles a responder con rapidez a las quejas o consultas de los clientes, hacer un seguimiento de la eficacia de las campañas de marketing y comprender la opinión pública respecto a su marca. Por ejemplo, un repentino aumento de las opiniones negativas sobre un producto podría indicar un problema que hay que abordar rápidamente.
• Análisis de tendencias. Twitter suele ser el lugar donde surgen por primera vez las nuevas tendencias, lo que lo convierte en un recurso valioso para el análisis de tendencias. Al analizar el contenido de los tuits, las empresas pueden identificar tendencias emergentes en su sector, hacer un seguimiento de la popularidad de determinados temas a lo largo del tiempo e incluso predecir tendencias futuras. Esto puede servir de base para la estrategia empresarial, desde el desarrollo de productos hasta el marketing y las ventas.
• Investigación académica. Los investigadores de campos como la sociología, la lingüística y las ciencias políticas pueden utilizar los datos de Twitter para diversos fines. Por ejemplo, pueden analizar los tuits de los usuarios para estudiar el uso del lenguaje, examinar la difusión de información o desinformación, o investigar la respuesta del público ante determinados acontecimientos o políticas.
• Periodismo. Los periodistas pueden utilizar los datos de Twitter para descubrir noticias de última hora, seguir el desarrollo de las noticias y evaluar la opinión pública sobre diversos temas. En algunos casos, los propios tuits pueden convertirse en noticias. Por ejemplo, los tuits de figuras públicas pueden tener un impacto significativo y a menudo son objeto de cobertura en los medios de comunicación.
Estos son solo algunos ejemplos de cómo se pueden utilizar los datos de miles de millones de tuits. Las posibilidades son enormes y siguen creciendo a medida que cada vez más personas pasan de otras plataformas de redes sociales a Twitter para compartir sus opiniones y experiencias.
Comprender los datos de Twitter
Antes de profundizar en los métodos de extracción de datos de Twitter, es fundamental comprender los cuatro tipos de datos disponibles en Twitter y la información que se puede obtener de ellos.
• Tuits. Un tuit es la unidad más básica de información en Twitter. Se trata de un mensaje publicado por un usuario y puede contener hasta 280 caracteres. Cada tuit contiene una gran cantidad de datos, entre los que se incluyen el contenido del tuit, la hora en que se publicó, el número de «me gusta» y retuits que ha recibido, y los hashtags utilizados. El análisis de los datos de los tuits puede proporcionar información sobre los temas de tendencia, la opinión sobre un tema concreto, el alcance de un hashtag y mucho más.
• Usuarios. Los datos de los usuarios se refieren a la información relacionada con las cuentas de Twitter. Esto incluye el nombre de usuario, la descripción del perfil, la ubicación, el número de seguidores y de personas a las que se sigue, el número de tuits y la fecha de creación de la cuenta. Al analizar los datos de los usuarios, se puede obtener información sobre las características demográficas de una base de usuarios, identificar a personas influyentes en un ámbito concreto o realizar un seguimiento del crecimiento de una cuenta de Twitter a lo largo del tiempo.
• Entidades. Las entidades en los datos de Twitter se refieren a los objetos asociados a un tuit. Esto incluye hashtags, menciones a usuarios, URL y archivos multimedia (fotos y vídeos). Las entidades permiten comprender el contexto de un tuit. Por ejemplo, analizar los hashtags asociados a un tuit puede ayudar a identificar los temas que se están debatiendo, mientras que examinar las menciones a usuarios puede revelar la red de interacciones.
• Lugares. Estos datos se refieren a la información geográfica asociada a un tuit o a un usuario. Puede tratarse de la ubicación desde la que se publicó un tuit o de la ubicación especificada en el perfil de un usuario. El análisis de los datos de lugares puede ofrecer información sobre tendencias geográficas, la difusión de la información entre distintas ubicaciones o la popularidad de un tema en diferentes regiones.
Cada tipo de datos tiene su propia importancia y puede aportar información única. Por ejemplo, los datos de los tuits pueden ayudar a identificar temas de actualidad y la opinión pública; los datos de los usuarios pueden revelar quiénes son las personas influyentes y las características demográficas de la audiencia; las entidades pueden aportar contexto a los debates; y los datos de lugares pueden descubrir tendencias geográficas.
Al comprender y analizar estos tipos de datos, puedes acceder a una gran cantidad de información valiosa procedente de Twitter. Ya sea para estudios de mercado, seguimiento de marcas, investigación académica o periodismo, los datos de Twitter constituyen un recurso rico y dinámico para comprender la opinión pública, seguir las tendencias y tomar el pulso a las conversaciones globales.
Cómo extraer datos de Twitter: tres métodos
1. La API de Twitter
La API oficial de Twitter permite a los desarrolladores interactuar con su plataforma mediante programación. La API proporciona acceso a diversos tipos de datos, como tuits, perfiles de Twitter y mucho más.
¿Por qué utilizar la API de Twitter?
• Datos estructurados. Los datos que devuelve la API están bien estructurados y son coherentes, lo que facilita su manejo y análisis.
• Fiabilidad. Al ser una API proporcionada por el propio Twitter, garantiza la fiabilidad y la continuidad del servicio.
• Documentación exhaustiva. Twitter ofrece una amplia documentación sobre su API, lo que facilita a los desarrolladores comprenderla y utilizarla de forma eficaz.
Limitaciones de la API de Twitter
• Límites de frecuencia. Para evitar abusos, Twitter impone límites a su API durante un periodo de tiempo determinado. Por ejemplo, solo se pueden realizar 900 solicitudes cada 15 minutos para consultar la cronología de un usuario con una aplicación autenticada por el usuario.
• Acceso a los datos. No se puede acceder a todos los datos a través de la API. Por ejemplo, solo se puede acceder a los 3.200 tuits más recientes de la cronología de un usuario.
• Costes. Aunque Twitter ofrece un nivel gratuito para su API, este conlleva importantes limitaciones. El acceso a más datos y a límites de frecuencia más altos requiere una suscripción de pago, que puede resultar bastante cara.
Pasos para utilizar la API de Twitter con el fin de extraer datos de Twitter:
La API de Twitter es una potente herramienta que permite a los desarrolladores acceder a una amplia gama de datos de Twitter mediante programación. A continuación, te ofrecemos una guía paso a paso sobre cómo utilizarla:
1. Configurar una cuenta de desarrollador
• Ve al sitio web para desarrolladores de Twitter (https://developer.twitter.com/
).
• Haz clic en el botón «Solicitar».
• Se te pedirá que inicies sesión en tu cuenta de Twitter. Si no tienes una, tendrás que crear una.
• Una vez que hayas iniciado sesión, rellena el formulario de solicitud para crear una cuenta de desarrollador. En el formulario se te pedirá información sobre cómo piensas utilizar la API. Sé lo más detallado posible para aumentar tus posibilidades de que te la aprueben.
• Tras enviar tu solicitud, espera a que Twitter la apruebe. Esto puede tardar unos días, así que ten paciencia.
2. Crea una aplicación y obtén las claves de la API
• Inicia sesión en tu cuenta de desarrollador de Twitter.
• Ve al «Panel de control» y haz clic en «Crear una aplicación».
• Rellena el formulario con los datos de tu aplicación. Indica un nombre, una descripción, la URL del sitio web y explica a Twitter cómo piensas utilizar la aplicación.
• Anota las claves de la API que aparecen en la página una vez creada la aplicación. Hay dos conjuntos de claves: la clave de API y el secreto, y el token de acceso y el secreto. Necesitarás estas claves para autenticar tu aplicación cuando utilices la API.
3. Utiliza Tweepy para acceder a la API de Twitter (Scraper API
)
Sigue estos pasos:
• Importa la biblioteca Tweepy.
• Autentícate en Twitter utilizando tus claves de API.
• Crea un objeto API que puedas utilizar para interactuar con la API de Twitter.
• Utiliza el método user_timeline para obtener los tuits más recientes de la cronología de un usuario (en este caso, «twitter») e imprime el texto de cada tuit.
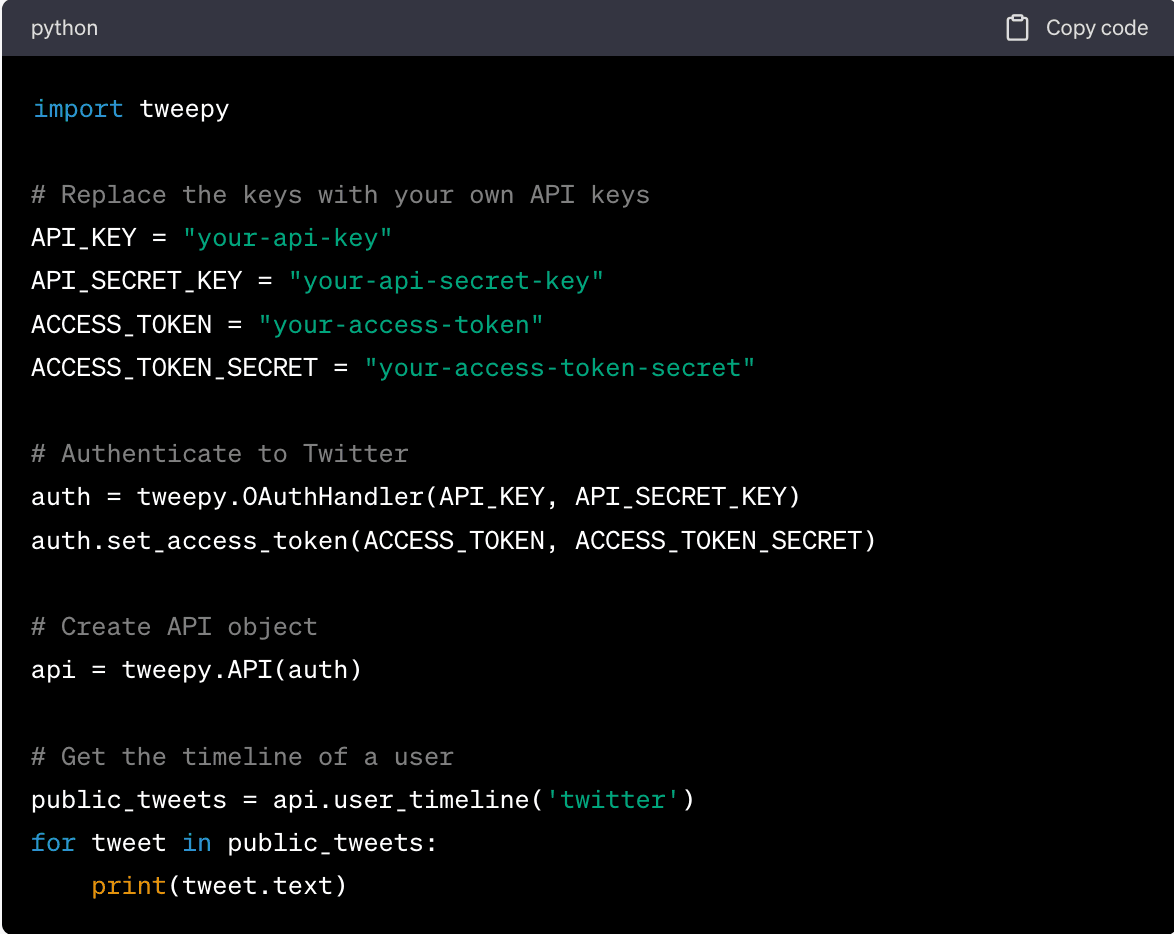
Recuerda sustituir «tu-clave-API», «tu-clave-secreta-API», «tu-token-de-acceso» y «tu-secreto-de-token-de-acceso» por tus propias claves API. Además, sustituye «twitter» por el nombre de usuario de la cuenta de Twitter de la que quieras obtener los tuits.
Este es un ejemplo sencillo, pero Tweepy ofrece muchos más métodos para acceder a diferentes tipos de datos de Twitter. Consulta la documentación de Tweepy para obtener más información.
En resumen, aunque la API de Twitter ofrece una forma fiable y estructurada de acceder a los datos de Twitter, presenta limitaciones en cuanto a límites de frecuencia, acceso a los datos y costes. Estas limitaciones pueden suponer un obstáculo importante para los proyectos de extracción de datos a gran escala. En tales casos, el web scraping puede ser una alternativa más flexible y rentable, que analizaremos en la siguiente sección.
2. Web scraping en Twitter con Python
El web scraping en Twitter con Python es el proceso de extraer automáticamente datos del sitio web de Twitter utilizando el lenguaje de programación Python. Este proceso se utiliza a menudo para recopilar grandes cantidades de datos de Twitter cuya recopilación manual llevaría demasiado tiempo.
¿Por qué utilizar Python?
• Bibliotecas potentes. Python cuenta con un amplio ecosistema de bibliotecas que simplifican el web scraping. Bibliotecas como Tweepy, BeautifulSoup y Scrapy pueden encargarse de todo, desde realizar peticiones HTTP hasta analizar código HTML e interactuar con API.
• Facilidad de uso. La sintaxis de Python es clara y concisa, lo que lo convierte en un buen lenguaje para el web scraping. Incluso las tareas de scraping más complejas pueden llevarse a cabo con relativamente pocas líneas de código.
• Herramientas de análisis de datos. Python también es ideal para analizar datos. Bibliotecas como Pandas, NumPy y Matplotlib facilitan la limpieza, el análisis y la visualización de los datos extraídos.
• Apoyo de la comunidad. Python cuenta con una comunidad amplia y activa que hace que encontrar ayuda y recursos en línea sea realmente fácil. Si te encuentras con un problema, es muy probable que alguien ya lo haya resuelto.
Limitaciones de Python
• Contenido dinámico. Las herramientas estándar de extracción de datos web de Python tienen dificultades con el contenido dinámico cargado mediante JavaScript. Hay formas de sortear este problema, como utilizar una biblioteca como Selenium, pero hacerlo añade otra capa de complejidad al proyecto de extracción de datos de Twitter.
• Límites de frecuencia. Twitter impone límites de frecuencia en su API, lo que puede ralentizar tu proyecto de scraping web. Aunque hay formas de sortear esto, como utilizar varias cuentas o direcciones IP, estos métodos van en contra de las condiciones de servicio de Twitter.
• Cambios en la estructura del sitio web. Si Twitter cambia la estructura de su sitio web o de su API, es posible que tu código de scraping deje de funcionar. Tendrás que actualizar tu código para reflejar estos cambios, lo que puede llevar bastante tiempo.
Pasos para utilizar Python en el scraping de Twitter:
1. Configurar el entorno. Instala Python y las bibliotecas necesarias si aún no las tienes. Para este ejemplo, utilizaremos BeautifulSoup y Requests.
2. Envía una solicitud HTTP a la página de Twitter de la que quieras extraer datos.
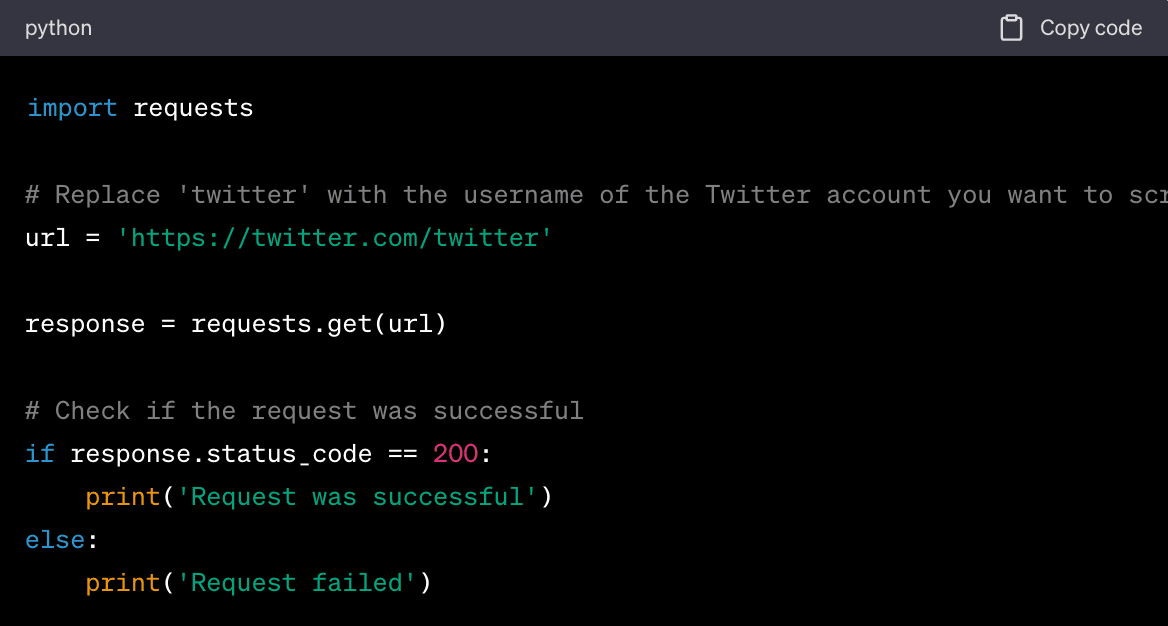
El servidor responde a la solicitud devolviendo el contenido HTML de la página web.
3. Analiza los datos. Dado que los datos están en formato HTML, necesitarás un analizador que pueda analizar y extraer los datos de interés.
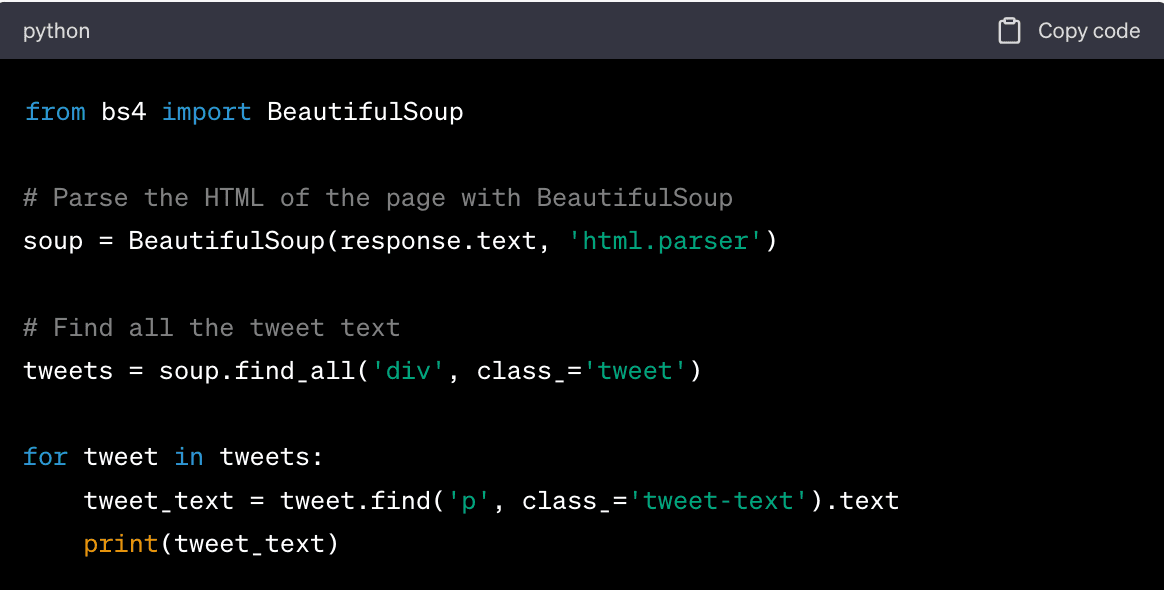
En este código, primero creamos un objeto BeautifulSoup y analizamos el HTML de la página. A continuación, buscamos todos los elementos div con la clase «tweet», que contienen los tuits. Para cada tuit, buscamos el elemento p con la clase «tweet-text», que contiene el texto del tuit, y lo mostramos en pantalla.
4. Utiliza métodos de consulta para encontrar elementos de datos específicos. Con BeautifulSoup, por ejemplo, puedes utilizar métodos como find_all() para localizar etiquetas de encabezado, párrafos u otros elementos.
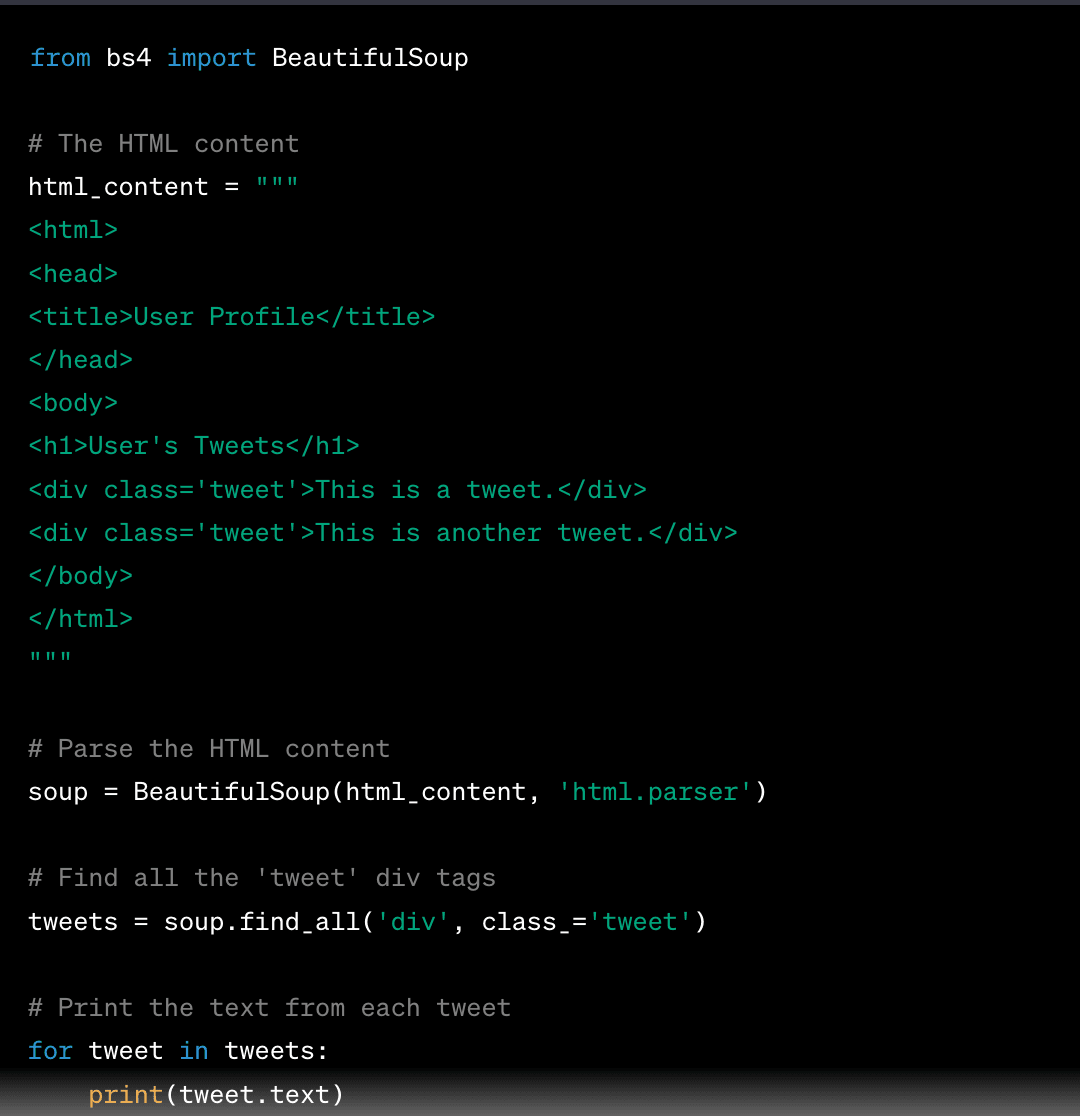
5. Guarda los datos en el formato que prefieras, como CSV, JSON o una base de datos. A continuación te mostramos cómo guardarlos en un archivo CSV utilizando la biblioteca Pandas:
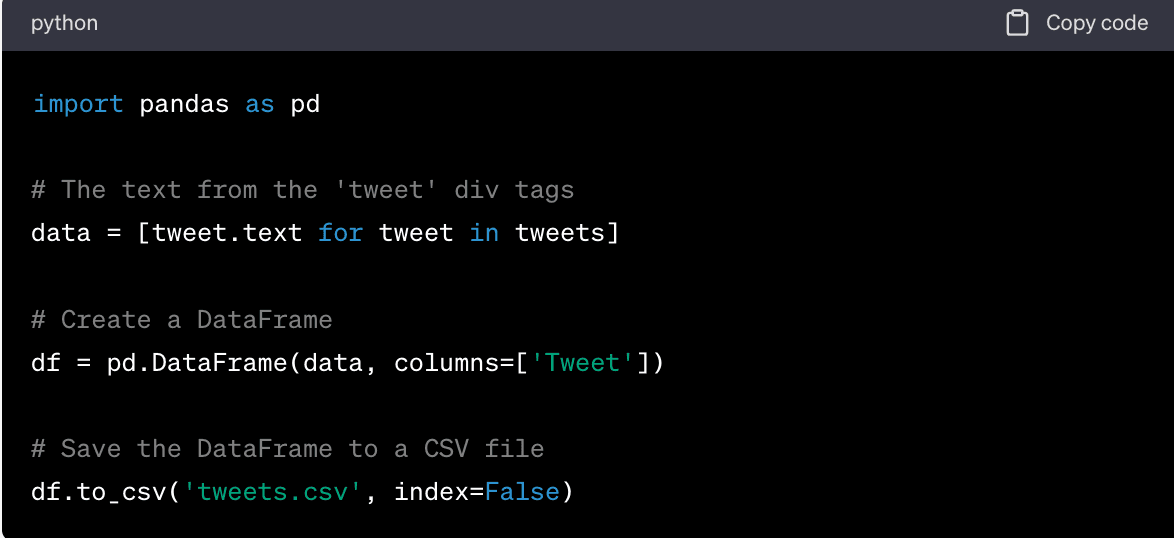
Esto creará un archivo CSV llamado «tweets.csv» con una única columna «Tweet» que contiene el texto de las etiquetas div «tweet». A continuación se muestra un ejemplo sencillo de cómo se puede extraer el texto de un tuit utilizando Python y BeautifulSoup:
3. Geonode
Scraper API
, de
Geonode
, es una potente herramienta que permite extraer datos de sitios web como Twitter. Ofrece diferentes modos de extracción para un rendimiento y una eficiencia óptimos.
¿Por qué utilizar el extractor Pay-As-You-Go
de Geonode
?
• Precios flexibles. El modelo «pay-as-you-go
» te permite pagar solo por lo que utilizas. Esto puede resultar más rentable que un modelo de suscripción, especialmente para un uso irregular o de bajo volumen.
• Escalabilidad. Este Scraper API
está diseñado para gestionar tareas de scraping tanto a pequeña como a gran escala. Esto significa que puedes ampliar tus tareas de scraping según sea necesario sin preocuparte por alcanzar los límites de uso.
• Facilidad de uso. El Scraper API
de Geonode
es fácil de usar, incluso para quienes no tienen conocimientos de programación. Ofrece una forma sencilla de extraer datos de Twitter.
• Funcionalidades avanzadas. Scraper API
de Geonode
ofrece una amplia gama de funcionalidades avanzadas, como renderización en JavaScript, ejecución de fragmentos de código JS personalizados, proxies rotativos, geolocalización y mucho más. Estas funcionalidades pueden resultar muy útiles para tareas de scraping complejas.
• Modos en tiempo real y de devolución de llamada. La API ofrece dos modos de scraping: el modo en tiempo real y el modo de devolución de llamada. Esto te proporciona flexibilidad a la hora de recibir los resultados del scraping.
Limitaciones del rastreador «Pay-As-You-Go
» de GeoNode
• Los costes pueden acumularse: Aunque el modelo «pay-as-you-go
» puede resultar rentable para un uso de bajo volumen, los costes pueden acumularse rápidamente en tareas de rastreo a gran escala. Es importante supervisar el uso para evitar cargos inesperados.
• Curva de aprendizaje: Aunque el servicio Scraper API
de GeoNode
está diseñado para ser fácil de usar, puede haber una curva de aprendizaje, especialmente para quienes se inician en el scraping web o en las API en general.
• **Dependencia del servicio de GeoNode
**: Al igual que con cualquier servicio de terceros, dependes del servicio de GeoNode
para tus tareas de scraping. Si surgiera algún problema con su servicio, esto podría afectar a tus tareas de scraping.
• Consideraciones legales y éticas: El web scraping puede situarse en una zona gris legal. Aunque la herramienta Scraper API
de GeoNode
facilita la extracción de datos, es importante asegurarse de que tus actividades de scraping cumplan con las condiciones de uso del sitio web del que extraes datos y con cualquier legislación pertinente en materia de privacidad.
Pasos para utilizar Geonode Scraper API para extraer datos de Twitter
1. Configura tu solicitud. Para utilizar GeoNode Scraper API, debes configurar una solicitud. Esta solicitud debe incluir la URL de la página de la que deseas extraer datos (en este caso, una página de Twitter) y un conjunto de configuraciones que controlen el comportamiento del extractor. A continuación se muestra un ejemplo de cómo estructurar tu solicitud:
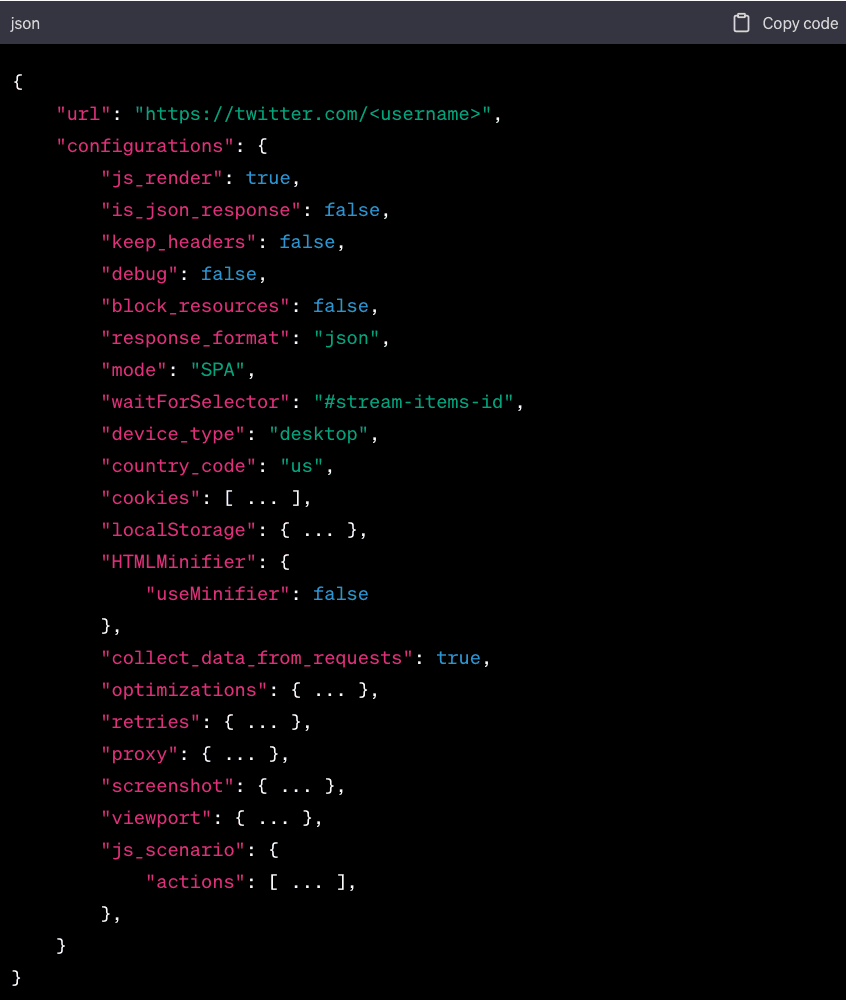
En este ejemplo, la URL es la página de Twitter que deseas extraer. El parámetro waitForSelector está establecido en #stream-items-id, que es el ID del elemento div que contiene los tuits en una página de Twitter. Esto indica al rastreador que espere a que se cargue este elemento antes de rastrear la página.
2. Modo en tiempo real y modo de devolución de llamada. GeoNode Scraper API ofrece dos modos de rastreo: el modo en tiempo real y el modo de devolución de llamada. En el modo en tiempo real, la API devuelve el resultado inmediatamente después de que finalice el rastreo. En el modo de devolución de llamada, la API envía el resultado a una URL de devolución de llamada especificada una vez finalizado el rastreo. Puedes elegir el modo que mejor se adapte a tus necesidades.
3. Comprueba el estado de tu tarea. Puedes comprobar el estado de tu tarea de rastreo utilizando el ID de solicitud que recibiste en la respuesta inicial. Esto te permite realizar un seguimiento del progreso de tu tarea y determinar si se ha completado.
4. Acciones. La API de extracción de datos de Google (Geonode) Scraper API te permite interactuar con el documento de destino a través de una lista de acciones compatibles. Por ejemplo, puedes utilizar acciones para hacer clic en un botón o rellenar un formulario en la página antes de realizar la extracción.
Análisis de datos de Twitter
Una vez que hayas extraído y almacenado los datos de Twitter, el siguiente paso es analizarlos. A continuación te ofrecemos una guía paso a paso:
**1. Análisis básico. **
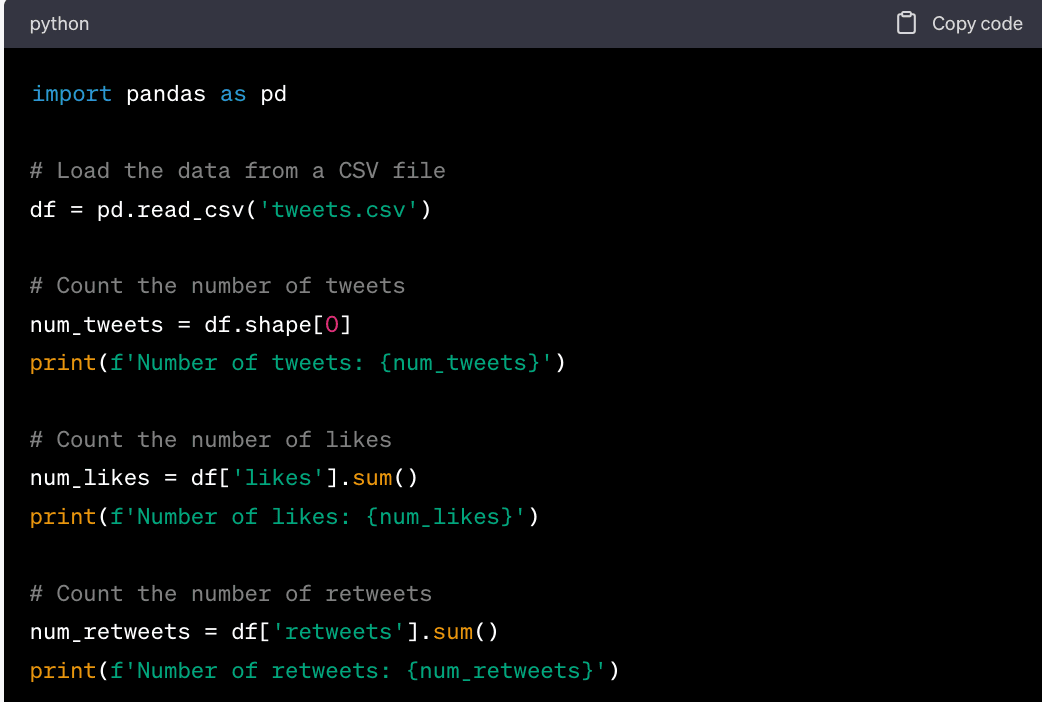
El análisis básico consiste en contar tuits, «me gusta», retuits y otras métricas sencillas. A continuación se muestra un ejemplo de cómo hacerlo utilizando pandas, una potente biblioteca de análisis de datos para Python:
2. Análisis de sentimiento
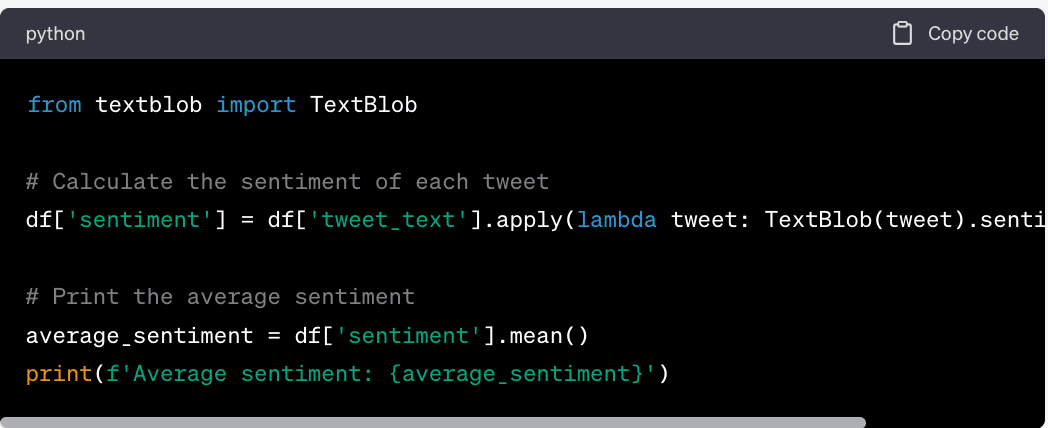
El análisis de sentimiento consiste en determinar el sentimiento de un fragmento de texto, como un tuit. A continuación se muestra un ejemplo de cómo hacerlo utilizando TextBlob, una biblioteca para el procesamiento de datos textuales:
3. Análisis de redes
El análisis de redes consiste en analizar las conexiones entre los usuarios de Twitter. Esto se puede hacer utilizando NetworkX, una biblioteca de Python para la creación, manipulación y estudio de la estructura, la dinámica y las funciones de redes complejas.
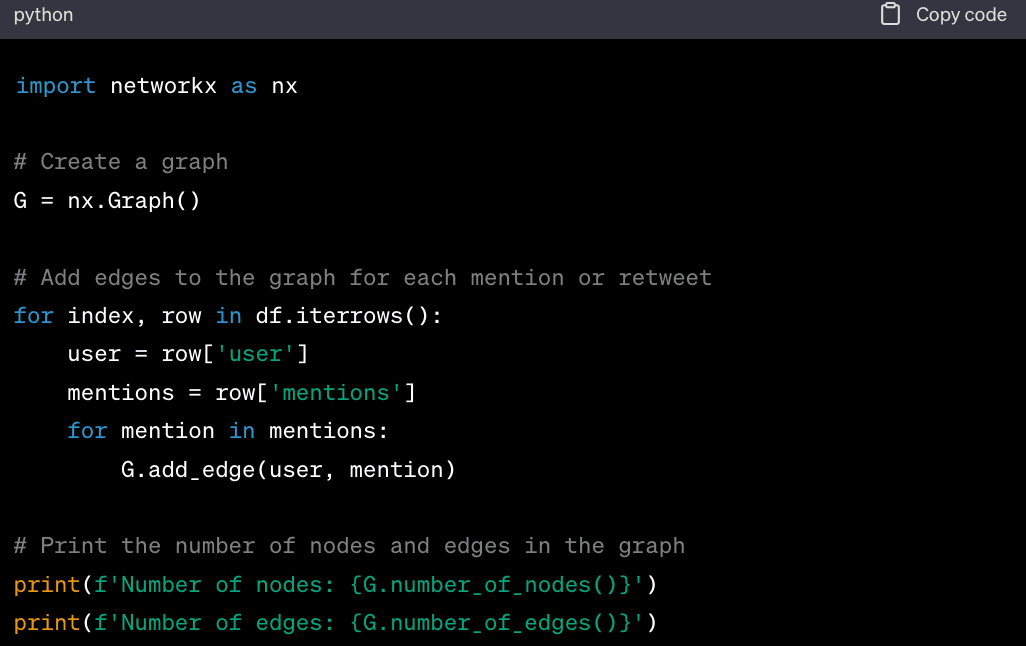
4. Visualización de datos de Twitter
Visualizar los datos de Twitter puede ayudarte a comprenderlos mejor. Esto se puede hacer utilizando Matplotlib, una biblioteca de gráficos para Python:
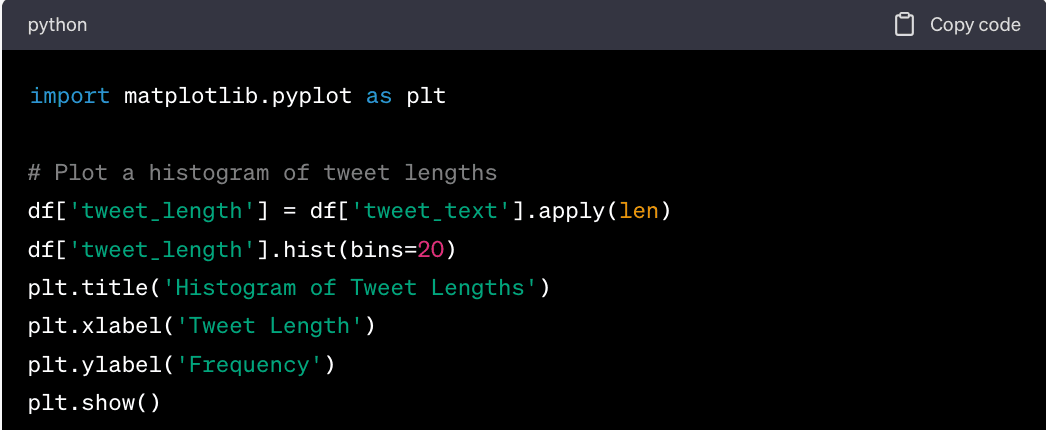
En este código, primero calculamos la longitud de cada tuit. A continuación, trazamos un histograma de las longitudes de los tuits, que muestra la distribución de las mismas.
Recuerda sustituir «tweets.csv» por la ruta a tu archivo CSV, y «tweet_text», «likes» y «retweets» por los nombres reales de las columnas de tu DataFrame. Asimismo, sustituye «user» y «mentions» por los nombres reales de las columnas correspondientes al usuario y a las menciones en tu DataFrame.
Conclusión
En esta guía exhaustiva, hemos analizado la importancia y los métodos para extraer datos de Twitter. Twitter, al ser un vasto repositorio de opinión pública, tendencias y enlaces, ofrece una gran cantidad de datos que pueden aprovecharse para diversos fines, desde estudios de mercado y análisis de opinión hasta la previsión de tendencias y mucho más.
Hemos profundizado en tres métodos principales para extraer estos datos:
-
La API de Twitter. Se trata de la vía oficial que ofrece Twitter para interactuar con sus datos. Es una herramienta potente, pero tiene sus propias limitaciones, como los límites de frecuencia y la necesidad de obtener la aprobación de una cuenta de desarrollador. Sin embargo, es una forma fiable y sencilla de acceder a los datos de Twitter, especialmente cuando se utiliza con bibliotecas como Tweepy.
-
Extracción de datos web con Python. Este método consiste en utilizar bibliotecas de Python como BeautifulSoup y requests para extraer datos directamente del sitio web de Twitter. Aunque este método puede eludir algunas de las limitaciones de la API de Twitter, es más complejo desde el punto de vista técnico y puede resultar más frágil debido a posibles cambios en la estructura del sitio web de Twitter.
-
Scraper de Pay-As-You-Go de GeoNode. Se trata de un servicio de terceros que ofrece una forma más flexible y potente de extraer datos de Twitter. Ofrece funciones avanzadas como la representación en JavaScript y la geolocalización, pero conlleva sus propios costes y requiere un uso prudente para evitar cargos inesperados.
Cada uno de estos métodos tiene sus propias ventajas e inconvenientes, y cuál es el más adecuado depende de tus necesidades específicas, tus conocimientos técnicos y tu presupuesto.
Para concluir, es fundamental destacar la importancia de realizar la extracción de datos de forma ética y responsable.
Aunque la extracción de datos de Twitter puede proporcionar información valiosa, es esencial respetar las condiciones de uso de Twitter, la privacidad de los usuarios de Twitter y cualquier legislación pertinente. Utiliza siempre los datos extraídos de forma responsable y, en caso de duda, busca asesoramiento jurídico.
Al conocer las herramientas y técnicas para extraer datos de Twitter, ahora estás preparado para aprovechar el potencial de los datos de Twitter en tus propios proyectos.

