¿Qué es la extracción de datos?
La extracción de datos consiste en obtener información de sitios web, bases de datos y documentos. Según IDC, el creciente volumen de datos, que se prevé que alcance los 175 zettabytes en 2025, hace que la extracción de datos sea fundamental. Por eso, muchas empresas automatizan su flujo de trabajo de extracción de datos utilizando API de web scraping, ya que les permite recopilar, procesar y analizar grandes cantidades de datos de forma eficiente. A través del web scraping, las empresas pueden acceder y analizar fácilmente los datos que necesitan para tomar decisiones más fundamentadas, impulsar el crecimiento y alcanzar el éxito en el mundo actual, impulsado por los datos.
Extracción de datos mediante ETL
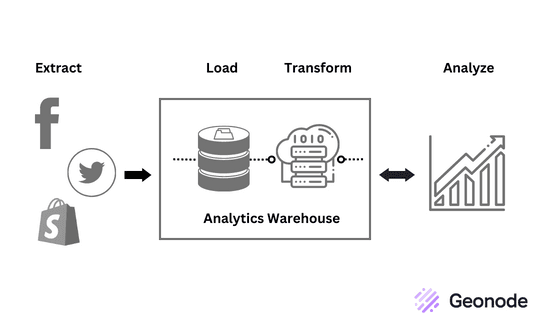
Extracción, transformación y carga (ETL) es un proceso que se utiliza para integrar y gestionar grandes cantidades de datos procedentes de diversas fuentes. Se trata de un proceso muy utilizado en la extracción de datos y el web scraping para recopilar, limpiar y organizar datos con fines de análisis.
El proceso ETL consta de tres etapas principales:
-
Extracción: La primera etapa consiste en extraer o recabar datos de diversas fuentes, como bases de datos, archivos o API. Los datos extraídos pueden ser estructurados, semiestructurados o no estructurados.
-
Transformación: La segunda etapa consiste en transformar los datos extraídos a un formato adecuado para el sistema de destino, como un almacén de datos o una herramienta de generación de informes. Esta etapa incluye la limpieza, el filtrado, la agregación y el enriquecimiento de los datos para garantizar su coherencia y precisión. También implica convertir los datos a un formato estándar de fácil comprensión.
-
Carga: La etapa final consiste en cargar los datos transformados en el sistema de destino para su posterior análisis y procesamiento. Los datos se cargan en una base de datos o en un almacén de datos, donde otras aplicaciones pueden consultarlos y analizarlos fácilmente.
Extracción de datos sin ETL
Aunque la extracción de datos puede realizarse al margen del proceso ETL, presenta limitaciones y debe utilizarse en consecuencia. Por ejemplo, si se extraen datos sin procesar sin una transformación y carga adecuadas, puede resultar complicado organizarlos y analizarlos, y pueden ser incompatibles con programas y aplicaciones más recientes. En consecuencia, estos datos podrían tener un valor limitado, salvo para fines de archivo.
Sin embargo, la extracción de datos sin ETL sigue siendo una excelente opción para las empresas que necesitan acceder rápidamente a datos procedentes de múltiples fuentes. También es una solución rentable, ya que elimina la necesidad de costosos programas y equipos de ETL.
Además, puede utilizarse para trasladar datos de un sistema a otro de forma rápida y sencilla sin necesidad de transformaciones complejas.
En función de tus necesidades y de los recursos disponibles, puedes encontrar varias técnicas alternativas de extracción de datos que no dependen del ETL tradicional.
Captura de datos modificados (CDC)
La captura de datos modificados (CDC) es un método de ETL que captura y almacena los cambios realizados en los datos de un sistema de origen para su análisis. A diferencia del ETL tradicional, que extrae conjuntos de datos completos, la CDC solo captura los cambios realizados en los datos desde la última extracción. Esto la convierte en un método más eficiente para extraer datos.
Interfaz de programación de aplicaciones (API)
Otro método de extracción de datos sin ETL es la API (Interfaz de programación de aplicaciones). Las API son un conjunto de protocolos y herramientas para crear aplicaciones de software. Con las API, los desarrolladores pueden extraer datos de un sistema de origen mediante programación y ponerlos a disposición en sus aplicaciones.
Muchas aplicaciones populares, como Google Maps y Twitter, ofrecen API que pueden utilizarse para la extracción de datos.
Web scraping
El web scraping es otro método para extraer datos sin ETL. Consiste en utilizar scripts automatizados para extraer datos de páginas web. Aunque el web scraping tiene algunas limitaciones, como la vulnerabilidad ante cambios en la estructura de la página web, puede ser una herramienta muy eficaz para extraer datos de sitios web.
Aunque el ETL es el método más utilizado para la extracción de datos, los métodos alternativos pueden resultar igual de eficaces. La captura de datos modificados (Change Data Capture), las API y el web scraping son opciones viables para extraer información de diversas fuentes. Es fundamental evaluar qué método se adapta mejor a un caso de uso concreto y mantenerse al día de las últimas técnicas y tecnologías para determinar cuál se ajusta mejor a tus necesidades.
Lee también: Conoce la diferencia entre un «web scraper» y un «web crawler»
Ventajas de la extracción de datos
Reduce los errores humanos
La extracción de datos automatiza el proceso de recopilación de datos, lo que minimiza la probabilidad de que se produzcan errores al introducir los datos manualmente. Como resultado, mejora la precisión y la coherencia de los datos.
Aumenta la productividad
La extracción de datos libera tiempo para que los empleados se centren en otras tareas, lo que aumenta su productividad. El proceso también es más rápido que la introducción manual de datos, lo que permite a las empresas procesar más datos en menos tiempo.
Permite tomar mejores decisiones empresariales
La extracción de datos proporciona a las empresas acceso a una gran cantidad de información, lo que les permite tomar decisiones basadas en datos. Esto se traduce en un mejor servicio al cliente, productos y servicios mejorados y un aumento de los ingresos.
Aporta visibilidad
La extracción de datos proporciona visibilidad sobre las operaciones empresariales, lo que permite a las empresas identificar ineficiencias, oportunidades de crecimiento y áreas de mejora.
Simplifica el intercambio
La extracción de datos permite a las empresas compartir fácilmente datos entre departamentos y partes interesadas externas, mejorando la colaboración y la comunicación.
Rentable
La extracción de datos es una solución rentable para las empresas, ya que elimina la necesidad de introducir datos manualmente y reduce la probabilidad de errores, que pueden resultar costosos.
Ahorro de tiempo
La extracción de datos automatiza la recopilación y el procesamiento de datos, lo que ahorra a las empresas un tiempo valioso para que puedan centrarse en otras tareas importantes.
Extracción de datos: casos de uso en el mundo real
La extracción de datos tiene varios casos de uso en el mundo real en distintos sectores. Estos son algunos de los casos de uso más comunes de la extracción de datos:
Seguimiento de la reputación
Las empresas necesitan supervisar su reputación en línea para proteger su marca. La extracción de datos ayuda a realizar un seguimiento de las menciones a la marca, identificar reseñas negativas y recopilar opiniones de los clientes para mejorar la imagen de la marca.
Investigación de mercado
La extracción de datos ayuda a las empresas a recopilar información sobre tendencias de mercado, comportamiento de los consumidores y conocimientos del sector. Esto se utiliza para tomar decisiones fundamentadas sobre el desarrollo de productos, las estrategias de marketing y la expansión empresarial.
Datos financieros
Las entidades financieras utilizan la extracción de datos para recopilar y analizar información procedente de diversas fuentes, como estados financieros, artículos de prensa e informes de mercado, con el fin de tomar decisiones de inversión fundamentadas e identificar tendencias de mercado.
Generación de clientes potenciales
La extracción de datos ayuda a generar clientes potenciales mediante la recopilación de información de contacto y otros datos relevantes de perfiles en redes sociales, sitios web de empresas y otras fuentes en línea.
Agregación de contenidos
Para crear noticias exhaustivas y actualizadas, las empresas de noticias y medios de comunicación utilizan la extracción de datos para recopilar información de diversas fuentes, como artículos de prensa, entradas de blog y redes sociales.
Análisis de opiniones
Las empresas utilizan la extracción de datos para supervisar la opinión de los clientes mediante la recopilación y el análisis de comentarios, reseñas y opiniones. Esto ayuda a las empresas a mejorar sus productos y servicios y a establecer mejores relaciones con los clientes.
Inteligencia de precios
Los minoristas utilizan la extracción de datos para recopilar información sobre los precios, las promociones y los descuentos de la competencia con el fin de ajustar sus propias estrategias de precios y obtener una ventaja competitiva.
Análisis del mercado laboral
Las agencias de selección de personal y las plataformas de empleo utilizan la extracción de datos para recopilar información sobre ofertas de trabajo, descripciones de puestos y competencias requeridas, lo que ayuda a quienes buscan empleo a encontrar ofertas relevantes y a las empresas a identificar candidatos potenciales.
Análisis de redes sociales
Las plataformas de redes sociales utilizan la extracción de datos para analizar el comportamiento y las preferencias de los usuarios, identificar a personas influyentes y ofrecer recomendaciones personalizadas a los usuarios.
Sector turístico
Las agencias de viajes y las plataformas de reservas utilizan la extracción de datos para recopilar información sobre vuelos, hoteles y destinos turísticos, lo que les permite ofrecer paquetes de viaje más personalizados a sus clientes.
Análisis de los diferentes tipos de datos extraídos
Durante la extracción de datos, se pueden extraer diferentes tipos de datos en función de la naturaleza de los mismos y del objetivo de la extracción. Veamos algunos de los tipos de datos que se extraen durante el proceso de extracción de datos.
Datos no estructurados
Los datos no estructurados son aquellos que no están organizados de una manera predefinida, como los correos electrónicos, las publicaciones en redes sociales o los documentos de texto. El análisis de los datos no estructurados puede resultar complicado, ya que carecen de una estructura coherente.
Sin embargo, con la ayuda de técnicas de procesamiento del lenguaje natural, los datos no estructurados pueden transformarse en un formato estructurado para facilitar el análisis y la toma de decisiones.
Datos estructurados
Los datos estructurados, por su parte, están organizados de forma predefinida, como en una hoja de cálculo o una base de datos. Los datos estructurados son más fáciles de analizar porque tienen una estructura coherente, lo que facilita su búsqueda, filtrado y agregación.
Los datos estructurados pueden clasificarse a su vez en diferentes tipos de datos, como datos de clientes, financieros y operativos.
Datos de clientes
Los datos de clientes incluyen información sobre los clientes, como sus datos demográficos, su historial de compras y sus preferencias. Los datos de clientes se utilizan para mejorar la interacción con los clientes, desarrollar campañas de marketing dirigidas y optimizar la experiencia del cliente.
Entre los ejemplos de fuentes de datos de clientes se incluyen las encuestas a clientes, la actividad en redes sociales y el análisis de sitios web.
Datos financieros
Los datos financieros se refieren a la información relacionada con las finanzas de una empresa, como los ingresos, los gastos y los márgenes de beneficio. Los datos financieros se utilizan para realizar un seguimiento del rendimiento financiero, identificar áreas de ahorro de costes y tomar decisiones financieras fundamentadas.
Entre los ejemplos de fuentes de datos financieros se incluyen el software de contabilidad, los estados financieros y los datos transaccionales.
Datos operativos
Los datos operativos se refieren a la información relacionada con las operaciones diarias de una empresa, como los niveles de inventario, la producción y las métricas de atención al cliente. Los datos operativos se utilizan para identificar áreas de mejora de los procesos, optimizar la asignación de recursos y mejorar la eficiencia general.
Entre las fuentes de datos operativos se incluyen los sensores de los equipos de fabricación, los sistemas de punto de venta y el software de asistencia técnica.
La extracción de datos puede generar diferentes tipos de datos, tanto estructurados como no estructurados. La extracción y el análisis de estos tipos de datos pueden proporcionar información valiosa para que las organizaciones tomen decisiones fundamentadas e impulsen el éxito empresarial.
Técnicas de extracción de datos
Existen dos tipos principales de métodos de extracción en los almacenes de datos: la extracción lógica y la extracción física.
Extracción lógica
La extracción lógica es un método de extracción de datos que consiste en utilizar reglas lógicas y transformaciones para extraer datos de diversas fuentes e integrarlos en un formato común dentro de un almacén de datos. Existen tres métodos principales de extracción lógica: notificación de actualizaciones, extracción incremental y extracción completa.
Notificación de actualizaciones
Este método consiste en extraer únicamente los datos que se han actualizado en el sistema de origen desde la última extracción. El sistema de origen notifica los cambios al almacén de datos y solo se extraen los datos actualizados. Resulta útil cuando se requiere una integración de datos en tiempo real y solo se necesitan los datos más recientes para el análisis.
Extracción incremental
Consiste en extraer únicamente los datos que se han añadido, actualizado o eliminado en el sistema fuente desde la última extracción. La extracción se basa en una marca de tiempo o un indicador que señala cuándo se modificaron los datos por última vez. Se suele utilizar cuando hay un volumen significativo de datos y no resulta práctico extraer todos los datos en cada ocasión.
Extracción completa
La extracción completa consiste en extraer todos los datos del sistema de origen, independientemente de si han cambiado o no desde la última extracción. Cuando el volumen de datos es reducido o el sistema de origen es relativamente estable, y el almacén de datos necesita una copia completa de los datos de origen, el método de extracción completa es el más adecuado.
Extracción física
Por otro lado, la extracción física es otro método de extracción de datos en el almacenamiento de datos que consiste en copiar o trasladar físicamente los datos del sistema de origen al almacén de datos. La extracción física cuenta con dos métodos principales: la extracción en línea y la extracción fuera de línea.
Extracción en línea
La extracción en línea consiste en extraer datos del sistema de origen mientras este sigue en funcionamiento. Resulta útil cuando se necesitan los datos en tiempo real y no es posible desconectar el sistema de origen. Sin embargo, el proceso de extracción puede afectar al rendimiento del sistema de origen, lo cual es un factor importante a tener en cuenta a la hora de elegir este método.
Extracción fuera de línea
Consiste en extraer datos del sistema de origen cuando este no está en funcionamiento. Se utiliza a menudo cuando los datos pueden extraerse durante períodos de baja actividad o cuando no es necesario extraerlos en tiempo real. El proceso de extracción no afecta al rendimiento del sistema de origen, lo cual supone una gran ventaja en comparación con la extracción en línea.
En general, estos métodos tienen sus ventajas e inconvenientes. La elección de un método depende de las necesidades específicas de su empresa y de la naturaleza de los datos que se extraen. Seleccionar cuidadosamente el método adecuado garantiza que los datos de su almacén de datos sean precisos, estén actualizados y estén disponibles para su análisis.
Extracción de datos frente a minería de datos
Al igual que la extracción de datos, la minería de datos es otro paso fundamental en el análisis y la utilización de grandes cantidades de datos. Sin embargo, aunque ambas se utilizan para extraer información valiosa y conocimientos a partir de los datos, existen diferencias significativas entre ambas.
Extracción de datos
La extracción de datos es el proceso de extraer datos de diversas fuentes y consolidarlos en una ubicación central, como un almacén de datos.
Esto implica identificar las fuentes de datos relevantes, aplicar técnicas de limpieza y transformación de datos, y cargar los datos en una base de datos centralizada. El objetivo de la extracción de datos es crear una copia completa y precisa de los datos a la que se pueda acceder y analizar fácilmente.
Minería de datos
Por otro lado, la minería de datos es el proceso de descubrir patrones, tendencias y conocimientos a partir de los datos que se han extraído.
Este proceso implica el uso de análisis estadísticos y técnicas de aprendizaje automático para identificar correlaciones, clasificaciones y otra información que permita tomar decisiones empresariales fundamentadas.
La minería de datos tiene como objetivo convertir los datos brutos en conocimiento útil y emplearlo para mejorar el rendimiento empresarial y obtener una ventaja competitiva.
En pocas palabras, la extracción de datos es el proceso de obtener datos de diversas fuentes y reunirlos todos en un único lugar. Por el contrario, la minería de datos analiza esos datos para encontrar patrones e información significativa.
Ambos son pasos esenciales en el análisis de datos y, a menudo, se utilizan conjuntamente para ofrecer una visión global de los datos de una empresa.
Mediante el uso de estas técnicas, las empresas pueden obtener información valiosa sobre sus clientes, sus operaciones y las tendencias del mercado, lo que puede ayudarles a tomar mejores decisiones y a mantenerse por delante de la competencia.
Diferentes tipos de herramientas de extracción de datos
Las herramientas de extracción de datos son aplicaciones de software que facilitan la extracción de datos de diversas fuentes y su consolidación en una ubicación central, como un almacén de datos. Estas herramientas están diseñadas para automatizar el proceso de extracción de datos y hacerlo más eficiente y preciso.
En el mercado existen diferentes tipos de herramientas de extracción de datos, cada una con sus propias características y ventajas. A continuación se presentan tres tipos habituales:
Herramientas de procesamiento por lotes
Estas herramientas están diseñadas para extraer datos de grandes volúmenes de archivos o documentos de forma por lotes. Las herramientas de procesamiento por lotes resultan útiles cuando es necesario extraer datos de múltiples archivos o documentos con una estructura similar.
Entre los ejemplos de herramientas de procesamiento por lotes se incluyen Talend Open Studio, Apache NiFi y Alteryx.
Herramientas de código abierto
Estas aplicaciones de software están disponibles de forma gratuita y los usuarios pueden modificarlas y personalizarlas. Las herramientas de extracción de datos de código abierto son populares entre las pequeñas y medianas empresas con presupuestos limitados y entre aquellas que no pueden adquirir software comercial costoso.
Algunos ejemplos de herramientas de extracción de datos de código abierto son Apache Kafka, Apache Flume y Pentaho Data Integration.
Herramientas basadas en la nube
Las herramientas basadas en la nube se alojan en la nube y se puede acceder a ellas a través de un navegador web. Puedes utilizar herramientas de extracción de datos basadas en la nube cuando necesites extraer datos de fuentes remotas o cuando quieras colaborar con otros miembros del equipo que se encuentren en diferentes ubicaciones geográficas.
Algunos ejemplos de herramientas de extracción de datos basadas en la nube son AWS Glue, Azure Data Factory y Google Cloud Dataflow.
Las herramientas de extracción de datos son fundamentales en el proceso de análisis de datos, ya que ayudan a las empresas a consolidar y analizar datos procedentes de diversas fuentes. Recuerda que elegir la herramienta de extracción de datos adecuada puede marcar una gran diferencia en la eficiencia y la precisión de tus tareas de análisis de datos.
Las mejores herramientas de extracción de datos
Las herramientas de extracción de datos pueden ser de muy diversos tipos y tamaños. Tanto si necesitas extraer datos de páginas web, documentos o plataformas de redes sociales, existe una herramienta que te ayudará a automatizar el proceso y a obtener información valiosa a partir de tus datos.
Scrapestorm
Scrapestorm es una herramienta de web scraping que ayuda a los usuarios a extraer datos de diversos sitios web. Está diseñada para automatizar el proceso de web scraping y facilita la recuperación de datos a los usuarios sin experiencia en programación. Scrapestorm puede extraer datos de tablas, gráficos y mapas, así como de archivos PDF e imágenes. Su interfaz intuitiva y sus opciones de personalización flexibles la convierten en una opción muy popular entre empresas de todos los tamaños.
Altair Monarch
Altair Monarch es una herramienta de extracción de datos que permite a los usuarios extraer datos de diversas fuentes, incluidos archivos PDF, hojas de cálculo y bases de datos. Utiliza algoritmos de aprendizaje automático para identificar y extraer datos automáticamente de documentos no estructurados, lo que ayuda a reducir el esfuerzo manual necesario para la extracción de datos. Como resultado, Altair Monarch resulta especialmente útil para empresas que extraen datos de forma habitual de grandes volúmenes de documentos.
Klippa
Klippa, una herramienta de extracción de datos basada en OCR, automatiza el procesamiento de documentos. Puede extraer datos de diversos documentos, como facturas, recibos y contratos. Utiliza algoritmos de aprendizaje automático para reconocer y extraer datos de estos documentos y exporta los datos extraídos a diversos formatos, como Excel, JSON y XML. Klippa resulta especialmente útil para empresas que necesitan extraer datos de grandes volúmenes de documentos en un breve periodo de tiempo.
NodeXL
NodeXL es una herramienta de análisis y visualización de datos para redes sociales. Permite a los usuarios extraer datos de diversas plataformas de redes sociales, como Twitter, Facebook y LinkedIn, y visualizarlos en gráficos y tablas. NodeXL resulta especialmente útil para empresas que necesitan analizar el comportamiento de sus clientes y competidores en las redes sociales. Goza de gran popularidad entre muchas empresas gracias a su interfaz intuitiva y a sus funciones avanzadas.
¿Por qué resulta tan complicada la extracción de datos?
Aunque es una parte fundamental del proceso de análisis de datos, la extracción de datos también plantea varios retos que pueden dificultar a las empresas la tarea de extraer y utilizar los datos de forma eficaz. A continuación se enumeran algunos de los principales retos de la extracción de datos:
Problemas de formato de los datos
Los datos pueden presentarse en diversos formatos y estructuras, lo que dificulta su extracción y estandarización. Pueden estar incompletos, ser incoherentes o contener errores, lo que requiere un exhaustivo proceso de limpieza y transformación de los datos.
Preocupaciones relacionadas con la seguridad de los datos
La extracción de datos puede suponer riesgos de seguridad si se trata de información sensible o confidencial. Las empresas deben adoptar las medidas adecuadas para garantizar la seguridad de los datos durante su extracción y transferencia.
Limitaciones técnicas
La extracción de datos puede resultar complicada si estos se almacenan en sistemas heredados o en diferentes fuentes de datos. Puede requerir conocimientos técnicos especializados o herramientas de software para extraer e integrar datos procedentes de múltiples fuentes.
Cumplimiento normativo
La extracción de datos debe cumplir con los requisitos legales y normativos, como las leyes de protección de datos, por ejemplo, el RGPD y la CCPA. El incumplimiento de estas normativas puede acarrear multas cuantiosas y daños a la reputación.
Para superar estos retos es necesario adoptar un enfoque estratégico de la extracción de datos, que incluya el uso de herramientas y técnicas avanzadas, así como un compromiso con la calidad y la seguridad de los datos. Al abordar estos retos, las empresas pueden aprovechar todo el potencial de sus datos y obtener una ventaja competitiva en el mercado.
Buenas prácticas para la extracción de datos
La extracción de datos es un paso crucial en el análisis de datos, por lo que es esencial seguir las buenas prácticas para garantizar la precisión, la calidad y el éxito.
Identificar las fuentes de datos
Empieza por identificar todas las fuentes de datos relevantes y comprender la estructura de los datos. Esto te ayudará a evitar perder datos esenciales y malgastar recursos en fuentes de datos irrelevantes.
Limpiar y preprocesar los datos
Para garantizar la precisión y la coherencia, limpia y preprocesa los datos antes de la extracción. La limpieza y el preprocesamiento de los datos pueden ayudar a identificar y eliminar incoherencias, errores y valores atípicos que puedan afectar a la calidad de los datos extraídos.
Almacenar y realizar copias de seguridad de los datos
Almacenar y realizar copias de seguridad de los datos es fundamental para garantizar que sean accesibles y estén seguros. Las soluciones de almacenamiento de datos, como los servicios basados en la nube, ofrecen flexibilidad y escalabilidad, y pueden ayudar a proteger los datos contra pérdidas o daños.
Proteger los datos
Implemente medidas de seguridad sólidas, como el cifrado de datos, los controles de acceso y las auditorías de seguridad periódicas. La seguridad de los datos debe ser una prioridad absoluta para proteger la información confidencial y evitar filtraciones de datos.
Conclusión
La extracción de datos puede resultar complicada, pero con las herramientas y técnicas adecuadas, puede ser fácil y accesible incluso para principiantes. En esta guía para principiantes hemos abordado los conceptos básicos de la extracción de datos, desde la definición del término hasta el análisis de los diferentes métodos y herramientas disponibles.
El futuro de la extracción de datos es prometedor, ya que asistimos a avances en el aprendizaje automático y la inteligencia artificial que permiten una extracción de datos más eficiente y precisa a partir de diversas fuentes. A medida que la cantidad de datos disponibles siga creciendo, surgirán preguntas como: ¿de qué tipos de big data podemos extraer valor? y ¿cómo lo haremos? En consecuencia, dominar la extracción de datos se convertirá en una habilidad cada vez más importante, tanto para las empresas como para los particulares.
Es fundamental abordar la extracción de datos con una comprensión clara de los objetivos y las necesidades de tu proyecto, así como con la disposición a experimentar con diferentes herramientas y métodos para encontrar lo que mejor funciona. Siguiendo los consejos y técnicas descritos en esta guía, estarás bien encaminado para extraer y utilizar con éxito datos valiosos.
Preguntas frecuentes - FAQ:
¿Qué significa «extracción de datos»?
La extracción de datos es el proceso de recuperar datos de diversas fuentes, como bases de datos, sitios web o aplicaciones, y transformarlos en un formato apto para su análisis. Los datos extraídos pueden utilizarse posteriormente para obtener información útil y facilitar la toma de decisiones.
¿Cuál es un ejemplo de extracción de datos?
Un ejemplo de extracción de datos es la recopilación de información sobre productos de un sitio web de comercio electrónico. El proceso de extracción consiste en identificar los campos de datos relevantes, como el nombre del producto, el precio y la descripción, y recuperar los datos mediante herramientas de web scraping o API.
¿Para qué se utiliza la extracción de datos?
La extracción de datos se utiliza para recuperar datos de múltiples fuentes con el fin de respaldar diversas funciones empresariales, como el análisis de datos, la elaboración de informes y la toma de decisiones. Esto se empleará para generar conocimientos, desarrollar modelos predictivos y mejorar las operaciones y estrategias empresariales.
¿Cuáles son las técnicas de extracción de datos?
Existen varias técnicas de extracción de datos, como el web scraping, la integración de API y las consultas a bases de datos. El web scraping consiste en extraer datos de sitios web mediante herramientas automatizadas, mientras que la integración de API permite recuperar datos de aplicaciones basadas en la web. Las consultas a bases de datos son el proceso de recuperar datos de bases de datos estructuradas mediante consultas SQL.
Referencias
(26 de mayo de 2020). Técnicas de extracción de datos. Rosoka.
https://www.rosoka.com/blog/data-extraction-techniques
(12 de agosto de 2022). ¿Cuál es la diferencia entre la minería de datos y la extracción de datos? AmyGB.ai.
https://www.amygb.ai/blog/difference-between-data-mining-and-data-extraction
(12 de noviembre de 2022). ¿Qué es la extracción de datos? ¿Por qué es importante? The ECM Consultant.
https://theecmconsultant.com/what-is-data-extraction
(s. f.). ETL: extraer, transformar, cargar. Talend.
https://www.talend.com/resources/what-is-etl/
(s. f.). Tipos de herramientas ETL. Dremio.
https://www.dremio.com/resources/guides/adv-types-etl-tools/
(s. f.). ¿Qué son las API y cómo funcionan? MuleSoft.
https://www.mulesoft.com/api-university/what-are-apis-and-how-do-they-work
(s. f.). ¿Qué es la captura de datos modificados (CDC)? Qlik.
https://www.qlik.com/us/change-data-capture/cdc-change-data-capture
(s. f.). ¿Qué es la extracción de datos? Docparser.
https://docparser.com/blog/what-is-data-extraction/
(s. f.). ¿Qué es ETL (Extract, Transform, Load)? Oracle.
https://www.oracle.com/ph/integration/what-is-etl/
Deshpande, I. (16 de marzo de 2021). ¿Qué son los datos de clientes? Definición, tipos, recopilación, validación y análisis. Spiceworks.
https://www.spiceworks.com/marketing/customer-data/articles/what-is-customer-data/
Eteng, O. (27 de enero de 2023). ¿Qué es la extracción de datos? Todo lo que necesitas saber. Hevo Data.
https://hevodata.com/learn/data-extraction/#usecase
Hillier, W. (13 de agosto de 2021). ¿Qué es el web scraping y cómo se utiliza? CareeerFoundry.
https://careerfoundry.com/en/blog/data-analytics/web-scraping-guide/
IBM Cloud Education (29 de junio de 2021). Datos estructurados frente a datos no estructurados: ¿cuál es la diferencia? IBM.
https://www.ibm.com/cloud/blog/structured-vs-unstructured-data

