Pourquoi extraire des données de Twitter ?
Les données de Twitter, de par leur caractère en temps réel et la vaste quantité d’opinions publiques qu’elles recèlent, peuvent être utilisées de multiples façons dans divers domaines, tels que :
• Surveillance de la marque. Les entreprises peuvent utiliser les données de Twitter pour surveiller en temps réel ce qui se dit à propos de leur marque. Cela peut les aider à répondre rapidement aux réclamations ou aux demandes des clients, à suivre l’efficacité de leurs campagnes marketing et à comprendre le sentiment du public à l’égard de leur marque. Par exemple, une hausse soudaine des sentiments négatifs à l’égard d’un produit pourrait indiquer un problème qu’il faut résoudre rapidement.
• Analyse des tendances. Twitter est souvent le lieu où les nouvelles tendances apparaissent en premier, ce qui en fait une ressource précieuse pour l’analyse des tendances. En analysant le contenu des tweets, les entreprises peuvent identifier les tendances émergentes dans leur secteur, suivre la popularité de certains sujets au fil du temps et même prédire les tendances futures. Ces informations peuvent orienter la stratégie d’entreprise, du développement de produits au marketing et aux ventes.
• Recherche universitaire. Les chercheurs dans des domaines tels que la sociologie, la linguistique et les sciences politiques peuvent utiliser les données de Twitter à des fins diverses. Par exemple, ils peuvent analyser les tweets des utilisateurs pour étudier l’usage de la langue, examiner la diffusion de l’information ou de la désinformation, ou encore étudier la réaction du public face à certains événements ou à certaines politiques.
• Journalisme. Les journalistes peuvent utiliser les données de Twitter pour dénicher des informations de dernière minute, suivre l’évolution des sujets d’actualité et évaluer l’opinion publique sur diverses questions. Dans certains cas, les tweets eux-mêmes peuvent devenir des sujets d’actualité. Par exemple, les tweets de personnalités publiques peuvent avoir un impact significatif et font souvent l’objet de reportages dans les médias.
Ce ne sont là que quelques exemples de la manière dont les données issues de milliards de tweets peuvent être utilisées. Les possibilités sont vastes et ne cessent de s’étendre à mesure que de plus en plus de personnes délaissent d’autres plateformes de réseaux sociaux au profit de Twitter pour partager leurs réflexions et leurs expériences.
Comprendre les données Twitter
Avant de se plonger dans les méthodes d’extraction de données sur Twitter, il est essentiel de comprendre les quatre types de données disponibles sur Twitter et les informations potentielles qui peuvent en être tirées.
• Tweets. Un tweet est l’unité d’information la plus élémentaire sur Twitter. Il s’agit d’un message publié par un utilisateur et pouvant contenir jusqu’à 280 caractères. Chaque tweet recèle une mine de données, notamment son contenu, l’heure à laquelle il a été publié, le nombre de « j’aime » et de retweets qu’il a reçus, ainsi que les hashtags utilisés. L’analyse des données des tweets permet de mieux cerner les sujets tendance, le sentiment à l’égard d’un sujet particulier, la portée d’un hashtag, et bien plus encore.
• Utilisateurs. Les données relatives aux utilisateurs désignent les informations liées aux comptes Twitter. Elles comprennent le nom d’utilisateur, la description du profil, la localisation, le nombre d’abonnés et d’abonnements, le nombre de tweets, ainsi que la date de création du compte. En analysant les données des utilisateurs, vous pouvez obtenir des informations sur les caractéristiques démographiques d’une base d’utilisateurs, identifier des influenceurs dans un domaine particulier ou suivre la croissance d’un compte Twitter au fil du temps.
• Entités. Les entités dans les données Twitter désignent les éléments associés à un tweet. Cela inclut les hashtags, les mentions d’utilisateurs, les URL et les médias (photos et vidéos). Les entités permettent de comprendre le contexte d’un tweet. Par exemple, l’analyse des hashtags associés à un tweet peut aider à identifier les sujets abordés, tandis que l’examen des mentions d’utilisateurs peut révéler le réseau d’interactions.
• Lieux. Ces données désignent les informations géographiques associées à un tweet ou à un utilisateur. Il peut s’agir du lieu d’où un tweet a été publié ou de la localisation indiquée dans le profil d’un utilisateur. L’analyse des données relatives aux lieux peut fournir des informations sur les tendances géographiques, la diffusion de l’information d’un lieu à l’autre ou la popularité d’un sujet dans différentes régions.
Chaque type de données revêt une importance qui lui est propre et peut fournir des informations uniques. Par exemple, les données relatives aux tweets peuvent aider à identifier les sujets tendance et le sentiment du public, les données sur les utilisateurs peuvent révéler les influenceurs et les caractéristiques démographiques de l’audience, les entités peuvent fournir un contexte aux discussions, et les données de localisation peuvent mettre en lumière des tendances géographiques.
En comprenant et en analysant ces types de données, vous pouvez exploiter une mine d’informations issues de Twitter. Que ce soit pour des études de marché, la veille de marque, la recherche universitaire ou le journalisme, les données Twitter constituent une ressource riche et dynamique pour comprendre l’opinion publique, suivre les tendances et prendre le pouls des conversations mondiales.
Comment extraire des données de Twitter : trois méthodes
1. L’API Twitter
L’API officielle de Twitter permet aux développeurs d’interagir avec sa plateforme par programmation. L’API donne accès à divers types de données, notamment les tweets, les profils Twitter et bien plus encore.
Pourquoi utiliser l’API Twitter ?
• Données structurées. Les données renvoyées par l’API sont bien structurées et cohérentes, ce qui facilite leur traitement et leur analyse.
• Fiabilité. L’API étant fournie par Twitter lui-même, elle garantit la fiabilité et la continuité du service.
• Documentation complète. Twitter fournit une documentation exhaustive sur son API, ce qui permet aux développeurs de mieux la comprendre et de l’utiliser efficacement.
Limitations de l’API Twitter
• Limites de fréquence. Afin d’éviter tout abus, Twitter impose des limites d’utilisation de son API sur une période donnée. Par exemple, il n’est possible d’effectuer que 900 requêtes toutes les 15 minutes pour consulter le fil d’actualité d’un utilisateur avec une application authentifiée par l’utilisateur.
• Accès aux données. Toutes les données ne sont pas accessibles via l’API. Par exemple, vous ne pouvez accéder qu’aux 3 200 tweets les plus récents du fil d’actualité d’un utilisateur.
• Coûts. Bien que Twitter propose un niveau d’accès gratuit à son API, celui-ci s’accompagne de limitations importantes. L’accès à davantage de données et à des limites de débit plus élevées nécessite un abonnement payant, qui peut s’avérer assez coûteux.
Étapes à suivre pour utiliser l’API de Twitter afin d’extraire des données :
L’API de Twitter est un outil puissant qui permet aux développeurs d’accéder à un large éventail de données Twitter par programmation. Voici un guide étape par étape pour l’utiliser :
1. Créer un compte développeur
• Rendez-vous sur le site des développeurs de Twitter (https://developer.twitter.com/
).
• Cliquez sur le bouton « Apply ».
• Vous serez invité à vous connecter à votre compte Twitter. Si vous n’en avez pas, vous devrez en créer un.
• Une fois connecté, remplissez le formulaire de demande pour créer un compte développeur. Ce formulaire vous demande des précisions sur la manière dont vous comptez utiliser l’API. Soyez aussi précis que possible pour augmenter vos chances d’obtenir l’approbation.
• Après avoir envoyé votre demande, attendez la validation de Twitter. Cela peut prendre quelques jours, alors soyez patient.
2. Créer une application et obtenir des clés API
• Connectez-vous à votre compte développeur Twitter.
• Rendez-vous sur le « Tableau de bord » et cliquez sur « Créer une application ».
• Remplissez le formulaire en indiquant les informations relatives à votre application. Indiquez un nom, une description, l’URL du site web et expliquez à Twitter comment vous comptez utiliser l’application.
• Notez les clés API qui s’affichent sur la page une fois votre application créée. Il existe deux jeux de clés : la clé API et le secret API, ainsi que le jeton d’accès et le secret d’accès. Vous aurez besoin de ces clés pour authentifier votre application lorsque vous utiliserez l’API.
3. Utilisez Tweepy pour accéder à l’Scraper API
Twitter
Suivez ces étapes :
• Importez la bibliothèque Tweepy.
• Authentifiez-vous sur Twitter à l’aide de vos clés API.
• Créez un objet API que vous pourrez utiliser pour interagir avec l’API de Twitter.
• Utilisez la méthode user_timeline pour récupérer les tweets les plus récents du fil d’actualité d’un utilisateur (dans ce cas, « twitter ») et affichez le texte de chaque tweet.
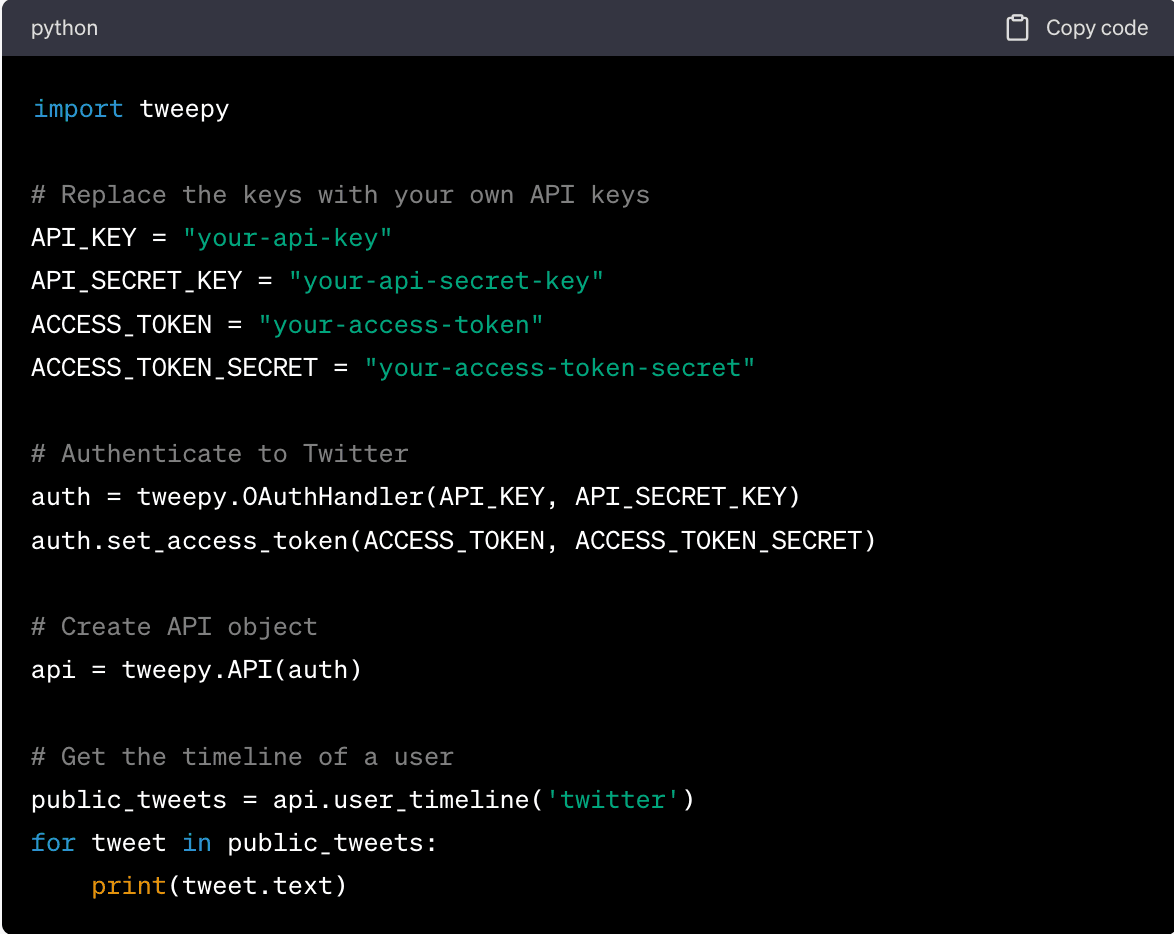
N’oubliez pas de remplacer « your-api-key », « your-api-secret-key », « your-access-token » et « your-access-token-secret » par vos propres clés API. Remplacez également « twitter » par le nom d’utilisateur du compte Twitter dont vous souhaitez récupérer les tweets.
Il s’agit là d’un exemple simple, mais Tweepy propose de nombreuses autres méthodes pour accéder à différents types de données Twitter. Consultez la documentation de Tweepy pour plus d’informations.
En résumé, bien que l’API Twitter offre un moyen fiable et structuré d’accéder aux données Twitter, elle comporte des contraintes en termes de limites de débit, d’accès aux données et de coûts. Ces limitations peuvent constituer un obstacle majeur pour les projets d’extraction de données à grande échelle. Dans de tels cas, le web scraping peut s’avérer une alternative plus flexible et plus économique, que nous aborderons dans la section suivante.
2. Le web scraping de Twitter avec Python
Le web scraping de Twitter avec Python consiste à extraire automatiquement des données du site web de Twitter à l’aide du langage de programmation Python. Ce processus est souvent utilisé pour recueillir de grandes quantités de données sur Twitter, dont la collecte manuelle prendrait trop de temps.
Pourquoi utiliser Python ?
• Des bibliothèques puissantes. Python dispose d’un riche écosystème de bibliothèques qui simplifient le web scraping. Des bibliothèques telles que Tweepy, BeautifulSoup et Scrapy permettent de gérer toutes les étapes, de l’envoi de requêtes HTTP à l’analyse du code HTML, en passant par l’interaction avec les API.
• Facilité d’utilisation. La syntaxe de Python est claire et concise, ce qui en fait un langage idéal pour le web scraping. Même les tâches de scraping complexes peuvent être réalisées avec relativement peu de lignes de code.
• Outils d’analyse de données. Python est également très efficace pour analyser les données. Des bibliothèques telles que Pandas, Numpy et Matplotlib facilitent le nettoyage, l’analyse et la visualisation des données extraites.
• Soutien de la communauté. Python dispose d’une communauté vaste et active qui permet de trouver très facilement de l’aide et des ressources en ligne. Si vous rencontrez un problème, il y a de fortes chances que quelqu’un d’autre l’ait déjà résolu.
Limites de Python
• Contenu dynamique. Les outils standard de scraping web de Python ont du mal à gérer le contenu dynamique chargé via JavaScript. Il existe des solutions pour contourner ce problème, comme l’utilisation d’une bibliothèque telle que Selenium, mais cela ajoute une couche supplémentaire de complexité au projet de scraping de Twitter.
• Limitation de débit. Twitter impose des limites de débit pour son API, ce qui peut ralentir votre projet de web scraping. Bien qu’il existe des moyens de contourner cette limitation, comme l’utilisation de plusieurs comptes ou adresses IP, ces méthodes sont contraires aux conditions d’utilisation de Twitter.
• Modifications de la structure du site web. Si Twitter modifie la structure de son site web ou de son API, votre code de scraping risque de ne plus fonctionner. Vous devrez alors mettre à jour votre code pour tenir compte de ces changements, ce qui peut prendre beaucoup de temps.
Étapes pour utiliser Python dans le cadre d’un projet de scraping de Twitter :
1. Configurer l’environnement. Installez Python et les bibliothèques nécessaires si vous ne les avez pas déjà. Pour les besoins de cet exemple, nous utiliserons BeautifulSoup et Requests.
2. Envoyez une requête HTTP à la page Twitter que vous souhaitez extraire.
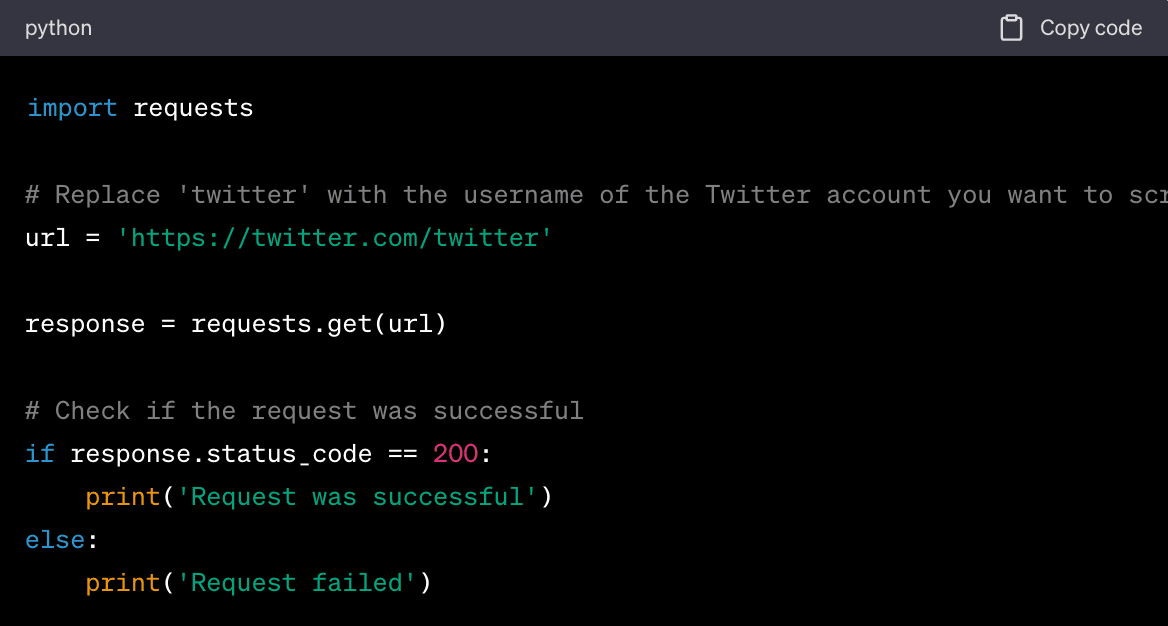
Le serveur répond à la requête en renvoyant le contenu HTML de la page Web.
3. Analysez les données. Les données étant au format HTML, vous aurez besoin d’un analyseur capable de les analyser et d’extraire les informations qui vous intéressent.
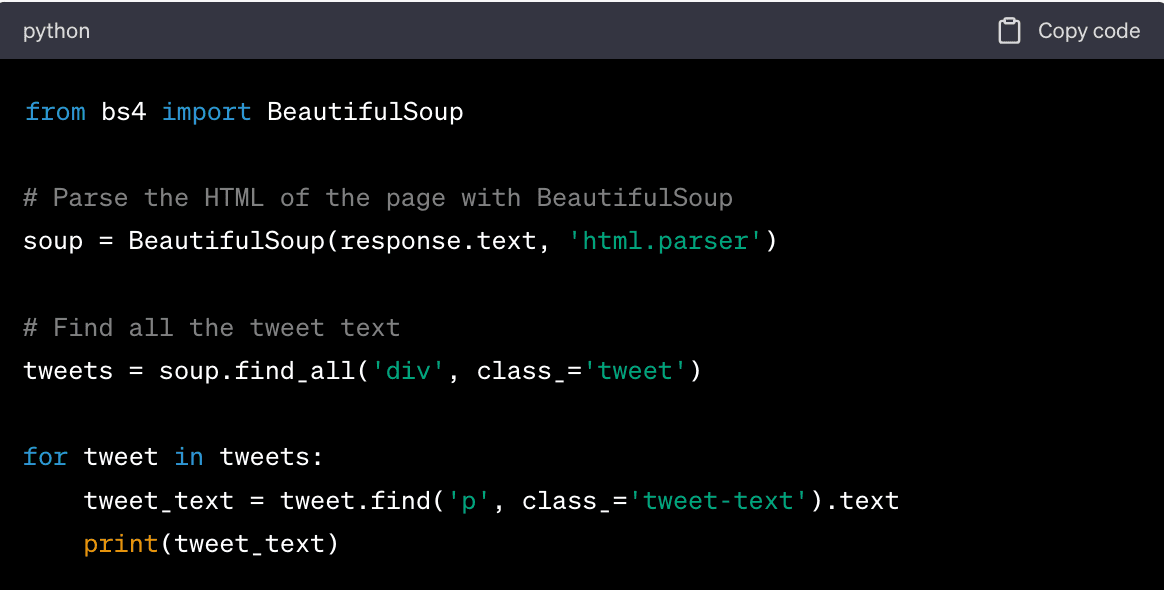
Dans ce code, nous créons d'abord un objet BeautifulSoup et analysons le code HTML de la page. Nous recherchons ensuite tous les éléments div ayant la classe « tweet », qui contiennent les tweets. Pour chaque tweet, nous recherchons l'élément p ayant la classe « tweet-text », qui contient le texte du tweet, puis nous l'affichons.
4. Utilisez des méthodes de requête pour trouver des éléments de données spécifiques. Avec BeautifulSoup, par exemple, vous pouvez utiliser des méthodes telles que find_all() pour localiser des balises d'en-tête, des paragraphes ou d'autres éléments.
5. Enregistrez les données dans le format de votre choix, tel que CSV, JSON ou une base de données. Voici comment les enregistrer dans un fichier CSV à l’aide de la bibliothèque Pandas :
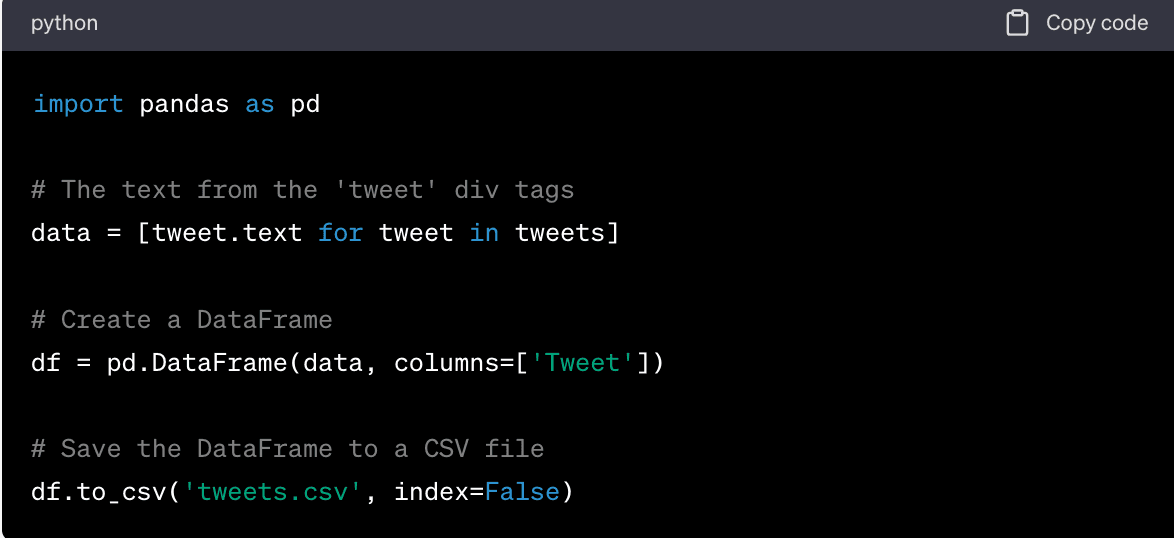
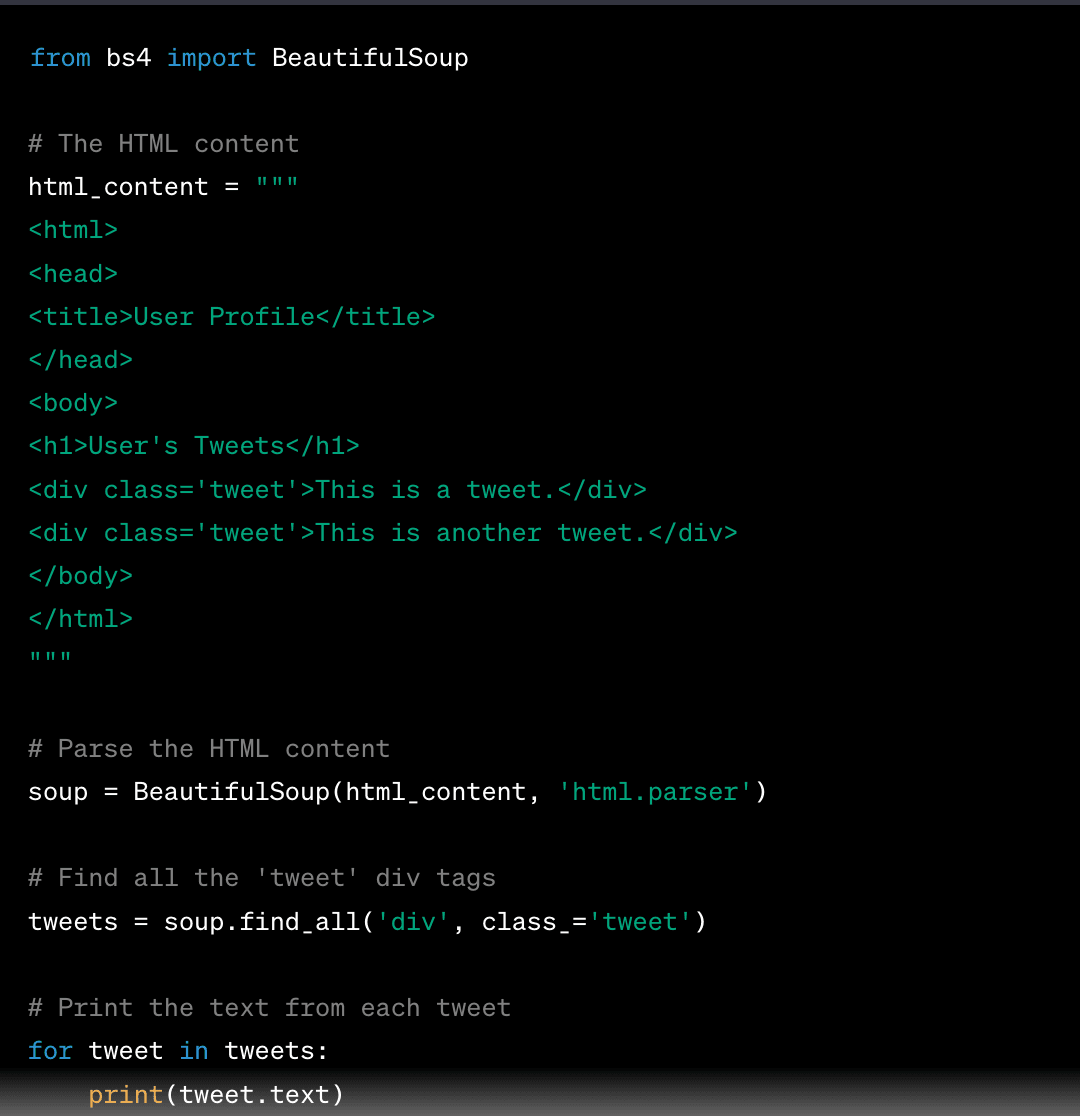
Cela créera un fichier CSV nommé « tweets.csv » comportant une seule colonne « Tweet » qui contient le texte des balises div « tweet ». Voici un exemple simple illustrant comment extraire le texte d’un tweet à l’aide de Python et de BeautifulSoup :
3. Geonode
L’outil « Scraper API
» de
Geonode
est un outil puissant qui vous permet d’extraire des données de sites web tels que Twitter. Il propose différents modes de scraping pour des performances et une efficacité optimales.
Pourquoi utiliser le scraper Pay-As-You-Go
d’Geonode
?
• Tarification flexible. Le modèle «pay-as-you-go
» vous permet de ne payer que ce que vous utilisez. Cela peut s’avérer plus rentable qu’un modèle d’abonnement, en particulier pour une utilisation irrégulière ou à faible volume.
• Évolutivité. Scraper API
est conçu pour gérer aussi bien les tâches de scraping à petite qu’à grande échelle. Vous pouvez ainsi faire évoluer vos tâches de scraping selon vos besoins sans craindre d’atteindre des limites d’utilisation.
• Facilité d’utilisation. Scraper API
de Geonode
est facile à utiliser, même pour ceux qui n’ont aucune connaissance en programmation. Il offre un moyen simple d’extraire des données de Twitter.
• Fonctionnalités avancées. L’interface Scraper API
de Geonode
propose toute une gamme de fonctionnalités avancées telles que le rendu JavaScript, l’exécution de snippets JS personnalisés, la rotation des proxys, le ciblage géographique, et bien plus encore. Ces fonctionnalités peuvent s’avérer très utiles pour les tâches de scraping complexes.
• Modes en temps réel et de rappel. L’API propose deux modes de scraping : le mode en temps réel et le mode de rappel. Cela vous offre une grande flexibilité quant à la manière dont vous recevez les résultats de votre scraping.
Limites du scraper Pay-As-You-Go
d’GeoNode
• Les coûts peuvent s’accumuler : bien que le modèle «pay-as-you-go
» puisse être rentable pour une utilisation à faible volume, les coûts peuvent rapidement s’accumuler pour les tâches de scraping à grande échelle. Il est important de surveiller votre utilisation pour éviter des frais imprévus.
• Courbe d’apprentissage : bien que l’outil Scraper API
d’GeoNode
soit conçu pour être facile à utiliser, il peut tout de même nécessiter un certain temps d’adaptation, en particulier pour les personnes novices en matière de scraping ou d’API en général.
• **Dépendance vis-à-vis du service d’GeoNode
** : comme pour tout service tiers, vous dépendez du service d’GeoNode
pour vos tâches de scraping. Si des problèmes surviennent au niveau de leur service, cela pourrait affecter vos tâches de scraping.
• Considérations juridiques et éthiques : le web scraping peut se situer dans une zone grise sur le plan juridique. Bien que l’Scraper API
de GeoNode
facilite l’extraction de données, il est important de vous assurer que vos activités de scraping respectent les conditions d’utilisation du site web que vous exploitez ainsi que toutes les lois applicables en matière de protection de la vie privée.
Étapes d'utilisation de Geonode Scraper API pour l'extraction de données sur Twitter
1. Configurez votre requête. Pour utiliser l'outil GeoNode Scraper API, vous devez configurer une requête. Cette requête doit inclure l'URL de la page que vous souhaitez extraire (dans ce cas, une page Twitter), ainsi qu'un ensemble de paramètres de configuration qui déterminent le comportement de l'outil d'extraction. Voici un exemple illustrant comment structurer votre requête :
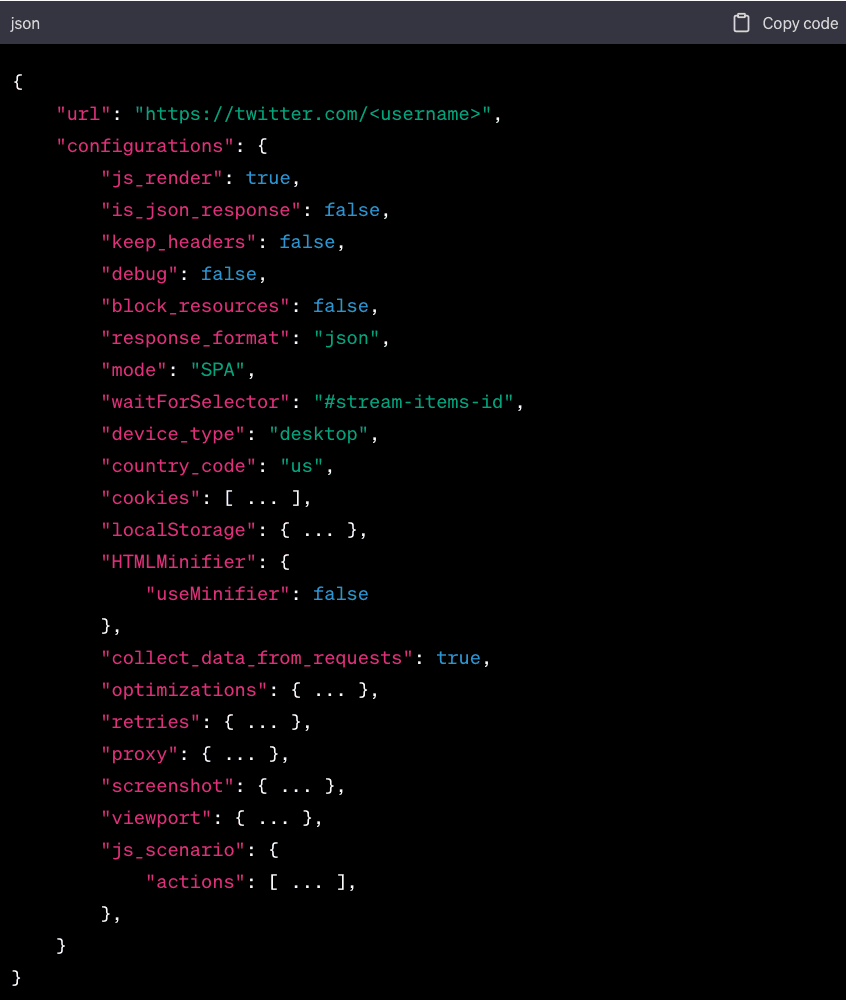
Dans cet exemple, l’URL correspond à la page Twitter que vous souhaitez extraire. Le paramètre waitForSelector est défini sur #stream-items-id, qui est l’ID de la balise div contenant les tweets sur une page Twitter. Cela indique au scraper d’attendre que cet élément soit chargé avant de procéder au scraping de la page.
2. Mode temps réel et mode callback. GeoNode Scraper API propose deux modes de scraping : le mode temps réel et le mode callback. En mode temps réel, l’API renvoie le résultat immédiatement après la fin du scraping. En mode « Callback », l’API envoie le résultat à une URL de callback spécifiée une fois l’extraction terminée. Vous pouvez choisir le mode qui correspond le mieux à vos besoins.
3. Vérifier l’état de votre tâche. Vous pouvez vérifier l’état de votre tâche d’extraction à l’aide de l’identifiant de requête que vous avez reçu dans la réponse initiale. Cela vous permet de suivre la progression de votre tâche et de déterminer si elle est terminée.
4. Actions. L’Geonode Scraper API vous permet d’interagir avec le document cible grâce à une liste d’actions prises en charge. Par exemple, vous pouvez utiliser ces actions pour cliquer sur un bouton ou remplir un formulaire sur la page avant le scraping.
Analyse des données Twitter
Une fois que vous avez extrait et stocké les données Twitter, l'étape suivante consiste à les analyser. Voici un guide étape par étape :
**1. Analyse de base. **
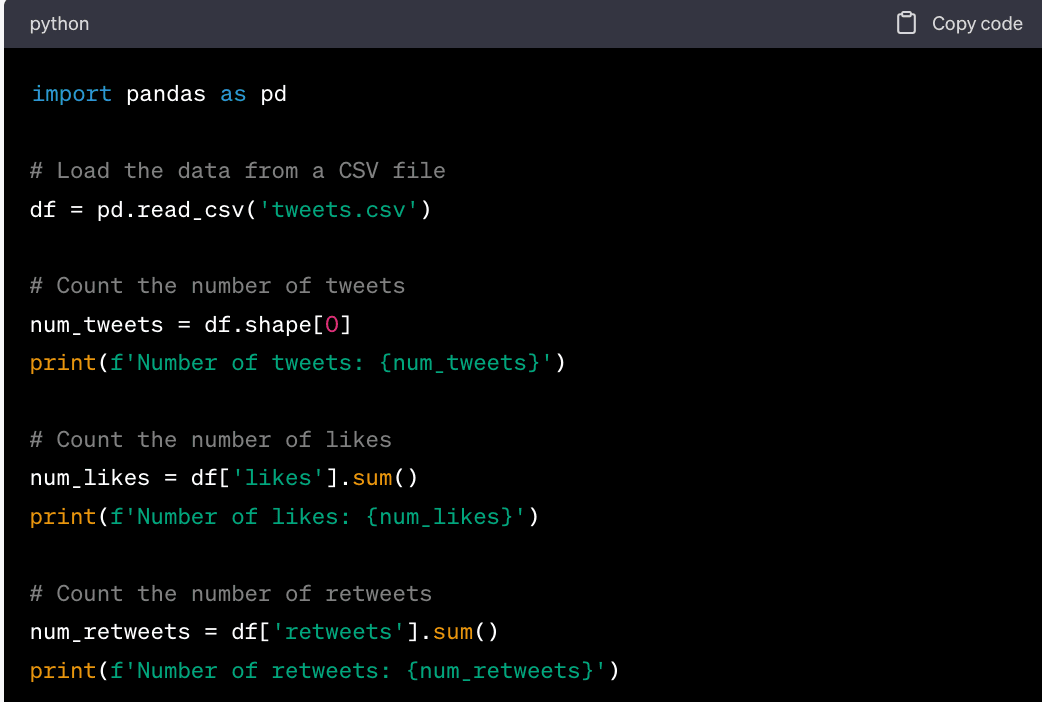
L'analyse de base consiste à compter les tweets, les « j'aime », les retweets et d'autres indicateurs simples. Voici un exemple illustrant comment procéder à l'aide de pandas, une puissante bibliothèque d'analyse de données pour Python :
2. Analyse des sentiments
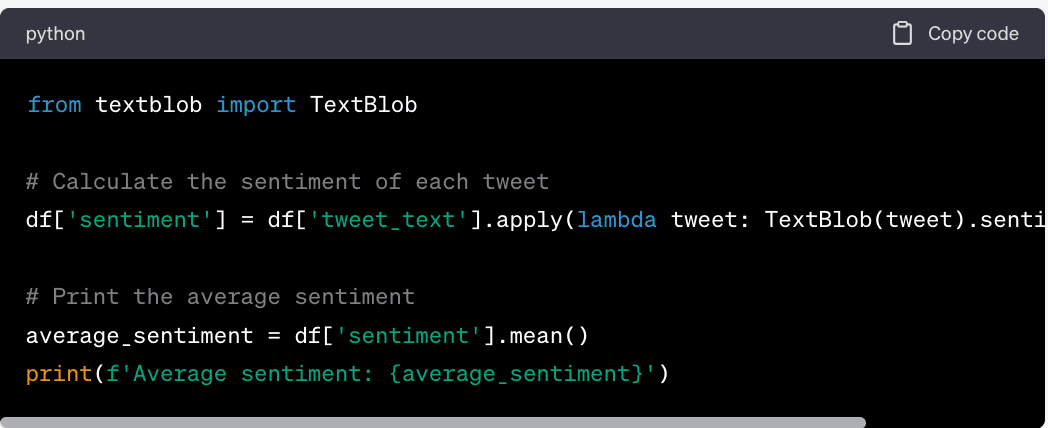
L’analyse des sentiments consiste à déterminer le sentiment exprimé dans un texte, tel qu’un tweet. Voici un exemple illustrant comment procéder à l’aide de TextBlob, une bibliothèque dédiée au traitement des données textuelles :
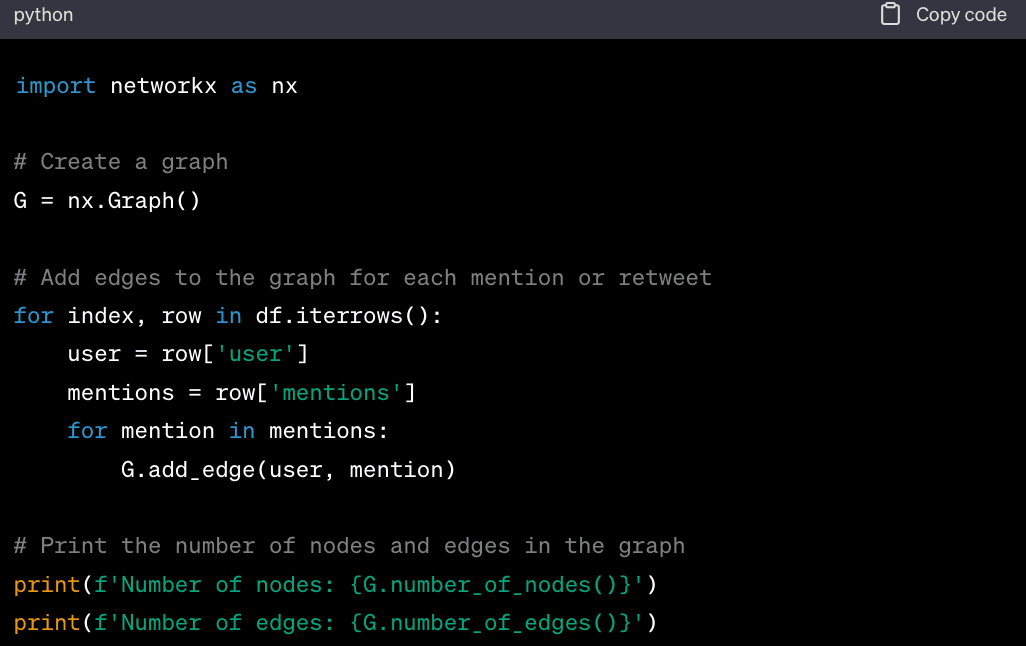
3. Analyse de réseau
L'analyse de réseaux consiste à analyser les liens entre les utilisateurs de Twitter. Cela peut être réalisé à l'aide de NetworkX, une bibliothèque Python permettant de créer, manipuler et étudier la structure, la dynamique et les fonctions de réseaux complexes.
4. Visualisation des données Twitter
La visualisation des données Twitter peut vous aider à mieux les comprendre. Pour cela, vous pouvez utiliser Matplotlib, une bibliothèque de traçage pour Python :
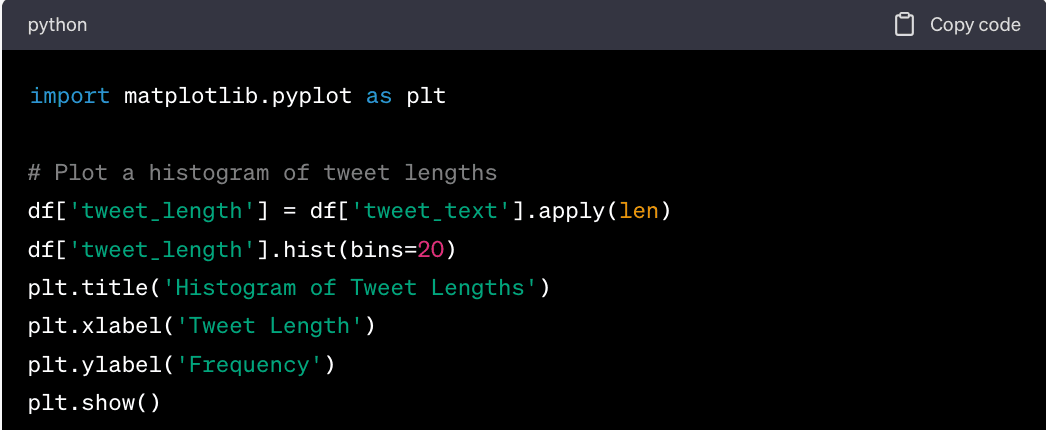
Dans ce code, nous calculons d’abord la longueur de chaque tweet. Nous traçons ensuite un histogramme des longueurs de tweets, qui montre la répartition de celles-ci.
N'oubliez pas de remplacer « tweets.csv » par le chemin d'accès à votre fichier CSV, et « tweet_text », « likes » et « retweets » par les noms réels des colonnes de votre DataFrame. Remplacez également « user » et « mentions » par les noms réels des colonnes correspondant à l'utilisateur et aux mentions dans votre DataFrame.
Conclusion
Dans ce guide complet, nous avons exploré l’importance et les méthodes d’extraction de données sur Twitter. Véritable mine d’informations sur l’opinion publique, les tendances et les liens, Twitter offre une multitude de données pouvant être exploitées à des fins diverses, allant des études de marché et de l’analyse des sentiments à la prévision des tendances, et bien plus encore.
Nous avons examiné en détail trois méthodes principales d’extraction de ces données :
-
L’API de Twitter. Il s’agit de la méthode officielle fournie par Twitter pour interagir avec ses données. C’est un outil puissant, mais qui comporte certaines limites, telles que des restrictions de débit et la nécessité d’obtenir l’approbation d’un compte développeur. Il s’agit toutefois d’un moyen fiable et simple d’accéder aux données de Twitter, en particulier lorsqu’il est utilisé avec des bibliothèques telles que Tweepy.
-
Le web scraping avec Python. Cette méthode consiste à utiliser des bibliothèques Python telles que BeautifulSoup et requests pour extraire directement les données du site web de Twitter. Bien que cette méthode permette de contourner certaines des limitations de l’API de Twitter, elle est plus complexe sur le plan technique et peut s’avérer plus fragile en raison des changements potentiels dans la structure du site web de Twitter.
-
Scraper « Pay-As-You-Go » de GeoNode. Il s’agit d’un service tiers qui offre un moyen plus flexible et plus puissant d’extraire des données de Twitter. Il propose des fonctionnalités avancées telles que le rendu JavaScript et le ciblage géographique, mais son utilisation entraîne des coûts et nécessite une utilisation prudente pour éviter des frais imprévus.
Chacune de ces méthodes présente ses propres avantages et inconvénients, et le choix de la meilleure dépend de vos besoins spécifiques, de vos compétences techniques et de votre budget.
Pour conclure, il est essentiel de souligner l’importance d’un extraction de données éthique et responsable.
Bien que l’extraction de données sur Twitter puisse fournir des informations précieuses, il est essentiel de respecter les conditions d’utilisation de Twitter, la vie privée des utilisateurs de Twitter et toutes les lois applicables. Utilisez toujours les données que vous extrayez de manière responsable et, en cas de doute, demandez un avis juridique.
En comprenant les outils et les techniques de scraping des données Twitter, vous disposez désormais des moyens nécessaires pour exploiter la puissance des données Twitter au service de vos propres projets.

