Qu'est-ce que l'extraction de données ?
L'extraction de données consiste à récupérer des informations à partir de sites web, de bases de données et de documents. Selon IDC, le volume croissant des données, qui devrait atteindre 175 zettaoctets d'ici 2025, rend l'extraction de données indispensable. C’est pourquoi de nombreuses entreprises automatisent leur processus d’extraction de données à l’aide d’API de web scraping, car cela leur permet de collecter, de traiter et d’analyser efficacement de grandes quantités de données. Grâce au web scraping, les entreprises peuvent facilement accéder aux données dont elles ont besoin et les analyser afin de prendre des décisions plus éclairées, de favoriser leur croissance et d’assurer leur réussite dans le monde actuel, axé sur les données.
Extraction de données à l'aide de l'ETL
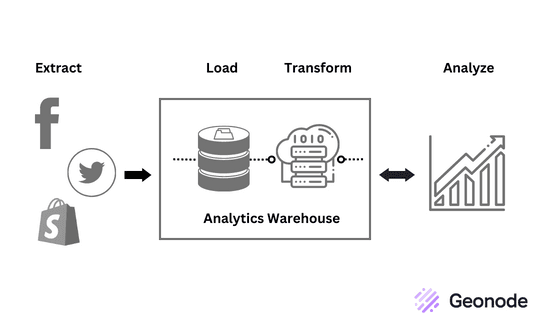
L'extraction, la transformation et le chargement (ETL) constituent un processus utilisé pour intégrer et gérer de grandes quantités de données provenant de diverses sources. Il s'agit d'un processus couramment utilisé dans l'extraction de données et le web scraping afin de collecter, nettoyer et organiser les données en vue de leur analyse.
Le processus ETL comprend trois étapes principales :
-
Extraction : la première étape consiste à extraire ou à récupérer des données provenant de diverses sources telles que des bases de données, des fichiers ou des API. Les données extraites peuvent être structurées, semi-structurées ou non structurées.
-
Transformation : la deuxième étape consiste à transformer les données extraites en un format adapté au système cible, tel qu’un entrepôt de données ou un outil de reporting. Cette étape comprend le nettoyage, le filtrage, l’agrégation et l’enrichissement des données afin d’en garantir la cohérence et l’exactitude. Elle implique également la conversion des données dans un format standard facile à comprendre.
-
Chargement : La dernière étape consiste à charger les données transformées dans le système cible en vue d’une analyse et d’un traitement ultérieurs. Les données sont chargées dans une base de données ou un entrepôt de données où d’autres applications peuvent facilement les interroger et les analyser.
Extraction de données sans ETL
Bien que l’extraction de données puisse être effectuée en dehors d’un processus ETL, cette méthode présente des limites et doit être utilisée à bon escient. Par exemple, si des données brutes sont extraites sans transformation ni chargement appropriés, elles peuvent s’avérer difficiles à organiser et à analyser, et incompatibles avec les programmes et applications plus récents. Par conséquent, ces données pourraient n'avoir qu'une valeur limitée, sauf à des fins d'archivage.
Cependant, l'extraction de données sans ETL reste une excellente option pour les entreprises qui ont besoin d'accéder rapidement à des données provenant de plusieurs sources. Il s'agit également d'une solution économique, qui évite d'avoir à investir dans des logiciels et du matériel ETL coûteux.
De plus, elle permet de transférer rapidement et facilement des données d’un système à un autre sans nécessiter de transformations complexes.
En fonction de vos besoins et des ressources disponibles, vous pouvez trouver plusieurs techniques alternatives d’extraction de données qui ne reposent pas sur l’ETL traditionnel.
Capture des données modifiées (CDC)
La capture des données modifiées (CDC) est une méthode ETL qui capture et stocke les modifications apportées aux données dans un système source à des fins d’analyse. Contrairement à l’ETL traditionnel, qui extrait des ensembles de données entiers, la CDC ne capture que les modifications apportées aux données depuis la dernière extraction. Cela en fait une méthode plus efficace pour extraire des données.
Interface de programmation d’applications (API)
L’API (Interface de programmation d’applications) est une autre méthode d’extraction de données sans ETL. Les API constituent un ensemble de protocoles et d’outils permettant de développer des applications logicielles. Grâce aux API, les développeurs peuvent extraire par programmation des données d’un système source et les rendre disponibles dans leurs applications.
De nombreuses applications populaires, telles que Google Maps et Twitter, fournissent des API pouvant être utilisées pour l’extraction de données.
Web scraping
Le web scraping est une autre méthode permettant d’extraire des données sans recourir à l’ETL. Cette technique consiste à utiliser des scripts automatisés pour extraire des données à partir de pages web. Bien que le web scraping présente certaines limites, comme sa vulnérabilité aux modifications de la structure des pages web, il peut constituer un outil puissant pour extraire des données de sites web.
Si l’ETL est la méthode la plus couramment utilisée pour l’extraction de données, d’autres méthodes peuvent s’avérer tout aussi efficaces. La capture des données modifiées (Change Data Capture), les API et le web scraping constituent tous des options viables pour extraire des informations à partir de diverses sources. Il est essentiel d’évaluer quelle méthode est la mieux adaptée à un cas d’utilisation particulier et de se tenir informé des dernières techniques et technologies afin de déterminer celle qui répond le mieux à vos besoins.
À lire également : Connaître la différence entre un « web scraper » et un « web crawler »
Avantages de l'extraction de données
Réduit les erreurs humaines
L'extraction de données automatise le processus de collecte des données, minimisant ainsi les risques d'erreurs pouvant survenir lors de la saisie manuelle. Elle améliore donc la précision et la cohérence des données.
Augmente la productivité
L’extraction de données libère du temps pour que les employés puissent se concentrer sur d’autres tâches, ce qui augmente leur productivité. Le processus est également plus rapide que la saisie manuelle, ce qui permet aux entreprises de traiter davantage de données en moins de temps.
Permet de prendre de meilleures décisions stratégiques
L’extraction de données donne aux entreprises accès à une mine d’informations, leur permettant ainsi de prendre des décisions fondées sur les données. Cela se traduit par un meilleur service client, des produits et services améliorés, ainsi qu’une augmentation du chiffre d’affaires.
Offre une meilleure visibilité
L’extraction de données offre une meilleure visibilité sur les opérations commerciales, permettant aux entreprises d’identifier les inefficacités, les opportunités de croissance et les axes d’amélioration.
Simplifie le partage
L’extraction de données permet aux entreprises de partager facilement des données entre les services et avec des parties prenantes externes, améliorant ainsi la collaboration et la communication.
Rentabilité
L’extraction de données est une solution rentable pour les entreprises, car elle élimine la saisie manuelle des données et réduit le risque d’erreurs, qui peuvent s’avérer coûteuses.
Gain de temps
L’extraction de données automatise la collecte et le traitement des données, ce qui fait gagner un temps précieux aux entreprises et leur permet de se concentrer sur d’autres tâches importantes.
Extraction de données : cas d'utilisation concrets
L'extraction de données trouve de nombreuses applications concrètes dans divers secteurs d'activité. Voici quelques-uns des cas d'utilisation les plus courants de l'extraction de données :
Surveillance de la réputation
Les entreprises doivent surveiller leur réputation en ligne afin de protéger leur marque. L’extraction de données permet de suivre les mentions de la marque, d’identifier les avis négatifs et de recueillir les commentaires des clients afin d’améliorer l’image de marque.
Études de marché
L’extraction de données aide les entreprises à recueillir des informations sur les tendances du marché, le comportement des consommateurs et les dynamiques du secteur. Ces données sont utilisées pour prendre des décisions éclairées en matière de développement de produits, de stratégies marketing et d’expansion commerciale.
Données financières
Les institutions financières ont recours à l’extraction de données pour collecter et analyser des informations provenant de diverses sources, notamment des états financiers, des articles de presse et des rapports de marché, afin de prendre des décisions d’investissement éclairées et d’identifier les tendances du marché.
Génération de prospects
L’extraction de données permet de générer des prospects en collectant des coordonnées et d’autres données pertinentes à partir de profils sur les réseaux sociaux, de sites web d’entreprises et d’autres sources en ligne.
Agrégation de contenu
Afin de créer des articles d’actualité complets et à jour, les agences de presse et les médias ont recours à l’extraction de données pour rassembler des informations provenant de diverses sources, telles que des articles d’actualité, des billets de blog et les réseaux sociaux.
Analyse des sentiments
Les entreprises ont recours à l’extraction de données pour suivre le sentiment des clients en collectant et en analysant les commentaires, les avis et les retours d’expérience. Cela leur permet d’améliorer leurs produits et services et de renforcer leurs relations avec la clientèle.
Veille tarifaire
Les détaillants utilisent l’extraction de données pour collecter des informations sur les prix, les promotions et les remises pratiqués par leurs concurrents afin d’ajuster leurs propres stratégies tarifaires et de se démarquer de la concurrence.
Analyse du marché de l’emploi
Les agences de recrutement et les sites d’offres d’emploi ont recours à l’extraction de données pour collecter des informations sur les offres d’emploi, les descriptions de poste et les compétences requises, aidant ainsi les demandeurs d’emploi à trouver des offres pertinentes et les employeurs à identifier des candidats potentiels.
Analyse des réseaux sociaux
Les plateformes de réseaux sociaux ont recours à l’extraction de données pour analyser le comportement et les préférences des utilisateurs, identifier les influenceurs et proposer des recommandations personnalisées aux utilisateurs.
Secteur du voyage
Les agences de voyage et les plateformes de réservation ont recours à l’extraction de données pour recueillir des informations sur les vols, les hôtels et les destinations de voyage, ce qui leur permet de proposer des forfaits de voyage plus personnalisés à leurs clients.
Découverte des différents types de données extraites
Lors de l'extraction de données, différents types de données peuvent être extraits en fonction de la nature des données et de l'objectif de l'extraction. Découvrons quelques-uns des types de données extraites au cours du processus d'extraction.
Données non structurées
Les données non structurées désignent les données qui ne sont pas organisées selon un schéma prédéfini, telles que les e-mails, les publications sur les réseaux sociaux ou les documents texte. L'analyse des données non structurées peut s'avérer difficile, car elles ne présentent pas de structure cohérente.
Cependant, grâce aux techniques de traitement du langage naturel, les données non structurées peuvent être transformées en un format structuré, ce qui facilite l’analyse et la prise de décision.
Données structurées
Les données structurées, en revanche, sont organisées selon un schéma prédéfini, comme dans un tableur ou une base de données. Les données structurées sont plus faciles à analyser car elles présentent une structure cohérente, ce qui facilite leur recherche, leur filtrage et leur agrégation.
Les données structurées peuvent être classées en différents types de données, telles que les données clients, financières et opérationnelles.
Données clients
Les données clients comprennent des informations sur les clients, telles que leurs caractéristiques démographiques, leur historique d’achats et leurs préférences. Elles sont utilisées pour améliorer l’engagement client, développer des campagnes marketing ciblées et optimiser l’expérience client.
Parmi les sources de données clients, on peut citer les enquêtes auprès des clients, l’activité sur les réseaux sociaux et les analyses de sites web.
Données financières
Les données financières désignent les informations relatives aux finances d’une entreprise, telles que le chiffre d’affaires, les dépenses et les marges bénéficiaires. Elles sont utilisées pour suivre les performances financières, identifier les domaines permettant de réaliser des économies et prendre des décisions financières éclairées.
Parmi les sources de données financières, on peut citer les logiciels de comptabilité, les états financiers et les données transactionnelles.
Données opérationnelles
Les données opérationnelles désignent les informations relatives aux opérations quotidiennes d’une entreprise, telles que les niveaux de stock, le volume de production et les indicateurs de service client. Elles sont utilisées pour identifier les domaines d’amélioration des processus, optimiser l’allocation des ressources et renforcer l’efficacité globale.
Les sources de données opérationnelles comprennent les capteurs des équipements de production, les systèmes de point de vente et les logiciels d’assistance technique.
L’extraction de données peut générer différents types de données, notamment des données non structurées et structurées. L’extraction et l’analyse de ces types de données peuvent fournir des informations précieuses permettant aux organisations de prendre des décisions éclairées et de favoriser la réussite de leur activité.
Techniques d'extraction de données
Il existe deux grands types de méthodes d'extraction dans le domaine du data warehousing : l'extraction logique et l'extraction physique.
Extraction logique
L'extraction logique est une méthode d'extraction de données qui consiste à utiliser des règles logiques et des transformations pour extraire des données de diverses sources et les intégrer dans un format commun au sein d'un entrepôt de données. Il existe trois méthodes principales d'extraction logique : la notification de mise à jour, l'extraction incrémentielle et l'extraction complète.
Notification de mise à jour
Cette méthode consiste à extraire uniquement les données qui ont été mises à jour dans le système source depuis la dernière extraction. Le système source signale les modifications à l’entrepôt de données, et seules les données mises à jour sont extraites. Cette approche est particulièrement utile lorsque l’intégration des données en temps réel est requise et que seules les données les plus récentes sont nécessaires à l’analyse.
Extraction incrémentielle
Cette méthode consiste à extraire uniquement les données qui ont été ajoutées, mises à jour ou supprimées dans le système source depuis la dernière extraction. L’extraction s’appuie sur un horodatage ou un indicateur signalant la date de la dernière modification des données. Elle est souvent utilisée lorsque le volume de données est important et qu’il n’est pas pratique d’extraire l’intégralité des données à chaque fois.
Extraction complète
L’extraction complète consiste à extraire toutes les données du système source, qu’elles aient ou non été modifiées depuis la dernière extraction. Lorsque le volume de données est faible ou que le système source est relativement stable, et que l’entrepôt de données a besoin d’une copie complète des données sources, la méthode d’extraction complète est la plus indiquée.
Extraction physique
D’autre part, l’extraction physique est une autre méthode d’extraction de données dans le cadre de l’entreposage de données, qui consiste à copier ou à déplacer physiquement les données du système source vers l’entrepôt de données. L’extraction physique s’articule autour de deux méthodes principales : l’extraction en ligne et l’extraction hors ligne.
Extraction en ligne
L’extraction en ligne consiste à extraire les données du système source alors que celui-ci est encore en fonctionnement. Cette méthode est utile lorsque les données sont requises en temps réel et que le système source ne peut pas être mis hors ligne. Cependant, le processus d’extraction peut avoir un impact sur les performances du système source, ce qui constitue un facteur important à prendre en compte lors du choix de cette méthode.
Extraction hors ligne
Elle consiste à extraire les données du système source lorsqu’il n’est pas en service. Elle est souvent utilisée lorsque les données peuvent être extraites pendant les périodes de faible activité ou lorsqu’il n’est pas nécessaire de les extraire en temps réel. Le processus d’extraction n’affecte pas les performances du système source, ce qui constitue un avantage considérable par rapport à l’extraction en ligne.
Dans l’ensemble, ces méthodes présentent chacune des avantages et des inconvénients. Le choix d’une méthode dépend des besoins spécifiques de votre entreprise et de la nature des données à extraire. Une sélection rigoureuse de la méthode appropriée garantit que les données de votre entrepôt de données sont exactes, à jour et disponibles pour l’analyse.
Extraction de données VS exploration de données
Tout comme l'extraction de données, l'exploration de données constitue une autre étape cruciale dans l'analyse et l'exploitation de grandes quantités de données. Cependant, bien que ces deux techniques servent à extraire des informations et des connaissances utiles à partir des données, il existe des différences significatives entre les deux.
Extraction de données
L’extraction de données consiste à extraire des données provenant de diverses sources et à les regrouper dans un emplacement central, tel qu’un entrepôt de données.
Cela implique d’identifier les sources de données pertinentes, d’appliquer des techniques de nettoyage et de transformation des données, puis de charger ces dernières dans une base de données centralisée. L’objectif de l’extraction de données est de créer une copie complète et précise des données, facilement accessible et analysable.
Exploration de données
D’autre part, l’exploration de données est le processus consistant à découvrir des modèles, des tendances et des informations pertinentes dans les données qui ont été extraites.
Ce processus implique l’utilisation d’analyses statistiques et de techniques d’apprentissage automatique pour identifier des corrélations, des classifications et d’autres informations permettant de prendre des décisions commerciales éclairées.
L’exploration de données vise à transformer les données brutes en connaissances exploitables et à les utiliser pour améliorer les performances de l’entreprise et obtenir un avantage concurrentiel.
En termes simples, l’extraction de données consiste à récupérer des données provenant de diverses sources et à les regrouper en un seul et même endroit. À l’inverse, l’exploration de données analyse ces données afin d’y trouver des modèles et des informations pertinentes.
Ces deux étapes sont essentielles dans l’analyse des données et sont souvent utilisées conjointement pour offrir une vue d’ensemble complète des données d’une entreprise.
En recourant à ces techniques, les entreprises peuvent obtenir des informations précieuses sur leurs clients, leurs opérations et les tendances du marché, ce qui peut les aider à prendre de meilleures décisions et à garder une longueur d’avance sur la concurrence.
Différents types d’outils d’extraction de données
Les outils d’extraction de données sont des applications logicielles qui facilitent l’extraction de données à partir de diverses sources et leur consolidation dans un emplacement central, tel qu’un entrepôt de données. Ces outils sont conçus pour automatiser le processus d’extraction de données et le rendre plus efficace et plus précis.
Il existe différents types d’outils d’extraction de données sur le marché, chacun présentant ses propres fonctionnalités et avantages. En voici trois types courants :
Outils de traitement par lots
Ces outils sont conçus pour extraire des données à partir de grands volumes de fichiers ou de documents en mode par lots. Les outils de traitement par lots sont utiles lorsque vous devez extraire des données de plusieurs fichiers ou de documents présentant une structure similaire.
Parmi les exemples d’outils de traitement par lots, on peut citer Talend Open Studio, Apache NiFi et Alteryx.
Outils open source
Ces applications logicielles sont disponibles gratuitement et peuvent être modifiées et personnalisées par les utilisateurs. Les outils d’extraction de données open source sont très prisés des petites et moyennes entreprises disposant de budgets limités, ainsi que de celles qui ne peuvent pas se permettre d’acheter des logiciels commerciaux onéreux.
Parmi les outils d’extraction de données open source, on peut citer Apache Kafka, Apache Flume et Pentaho Data Integration.
Outils basés sur le cloud
Les outils basés sur le cloud sont hébergés dans le cloud et accessibles via un navigateur web. Vous pouvez utiliser des outils d’extraction de données basés sur le cloud lorsque vous devez extraire des données à partir de sources distantes ou lorsque vous souhaitez collaborer avec d’autres membres de l’équipe situés dans différentes zones géographiques.
Parmi les outils d’extraction de données basés sur le cloud, on peut citer AWS Glue, Azure Data Factory et Google Cloud Dataflow.
Les outils d’extraction de données font partie intégrante du processus d’analyse des données, car ils aident les entreprises à consolider et à analyser des données provenant de diverses sources. N’oubliez pas que le choix du bon outil d’extraction de données peut faire une grande différence en termes d’efficacité et de précision de vos efforts d’analyse des données.
Les meilleurs outils d'extraction de données
Les outils d'extraction de données se présentent sous de nombreuses formes et tailles différentes. Que vous ayez besoin d'extraire des données de sites web, de documents ou de plateformes de réseaux sociaux, il existe un outil pour vous aider à automatiser le processus et à tirer des informations précieuses de vos données.
Scrapestorm
Scrapestorm est un outil de web scraping qui aide les utilisateurs à extraire des données de divers sites web. Conçu pour automatiser le processus de web scraping, il permet aux utilisateurs sans aucune expérience en programmation de récupérer facilement des données. Scrapestorm peut extraire des données à partir de tableaux, de graphiques et de cartes, ainsi que de fichiers PDF et d’images. Son interface conviviale et ses options de personnalisation flexibles en font un choix populaire auprès des entreprises de toutes tailles.
Altair Monarch
Altair Monarch est un outil d’extraction de données qui permet aux utilisateurs d’extraire des données à partir de diverses sources, notamment des fichiers PDF, des feuilles de calcul et des bases de données. Il utilise des algorithmes d’apprentissage automatique pour identifier et extraire automatiquement des données à partir de documents non structurés, ce qui contribue à réduire l’effort manuel nécessaire à l’extraction de données. De ce fait, Altair Monarch est particulièrement utile pour les entreprises qui extraient régulièrement des données à partir de volumes importants de documents.
Klippa
Outil d’extraction de données basé sur la reconnaissance optique de caractères (OCR), Klippa automatise le traitement des documents. Il peut extraire des données de divers documents tels que des factures, des reçus et des contrats. Il utilise des algorithmes d’apprentissage automatique pour reconnaître et extraire les données de ces documents, puis exporte les données extraites vers divers formats tels qu’Excel, JSON et XML. Klippa est particulièrement utile pour les entreprises qui ont besoin d’extraire des données à partir d’un grand nombre de documents en peu de temps.
NodeXL
NodeXL est un outil d’analyse et de visualisation des données pour les réseaux sociaux. Il permet aux utilisateurs d’extraire des données de diverses plateformes de réseaux sociaux, telles que Twitter, Facebook et LinkedIn, et de les visualiser sous forme de graphiques et de tableaux. NodeXL est particulièrement adapté aux entreprises qui ont besoin d’analyser le comportement de leurs clients et de leurs concurrents sur les réseaux sociaux. Il est très apprécié par de nombreuses entreprises en raison de son interface conviviale et de ses fonctionnalités avancées.
Qu'est-ce qui rend l'extraction de données si difficile ?
Bien qu'elle constitue une étape essentielle du processus d'analyse des données, l'extraction de données s'accompagne également de plusieurs défis qui peuvent empêcher les entreprises d'extraire et d'utiliser efficacement leurs données. Voici quelques-uns des principaux défis liés à l'extraction de données :
Problèmes de formatage des données
Les données peuvent se présenter sous divers formats et structures, ce qui rend leur extraction et leur normalisation difficiles. Elles peuvent être incomplètes, incohérentes ou contenir des erreurs, ce qui nécessite un nettoyage et une transformation approfondis.
Problèmes de sécurité des données
L’extraction de données peut présenter des risques pour la sécurité si elle concerne des informations sensibles ou confidentielles. Les entreprises doivent prendre les mesures appropriées pour garantir la sécurité des données pendant leur extraction et leur transfert.
Limites techniques
L’extraction de données peut s’avérer difficile si celles-ci sont stockées dans des systèmes hérités ou provenant de différentes sources. Elle peut nécessiter des compétences techniques spécialisées ou des outils logiciels pour extraire et intégrer des données provenant de sources multiples.
Conformité légale
L’extraction de données doit respecter les exigences légales et réglementaires, telles que les lois sur la protection des données comme le RGPD et le CCPA. Le non-respect de ces réglementations peut entraîner de lourdes amendes et nuire à la réputation de l’entreprise.
Pour surmonter ces difficultés, une approche stratégique de l’extraction des données est nécessaire, impliquant notamment l’utilisation d’outils et de techniques avancés, ainsi qu’un engagement en faveur de la qualité et de la sécurité des données. En relevant ces défis, les entreprises peuvent exploiter pleinement le potentiel de leurs données et acquérir un avantage concurrentiel sur le marché.
Bonnes pratiques en matière d'extraction de données
L'extraction de données est une étape cruciale de l'analyse des données ; il est donc essentiel de suivre les bonnes pratiques pour garantir la précision, la qualité et la réussite de cette opération.
Identifier les sources de données
Commencez par identifier toutes les sources de données pertinentes et par comprendre la structure des données. Cela vous évitera de passer à côté de données essentielles et de gaspiller des ressources sur des sources de données non pertinentes.
Nettoyer et prétraiter les données
Pour garantir la précision et la cohérence, nettoyez et prétraitez les données avant leur extraction. Le nettoyage et le prétraitement des données permettent d’identifier et de supprimer les incohérences, les erreurs et les valeurs aberrantes susceptibles d’affecter la qualité des données extraites.
Stocker et sauvegarder les données
Le stockage et la sauvegarde des données sont essentiels pour garantir leur accessibilité et leur sécurité. Les solutions de stockage de données, telles que les services basés sur le cloud, offrent flexibilité et évolutivité et peuvent contribuer à protéger les données contre la perte ou la détérioration.
Sécuriser les données
Mettez en œuvre des mesures de sécurité robustes, telles que le chiffrement des données, les contrôles d’accès et des audits de sécurité réguliers. La sécurité des données doit être une priorité absolue afin de protéger les données sensibles et de prévenir les fuites de données.
Conclusion
L'extraction de données peut s'avérer complexe, mais avec les outils et les techniques adaptés, elle peut devenir simple et accessible aux débutants. Dans ce guide pour débutants, nous avons abordé les principes fondamentaux de l'extraction de données, depuis la définition du terme jusqu'à la présentation des différentes méthodes et outils disponibles.
L'avenir de l'extraction de données s'annonce passionnant, car les progrès réalisés dans les domaines de l'apprentissage automatique et de l'intelligence artificielle permettent une extraction plus efficace et plus précise des données provenant de diverses sources. À mesure que la quantité de données disponibles continue d'augmenter, des questions telles que « de quels types de mégadonnées pouvons-nous tirer de la valeur ? » et « comment y parvenir ? » se poseront. Par conséquent, la maîtrise de l’extraction de données deviendra une compétence de plus en plus importante, tant pour les entreprises que pour les particuliers.
Il est essentiel d’aborder l’extraction de données avec une compréhension claire des objectifs et des besoins de votre projet, ainsi qu’une volonté d’expérimenter différents outils et méthodes pour trouver ce qui fonctionne le mieux. En suivant les conseils et les techniques présentés dans ce guide, vous serez sur la bonne voie pour extraire et exploiter avec succès des données précieuses.
Foire aux questions - FAQ :
Que signifie « extraction de données » ?
L'extraction de données est le processus qui consiste à récupérer des données provenant de diverses sources, telles que des bases de données, des sites web ou des applications, et à les transformer en un format exploitable à des fins d'analyse. Les données extraites peuvent ensuite être utilisées pour générer des informations pertinentes et faciliter la prise de décision.
Quel est un exemple d’extraction de données ?
Un exemple d’extraction de données consiste à extraire des informations sur des produits à partir d’un site web de commerce électronique. Le processus d’extraction implique d’identifier les champs de données pertinents, tels que le nom du produit, son prix et sa description, puis de récupérer ces données à l’aide d’outils de web scraping ou d’API.
À quoi sert l’extraction de données ?
L’extraction de données sert à récupérer des données provenant de multiples sources afin de soutenir diverses fonctions métier, telles que l’analyse de données, le reporting et la prise de décision. Elle permet de générer des informations exploitables, de développer des modèles prédictifs et d’améliorer les opérations et les stratégies de l’entreprise.
Quelles sont les techniques d’extraction de données ?
Il existe plusieurs techniques d’extraction de données, telles que le web scraping, l’intégration d’API et l’interrogation de bases de données. Le web scraping consiste à extraire des données de sites web à l’aide d’outils automatisés, tandis que l’intégration d’API permet de récupérer des données à partir d’applications web. L’interrogation de bases de données est le processus consistant à récupérer des données à partir de bases de données structurées à l’aide de requêtes SQL.
Références
(26 mai 2020). Techniques d'extraction de données. Rosoka.
https://www.rosoka.com/blog/data-extraction-techniques
(12 août 2022). Quelle est la différence entre l'exploration de données et l'extraction de données ? AmyGB.ai.
https://www.amygb.ai/blog/difference-between-data-mining-and-data-extraction
(12 novembre 2022). Qu’est-ce que l’extraction de données ? Pourquoi est-elle importante ? The ECM Consultant.
https://theecmconsultant.com/what-is-data-extraction
(s.d.). ETL : extraction, transformation, chargement. Talend.
https://www.talend.com/resources/what-is-etl/
(s.d.). Types d’outils ETL. Dremio.
https://www.dremio.com/resources/guides/adv-types-etl-tools/
(s.d.). Que sont les API et comment fonctionnent-elles ? MuleSoft.
https://www.mulesoft.com/api-university/what-are-apis-and-how-do-they-work
(s.d.). Qu'est-ce que la capture des données modifiées (CDC) ? Qlik.
https://www.qlik.com/us/change-data-capture/cdc-change-data-capture
(s.d.). Qu'est-ce que l'extraction de données ? Docparser.
https://docparser.com/blog/what-is-data-extraction/
(s.d.). Qu'est-ce que l'ETL (Extract, Transform, Load) ? Oracle.
https://www.oracle.com/ph/integration/what-is-etl/
Deshpande, I. (16 mars 2021). Qu’est-ce que les données clients ? Définition, types, collecte, validation et analyse. Spiceworks.
https://www.spiceworks.com/marketing/customer-data/articles/what-is-customer-data/
Eteng, O. (27 janvier 2023). Qu’est-ce que l’extraction de données ? Tout ce que vous devez savoir. Hevo Data.
https://hevodata.com/learn/data-extraction/#usecase
Hillier, W. (13 août 2021). Qu’est-ce que le web scraping et comment l’utiliser ? CareeerFoundry.
https://careerfoundry.com/en/blog/data-analytics/web-scraping-guide/
IBM Cloud Education (29 juin 2021). Données structurées et données non structurées : quelle est la différence ? IBM.
https://www.ibm.com/cloud/blog/structured-vs-unstructured-data

