Pendahuluan
Sebagai salah satu jaringan pengiriman konten (CDN) terkemuka, CloudFront.net menawarkan peluang yang tak tertandingi ketika dipadukan dengan kekuatan web scraping. Panduan ini mengulas sinergi tersebut dan memberikan wawasan tentang cara memaksimalkan efisiensi, memastikan keakuratan data, serta memanfaatkan layanan ini secara bertanggung jawab.
CloudFront.net: Raksasa Penyedia Layanan Pengiriman Konten
Amazon CloudFront, yang sering disebut dengan domainnya "CloudFront.net", adalah layanan jaringan pengiriman konten (CDN) yang ditawarkan oleh Amazon Web Services (AWS).
CDN adalah sistem server terdistribusi yang menyalurkan konten web dan aplikasi kepada pengguna berdasarkan lokasi geografis mereka. Tujuannya adalah untuk memberikan ketersediaan dan kinerja yang tinggi dengan mendistribusikan layanan secara spasial relatif terhadap pengguna akhir.
CloudFront terintegrasi dengan layanan AWS lainnya untuk memberikan cara yang dioptimalkan bagi pengembang dan bisnis dalam mendistribusikan konten kepada pengguna akhir dengan latensi rendah dan kecepatan transfer data yang tinggi.
CloudFront bekerja dengan menyimpan salinan konten Anda di berbagai lokasi di seluruh dunia, yang dikenal sebagai lokasi tepi (edge locations). Ketika pengguna meminta konten, CloudFront menyampaikannya dari lokasi tepi terdekat, sehingga memastikan waktu muat secepat mungkin.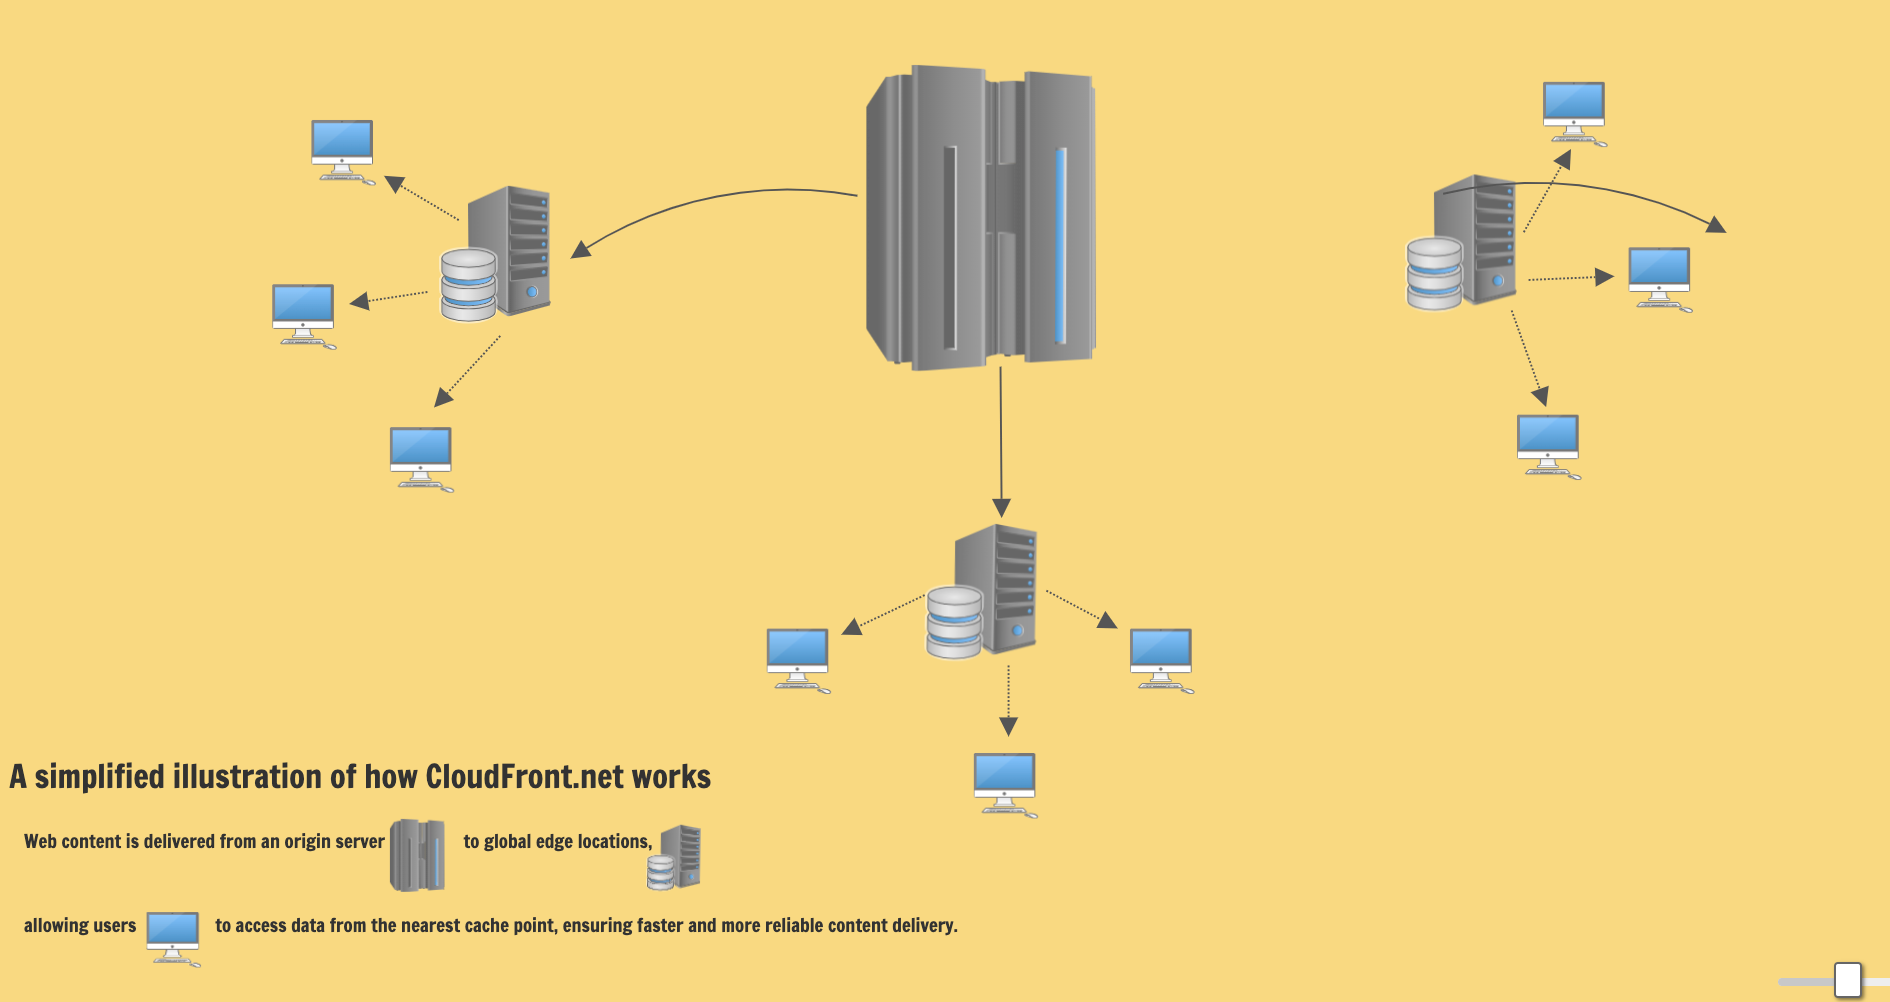
Fitur & Manfaat Utama CloudFront
-
Jangkauan Global. CloudFront memiliki jaringan lokasi tepi yang luas di seluruh dunia untuk mengurangi latensi dan memastikan konten dikirimkan dari titik terdekat ke pengguna akhir.
-
Integrasi Mendalam dengan AWS. CloudFront terintegrasi dengan layanan AWS seperti Amazon S3, Amazon EC2, Elastic Load Balancing, dan Route 53, sehingga memudahkan penggunaan layanan-layanan ini secara bersamaan.
-
Keamanan. CloudFront menawarkan beberapa lapisan keamanan, termasuk dukungan HTTPS, AWS Shield untuk mitigasi DDoS, dan integrasi AWS WAF (Web Application Firewall).
Foto dari Vecteezy
-
Opsi Kustomisasi. Pengembang dapat menyesuaikan pengiriman konten dan mengadaptasi CDN sesuai dengan persyaratan aplikasi tertentu.
-
Hemat Biaya. CloudFront menggunakan model "pay-as-you-go", memastikan Anda hanya membayar untuk data yang ditransfer tanpa biaya di muka.
-
Pengiriman Konten Dinamis dan Statis. Meskipun banyak CDN yang berspesialisasi dalam pengiriman konten statis, CloudFront mendukung konten statis dan dinamis.
-
Ramah Pengembang. Dengan SDK dan API yang didokumentasikan dengan baik, pengembang dapat dengan mudah mengintegrasikan dan mengelola distribusi CloudFront.
-
Metrik dan Pencatatan Log Waktu Nyata. CloudFront menyediakan metrik dan log terperinci, sehingga memungkinkan analisis dan pemantauan penyampaian konten secara mendalam.
Memahami Web Scraping dan Ekstraksi Data
Web scraping adalah proses pengumpulan data dari sebuah situs web.
Proses ini melibatkan pengiriman permintaan HTTP ke halaman web, mengambil konten HTML, lalu mengurai dan mengekstrak informasi yang diinginkan.
Foto dari Vecteezy
Berbeda dengan menyalin data secara manual dari situs web, web scraping mengotomatiskan proses ini, sehingga memungkinkan ekstraksi data dalam jumlah besar dalam waktu yang relatif singkat.
Proses ini biasanya melibatkan:
- Mengirim Permintaan. Sebuah scraper mengirimkan permintaan HTTP ke situs web target.
- Menerima Respons. Situs web tersebut merespons dengan konten HTML.
- Menganalisis Konten. Scraper memproses HTML menggunakan teknik penguraian (parsing) untuk mengidentifikasi struktur data tertentu.
- Ekstraksi Data. Setelah teridentifikasi, data yang diinginkan diekstraksi dari konten yang telah diuraikan.
- Penyimpanan Data. Data yang diekstraksi kemudian disimpan dalam format terstruktur, seringkali dalam basis data atau spreadsheet.
Dampak Web Scraping di Berbagai Industri
Web scraping memiliki beragam aplikasi di berbagai industri:
-
E-commerce. Pengecer melakukan web scraping pada situs web pesaing untuk memantau harga dan penawaran produk.
-
Properti. Situs web properti di-scraping untuk mengumpulkan data mengenai daftar properti, harga, dan tren pasar.
-
Perekrutan. Portal lowongan kerja di-scraping untuk menemukan daftar lowongan kerja dan menganalisis permintaan pasar terhadap keterampilan tertentu.
Foto dari Vecteezy
-
Keuangan. Lembaga keuangan melakukan web scraping pada situs web pasar saham untuk melacak harga saham, berita, dan sentimen pasar.
-
Penelitian. Akademisi dan peneliti melakukan web scraping untuk pengumpulan data di berbagai bidang.
-
Berita & Media. Aggregator melakukan web scraping pada situs berita untuk mengkurasi konten dari berbagai sumber.
-
Perjalanan. Agen perjalanan melakukan web scraping pada situs maskapai penerbangan dan hotel untuk perbandingan harga dan pembuatan penawaran.
Alat & Teknik Penggoresan Web
Terdapat banyak alat dan teknik yang tersedia untuk penggoresan web, mulai dari ekstensi browser sederhana hingga perangkat lunak yang kompleks.
1. Browser Tanpa Antarmuka Pengguna
Foto dari Vecteezy
Browser headless memainkan peran penting dalam web scraping modern, terutama saat berurusan dengan platform seperti CloudFront.net. Inilah alasan mengapa browser headless sering kali sangat penting untuk melakukan scraping pada CloudFront.net:
-
Pemuatan Konten Dinamis. Banyak situs web, termasuk yang dihosting di CloudFront.net, menggunakan JavaScript untuk memuat konten secara dinamis.
Alat pengikisan tradisional hanya mengambil HTML awal dari sebuah halaman, yang mungkin tidak berisi semua data jika konten dimuat secara asinkron melalui JavaScript.
Browser headless dapat menjalankan JavaScript, sehingga memungkinkan pengikis untuk mengakses konten yang dimuat secara dinamis.
-
Meniru Perilaku Pengguna Nyata. Browser headless dapat meniru interaksi pengguna yang sebenarnya, seperti menggulir, mengklik tombol, atau mengisi formulir.
Kemampuan ini sangat penting ketika data yang ingin Anda ambil berada di balik interaksi pengguna tertentu.
-
Menampilkan Halaman Web. Beberapa konten di CloudFront.net mungkin ditampilkan menggunakan kerangka kerja web seperti React, Angular, atau Vue.js. Kerangka kerja ini sering kali memerlukan lingkungan peramban untuk menampilkan konten halaman dengan benar.
Browser headless dapat menampilkan halaman-halaman ini, memastikan bahwa scraper melihat halaman tersebut sama seperti yang dilihat oleh pengguna manusia.
-
Cookie dan Sesi. Browser headless dapat mengelola cookie dan sesi, yang mungkin diperlukan untuk mengakses konten tertentu di CloudFront.net, terutama jika memerlukan otentikasi pengguna atau pelacakan sesi.
-
Debugging dan Pengembangan. Browser headless sering kali dilengkapi dengan alat pengembang yang memungkinkan debugging dan pengujian skrip pengikisan.
Fitur ini sangat berharga saat mengembangkan dan menyempurnakan strategi pengikisan untuk situs web yang kompleks.
2. Python & BeautifulSoup
Python adalah bahasa pemrograman serbaguna yang banyak digunakan untuk pengikisan web, memungkinkan Anda menulis baris kode sesuai kebutuhan. Bahasa ini memiliki pustaka yang sederhana namun lengkap, salah satunya adalah BeautifulSoup.
Foto dari Pexels
BeautifulSoup adalah pustaka Python yang memungkinkan Anda mengumpulkan informasi dari halaman web. Pustaka ini membuat pohon penguraian (parse tree) dari kode sumber halaman, yang dapat digunakan untuk mengekstrak data secara hierarkis dan lebih mudah dibaca.
Dikombinasikan dengan pustaka `requests` Python untuk mengambil halaman web, BeautifulSoup membuat proses pengikisan web menjadi mudah dan efisien.
Fitur Utama BeautifulSoup
- Parsing yang Mudah. Dapat mengurai file HTML atau XML yang terstruktur dengan baik maupun yang tidak terstruktur dengan baik.
- Metode Pencarian. Menyediakan metode seperti `find()`, `find_all()`, dan `select()` untuk menavigasi dan mencari dalam pohon parsing.
- Manipulasi Tag. Memungkinkan manipulasi tag dan atribut dengan mudah.
- Pengkodean. Secara otomatis mengonversi dokumen yang masuk ke Unicode dan dokumen yang keluar ke pengkodean UTF-8.
3. Proksi untuk Pengikisan Web yang Lebih Baik
Proksi bertindak sebagai perantara antara pengguna dan internet. Proksi memainkan peran penting dalam pengikisan web karena beberapa alasan:
-
Anonimitas. Pengikisan web dapat mengakibatkan pemblokiran IP jika situs web mendeteksi lalu lintas yang tidak biasa dari satu alamat IP.
Proksi menyembunyikan IP asli pengikis, memastikan anonimitas, dan mengurangi risiko terdeteksi serta diblokir.
-
Penargetan Geografis. Beberapa situs web menampilkan konten yang berbeda berdasarkan lokasi geografis pengguna.
Proksi memungkinkan pengikis data mengakses konten dari wilayah tertentu dengan menggunakan alamat IP dari wilayah tersebut.
-
Pembatasan Kecepatan. Situs web sering kali menerapkan pembatasan kecepatan untuk mencegah kelebihan beban. Dengan bergantian menggunakan beberapa alamat IP proxy, scraper dapat mengirimkan lebih banyak permintaan ke situs web tanpa menabrak batasan laju.
Foto dari Pexels
-
Pengikisan Paralel. Penggunaan beberapa proxy memungkinkan permintaan dilakukan secara bersamaan, sehingga mempercepat proses ekstraksi data, terutama untuk tugas pengikisan data berskala besar.
-
Mengurangi Pemblokiran. Situs web menggunakan berbagai langkah anti-pengikisan data. Proxy, terutama jika diganti secara berkala, dapat membantu melewati langkah-langkah tersebut, sehingga memastikan proses pengikisan data berjalan tanpa gangguan.
Mengapa Mengumpulkan Data dari CloudFront.net?
Berikut adalah beberapa aplikasi nyata untuk data yang dapat dikumpulkan dari CloudFront.net (atau situs web yang disajikan melalui CloudFront):
-
Analisis Kompetitif. Perusahaan mungkin ingin memahami konten, struktur, atau aset situs web pesaing yang disajikan melalui CloudFront untuk mengevaluasi strategi online, penawaran, atau kehadiran digital mereka.
-
Agregasi Konten. Agregator, seperti platform berita atau perbandingan harga, mungkin melakukan pengumpulan data dari situs yang disajikan melalui CloudFront untuk mengumpulkan dan menyajikan informasi terpadu kepada pengguna mereka, memberikan nilai tambah melalui data yang komprehensif.
-
Tujuan Penelitian dan Akademik. Para peneliti atau mahasiswa mungkin melakukan scraping terhadap situs web di CloudFront untuk mengumpulkan data guna proyek akademik, studi, atau makalah, dengan tujuan menganalisis tren, pola, atau fenomena.
[Foto](https://Photo oleh Vlada Karpovich https) dari Pexels
-
Analisis SEO. Para profesional SEO mungkin melakukan scraping pada situs yang disajikan melalui CloudFront untuk memahami strategi SEO on-page, profil backlink, atau struktur konten mereka, guna membantu menyempurnakan taktik SEO mereka sendiri atau klien mereka.
-
Pemantauan Konten. Merek atau individu mungkin ingin memantau situs web tertentu di CloudFront untuk mencari sebutan, ulasan, atau pembaruan, sehingga mereka dapat tetap mendapat informasi terbaru dan bereaksi dengan cepat terhadap konten baru.
-
Pencadangan dan Pengarsipan. Beberapa entitas mungkin ingin membuat cadangan konten web mereka sendiri yang disajikan melalui CloudFront, memastikan mereka memiliki versi historis atau arsip untuk referensi di masa depan.
-
Analisis Pasar. Bisnis e-commerce atau analis pasar mungkin melakukan penggalian data (scraping) terhadap daftar produk, ulasan, atau data harga dari situs di CloudFront untuk memahami tren pasar, preferensi konsumen, atau strategi penetapan harga.
Penting untuk dicatat bahwa meskipun kasus penggunaan ini menyajikan alasan yang sah untuk pengikisan web, pastikan selalu untuk melakukan pengikisan secara etis, terutama saat berurusan dengan situs yang disajikan melalui CDN yang andal seperti CloudFront.
Cara Mengambil Data dari CloudFront.net
- Tentukan URL Target. Tentukan URL CloudFront.net spesifik yang ingin Anda ambil datanya.

- Periksa Halaman Web. Gunakan alat pengembang browser untuk memeriksa struktur halaman dan mengidentifikasi data yang ingin Anda ekstrak.

- Tulis Skrip Pengikisan. Manfaatkan pustaka Python untuk menulis skrip yang mengambil dan mengurai halaman web.
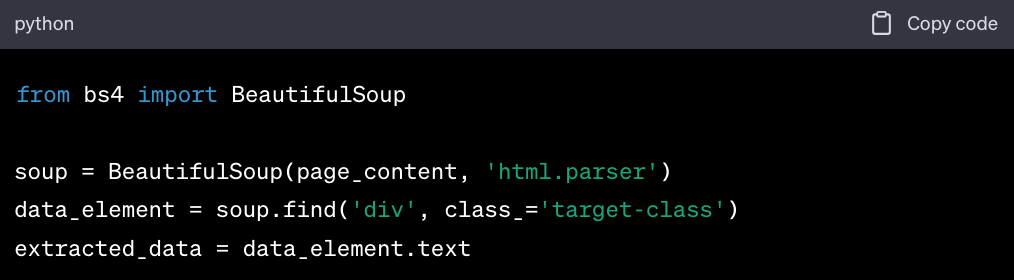
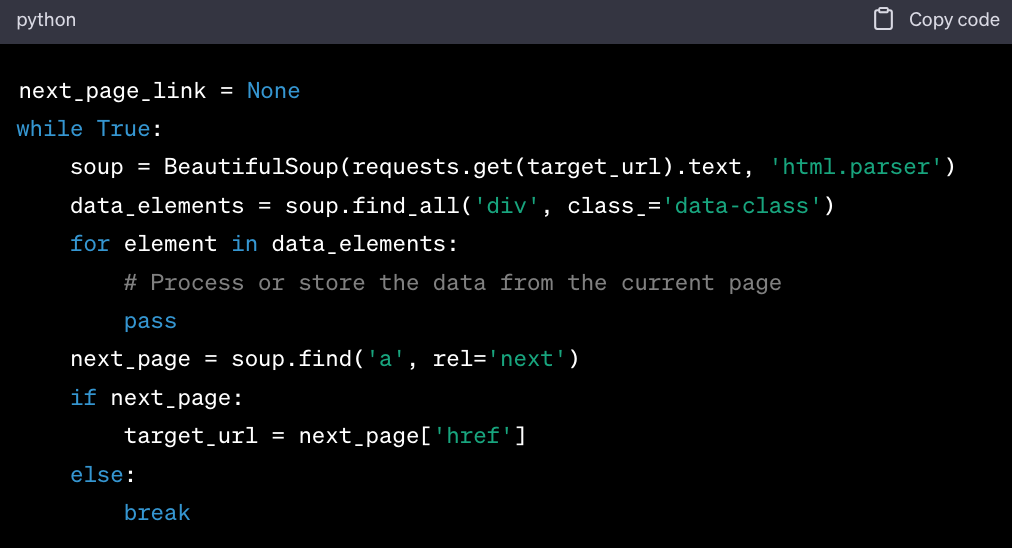
- Tangani Paginasi. Jika konten tersebar di beberapa halaman, pastikan skrip Anda dapat menavigasi dan mengekstrak data dari semua halaman. (Dengan asumsi setiap halaman memiliki tombol "Berikutnya" yang mengarah ke halaman berikutnya.)
- Simpan Data. Simpan data yang telah di-scrape dalam format terstruktur seperti file CSV, JSON, atau database.

- Patuhi Berkas
robots.txt: Selalu periksa dan patuhi berkas robots.txt dari CloudFront.net untuk memastikan Anda tidak melanggar aturan pengambilan data apa pun. 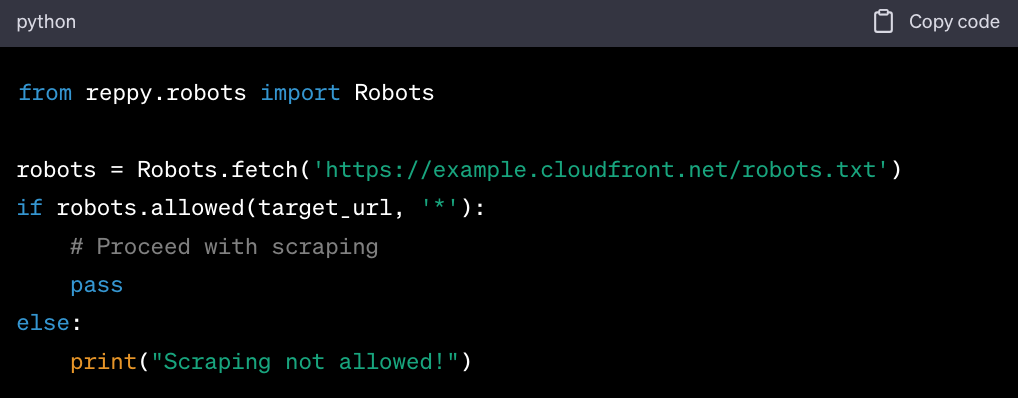
Memahami Aspek Hukum dalam Pengambilan Data dari CloudFront.net
Pengambilan data web, terutama pada platform seperti CloudFront.net, memerlukan pemahaman yang mendalam mengenai seluk-beluk hukum yang terlibat, seperti
-
Ketentuan Layanan (ToS). Sebelum melakukan pengambilan data dari CloudFront.net atau situs lain mana pun, selalu tinjau ToS-nya.
Selalu tinjau Ketentuan Layanan AWS sebelum memulai aktivitas pengambilan data apa pun di CloudFront.net atau layanan AWS lainnya. Mengabaikan ketentuan ini dapat menimbulkan konsekuensi hukum.
-
Undang-Undang Hak Cipta. Data di CloudFront.net, meskipun dapat diakses publik, mungkin dilindungi oleh hak cipta.
Pastikan data yang diekstraksi digunakan dengan cara yang tidak melanggar undang-undang ini.
Foto dari Pexels
-
Peraturan Perlindungan Data. Peraturan seperti GDPR dan CCPA menekankan privasi pengguna.
Saat melakukan scraping data pribadi dari CloudFront.net, pastikan kepatuhan terhadap undang-undang ini, termasuk penyimpanan yang aman dan izin yang diperlukan.
-
Undang-Undang Penipuan dan Penyalahgunaan Komputer (CFAA). Undang-undang AS ini mengkriminalisasi akses tanpa izin ke sistem komputer.
Pastikan aktivitas pengumpulan data Anda di CloudFront.net tidak melanggar Ketentuan Layanan (ToS) untuk menghindari konflik dengan CFAA.
Menghormati Batasan Digital di CloudFront.net
Web scraping yang etis berarti menghormati ruang digital platform seperti CloudFront.net:
-
Pembatasan Laju (Rate Limiting). Hindari membebani CloudFront.net dengan mengirimkan terlalu banyak permintaan dalam waktu singkat.
Patuhi batasan laju apa pun dan atur jarak waktu antara aktivitas scraping Anda.
-
Informasi Sensitif. CloudFront.net mungkin menyimpan data pribadi atau sensitif. Prioritaskan privasi pengguna dan hindari web scraping yang berbahaya.
-
Sebutkan Sumber. Jika menggunakan data dari CloudFront.net untuk penelitian atau tujuan lain, selalu cantumkan platform tersebut sebagai sumbernya.
-
Minta Izin. Jika ragu tentang pengikisan data di CloudFront.net, sebaiknya mintalah izin dari administrator platform.
Mengatasi Langkah-Langkah Anti-Pengikisan di CloudFront.net
CloudFront.net, seperti banyak platform lainnya, mungkin memiliki langkah-langkah untuk mencegah pengikis data:
- User-Agent. CloudFront.net mungkin memblokir user-agent pengikis data yang sudah dikenal. Gantilah user-agent secara berkala atau tiru perilaku browser asli untuk melewati pemblokiran ini.
- CAPTCHA. CloudFront.net mungkin menggunakan CAPTCHA untuk memverifikasi pengguna manusia. Meskipun ada alat untuk mengatasinya, tantangan yang sering muncul dapat mengakibatkan pemblokiran IP.
- Pemblokiran IP. Jika CloudFront.net mendeteksi aktivitas yang tidak biasa, platform ini mungkin akan memblokir IP tersebut. Gunakan proxy secara bertanggung jawab untuk mengganti-ganti alamat IP dan melanjutkan proses scraping.
- Honeypot. Waspadalah terhadap perangkap honeypot di CloudFront.net—titik data palsu yang disiapkan untuk mendeteksi scraper.
Mengoptimalkan Tugas Penggoresan Data di CloudFront.net dengan Proksi Residensial Geonode
Mengintegrasikan proksi Geonode dengan alat dan skrip penggalian data web dapat secara signifikan meningkatkan proses penggalian data, terutama saat menargetkan platform yang tangguh seperti CloudFront.net.

Geonode telah menonjol sebagai penyedia layanan proxy berkat beragam fitur unggulannya.
Dikenal karena jaringan proxy yang andal yang memastikan waktu henti minimal dan kinerja yang konsisten, Geonode menawarkan cakupan yang luas, didukung oleh sejumlah besar alamat IP yang tersebar di berbagai negara.
Selain itu, Geonode menawarkan waktu respons yang cepat berkat infrastrukturnya yang kokoh, sebuah faktor penting untuk penggalian data web yang efisien. Layanan ini menyediakan koneksi yang aman dan memenuhi berbagai kebutuhan penggalian data web, menjamin privasi data serta perlindungan terhadap potensi ancaman.
Pertanyaan Lainnya
Bagaimana CloudFront.net meningkatkan pengiriman konten?
CloudFront.net adalah layanan jaringan pengiriman konten (CDN) yang disediakan oleh Amazon Web Services (AWS).
Secara sederhana, CDN mirip dengan jaringan kurir pengiriman cepat yang tersebar di seluruh dunia, memastikan bahwa konten online sampai ke pengguna dengan cepat dan efisien. Begini cara kerjanya:
-
Distribusi Global. CloudFront memiliki banyak pusat data, yang dikenal sebagai lokasi tepi (edge locations), yang tersebar di seluruh dunia.
Ketika pengguna meminta konten, konten tersebut dikirimkan dari lokasi tepi terdekat, sehingga memastikan penundaan atau latensi yang minimal.
-
Terintegrasi dengan AWS. Sebagai bagian dari ekosistem AWS, CloudFront terintegrasi secara mulus dengan layanan AWS lainnya.
Jika situs web atau aplikasi Anda dihosting di AWS, menggunakan CloudFront dapat membuat pengiriman konten menjadi lebih efisien.
-
Konten Dinamis dan Statis. Meskipun beberapa CDN paling cocok untuk mengirimkan konten statis (seperti gambar atau lembar gaya), CloudFront mahir dalam mengirimkan konten statis dan dinamis (seperti halaman web khusus pengguna).
-
Keamanan. CloudFront menawarkan fitur keamanan yang tangguh, termasuk HTTPS untuk transfer data yang aman, perlindungan terhadap serangan DDoS, dan integrasi dengan Web Application Firewall AWS.
-
Hemat Biaya. Dengan model "pay-as-you-go", pengguna hanya membayar untuk konten yang mereka kirimkan, menjadikannya solusi hemat biaya bagi bisnis dari segala skala.
Intinya, CloudFront.net memastikan bahwa konten online Anda sampai ke pengguna dengan cepat, aman, dan efisien, di mana pun mereka berada di dunia.
Mengapa proxy seperti Geonode sangat penting untuk web scraping?
Web scraping melibatkan pengumpulan berbagai jenis data dari situs web. Namun, proses ini tidak selalu mudah.
Situs web mungkin memiliki langkah-langkah untuk memblokir atau membatasi akses otomatis. Di sinilah proxy, terutama yang andal seperti Geonode, berperan:
-
Melewati Pembatasan. CloudFront.net, sebagai bagian dari rangkaian layanan AWS, memiliki langkah-langkah keamanan yang kuat.
Proksi Geonode dapat membantu melewati pembatasan berbasis IP dan mengakses data tanpa memicu peringatan.
-
Penyeimbangan Beban. Saat mengumpulkan dataset besar dari CloudFront.net, proxy Geonode dapat mendistribusikan permintaan, memastikan penyeimbangan beban yang efisien dan pengambilan data yang lebih cepat.
-
Akses Data Terbaru. CloudFront.net mungkin menyajikan konten yang disimpan dalam cache berdasarkan lokasi geografis permintaan.
Rentang alamat IP yang luas dariGeonode memastikan akses ke data terbaru dan real-time.
-
Penanganan Kesalahan. Jika terjadi pemblokiran atau captcha, skrip yang terintegrasi dengan Geonode dapat secara otomatis beralih ke proxy lain, memastikan proses pengikisan data berjalan tanpa gangguan.
-
Penghindaran Batas Frekuensi. CloudFront memiliki batasan jumlah permintaan dari satu alamat IP dalam waktu tertentu.
Dengan bergantian menggunakan proxy Geonode, pengikis data dapat melakukan permintaan lebih sering tanpa diblokir.
-
Keandalan. Tidak semua proxy diciptakan sama. Geonode dikenal karena proxy-proxy yang stabil dan berkecepatan tinggi, memastikan proses pengikisan data yang efisien dan tanpa gangguan.
-
Keamanan. Menggunakan proxy dari Geonode memastikan koneksi yang aman, melindungi alat pengikis data dari ancaman potensial dan mata-mata.
Bagi siapa pun yang serius dalam web scraping, proxy yang andal seperti Geonode bukan hanya bermanfaat; melainkan sangat penting.
Apakah web scraping legal?
Di AS, legalitas web scraping telah menjadi topik perdebatan dan telah dibahas dalam berbagai kasus pengadilan.
Salah satu kasus yang paling sering dikutip adalah hiQ Labs, Inc. v. LinkedIn Corp., di mana Pengadilan Banding Sirkuit Kesembilan memutuskan bahwa pengambilan data dari situs web yang dapat diakses publik kemungkinan besar tidak melanggar CFAA.
Pengadilan memutuskan mendukung hiQ, sebuah perusahaan yang mengambil data LinkedIn yang tersedia untuk umum.
Keputusan pengadilan tersebut didasarkan pada interpretasi bahwa CFAA menargetkan pelanggaran terhadap pembatasan akses komputer, bukan penyalahgunaan data oleh pihak yang telah memiliki akses yang sah.
Meskipun pengambilan data dari situs web (web scraping) pada dasarnya tidak ilegal, sangat penting untuk melakukannya secara bertanggung jawab.
Selalu patuhi Ketentuan Layanan (ToS) situs web, perhatikan undang-undang hak cipta dan perlindungan data, dan jika ragu, mintalah nasihat hukum.
Kesimpulan
Interaksi antara CloudFront.net, web scraping, dan proxy Geonode menggambarkan gambaran yang menarik mengenai efisiensi, inovasi, dan perolehan data yang bertanggung jawab.
Dengan jangkauan globalnya, CloudFront.net memfasilitasi pengiriman konten yang cepat dan mendukung pengalaman pengguna yang lancar.
Sementara itu, web scraping membuka wawasan yang signifikan, yang mendorong penelitian dan inovasi jika digunakan secara etis.
Proksi Geonode melengkapi proses ini, memungkinkan navigasi web secara anonim, melewati pembatasan geografis, dan mendukung aliran data yang stabil.
Namun, saat kita memanfaatkan kemampuan gabungan dari CloudFront.net, web scraping, dan proxy Geonode, sangatlah penting untuk memprioritaskan praktik-praktik etis.
Foto dari Vecteezy
Menghormati batasan digital, mematuhi pedoman hukum, serta menjamin privasi dan hak-hak entitas daring harus menjadi prioritas utama dalam setiap upaya.
Mari kita semua berkomitmen pada praktik etis dan terus mengejar pengetahuan. Dunia digital terus berkembang, dan dengan bertindak secara bertanggung jawab serta tetap terinformasi, kita dapat memastikan bahwa tindakan kita tidak hanya menguntungkan diri kita sendiri, tetapi juga komunitas online yang lebih luas.
.

