
マイクロブログシステムというささやかな始まりから、Twitterは今や世界的なコミュニケーションの巨人に成長しました。
3億3000万人以上のアクティブユーザーを擁し、毎日5億件以上のツイートが投稿されるこのソーシャルメディアプラットフォームは、世界中の会話やトレンド、世論の動向を反映する豊富なデータ源となっています。
この膨大なデータは、ソーシャルメディアネットワークの分析に熱心な企業、研究者、マーケター、そしてデータ愛好家にとって、計り知れない可能性を秘めています。

Maricor Bunal
更新日:2026年10月7日
公開日:2023年8月14日
マイクロブログシステムというささやかな始まりから、Twitterは今や世界的なコミュニケーションの巨人に成長しました。
3億3000万人以上のアクティブユーザーを擁し、毎日5億件以上のツイートが投稿されるこのソーシャルメディアプラットフォームは、世界中の会話やトレンド、世論の動向を反映する豊富なデータ源となっています。
この膨大なデータは、ソーシャルメディアネットワークの分析に熱心な企業、研究者、マーケター、そしてデータ愛好家にとって、計り知れない可能性を秘めています。
Twitterのデータは、そのリアルタイム性や膨大な量の世論を反映しているという特性から、以下のようなさまざまな分野で多岐にわたる用途に活用できます。
• ブランドモニタリング。 企業はTwitterデータを活用して、自社ブランドに関する言及をリアルタイムで監視できます。これにより、顧客からの苦情や問い合わせに迅速に対応したり、マーケティングキャンペーンの効果を追跡したり、自社ブランドに対する世論の動向を把握したりすることが可能になります。例えば、ある製品に対する否定的な言及が急増した場合は、早急に対処すべき問題が発生していることを示唆している可能性があります。
• トレンド分析。Twitterは新しいトレンドが最初に現れる場であることが多く、トレンド分析にとって貴重な情報源となります。ツイートの内容を分析することで、企業は業界内の新たなトレンドを特定し、特定のトピックの人気度を長期的に追跡し、さらには将来のトレンドを予測することさえ可能です。これは、製品開発からマーケティング、販売に至るまでのビジネス戦略の策定に役立ちます。
• 学術研究。社会学、言語学、政治学などの分野の研究者は、Twitterのデータを様々な目的に活用できます。例えば、ユーザーのツイートを分析して言語使用を研究したり、情報や誤情報の拡散を調査したり、特定の出来事や政策に対する世論の反応を調査したりすることが可能です。
• ジャーナリズム。ジャーナリストは、Twitterのデータを活用して速報を見つけたり、ニュースの展開を追跡したり、様々な問題に対する世論を測ったりすることができます。場合によっては、ツイート自体がニュース記事になることもあります。例えば、著名人によるツイートは大きな影響を与えることがあり、メディアで頻繁に取り上げられます。
これらは、数十億件に及ぶツイートデータがどのように活用できるかの一例に過ぎません。その可能性は計り知れず、自分の考えや経験を共有するために他のソーシャルメディアプラットフォームからTwitterへ移行する人が増え続けるにつれて、その可能性はさらに広がり続けています。
Twitterからデータをスクレイピングすることの合法性は、どのデータをスクレイピングするか、そしてそれをどのように利用するかによって異なります。
原則として、データが一般に公開されており、利用規約やプライバシー関連法に違反していない限り、Twitterデータのウェブスクレイピングは合法とみなされます。
ただし、大規模なウェブスクレイピングプロジェクトに着手する前には、必ず法律の専門家に相談することをお勧めします。
Twitterのスクレイピング手法について詳しく説明する前に、Twitter上で利用可能な4種類のデータと、そこから得られる可能性のある知見を理解しておくことが不可欠です。
• ツイート。 ツイートは、Twitterにおける最も基本的な情報の単位です。ユーザーが投稿するメッセージであり、最大280文字まで入力できます。各ツイートには、ツイート本文、投稿日時、獲得した「いいね」や「リツイート」の数、使用されたハッシュタグなど、豊富なデータが含まれています。 ツイートデータを分析することで、トレンドトピック、特定のテーマに対する感情、ハッシュタグのリーチなどに関する知見を得ることができます。
• ユーザー。ユーザーデータとは、Twitterアカウントに関連する情報を指します。これには、ユーザー名、プロフィール説明、所在地、フォロワー数とフォロー数、ツイート数、アカウント作成日などが含まれます。 ユーザーデータを分析することで、ユーザー層の人口統計に関する知見を得たり、特定の分野におけるインフルエンサーを特定したり、Twitterアカウントの経時的な成長を追跡したりすることができます。
• エンティティ。Twitterデータにおけるエンティティとは、ツイートに関連付けられた対象を指します。 これには、ハッシュタグ、ユーザーメンション、URL、メディア(写真や動画)などが含まれます。エンティティは、ツイートの文脈を理解するための手がかりとなります。例えば、ツイートに関連付けられたハッシュタグを分析することで、議論されているトピックを特定でき、ユーザーメンションを調べることで、相互作用のネットワークを明らかにすることができます。
• 場所。このデータは、ツイートやユーザーに関連付けられた地理情報を指します。これには、ツイートが投稿された場所や、ユーザーのプロフィールに指定された場所などが含まれます。場所データを分析することで、地理的な傾向、地域間の情報の広がり、あるいは異なる地域におけるトピックの人気度に関する洞察を得ることができます。
各データタイプにはそれぞれ独自の重要性があり、独自の洞察をもたらします。例えば、ツイートデータはトレンドトピックや世論の把握に役立ち、ユーザーデータはインフルエンサーやオーディエンスの人口統計を明らかにし、エンティティは議論の文脈を提供し、場所データは地理的な傾向を明らかにすることができます。
こうした各種類のデータを理解し分析することで、Twitterから豊富な知見を引き出すことができます。市場調査、ブランドモニタリング、学術研究、ジャーナリズムのいずれの目的であれ、Twitterデータは、世論を理解し、トレンドを追跡し、世界的な会話の動向を把握するための、豊かでダイナミックなリソースとなります。
Twitterの公式APIを利用すれば、開発者はプログラムを通じてTwitterプラットフォームとやり取りすることができます。このAPIを通じて、ツイートやTwitterプロフィールなど、さまざまな種類のデータにアクセスできます。
• 構造化されたデータ。APIから返されるデータは適切に構造化され、一貫性があるため、処理や解析が容易です。
• 信頼性。APIはTwitter自体が提供しているため、サービスの信頼性と継続性が保証されています。
• 充実したドキュメント。TwitterはAPIに関する詳細なドキュメントを提供しており、開発者がAPIを理解し、効果的に活用しやすくなっています。
• レート制限。不正利用を防ぐため、Twitterは一定期間におけるAPIの利用に制限を設けています。 例えば、ユーザー認証済みのアプリでは、ユーザーのタイムラインに対するリクエストは15分間に900回までしか行えません。
• データへのアクセス。すべてのデータがAPI経由でアクセスできるわけではありません。例えば、ユーザーのタイムラインからは最新の3200件のツイートにしかアクセスできません。
• 費用。TwitterはAPIの無料プランを提供していますが、これには大きな制限があります。より多くのデータへのアクセスやリクエスト制限の引き上げには有料プランの契約が必要であり、その費用はかなり高額になる場合があります。
Twitter API は、開発者がプログラムを通じて幅広い Twitter データにアクセスできるようにする強力なツールです。その使用方法について、ステップバイステップで解説します:
1. 開発者アカウントの設定
• Twitterのデベロッパーサイトへアクセスします (https://developer.twitter.com/ ).
• 「Apply」ボタンをクリックします。
• Twitterアカウントへのログインを求められます。アカウントをお持ちでない場合は、作成する必要があります。
• ログイン後、開発者アカウントの申請フォームに必要事項を入力してください。申請フォームでは、APIをどのように利用する予定かについて詳細を求められます。承認される可能性を高めるため、できるだけ詳しく記入してください。
• 申請を送信したら、Twitterからの承認を待ちます。数日かかる場合があるため、辛抱強くお待ちください。
2. アプリの作成とAPIキーの取得
• Twitter開発者アカウントにログインします。
• 「ダッシュボード」に移動し、「アプリを作成」をクリックします。
• フォームにアプリの詳細を入力します。名前、説明、ウェブサイトのURLを入力し、アプリをどのように使用する予定かをTwitterに伝えてください。
• アプリの作成後に表示されるページにあるAPIキーをメモしておいてください。キーには2種類あります。APIキーとシークレット、およびアクセストークンとシークレットです。 APIを使用する際、アプリの認証にはこれらのキーが必要になります。
3. Tweepyを使用してTwitterのScraper API にアクセスする
以下の手順に従ってください:
• Tweepyライブラリをインポートします。
• APIキーを使用してTwitterに認証します。
• TwitterのAPIとやり取りするために使用できるAPIオブジェクトを作成します。
• user_timelineメソッドを使用して、ユーザーのタイムライン(この場合は「twitter」)から最新のツイートを取得し、各ツイートのテキストを出力します。
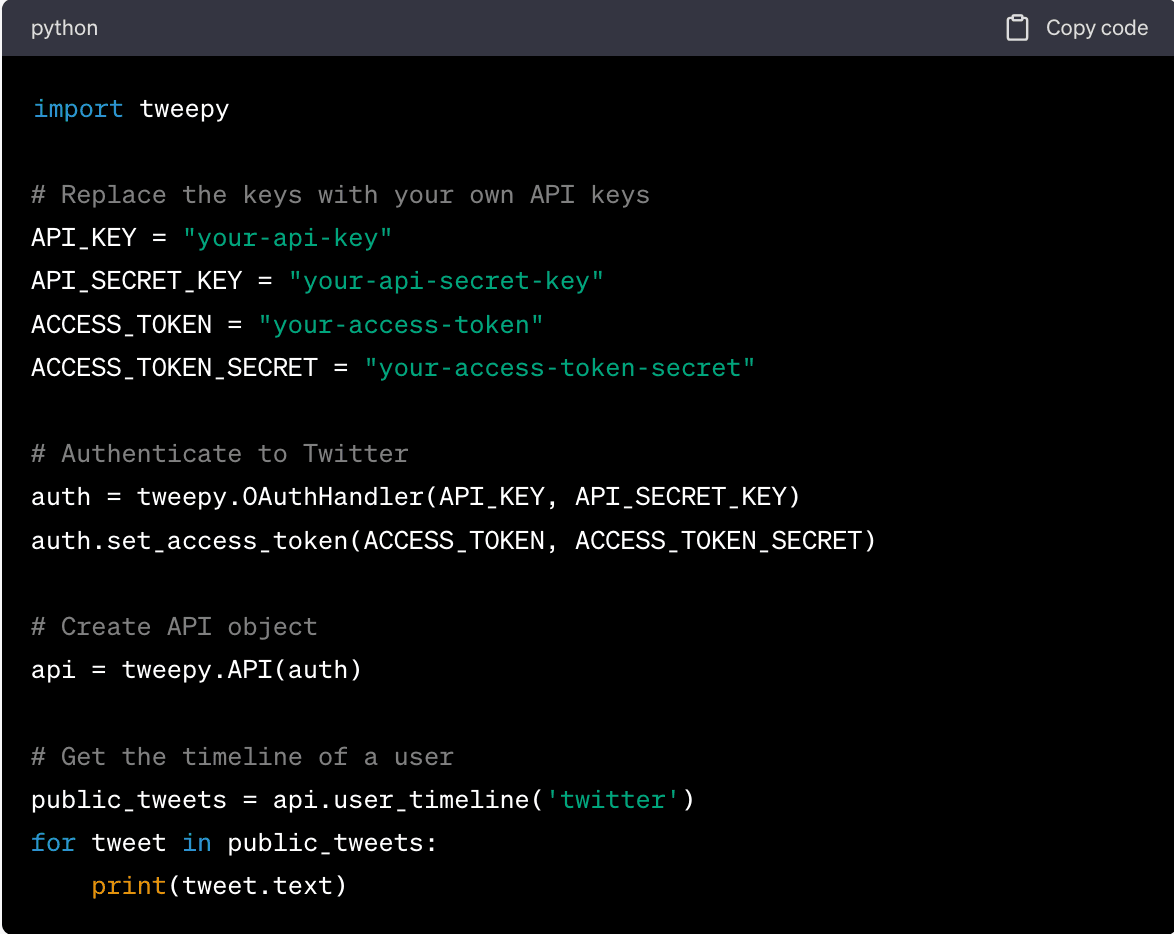
「your-api-key」、「your-api-secret-key」、「your-access-token」、「your-access-token-secret」は、必ずご自身のAPIキーに置き換えてください。また、「twitter」は、ツイートを取得したいTwitterアカウントのユーザー名に置き換えてください。
これは簡単な例ですが、Tweepyにはさまざまな種類のTwitterデータにアクセスするためのメソッドが他にも多数用意されています。詳細については、Tweepyのドキュメントをご確認ください。
要約すると、Twitter APIはTwitterデータにアクセスするための信頼性が高く構造化された方法を提供していますが、レート制限、データアクセス、コストの面で制約があります。 これらの制限は、大規模なデータ抽出プロジェクトにとって大きな障壁となる可能性があります。そのような場合、ウェブスクレイピングはより柔軟で費用対効果の高い代替手段となり得ます。これについては次のセクションで説明します。
Python を使った Twitter のウェブスクレイピングとは、Python プログラミング言語を使用して Twitter のウェブサイトからデータを自動的に抽出するプロセスです。このプロセスは、手作業では収集に時間がかかりすぎるような大量のデータを Twitter から収集するためによく使用されます。
• 強力なライブラリ。Pythonには、ウェブスクレイピングを簡素化する豊富なライブラリのエコシステムがあります。Tweepy、BeautifulSoup、Scrapy などのライブラリは、HTTPリクエストの発行からHTMLの解析、APIとの連携に至るまで、あらゆる処理を処理できます。
• 使いやすさ。Pythonの構文は明確かつ簡潔であるため、Webスクレイピングに適した言語です。複雑なスクレイピング作業であっても、比較的少ない行数のコードで実現できます。
• データ分析ツール。Pythonはデータ分析にも優れています。 Pandas、Numpy、Matplotlib といったライブラリを使えば、スクレイピングしたデータのクリーニング、分析、可視化が簡単に行えます。
• コミュニティのサポート。Python には大規模で活発なコミュニティがあり、オンラインでヘルプやリソースを簡単に見つけることができます。問題に直面しても、誰かがすでに解決策を提示している可能性が高いです。
• 動的コンテンツ。Pythonの標準的なウェブスクレイピングツールは、JavaScriptを使用して読み込まれる動的コンテンツの処理に苦戦します。Seleniumのようなライブラリを使用するなど、これを回避する方法もありますが、そうすることでTwitterスクレイピングプロジェクトの複雑さがさらに増してしまいます。
• レート制限。TwitterはAPIのレート制限を設けており、これがウェブスクレイピングプロジェクトの速度を低下させる可能性があります。複数のアカウントやIPアドレスを使用するなど、これを回避する方法もありますが、これらの方法はTwitterの利用規約に違反します。
• ウェブサイトの構造変更。 TwitterがウェブサイトやAPIの構造を変更した場合、スクレイピングコードが動作しなくなる可能性があります。これらの変更に対応するためにコードを更新する必要があり、これには時間がかかる場合があります。
1. 環境のセットアップ。 Pythonおよび必要なライブラリがまだインストールされていない場合は、インストールしてください。この例では、BeautifulSoupとRequestsを使用します。
2. スクレイピングしたいTwitterページにHTTPリクエストを送信します。
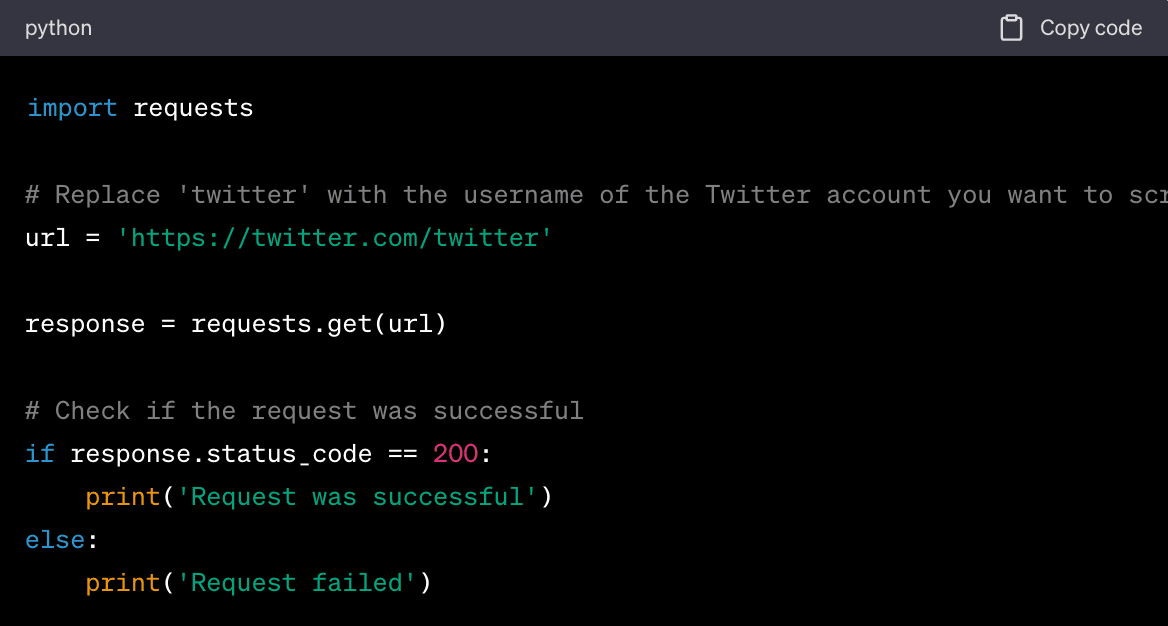
サーバーはリクエストに応答し、ウェブページのHTMLコンテンツを返します。
3. データを解析する。データはHTML形式であるため、目的のデータを解析・抽出できるパーサーが必要になります。
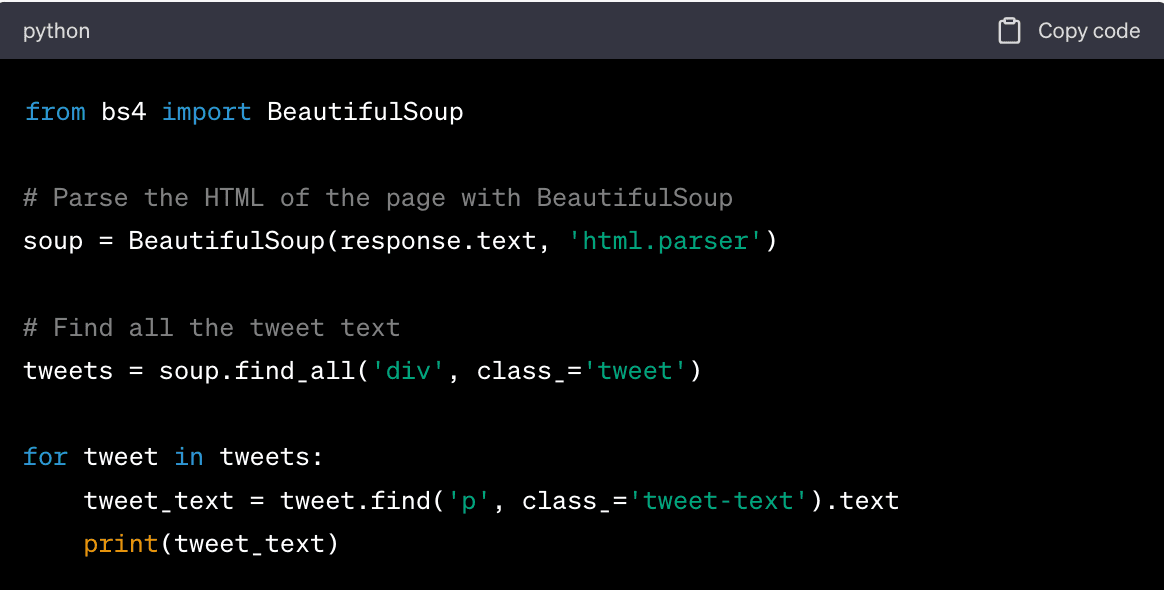
このコードでは、まずBeautifulSoupオブジェクトを作成し、ページのHTMLを解析します。次に、ツイートを格納しているクラス「tweet」を持つすべてのdiv要素を検索します。各ツイートについて、ツイートの本文を含むクラス「tweet-text」を持つp要素を検索し、それを表示します。
4. クエリメソッドを使用して特定のデータ要素を検索する。例えば、BeautifulSoupでは、find_all() などのメソッドを使用して、ヘッダータグや段落、その他の要素を特定することができます。
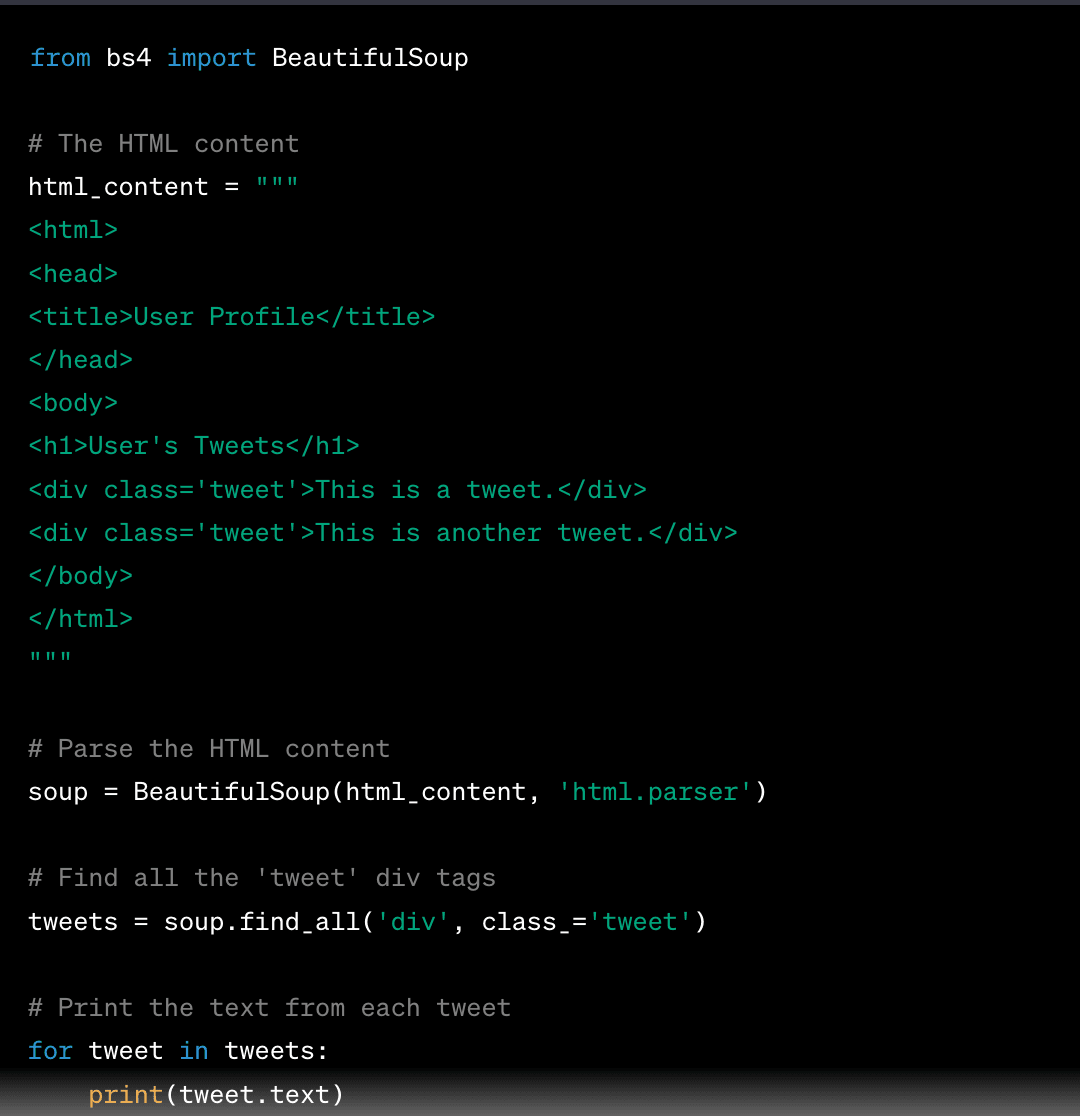
5. データをCSV、JSON、データベースなど、好みの形式で保存する。Pandasライブラリを使用してCSVファイルに保存する方法は以下の通りです:
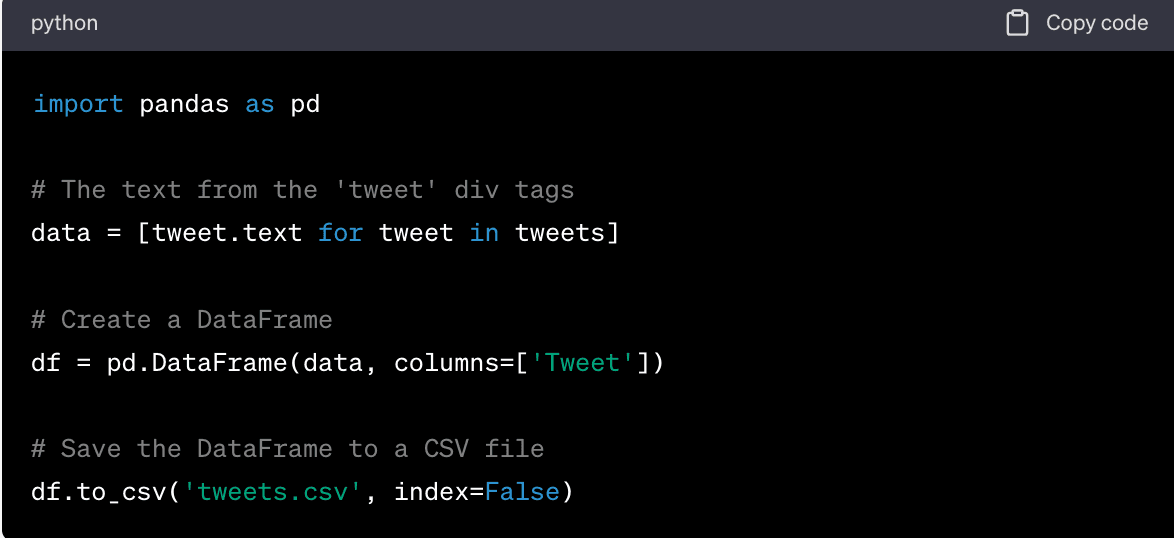
これにより、「tweets.csv」という名前のCSVファイルが作成され、その中の「Tweet」という単一の列には、「tweet」divタグ内のテキストが含まれます。PythonとBeautifulSoupを使用してツイートのテキストをスクレイピングする簡単な例を以下に示します:
Geonode のScraper API は、Twitterなどのウェブサイトからデータを抽出できる強力なツールです。最適なパフォーマンスと効率を実現するために、さまざまなスクレイピングモードが用意されています。
のPay-As-You-Go スクレイパーを使うべきか?
• 柔軟な価格体系。pay-as-you-go モデルでは、実際に使用した分だけ支払うことができます。これは、特に不定期または少量の利用の場合、サブスクリプションモデルよりも費用対効果が高い場合があります。
• 拡張性。 このScraper API は、小規模から大規模までのスクレイピングタスクに対応するように設計されています。つまり、利用制限に達することを心配することなく、必要に応じてスクレイピングタスクをスケールアップできます。
• 使いやすさ。Geonode のScraper API は、プログラミングの知識がない方でも簡単に利用できます。Twitterからデータを抽出するためのシンプルな方法を提供します。
• 高度な機能。Geonode のScraper API は、JavaScriptレンダリング、カスタムJSスニペットの実行、プロキシのローテーション、ジオターゲティングなど、幅広い高度な機能を提供しています。これらの機能は、複雑なスクレイピング作業において非常に役立ちます。
• リアルタイムモードとコールバックモード。このAPIでは、スクレイピング用に「リアルタイムモード」と「コールバックモード」の2つのモードが用意されています。これにより、スクレイピング結果の受け取り方を柔軟に選択できます。
のPay-As-You-Go スクレイパーの制限事項
• コストが積み重なる可能性:pay-as-you-go モデルは少量の利用では費用対効果が高いですが、大規模なスクレイピング作業ではコストが急速に膨らむ可能性があります。予期せぬ請求を避けるため、利用状況を監視することが重要です。
• 習得の難易度:GeoNode のScraper API は使いやすさを重視して設計されていますが、特にウェブスクレイピングやAPI全般に不慣れなユーザーにとっては、習得に時間がかかる場合があります。
• GeoNode のサービスへの依存:他のサードパーティ製サービスと同様に、スクレイピング作業はGeoNode のサービスに依存しています。同社のサービスに問題が生じた場合、スクレイピング作業に影響が出る可能性があります。
• 法的および倫理的な考慮事項:ウェブスクレイピングは法的にグレーゾーンとなる場合があります。GeoNode のScraper API を使えばデータを簡単にスクレイピングできますが、スクレイピング活動が、対象となるウェブサイトの利用規約および関連するプライバシー法に準拠していることを確認することが重要です。
1. リクエストの設定。 GeoNode Scraper API を使用するには、リクエストを設定する必要があります。このリクエストには、スクレイピングしたいページ(この場合はTwitterのページ)のURLと、スクレイパーの動作を制御する一連の設定を含める必要があります。 リクエストの構成例は以下の通りです:
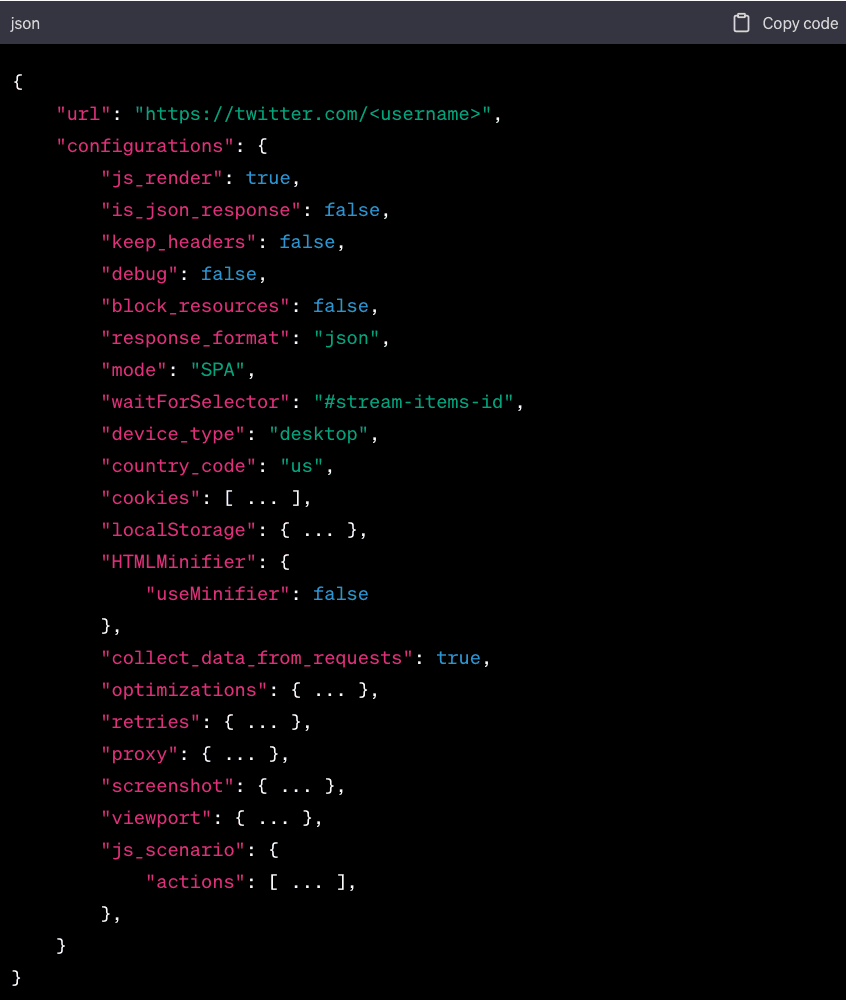
この例では、url はスクレイピング対象の Twitter ページです。waitForSelector パラメータは #stream-items-id に設定されています。これは、Twitter ページ上でツイートを格納する div の ID です。 これにより、スクレイパーは、この要素が読み込まれるまで待機してからページのスクレイピングを開始するよう指示されます。
2. リアルタイムモードとコールバックモード。 GeoNode Scraper API では、スクレイピングに「リアルタイムモード」と「コールバックモード」の2つのモードが用意されています。リアルタイムモードでは、スクレイピングが完了するとすぐにAPIが結果を返します。 コールバックモードでは、スクレイピングが完了すると、APIが指定されたコールバックURLに結果を送信します。ニーズに最も適したモードを選択できます。
3. タスクのステータスを確認する。 初期レスポンスで受け取ったリクエストIDを使用して、スクレイピングタスクのステータスを確認できます。 これにより、タスクの進行状況を追跡し、完了状態を確認することができます。
4. アクション。 Geonode Scraper API では、サポートされているアクションの一覧を通じて、対象のドキュメントとやり取りを行うことができます。例えば、スクレイピングの前に、アクションを使用してページ上のボタンをクリックしたり、フォームに入力したりすることができます。
Twitterデータをスクレイピングして保存したら、次はそれを分析します。手順は以下の通りです:
1. 基本的な分析。
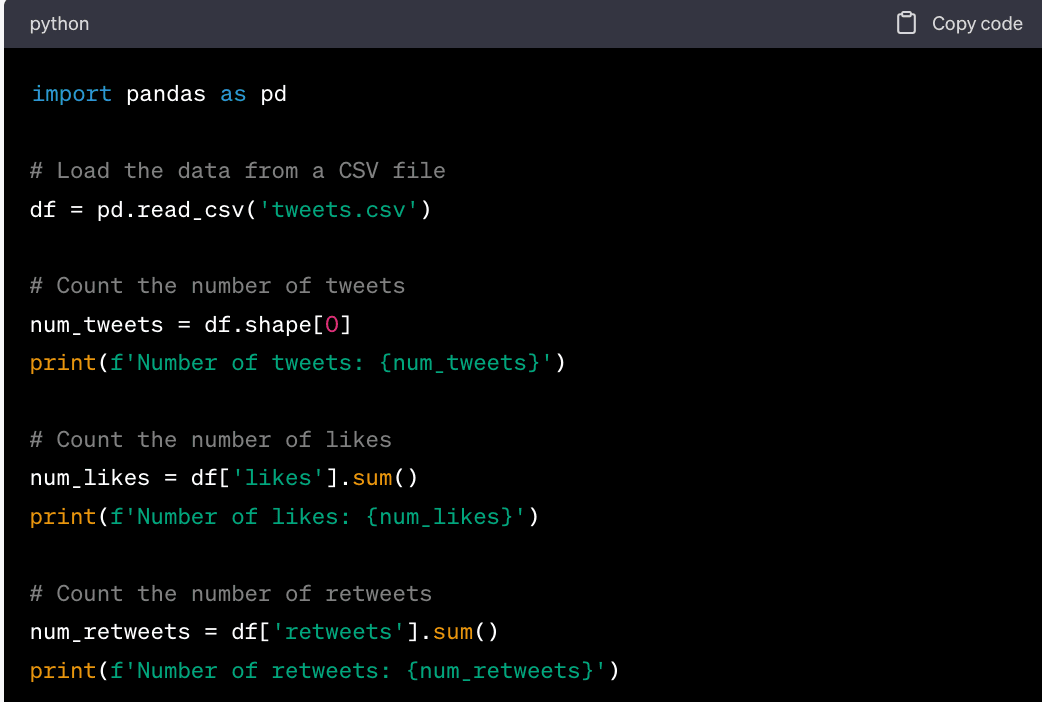
基本分析では、ツイート数、いいね数、リツイート数、その他の単純な指標をカウントします。Python用の強力なデータ分析ライブラリであるpandasを使用してこれを行う例を以下に示します:
2. センチメント分析
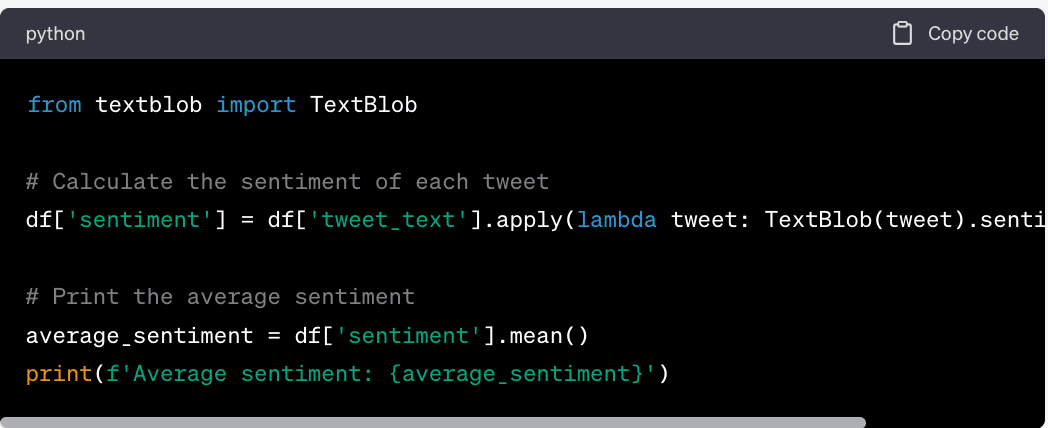
センチメント分析とは、ツイートなどのテキストの感情傾向を判定することです。テキストデータを処理するためのライブラリであるTextBlobを使用して行う例を以下に示します:
3. ネットワーク分析
ネットワーク分析とは、Twitterユーザー間のつながりを分析することです。これは、複雑なネットワークの構造、ダイナミクス、および機能を構築、操作、研究するためのPythonライブラリであるNetworkXを使用して行うことができます。
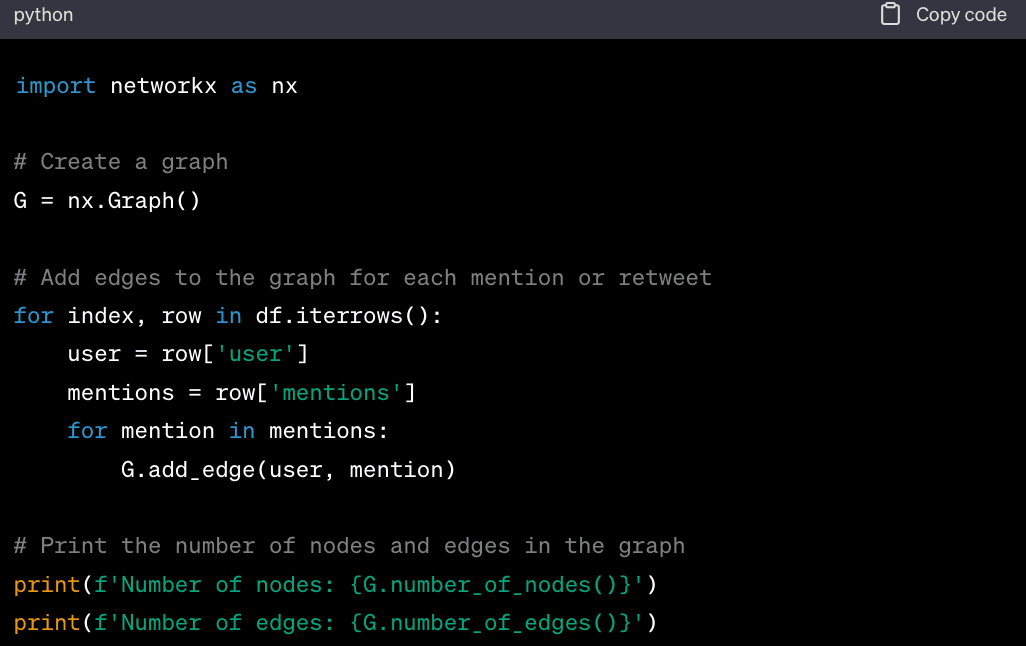
4. Twitterデータの可視化
Twitterデータを可視化することで、データをより深く理解することができます。これには、Python用のプロットライブラリであるMatplotlibを使用します:
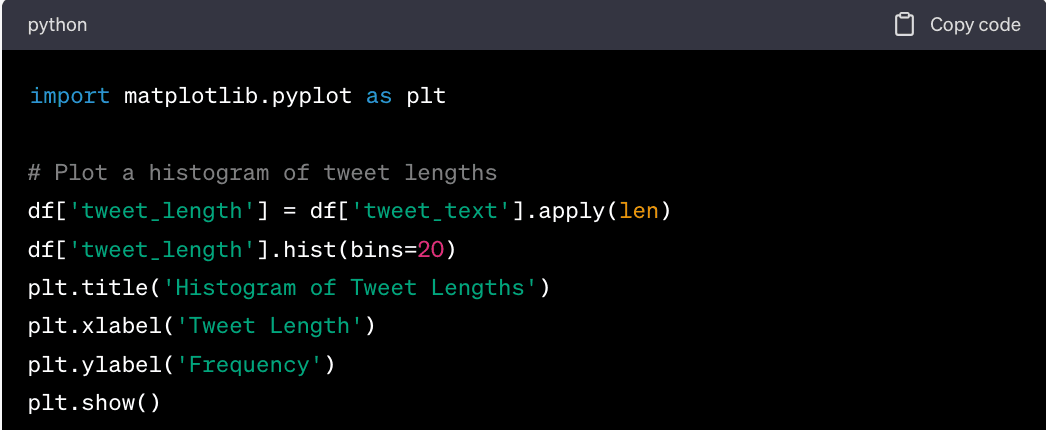
このコードでは、まず各ツイートの長さを計算します。次に、ツイートの長さの分布を示すヒストグラムをプロットします。
'tweets.csv' はご自身のCSVファイルへのパスに、'tweet_text'、'likes'、'retweets' はDataFrame内の実際の列名に置き換えることを忘れないでください。また、'user' と 'mentions' も、DataFrame内のユーザーおよびメンションの実際の列名に置き換えてください。
この包括的なガイドでは、Twitterデータのスクレイピングの重要性と手法について解説しました。Twitterは、世論、トレンド、リンクの膨大な情報源であり、市場調査やセンチメント分析からトレンド予測など、さまざまな目的に活用できる豊富なデータを提供しています。
このデータを抽出するための3つの主要な方法について詳しく見てきました:
TwitterのAPI。これは、Twitterが提供するデータとやり取りするための公式な方法です。強力なツールですが、レート制限や開発者アカウントの承認が必要であるなど、独自の制限があります。 とはいえ、特にTweepyのようなライブラリと併用すれば、Twitterのデータにアクセスするための信頼性が高く、シンプルな方法と言えます。
Pythonを用いたウェブスクレイピング。この方法では、BeautifulSoupやrequestsといったPythonライブラリを使用して、Twitterのウェブサイトを直接スクレイピングします。 この方法ではTwitter APIの制限の一部を回避できますが、技術的な難易度が高く、Twitterのウェブサイト構造が変更される可能性があるため、不安定になりやすいという欠点があります。
GeoNodeのPay-As-You-Goスクレイパー。これは、Twitterからデータをスクレイピングするための、より柔軟で強力な方法を提供するサードパーティ製サービスです。 JavaScriptレンダリングやジオターゲティングといった高度な機能を備えていますが、利用には費用がかかり、予期せぬ請求を避けるために慎重な使用が求められます。
これらの方法にはそれぞれ長所と短所があり、どの方法が最適かは、具体的なニーズ、技術力、予算によって異なります。
最後に、倫理的かつ責任あるデータスクレイピングの重要性を強調しておくことが不可欠です。
Twitterデータのスクレイピングは貴重な洞察をもたらす可能性がありますが、Twitterの利用規約、Twitterユーザーのプライバシー、および関連する法律を尊重することが不可欠です。スクレイピングしたデータは常に責任を持って使用し、疑問がある場合は法的助言を求めてください。
Twitterデータのスクレイピングに役立つツールや手法を理解したことで、皆さんは自身のプロジェクトにおいてTwitterデータの力を活用する準備が整いました。