データ抽出とは?
データ抽出とは、ウェブサイト、データベース、文書から情報を取得することです。IDCによると、データ量の増加(2025年までに175ゼッタバイトに達すると予測されている)により、データ抽出は極めて重要となっています。 そのため、多くの企業がウェブスクレイピングAPIを活用してデータ抽出ワークフローを自動化しており、これにより大量のデータを効率的に収集、処理、分析することが可能になります。ウェブスクレイピングを通じて、企業は必要なデータに容易にアクセスし、分析を行うことで、今日のデータ主導型の世界において、より的確な意思決定、成長、そして成功を推進することができます。
ETLを用いたデータ抽出
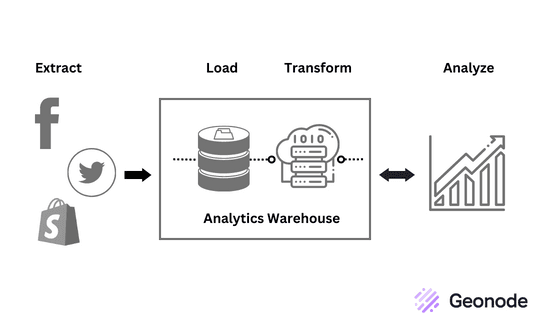
抽出、変換、ロード(ETL)とは、さまざまなソースからの大量のデータを統合・管理するために用いられるプロセスです。これは、分析のためにデータを収集、クリーニング、整理する際、データ抽出やウェブスクレイピングで一般的に使用されるプロセスです。
ETLプロセスには、主に3つの段階があります。
-
抽出:最初の段階では、データベース、ファイル、APIなどのさまざまなソースからデータを抽出または取得します。抽出されるデータは、構造化データ、半構造化データ、または非構造化データである場合があります。
-
変換:第2段階では、抽出されたデータを、データウェアハウスやレポート作成ツールなどのターゲットシステムに適した形式に変換します。この段階では、一貫性と正確性を確保するために、データのクリーニング、フィルタリング、集計、およびエンリッチメントが行われます。また、データを理解しやすい標準形式に変換することも含まれます。
-
ロード:最終段階では、変換されたデータを、さらなる分析や処理のためにターゲットシステムにロードします。データはデータベースやデータウェアハウスにロードされ、他のアプリケーションから容易にクエリを実行して分析できるようになります。
ETLを使用しないデータ抽出
データ抽出はETL以外でも行うことができますが、制限があるため、状況に応じて適切に利用する必要があります。例えば、適切な変換やロードを行わずに生データを抽出すると、データの整理や分析が困難になるほか、新しいプログラムやアプリケーションとの互換性がなくなる可能性があります。 その結果、このデータはアーカイブ目的を除いて、その価値が限定的になってしまう可能性があります。
しかし、ETLを使用しないデータ抽出は、複数のソースから迅速にデータにアクセスする必要がある企業にとっては、依然として優れた選択肢です。また、高価なETLソフトウェアやハードウェアが不要となるため、費用対効果の高いソリューションでもあります。
さらに、複雑な変換を行うことなく、あるシステムから別のシステムへデータを迅速かつ容易に移行するために利用することもできます。
ニーズや利用可能なリソースに応じて、従来のETLに依存しない、いくつかの代替的なデータ抽出手法を見つけることができます。
変更データキャプチャ(CDC)
チェンジ・データ・キャプチャ(CDC)は、分析のためにソースシステムにおけるデータへの変更を捕捉・保存するETLの手法です。データセット全体を抽出する従来のETLとは異なり、CDCは前回の抽出以降にデータに加えられた変更のみを捕捉します。これにより、より効率的なデータ抽出手法となります。
アプリケーション・プログラミング・インターフェース(API)
ETLを使用しないもう一つのデータ抽出手法として、API(アプリケーション・プログラミング・インターフェース)があります。APIとは、ソフトウェアアプリケーションを構築するための一連のプロトコルやツールのことです。APIを使用することで、開発者はソースシステムからプログラムによってデータを抽出し、自身のアプリケーションで利用できるようになります。
Google マップや Twitter など、多くの人気アプリケーションは、データ抽出に利用できる API を提供しています。
ウェブスクレイピング
ウェブスクレイピングも、ETLを使用せずにデータを抽出する手法の一つです。これは、自動化されたスクリプトを使用してウェブページからデータを抽出するものです。ウェブスクレイピングには、ウェブページの構造変更の影響を受けやすいといった制限がありますが、ウェブサイトからデータを抽出するための強力なツールとなり得ます。
ETLはデータ抽出において最も一般的に使用される手法ですが、他の手法も同様に効果的です。変更データキャプチャ(CDC)、API、ウェブスクレイピングは、いずれもさまざまなソースから情報を抽出するための有効な選択肢です。 特定のユースケースに最適な手法を見極め、最新の技術やトレンドを常に把握して、自身のニーズに最も適した手法を見つけることが不可欠です。
関連記事:ウェブスクレイパーとウェブクローラーの違いを知る
データ抽出のメリット
人為的ミスの削減
データ抽出により、データ収集のプロセスが自動化され、手動でのデータ入力時に発生しがちなミスの可能性を最小限に抑えます。その結果、データの正確性と一貫性が向上します。
生産性の向上
データ抽出により、従業員は他の業務に集中できる時間が確保され、生産性が向上します。また、このプロセスは手動でのデータ入力よりも迅速であるため、企業はより短い時間でより多くのデータを処理できるようになります。
より適切な経営判断を可能にする
データ抽出により、企業は豊富な情報にアクセスできるようになり、データに基づいた意思決定が可能になります。これにより、顧客サービスの向上、製品・サービスの改善、そして収益の増加につながります。
可視性の向上
データ抽出により、事業運営の可視性が向上し、企業は非効率な部分、成長の機会、改善すべき領域を特定できるようになります。
共有の簡素化
データ抽出により、企業は部門間や外部のステークホルダーとの間でデータを容易に共有できるようになり、コラボレーションとコミュニケーションが改善されます。
コスト効率の良さ
データ抽出は、手作業によるデータ入力の必要性を排除し、多額のコストにつながる可能性のあるエラーの発生確率を低減するため、企業にとってコスト効率に優れたソリューションです。
時間の節約
データ抽出はデータの収集と処理を自動化し、企業の貴重な時間を節約することで、他の重要な業務に集中できるようになります。
データ抽出:実世界の活用事例
データ抽出には、さまざまな業界にわたって数多くの実世界の活用事例があります。以下に、データ抽出の最も一般的な活用事例をいくつか紹介します。
評判モニタリング
企業は、ブランドを守るためにオンライン上の評判を監視する必要があります。 データ抽出は、ブランドに関する言及を追跡し、否定的なレビューを特定し、顧客のフィードバックを収集して、ブランドイメージを向上させるのに役立ちます。
市場調査
データ抽出は、企業が市場動向、消費者の行動、業界の知見に関するデータを収集するのに役立ちます。これらは、製品開発、マーケティング戦略、事業拡大について、情報に基づいた意思決定を行うために活用されます。
財務データ
金融機関は、データ抽出を活用して、財務諸表、ニュース記事、市場レポートなど、さまざまな情報源からデータを収集・分析し、情報に基づいた投資判断や市場動向の把握を行っています。
リード生成
データ抽出は、ソーシャルメディアのプロフィール、企業のウェブサイト、その他のオンライン情報源から連絡先情報やその他の関連データを収集することで、リードの生成を支援します。
コンテンツの集約
包括的かつ最新のニュース記事を作成するため、ニュースやメディア企業はデータ抽出を活用し、ニュース記事、ブログ記事、ソーシャルメディアなど、さまざまな情報源から情報を収集しています。
センチメント分析
企業はデータ抽出を活用して、コメント、レビュー、フィードバックを収集・分析し、顧客の感情をモニタリングしています。これにより、企業は製品やサービスの改善を図り、顧客とのより良い関係を築くことができます。
価格情報分析
小売業者はデータ抽出を活用して、競合他社の価格設定、プロモーション、割引に関する情報を収集し、自社の価格戦略を調整して競争優位性を獲得しています。
求人市場分析
人材紹介会社や求人サイトは、データ抽出を活用して求人情報、職務内容、必要スキルに関する情報を収集し、求職者が適切な求人を見つけられるよう支援するとともに、企業が有望な候補者を特定できるようにしています。
ソーシャルメディア分析
ソーシャルメディアプラットフォームは、データ抽出を活用してユーザーの行動や嗜好を分析し、インフルエンサーを特定し、ユーザーにパーソナライズされたおすすめ情報を提供しています。
旅行業界
旅行代理店や予約プラットフォームは、データ抽出を活用してフライト、ホテル、旅行先に関する情報を収集し、顧客によりパーソナライズされた旅行パッケージを提供できるようにしています。
抽出されるデータのさまざまな種類について
データ抽出の際、データの性質や抽出の目的に応じて、さまざまな種類のデータが抽出されます。ここでは、データ抽出プロセスにおいて抽出されるデータの種類についていくつか見ていきましょう。
非構造化データ
非構造化データとは、電子メール、ソーシャルメディアの投稿、テキスト文書など、あらかじめ定義された形式で整理されていないデータを指します。非構造化データは一貫した構造を持たないため、分析が困難な場合があります。
しかし、自然言語処理技術を活用することで、非構造化データを構造化された形式に変換し、より容易な分析や意思決定が可能になります。
構造化データ
一方、構造化データは、スプレッドシートやデータベースのように、あらかじめ定義された方法で整理されたデータです。 構造化データは一貫した構造を持っているため、検索、フィルタリング、集計が容易であり、分析も簡単です。
構造化データは、顧客データ、財務データ、業務データなど、さまざまなデータタイプにさらに分類することができます。
顧客データ
顧客データには、顧客に関する情報が含まれます。これには、顧客の人口統計情報、購入履歴、嗜好などが挙げられます。顧客データは、顧客エンゲージメントの向上、ターゲットを絞ったマーケティングキャンペーンの策定、顧客体験の最適化に活用されます。
顧客データの情報源の例としては、顧客アンケート、ソーシャルメディア上の活動、ウェブサイト解析などが挙げられます。
財務データ
財務データとは、収益、経費、利益率など、企業の財務に関連する情報を指します。財務データは、財務実績の追跡、コスト削減の余地のある分野の特定、そして情報に基づいた財務上の意思決定を行うために活用されます。
財務データソースの例としては、会計ソフトウェア、財務諸表、取引データなどが挙げられます。
業務データ
業務データとは、在庫水準、生産量、顧客サービス指標など、企業の日常業務に関連する情報を指します。業務データは、プロセスの改善すべき領域を特定し、リソース配分を最適化し、全体的な効率を高めるために活用されます。
業務データの情報源には、製造設備のセンサー、POSシステム、ヘルプデスクソフトウェアなどがあります。
データ抽出により、非構造化データや構造化データなど、さまざまな種類のデータが得られます。これらのデータタイプを抽出・分析することで、組織は有益な知見を得て、情報に基づいた意思決定を行い、ビジネスの成功を推進することができます。
データ抽出手法
データウェアハウジングにおける抽出手法には、主に「論理的抽出」と「物理的抽出」の2種類があります。
論理抽出
論理抽出とは、論理的なルールや変換を用いて、さまざまなソースからデータを抽出し、データウェアハウス内で共通の形式に統合するデータ抽出手法です。論理抽出には、更新通知、増分抽出、完全抽出の3つの主要な方法があります。
更新通知
この手法では、前回の抽出以降にソースシステムで更新されたデータのみを抽出します。ソースシステムがデータウェアハウスに変更内容を通知し、更新されたデータのみが抽出されます。これは、リアルタイムのデータ統合が必要であり、分析に最新のデータのみが必要な場合に有効です。
増分抽出
この方法では、前回の抽出以降にソースシステムで追加、更新、または削除されたデータのみを抽出します。抽出は、データが最後に変更された時刻を示すタイムスタンプまたはフラグに基づいて行われます。これは、データ量が膨大で、毎回すべてのデータを抽出することが現実的でない場合に頻繁に使用されます。
完全抽出
完全抽出とは、前回の抽出以降に変更があったかどうかにかかわらず、ソースシステムからすべてのデータを抽出するものです。データ量が少ない場合やソースシステムが比較的安定しており、データウェアハウスにソースデータの完全なコピーが必要な場合、完全抽出が最適な方法です。
物理的抽出
一方、物理的抽出は、データウェアハウジングにおけるもう一つのデータ抽出手法であり、ソースシステムからデータウェアハウスへデータを物理的にコピーまたは移動させることを指します。物理的抽出には、主に「オンライン抽出」と「オフライン抽出」の2つの方法があります。
オンライン抽出
オンライン抽出とは、ソースシステムが稼働している状態でデータを抽出する手法です。これは、データがリアルタイムで必要であり、かつソースシステムをオフラインにできない場合に有用です。ただし、抽出プロセスがソースシステムのパフォーマンスに影響を与える可能性があるため、この手法を選択する際には重要な考慮事項となります。
オフライン抽出
これは、ソースシステムが稼働していない間にデータを抽出する手法です。データの抽出をアクティビティの少ない時間帯に行える場合や、リアルタイムでの抽出が必要ない場合に、よく使用されます。抽出プロセスがソースシステムのパフォーマンスに影響を与えないため、オンライン抽出と比較して大きな利点となります。
全体として、これらの方法にはそれぞれ長所と短所があります。どの方法を選択するかは、ビジネスの具体的なニーズや、抽出対象となるデータの性質によって異なります。適切な方法を慎重に選択することで、データウェアハウス内のデータが正確かつ最新の状態に保たれ、分析に活用できるようになります。
データ抽出とデータマイニング
データ抽出と同様に、データマイニングも大量のデータを分析・活用する上で欠かせない重要なステップです。しかし、どちらもデータから有益な知見や知識を引き出すために用いられますが、両者には大きな違いがあります。
データ抽出
データ抽出とは、さまざまなソースからデータを抽出し、データウェアハウスなどの中央の場所に集約するプロセスです。
これには、関連するデータソースの特定、データクレンジングや変換手法の適用、そして中央集約型データベースへのデータロードが含まれます。データ抽出の目的は、容易にアクセス・分析できる、完全かつ正確なデータのコピーを作成することです。
データマイニング
一方、データマイニングとは、抽出されたデータの中からパターン、傾向、洞察を発見するプロセスです。
このプロセスでは、統計分析や機械学習の手法を用いて、相関関係や分類、その他の情報を特定し、情報に基づいたビジネス上の意思決定を行うことを目的としています。
データマイニングは、生データを実用的な知見に変換し、それを活用してビジネスパフォーマンスを向上させ、競争優位性を獲得することを目的としています。
簡単に言えば、データ抽出とは、さまざまなソースからデータを取得し、それらを一か所に集約するプロセスです。対照的に、データマイニングはそのデータを分析し、有意義なパターンや洞察を見出すものです。
どちらもデータ分析において不可欠なステップであり、企業のデータを包括的に把握するために、しばしば組み合わせて使用されます。
これらの手法を活用することで、企業は顧客、業務、市場動向に関する貴重な知見を得ることができ、より良い意思決定を行い、競合他社に先んじることが可能になります。
データ抽出ツールの種類
データ抽出ツールとは、さまざまなソースからデータを抽出し、データウェアハウスなどの中央の場所に集約することを容易にするソフトウェアアプリケーションのことです。これらのツールは、データ抽出プロセスを自動化し、その効率と精度を高めるように設計されています。
市場にはさまざまな種類のデータ抽出ツールが提供されており、それぞれ独自の機能と利点を持っています。以下に、代表的な3つの種類を紹介します。
バッチ処理ツール
これらのツールは、大量のファイルやドキュメントからバッチモードでデータを抽出するように設計されています。バッチ処理ツールは、複数のファイルや構造が類似したドキュメントからデータを抽出する必要がある場合に役立ちます。
バッチ処理ツールの例としては、Talend Open Studio、Apache NiFi、Alteryxなどが挙げられます。
オープンソースツール
これらのソフトウェアアプリケーションは無料で利用でき、ユーザーが自由に変更やカスタマイズを行うことができます。オープンソースのデータ抽出ツールは、予算が限られている中小企業や、高価な商用ソフトウェアを購入できないユーザーの間で人気があります。
オープンソースのデータ抽出ツールの例としては、Apache Kafka、Apache Flume、Pentaho Data Integrationなどが挙げられます。
クラウドベースのツール
クラウドベースのツールはクラウド上でホストされており、Webブラウザ経由でアクセスできます。リモートソースからデータを抽出する必要がある場合や、地理的に離れた場所にいる他のチームメンバーと共同作業を行いたい場合に、クラウドベースのデータ抽出ツールを利用できます。
クラウドベースのデータ抽出ツールの例としては、AWS Glue、Azure Data Factory、Google Cloud Dataflowなどが挙げられます。
データ抽出ツールは、企業がさまざまなソースからのデータを統合・分析するのを支援するため、データ分析プロセスに不可欠なものです。適切なデータ抽出ツールを選択することは、データ分析作業の効率と精度に大きな違いをもたらすことを忘れないでください。
おすすめのデータ抽出ツール
データ抽出ツールには、さまざまな種類や規模のものがあります。ウェブサイト、文書、ソーシャルメディアプラットフォームなどからデータを抽出する必要がある場合でも、そのプロセスを自動化し、データから貴重な知見を得るのに役立つツールが必ず見つかります。
Scrapestorm
Scrapestormは、ユーザーがさまざまなウェブサイトからデータを抽出できるウェブスクレイピングツールです。ウェブスクレイピングのプロセスを自動化するように設計されており、コーディングの経験がなくても簡単にデータを取得できます。Scrapestormは、表、グラフ、地図だけでなく、PDFや画像からもデータを抽出できます。 その使いやすいインターフェースと柔軟なカスタマイズオプションにより、あらゆる規模の企業から広く支持されています。
Altair Monarch
Altair Monarchは、PDF、スプレッドシート、データベースなど、さまざまなソースからデータを抽出できるデータ抽出ツールです。 機械学習アルゴリズムを活用して、非構造化文書からデータを自動的に識別・抽出するため、データ抽出に必要な手作業を削減できます。その結果、Altair Monarchは、大量の文書から定期的にデータを抽出する企業にとって特に有用です。
Klippa
OCR ベースのデータ抽出ツールである Klippa は、文書処理を自動化します。請求書、領収書、契約書など、さまざまな文書からデータを抽出できます。機械学習アルゴリズムを用いてこれらの文書からデータを認識・抽出し、抽出されたデータを Excel、JSON、XML などのさまざまな形式でエクスポートします。 Klippaは、短期間で大量の文書からデータを抽出する必要がある企業にとって特に有用です。
NodeXL
NodeXLは、ソーシャルメディアネットワーク向けのデータ分析・可視化ツールです。 ユーザーはTwitter、Facebook、LinkedInなどのさまざまなソーシャルメディアプラットフォームからデータを抽出し、グラフやチャートで可視化することができます。NodeXLは、顧客や競合他社のソーシャルメディア上の行動を分析する必要がある企業にとって特に有用です。その使いやすいインターフェースと高度な機能により、多くの企業で人気を博しています。
データ抽出の難しさとは?
データ分析プロセスにおいて重要な役割を担う一方で、データ抽出にはいくつかの課題も伴い、企業がデータを効果的に抽出・活用することを困難にしています。以下に、データ抽出における主な課題をいくつか挙げます。
データ形式の問題
データはさまざまな形式や構造で存在するため、抽出や標準化が困難になる場合があります。データが不完全であったり、一貫性がなかったり、エラーが含まれていたりすることもあり、その場合は大規模なデータクレンジングや変換が必要となります。
データセキュリティ上の懸念
機密情報や個人情報が含まれる場合、データの抽出はセキュリティリスクをもたらす可能性があります。 企業は、データの抽出および転送中にデータの安全性を確保するために、適切な対策を講じる必要があります。
技術的な制約
データがレガシーシステムや異なるデータソースに保存されている場合、データの抽出は困難になる可能性があります。複数のソースからデータを抽出して統合するには、専門的な技術スキルやソフトウェアツールが必要になる場合があります。
法令遵守
データ抽出は、GDPRやCCPAなどのデータプライバシー法をはじめとする法的および規制上の要件に準拠しなければなりません。これらの規制に準拠しない場合、多額の罰金や評判の低下を招く可能性があります。
これらの課題を克服するには、高度なツールや技術の活用、データ品質とセキュリティへの徹底した取り組みなど、データ抽出に対する戦略的なアプローチが必要です。これらの課題に対処することで、企業はデータの潜在能力を最大限に引き出し、市場における競争優位性を獲得することができます。
データ抽出のベストプラクティス
データ抽出はデータ分析において極めて重要なステップであるため、正確性、品質、そして成功を確実にするためには、ベストプラクティスに従うことが不可欠です。
データソースの特定
まず、関連するすべてのデータソースを特定し、データの構造を把握することから始めます。 これにより、重要なデータを見逃したり、無関係なデータソースにリソースを浪費したりすることを防ぐことができます。
データのクリーニングと前処理
正確性と一貫性を確保するために、抽出前にデータのクリーニングと前処理を行ってください。データのクリーニングと前処理を行うことで、抽出されたデータの品質に影響を与える可能性のある不整合、エラー、外れ値を特定し、除去することができます。
データの保存とバックアップ
データへのアクセス性と安全性を確保するためには、データの保存とバックアップが不可欠です。クラウドベースのサービスなどのデータ保存ソリューションは、柔軟性と拡張性を提供し、データの紛失や破損から保護するのに役立ちます。
データのセキュリティ確保
データ暗号化、アクセス制御、定期的なセキュリティ監査など、強固なセキュリティ対策を実施してください。機密データを保護し、データ漏洩を防止するためには、データのセキュリティを最優先事項とすべきです。
まとめ
データ抽出は難しい作業に思えるかもしれませんが、適切なツールと手法を使えば、初心者でも簡単かつ手軽に取り組むことができます。この初心者向けガイドでは、用語の定義から、データ抽出のためのさまざまな手法やツールについて解説するなど、データ抽出の基礎を網羅しました。
機械学習や人工知能の進歩により、さまざまなソースからより効率的かつ正確にデータを抽出できるようになり、データ抽出の未来は明るいものとなっています。利用可能なデータ量が増え続けるにつれ、「どのような種類のビッグデータから価値を引き出せるのか」「どのように活用すべきか」といった問いが浮上してくるでしょう。 その結果、データ抽出を習得することは、企業にとっても個人にとっても、ますます重要なスキルとなっていくでしょう。
データ抽出に取り組む際には、プロジェクトの目標やニーズを明確に理解するとともに、最適な方法を見つけるためにさまざまなツールや手法を積極的に試してみる姿勢が不可欠です。本ガイドで紹介するヒントやテクニックを実践することで、貴重なデータをうまく抽出し、活用するための第一歩を踏み出すことができるでしょう。
よくある質問 - FAQ:
データ抽出とは何ですか?
データ抽出とは、データベース、ウェブサイト、アプリケーションなどのさまざまな情報源からデータを取得し、分析に利用できる形式に変換するプロセスです。抽出されたデータは、洞察を得たり、意思決定を支援したりするために活用できます。
データ抽出の具体例を教えてください。
データ抽出の具体例としては、ECサイトから商品情報をスクレイピングすることが挙げられます。この抽出プロセスでは、商品名、価格、説明文などの関連データフィールドを特定し、ウェブスクレイピングツールやAPIを使用してデータを取得します。
データ抽出はどのような目的で使用されますか?
データ抽出は、データ分析、レポート作成、意思決定など、さまざまな業務機能を支援するために、複数のソースからデータを取得するために使用されます。これにより、洞察の創出、予測モデルの構築、および業務運営や戦略の改善に役立てられます。
データ抽出の手法にはどのようなものがありますか?
データ抽出の手法には、ウェブスクレイピング、API統合、データベースクエリなどがあります。ウェブスクレイピングは自動化ツールを使用してウェブサイトからデータを抽出する手法であり、API統合はウェブベースのアプリケーションからデータを取得する手法です。データベースクエリは、SQLクエリを使用して構造化されたデータベースからデータを取得するプロセスです。

