Immobiliare.it adalah salah satu platform properti daring terkemuka di Italia.
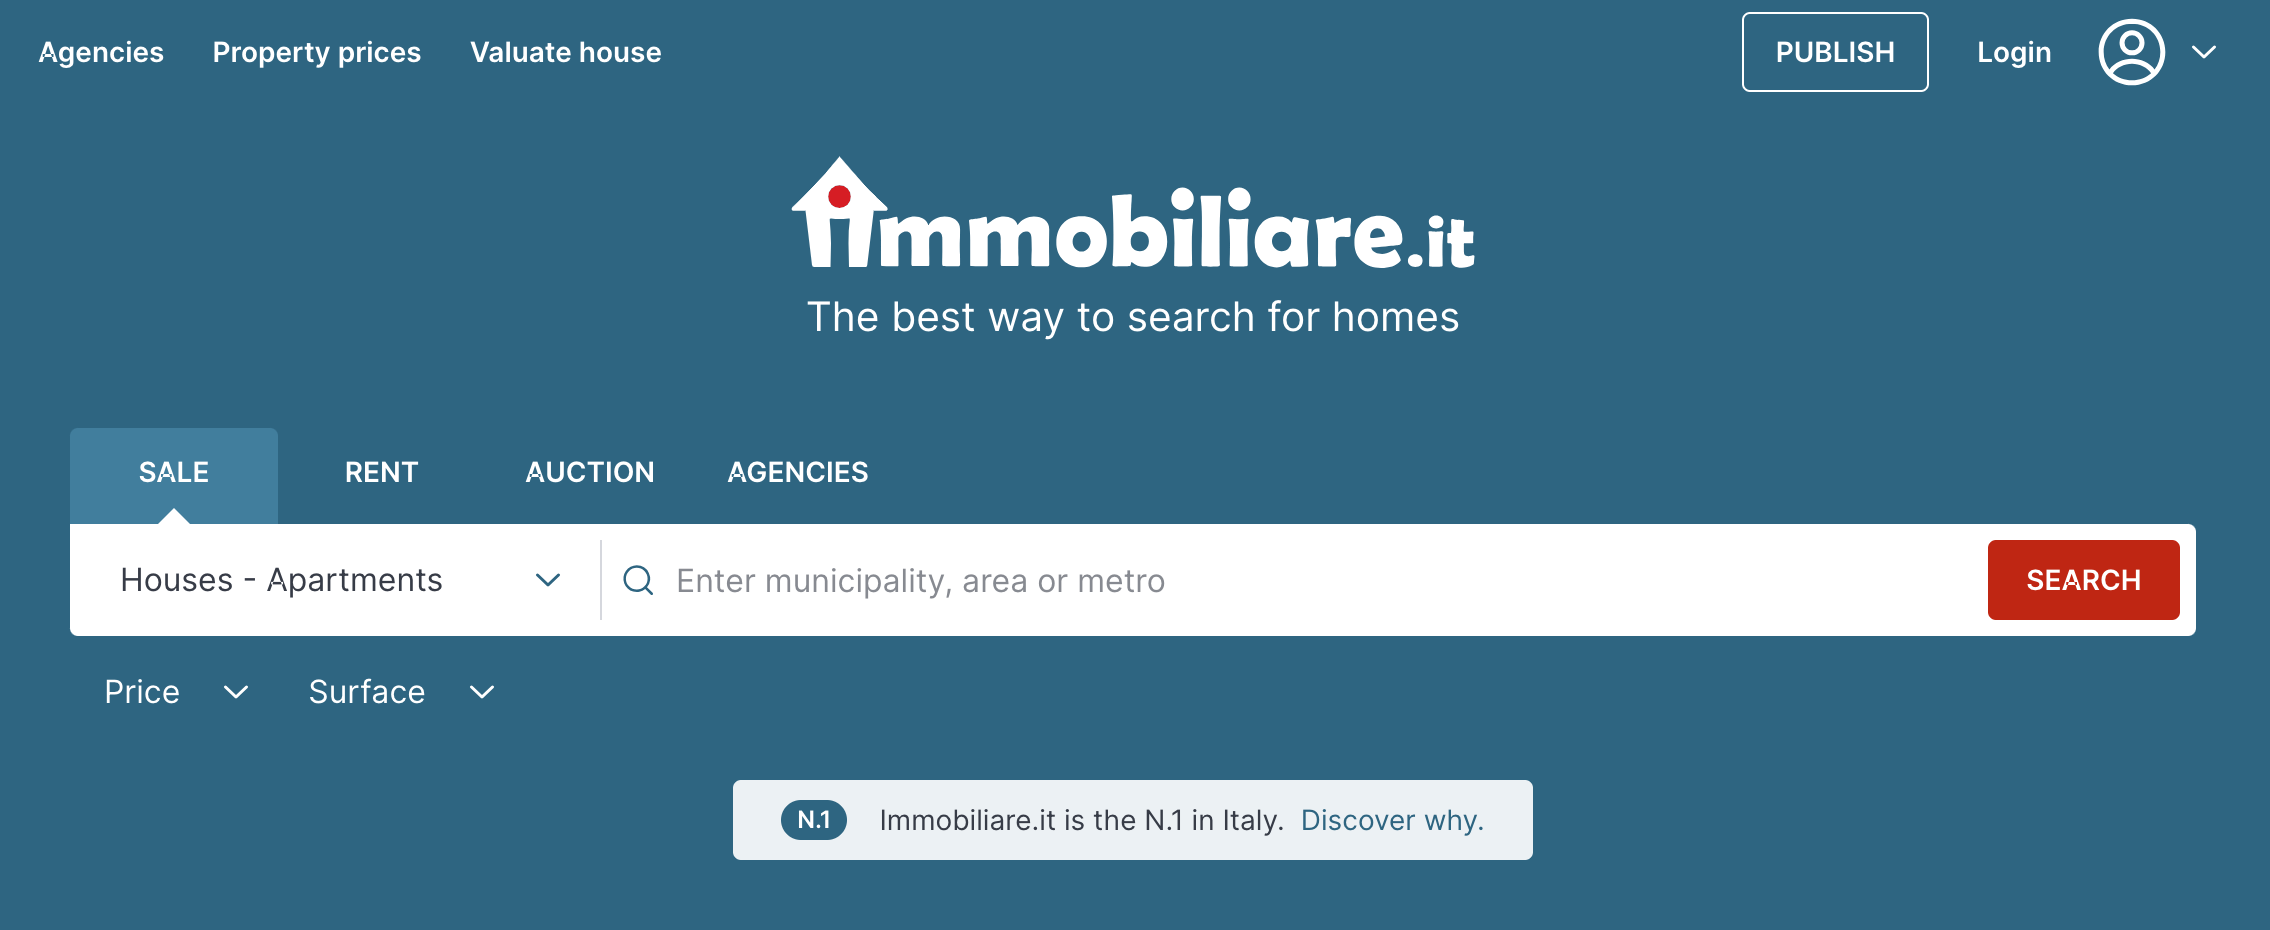
Dengan beragam daftar properti yang mencakup properti hunian, komersial, dan liburan, situs web ini berfungsi sebagai sumber informasi lengkap bagi siapa pun yang ingin berinvestasi di sektor properti Italia.
Bagi agen properti dan pembeli properti asal Amerika Serikat, Immobiliare.it menawarkan kesempatan unik untuk mengakses pasar yang beragam, yang biasanya sulit dijelajahi dari luar negeri.
Pentingnya Data Properti
Di industri properti, data adalah segalanya. Informasi yang akurat dan tepat waktu dapat menjadi pembeda antara investasi yang sukses dan kesalahan yang merugikan.
Bagi agen properti dan pembeli properti Amerika, memahami pasar Italia memerlukan sumber data yang andal.
Immobiliare.it menyediakan hal ini dalam bentuk daftar properti, tren harga, wawasan tentang lingkungan sekitar, dan banyak lagi.
Fitur filter pencarian yang canggih pada platform ini memungkinkan pengguna mempersempit pilihan berdasarkan berbagai kriteria, seperti lokasi, jenis properti, dan kisaran harga, sehingga memudahkan pencarian properti yang sesuai dengan tujuan investasi tertentu.
Contoh Penggunaan Data Properti dari Immobiliare.it
-
Riset Pasar. Agen properti Amerika dapat menggunakan data ini untuk memahami pasar properti Italia dengan lebih baik, mengidentifikasi tren dan peluang yang dapat menguntungkan klien mereka.
-
Keputusan Investasi. Pembeli properti dari Amerika Serikat dapat menggunakan Immobiliare.it untuk mengambil keputusan investasi yang terinformasi. T
Data dari platform ini dapat membantu mengidentifikasi properti yang dinilai terlalu rendah, kawasan yang sedang berkembang, atau properti sewa liburan yang menguntungkan.
-
Analisis Komparatif. Data tersebut dapat digunakan untuk membandingkan pasar Italia dengan pasar Amerika.
Hal ini sangat berguna bagi investor yang ingin mendiversifikasi portofolio mereka secara internasional.
-
Layanan Klien. Agen properti dapat menawarkan layanan tambahan kepada klien Amerika mereka yang tertarik dengan pasar Italia, seperti laporan dan analisis yang disesuaikan berdasarkan data dari Immobiliare.it.
-
Strategi Pemasaran. Dengan mengekstrak data dari Immobiliare.it, perusahaan dapat mengidentifikasi tren terkini terkait fitur properti dan lokasi, sehingga membantu dalam merumuskan strategi pemasaran yang lebih efektif.
Pendekatan ini dapat membuat situs web properti real estat lebih kompetitif di pasar.
-
Analisis Harga. Mengumpulkan data harga dan riwayat harga dari Immobiliare.it memungkinkan dilakukannya analisis harga yang komprehensif.
Memahami fluktuasi harga pasar, harga terbaru, dan harga pasar saat ini dapat membantu perusahaan dan konsumen mengambil keputusan yang lebih tepat.
-
Wawasan Hukum dan Regulasi. Immobiliare.it sering menampilkan artikel dan sumber daya yang menjelaskan undang-undang dan peraturan properti Italia, yang dapat menjadi informasi berharga bagi investor Amerika yang belum terbiasa dengan lanskap hukum Italia.
Dengan memanfaatkan data dan sumber daya yang tersedia di Immobiliare.it, agen properti dan pembeli properti Amerika dapat memperoleh keunggulan kompetitif di pasar yang menantang sekaligus menjanjikan.
Pertimbangan Hukum
Dalam hal pengumpulan data dari platform daring, sangat penting untuk memahami kerangka hukum dan etika guna memastikan Anda beroperasi sesuai dengan ketentuan hukum dan menghormati hak-hak pemilik data.
Apakah Scraping Immobiliare.it Diperbolehkan Secara Hukum?
Sebelum melakukan scraping pada situs web mana pun, sangat penting untuk memeriksa berkas robots.txt-nya, yang memuat aturan bagi web crawler.
Berkas robots.txt Immobiliare.it memuat beberapa perintah "Disallow", yang menunjukkan bagian-bagian situs web yang tidak boleh di-scrape.
Misalnya, berkas tersebut melarang pengambilan data dari peta pencarian, area pengguna, dan jenis-jenis iklan tertentu, di antara hal-hal lainnya.
Melanggar aturan ini dapat mengakibatkan pemblokiran akses ke situs atau menghadapi tindakan hukum.
Oleh karena itu, sangat penting untuk mematuhi pedoman yang ditetapkan dalam berkas robots.txt saat mempertimbangkan kegiatan pengumpulan data apa pun di Immobiliare.it.
Pertimbangan Etis
Selain aspek hukum, pertimbangan etis juga berperan saat melakukan pengumpulan data dari situs web.
Pengumpulan data yang etis menghormati baik huruf maupun semangat hukum, serta berkas robots.txt situs web, yang menjelaskan area-area situs yang tidak boleh dikumpulkan datanya.
Selain itu, pengambilan data yang etis mencakup tidak membebani server situs web secara berlebihan, menghormati privasi pengguna, dan menggunakan data secara bertanggung jawab.
Kegagalan dalam mematuhi pedoman etika ini dapat merusak reputasi Anda dan juga berpotensi menimbulkan konsekuensi hukum.
Wawasan tentang Legalitas Pengambilan Data Web
Berikut adalah tiga artikel yang membahas legalitas pengambilan data web beserta ringkasannya:
Pengadilan Banding Sirkuit Kesembilan AS telah memutuskan bahwa pengambilan data yang dapat diakses publik bukanlah pelanggaran terhadap Undang-Undang Penipuan dan Penyalahgunaan Komputer (CFAA). Putusan ini penting bagi para arsiparis, akademisi, peneliti, dan jurnalis yang menggunakan alat web scraping.
Namun, artikel tersebut juga menyebutkan bahwa terdapat beberapa kasus di mana web scraping menimbulkan kekhawatiran terkait privasi dan keamanan. Kasus ini awalnya diajukan oleh LinkedIn terhadap Hiq Labs, sebuah perusahaan yang melakukan web scraping terhadap profil pengguna LinkedIn. LinkedIn kalah dalam kasus tersebut pada tahun 2019, dan Pengadilan Banding Sirkuit Kesembilan menegaskan kembali putusan aslinya.
Artikel ini menyatakan bahwa tidak ada undang-undang federal yang melarang web scraping di Amerika Serikat selama data yang di-scraping tersedia untuk umum.
Namun, artikel ini menekankan pentingnya pertimbangan etika dan menyarankan para pelaku web scraping untuk beroperasi sesuai dengan batasan syarat dan ketentuan serta berkas robots.txt dari situs web.
Artikel tersebut membahas bahwa berdasarkan sebagian besar undang-undang, pengumpulan, penggunaan, atau penyimpanan informasi yang dapat mengidentifikasi pribadi (PII) tanpa persetujuan eksplisit dari pemiliknya merupakan tindakan ilegal.
Artikel tersebut juga menyebutkan bahwa web scraping terkadang dapat masuk ke dalam wilayah abu-abu secara hukum, terutama jika melibatkan pengumpulan informasi sensitif.
Alat dan Teknologi yang Digunakan untuk Pengumpulan Data
Dalam bidang web scraping, tersedia berbagai alat dan teknologi yang dapat disesuaikan dengan kebutuhan yang berbeda-beda. Baik Anda seorang pemula maupun ilmuwan data berpengalaman, kemungkinan besar ada alat yang sesuai dengan persyaratan proyek Anda. Di bawah ini, kami akan membahas beberapa alat yang paling umum digunakan. 
Pustaka Python (BeautifulSoup, Selenium)
Python adalah bahasa pemrograman yang populer untuk web scraping, dan menawarkan beberapa pustaka untuk mempermudah prosesnya:
-
BeautifulSoup: Ini adalah pustaka Python untuk mengekstrak data dari berkas HTML dan XML. Pustaka ini menyediakan idiom-idiom khas Python untuk mengiterasi, mencari, dan memodifikasi pohon parsing.
BeautifulSoup sering digunakan untuk keperluan web scraping guna mengekstrak data dari halaman web dan relatif mudah dipelajari oleh pemula.
-
Selenium: Berbeda dengan BeautifulSoup yang hanya mengekstrak kode sumber, Selenium berinteraksi dengan halaman web layaknya pengguna manusia.
Perpustakaan ini sering digunakan untuk mengekstrak data dari situs web dinamis di mana konten dimuat melalui JavaScript, dan juga dapat digunakan untuk pengujian otomatis.
Kedua pustaka ini dapat digunakan secara bersamaan, sehingga menyediakan perangkat yang kuat untuk proyek pengikisan web apa pun.
Layanan Pengikisan Web
Layanan pengikisan web menyediakan alternatif yang praktis bagi mereka yang memilih untuk tidak mendalami pemrograman.
Layanan ini sering kali dilengkapi dengan antarmuka pengguna yang intuitif yang memungkinkan Anda menentukan data apa yang ingin Anda ambil, tanpa perlu menulis kode apa pun.
Layanan ini menangani semuanya, mulai dari ekstraksi data hingga penyimpanan, sehingga memudahkan Anda untuk fokus pada analisis dan pemanfaatan data. P
Repositori GitHub sebagai Referensi
GitHub adalah sumber daya yang melimpah untuk web scraping. Anda dapat menemukan banyak repositori yang menawarkan skrip pengikisan yang sudah jadi, kerangka kerja, dan tutorial.
Berikut adalah beberapa jenis repositori yang mungkin berguna bagi Anda:
-
Repositori Tutorial. Repositori ini menyediakan panduan langkah demi langkah dan potongan kode untuk membantu Anda memulai web scraping.
-
Repositori Kerangka Kerja. Repositori ini berisi kerangka kerja siap pakai yang dirancang untuk mengikis jenis situs web atau data tertentu.
-
Repositori Proyek. Ini adalah proyek lengkap yang mendemonstrasikan tugas-tugas pengikisan yang lebih kompleks, sering kali melibatkan beberapa situs web atau teknologi.
Dengan mempelajari repositori-repositori ini, Anda dapat memperoleh wawasan mengenai praktik terbaik dan teknik lanjutan untuk web scraping.
Panduan Langkah demi Langkah
Bagian ini memberikan panduan lengkap tentang cara mengumpulkan data dari Immobiliare.it menggunakan pustaka Python dan alat bantu lainnya.
Ikuti langkah-langkah berikut untuk menyiapkan lingkungan kerja, menulis kode, dan menemukan contoh-contoh di GitHub untuk pembelajaran lebih lanjut.
Menyiapkan Lingkungan
-
Instal Python. Jika Anda belum melakukannya, unduh dan instal Python dari situs web resminya.
-
Instal Pustaka. Buka terminal Anda dan instal BeautifulSoup serta Selenium dengan menjalankan perintah berikut: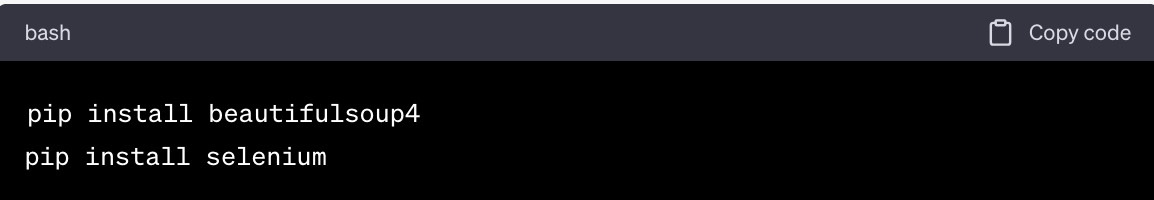
-
Web Driver. Unduh web driver yang kompatibel dengan browser Anda (misalnya, ChromeDriver untuk Chrome) dan letakkan di direktori proyek Anda.
-
Kunci API untuk Geonode. Jika Anda menggunakan Scraper Pay-As-You-Go dari Geonode, daftarkan diri untuk mendapatkan kunci API dari situs web mereka.
Menulis Kode untuk Mengumpulkan Data dari Immobiliare.it
-
Impor Pustaka. Impor pustaka Python yang diperlukan di awal skrip Anda.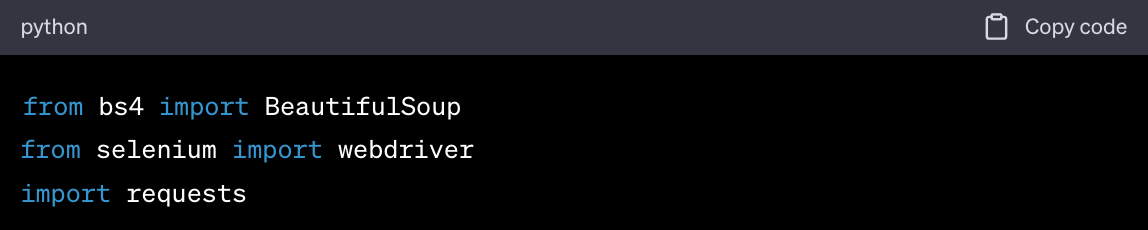
-
Inisialisasi WebDriver. Inisialisasi Selenium WebDriver. 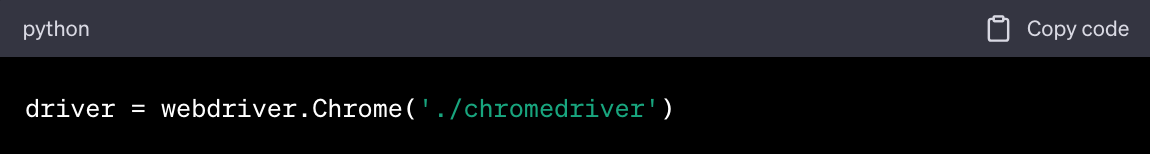
-
Buka Immobiliare.it. Gunakan WebDriver untuk membuka halaman web Immobiliare.it yang ingin Anda ambil datanya. 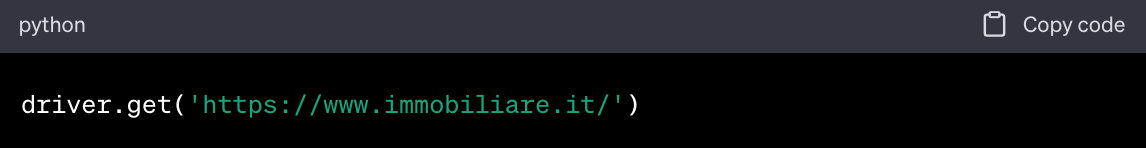
-
Temukan Elemen. Gunakan BeautifulSoup atau fungsi Selenium untuk menemukan elemen HTML yang berisi data yang ingin Anda ambil.
-
Ekstraksi Data. Ekstrak data dan simpan dalam variabel atau berkas.
-
APIGeonode. Jika menggunakan Geonode, lakukan panggilan API untuk menangani proxy, peramban, dan captcha.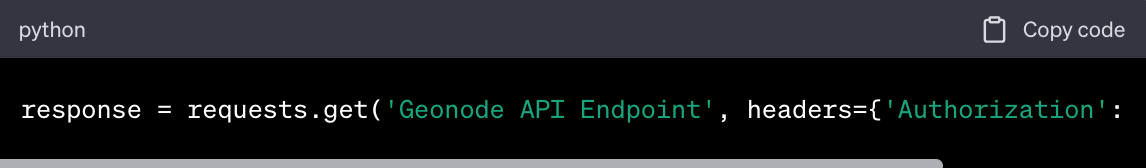
-
Tutup WebDriver. Jangan lupa untuk menutup WebDriver setelah Anda selesai.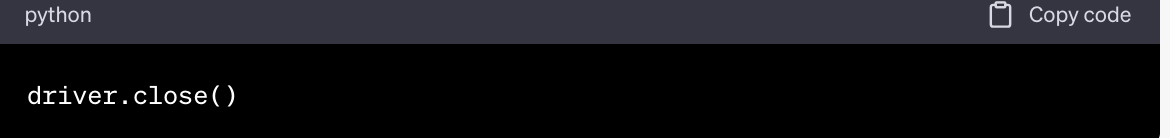
Contoh dan Tutorial GitHub
-
Cari Repositori. Gunakan fitur pencarian GitHub untuk menemukan repositori yang berkaitan dengan web scraping menggunakan Python, BeautifulSoup, dan Selenium.
-
Pelajari Kode. Cari contoh yang dirancang khusus untuk situs web properti atau Immobiliare.it.
-
Ikuti Tutorial. Beberapa repositori GitHub menawarkan tutorial langkah demi langkah yang dapat membantu Anda memahami kode dengan lebih baik.
-
Kloning dan Bereksperimen. Jangan ragu untuk mengkloning repositori dan menyesuaikan kode agar sesuai dengan kebutuhan spesifik Anda.
Teknik Lanjutan
Seiring Anda semakin terbiasa dengan teknik-teknik dasar web scraping, Anda mungkin merasa perlu mengatasi tantangan yang lebih kompleks. Bagian ini menguraikan beberapa teknik lanjutan yang dapat membantu Anda menghadapi skenario-skenario yang lebih rumit tersebut.
Mengatasi Situs Web Dinamis
Situs web dinamis memuat konten secara asinkron, sering kali menggunakan JavaScript. Hal ini dapat membuat proses pengikisan data menjadi lebih menantang. Berikut adalah beberapa teknik lanjutan untuk menangani situs web dinamis:
-
Selenium WebDriver. Seperti yang telah disebutkan sebelumnya, Selenium dapat berinteraksi dengan halaman web dinamis, sehingga memungkinkan Anda mengikis data yang dimuat melalui JavaScript.
-
Penjelajahan Tanpa Antarmuka (Headless Browsing). Gunakan peramban tanpa antarmuka seperti PhantomJS atau jalankan Selenium dalam mode headless untuk melakukan pengikisan data situs web tanpa membuka jendela peramban yang sebenarnya.
-
Permintaan AJAX. Beberapa situs web memuat data melalui permintaan AJAX. Anda dapat menggunakan alat pengembang untuk memeriksa permintaan ini dan mereplikasinya menggunakan pustaka requests dari Python.
-
Perintah Tunggu. Gunakan perintah tunggu eksplisit dan implisit di Selenium untuk memastikan halaman web telah dimuat sepenuhnya sebelum melakukan pengambilan data.
Mengambil Data Agen Properti
Mengumpulkan data terkait agen properti bisa jadi sedikit lebih rumit karena kebutuhan akan akurasi dan pertimbangan etika yang terlibat. Berikut beberapa tips:
-
Sasaran Bagian Tertentu. Gunakan BeautifulSoup atau ekspresi XPath untuk menargetkan bagian tertentu dari situs web tempat data agen disimpan.
-
Pagination. Banyak situs web mencantumkan agen di beberapa halaman. Pastikan kode Anda dapat menavigasi melalui pagination.
-
Pembatasan Kecepatan. Patuhi syarat dan ketentuan situs web tersebut. Terapkan pembatasan kecepatan dalam kode Anda untuk menghindari kelebihan beban pada server mereka.
-
Validasi Data. Selalu validasi data yang telah Anda kumpulkan untuk memastikan keakuratan dan kelengkapannya.
Wawasan StackOverflow tentang Menghadapi Perubahan Kode
Situs web sering memperbarui struktur HTML-nya, yang dapat membuat kode pengikisan Anda tidak berfungsi. Berikut cara Anda dapat menyesuaikannya:
-
Pembaruan Rutin: Pantau terus utas StackOverflow yang terkait dengan situs web yang Anda ikis. Pengguna sering membagikan pembaruan mengenai perubahan pada struktur situs web.
-
Penanganan Kesalahan: Terapkan penanganan kesalahan yang andal dalam kode Anda untuk memberi tahu Anda saat proses pengikisan gagal, sehingga Anda dapat memperbarui kode sesuai kebutuhan.
-
Wawasan Komunitas: StackOverflow adalah tempat yang tepat untuk menemukan solusi alternatif atau metode lain dalam pengikisan saat struktur kode situs web berubah.
Dengan menguasai teknik-teknik lanjutan ini, Anda akan lebih siap menghadapi berbagai tantangan pengikisan web. Baik saat berurusan dengan konten dinamis, data khusus, maupun struktur situs web yang berubah, metode-metode ini akan membekali Anda dengan keterampilan yang dibutuhkan untuk pengumpulan data yang efektif.
Analisis dan Pemanfaatan Data
Setelah Anda berhasil mengumpulkan data, langkah selanjutnya adalah menganalisis dan memanfaatkannya secara efektif.
Bagian ini akan memandu Anda melalui proses menganalisis data yang telah dikumpulkan, membangun model penetapan harga Anda sendiri, serta membuat dan memperbarui profil penawaran.
Cara Menganalisis Data yang Telah Dikumpulkan
-
Pembersihan Data. Langkah pertama dalam setiap proses analisis data adalah membersihkan data. Hapus duplikat, tangani nilai yang hilang, dan ubah tipe data jika diperlukan.
-
Visualisasi Data. Gunakan pustaka seperti Matplotlib atau Seaborn untuk memvisualisasikan data. Hal ini dapat membantu Anda mengidentifikasi tren, nilai yang menyimpang, atau pola.
-
Analisis Statistik. Gunakan metode statistik untuk merangkum data. Hitung rata-rata, median, deviasi standar, dan sebagainya, untuk mendapatkan pemahaman yang lebih baik tentang distribusi data.
-
**Analisis Teks. **Jika Anda telah mengumpulkan data teks, pertimbangkan untuk menggunakan teknik Pemrosesan Bahasa Alami (NLP) guna mengekstrak wawasan.
-
Analisis Korelasi. Identifikasi variabel yang memiliki korelasi kuat satu sama lain. Hal ini dapat sangat berguna dalam bidang properti untuk memahami bagaimana berbagai faktor memengaruhi harga properti.
Tantangan Umum dan Solusinya
Web scraping tidak lepas dari berbagai tantangan. Mulai dari CAPTCHA dan batasan laju (rate limit) hingga kekhawatiran mengenai kualitas dan keandalan data, bagian ini bertujuan untuk mempersiapkan Anda menghadapi beberapa hambatan yang mungkin Anda temui serta menawarkan solusi untuk mengatasinya.
CAPTCHA
-
- Masalah: Banyak situs web menggunakan CAPTCHA untuk mencegah pengikisan otomatis.
- Solusi: Anda dapat menggunakan layanan seperti 2Captcha atau Anti-Captcha untuk memecahkan CAPTCHA secara otomatis. Sebagai alternatif, Selenium dapat digunakan untuk menyelesaikan CAPTCHA secara manual selama proses pengambilan data.
Batas Kecepatan
-
- Masalah: Situs web sering kali memiliki batas kecepatan untuk membatasi jumlah permintaan dari satu alamat IP.
- Solusi: Terapkan pembatasan laju dalam kode Anda untuk mematuhi ketentuan situs web tersebut. Anda juga dapat menggunakan layanan proxy untuk mengganti-ganti alamat IP. Proxy residensial dari Geonode merupakan layanan yang sangat baik untuk tujuan ini.
Data Tidak Lengkap
-
- Masalah: Terkadang data yang di-scrape mungkin tidak lengkap karena pemuatan dinamis atau masalah lainnya.
- Solusi: Gunakan Selenium untuk memastikan halaman telah dimuat sepenuhnya sebelum melakukan scraping. Anda juga dapat menggunakan fungsi wait-nya untuk menjeda kode hingga elemen tertentu dimuat.
Data yang Tidak Konsisten
-
- Masalah: Struktur situs web mungkin berubah seiring waktu, sehingga menyebabkan data menjadi tidak konsisten.
- Solusi: Perbarui kode pengikisan Anda secara berkala agar dapat menyesuaikan dengan perubahan apa pun pada struktur situs web. Terapkan penanganan kesalahan yang andal untuk memberi tahu Anda saat proses pengambilan data gagal.
Validasi Data
-
- Masalah: Data yang diambil mungkin mengandung kesalahan atau ketidakakuratan.
- Solusi: Selalu validasi data Anda dengan membandingkannya dengan berbagai sumber atau gunakan checksum untuk memastikan integritas data.
Masalah Hukum dan Etika
-
- Masalah: Pengambilan data terkadang dapat melanggar ketentuan layanan situs web.
- Solusi: Selalu baca dan patuhi ketentuan layanan serta berkas robots.txt situs web tersebut. Hormati aturan dan kebijakan situs web tersebut.
Dengan menyadari tantangan umum ini beserta solusinya, Anda akan lebih siap menghadapi masalah apa pun yang muncul selama proses pengikisan web.
Pertanyaan Populer Lainnya
Bagaimana cara mengekstrak data dari situs web properti tanpa perlu coding?
Anda dapat menggunakan alat web scraping tanpa kode seperti WebHarvy, Octoparse, atau Import.io. Alat-alat ini menawarkan antarmuka yang ramah pengguna untuk ekstraksi data dengan cara klik dan pilih.
Apa saja pustaka Python terbaik untuk pengikisan web?
Pustaka Python yang paling umum digunakan untuk pengikisan web adalah BeautifulSoup untuk mengurai HTML dan XML, serta Selenium untuk berinteraksi dengan situs web yang banyak menggunakan JavaScript. Scrapy adalah pilihan lain untuk proyek yang lebih kompleks.
Apakah pengikisan web legal?
Legalitas pengikisan web bergantung pada ketentuan layanan situs web dan cara Anda menggunakan data tersebut. Selalu periksa syarat dan ketentuan situs web tersebut dan pertimbangkan untuk meminta nasihat hukum guna memastikan kepatuhan.
Sumber Daya Tambahan
Setelah menjelajahi berbagai aspek web scraping, mulai dari menyiapkan lingkungan kerja hingga mengatasi tantangan, kini saatnya menyimpulkan dan melihat langkah selanjutnya.
Dokumentasi Resmi. Selalu menjadi titik awal yang baik. BeautifulSoup, Selenium, dan pustaka lainnya memiliki dokumentasi lengkap untuk membantu Anda memahami fungsinya dengan lebih baik.
Kursus Online. Situs web seperti Udemy, Coursera, dan edX menawarkan kursus tentang web scraping dan analisis data.
Tutorial YouTube. Tersedia banyak sekali tutorial yang mencakup segala hal, mulai dari dasar-dasar hingga teknik lanjutan.
Forum dan Komunitas. Situs web seperti StackOverflow dan Reddit memiliki komunitas aktif tempat Anda dapat mengajukan pertanyaan dan berbagi pengetahuan.
Buku. Tersedia pula beberapa buku yang berfokus pada teknik web scraping dan pengumpulan data.
Kesimpulan
Kini setelah Anda memiliki pengetahuan dan alat yang diperlukan untuk melakukan web scraping secara efektif, saatnya untuk mempraktikkannya.
Mulailah dari yang sederhana, lakukan eksperimen, dan jangan ragu untuk terjun ke proyek yang lebih kompleks seiring dengan meningkatnya kepercayaan diri Anda.
Ingatlah, kunci keberhasilan web scraping bukan hanya mengumpulkan data, tetapi mengubahnya menjadi wawasan yang dapat ditindaklanjuti.

