LIHKG adalah forum diskusi daring populer yang telah mendapatkan popularitas besar di Hong Kong dan di kalangan komunitas penutur bahasa Kanton di seluruh dunia.
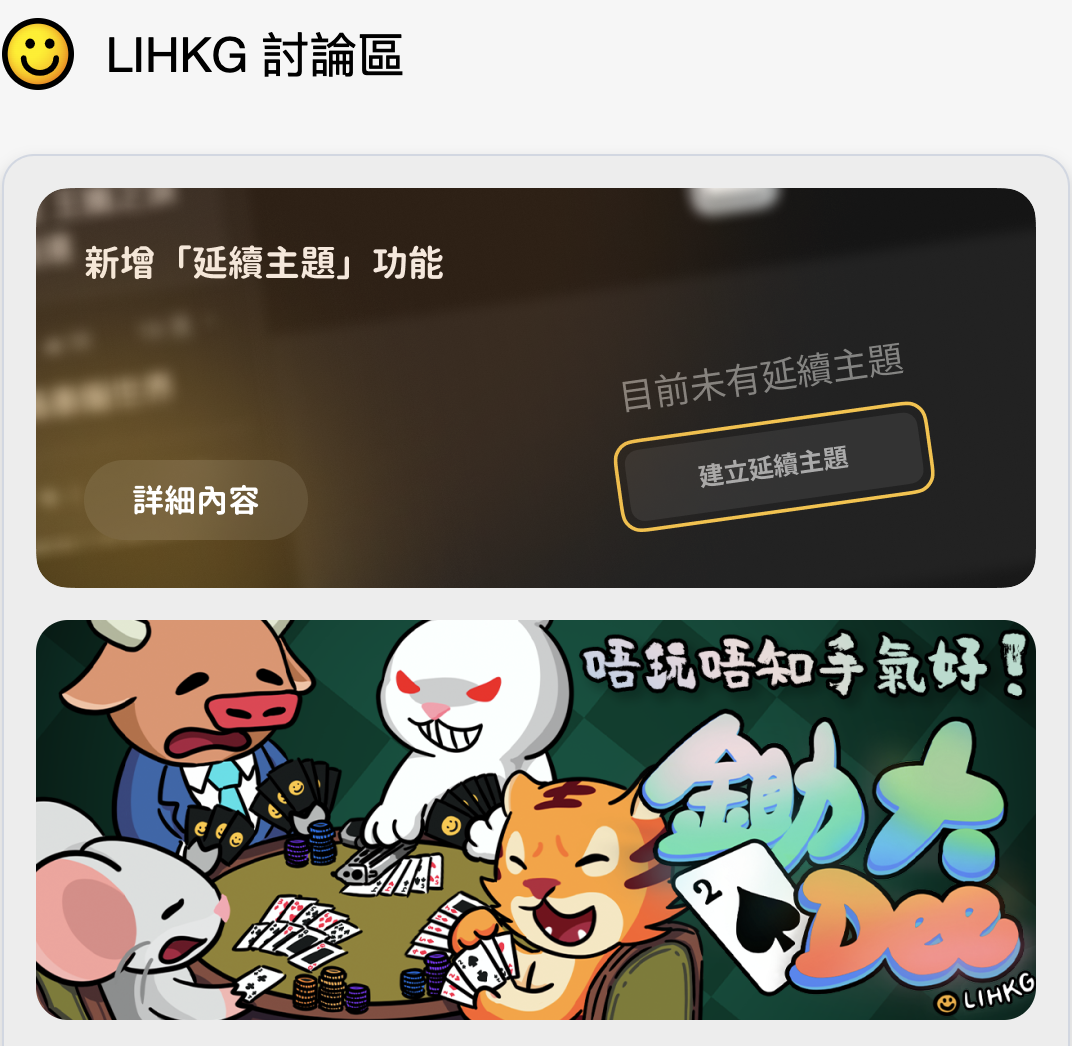
Forum ini merupakan salah satu forum terbesar untuk membahas aksi protes, peristiwa kerusuhan sosial, dan topik lainnya.
Sering dibandingkan dengan Reddit dalam analisis pesaing, platform media sosial ini memungkinkan pengguna forum untuk mendiskusikan berbagai topik, mulai dari politik dan peristiwa terkini hingga hiburan dan gaya hidup.
Sejarah forum ini menunjukkan fokus yang kuat pada aksi kolektif dan protes berskala besar.
Dengan konten media sosial yang dibuat oleh pengguna dan diskusi daring secara real-time, lihkg.com berfungsi sebagai sumber daya yang berharga bagi para peneliti, pemasar, dan analis data yang tertarik untuk memahami opini publik, jejaring sosial, dan tren sosial.
Kompleksitas Pengambilan Data dari lihkg.com
Meskipun gagasan untuk mengambil data dari lihkg.com mungkin tampak sederhana, kenyataannya jauh dari itu.
Situs web ini menggunakan berbagai mekanisme untuk melindungi kumpulan datanya yang terstruktur dengan baik, mulai dari CAPTCHA hingga permintaan AJAX, sehingga menjadikannya target yang menantang bagi pengikisan web dan jaringan pendeteksi peristiwa kerusuhan.
Selain itu, pertimbangan etika dan hukum, termasuk etika solidaritas, menambah lapisan kerumitan lain pada proses tersebut.
Memahami seluk-beluk ini sangat penting bagi siapa pun yang mempertimbangkan untuk melakukan pengikisan data pada platform online ini atau yang serupa.
Ini bukan sekadar mengumpulkan data media sosial; ini tentang melakukannya secara bertanggung jawab dan efektif.
Alat Hipotetis: Proksi Geonode
dan Scraper API
Dalam skenario hipotetis di mana seseorang akan melakukan scraping pada lihkg.com, alat-alat tertentu berpotensi memperlancar proses tersebut.
Proksi [Geonode
](https://geonode.com) dapat digunakan untuk melewati pembatasan berbasis IP, sehingga memungkinkan pengumpulan data yang lebih luas tanpa memicu tindakan anti-scraping. Hal ini sangat berguna untuk menangani aktivitas beruntun.
Selain itu, [scraper API
dari Geonode
](https://geonode.com/the-pay-as-you-go-scraper) dapat mengotomatiskan dan menyederhanakan proses pengikisan data, serta menangani tantangan seperti CAPTCHA dan permintaan AJAX dengan lebih efisien.
Hal ini akan sangat bermanfaat dalam waktu nyata, terutama saat berhadapan dengan tingkat solidaritas yang tinggi di antara pengguna forum.
Siapa yang Sebaiknya Membaca Artikel Ini?
Jika Anda pernah bertanya-tanya bagaimana cara melakukan scraping pada lihkg.com, eksperimen pemikiran ini cocok untuk Anda.
Artikel ini bertujuan untuk menjelaskan kompleksitas dan tantangan yang akan Anda hadapi saat melakukan scraping pada lihkg.com — tanpa benar-benar mengajarkan cara melakukannya.
Jadi, mari kita telusuri topik menarik ini dan jelajahi apa yang membuatnya begitu menantang namun juga memikat.
Seluk-beluk lihkg.com
Struktur lihkg.com
lihkg.com pada dasarnya dibangun menggunakan kombinasi HTML, CSS, dan JavaScript.
Sementara HTML dan CSS menangani tata letak dan gaya, JavaScript bertanggung jawab atas aspek dinamis situs, seperti pembaruan real-time dan permintaan AJAX.
Mengapa Struktur Penting dalam Scraping
Memahami struktur adalah langkah pertama dalam menentukan cara melakukan scraping pada lihkg.com.
Misalnya, jika situs web sangat bergantung pada JavaScript untuk memuat konten, metode pengikisan tradisional yang hanya mengambil HTML mungkin tidak akan berhasil.
Anda perlu menggunakan teknik yang lebih canggih seperti browser headless untuk menjalankan kode JavaScript dan mengambil data.
Tantangan dalam Mengikis Konten Dinamis
lihkg.com menggunakan AJAX (Asynchronous JavaScript and XML) untuk memuat data baru tanpa perlu menyegarkan seluruh halaman.
Hal ini membuat pengambilan data dari situs tersebut menggunakan permintaan HTTP dasar menjadi sulit.
Dalam skenario hipotetis, seseorang dapat menggunakan scraper API dari Geonode untuk menangani konten dinamis semacam itu dengan lebih efisien.
Jenis Data di lihkg.com
Apa Saja yang Dapat Anda Temukan?
lihkg.com menawarkan berbagai jenis konten yang mungkin menarik bagi berbagai pihak. Berikut adalah beberapa jenis data utama yang mungkin ingin Anda kumpulkan:
-
Postingan Pengguna. Postingan asli yang dibuat oleh pengguna mengenai berbagai topik; postingan ini berfungsi sebagai titik awal diskusi dan dapat berisi teks, gambar, serta tautan.
-
Komentar: Komentar adalah tanggapan terhadap postingan pengguna, dan dapat memiliki balasan bersarang, sehingga membentuk struktur seperti utas.
-
Suara Setuju dan Tidak Setuju. Setiap postingan dan komentar dapat diberi upvote atau downvote, yang memberikan indikasi sentimen komunitas terhadap konten tersebut.
-
Profil Pengguna. Profil ini mungkin berisi informasi seperti tanggal bergabung pengguna, tingkat aktivitas, dan statistik lainnya, meskipun sebagian besar data ini sering kali dianonimkan atau dipseudonimkan.
Mengapa Data Ini Penting
Riset Pasar
Memahami apa yang dibicarakan pengguna dapat memberikan wawasan berharga mengenai perilaku dan tren konsumen. Hal ini sangat berguna untuk analisis pesaing dan analisis visualisasi.
Analisis Sentimen
Suara setuju dan tidak setuju dapat digunakan untuk mengukur opini publik mengenai topik atau peristiwa tertentu, termasuk kampanye protes dan peristiwa kerusuhan sosial.
Penelitian Akademis
Para akademisi yang mempelajari komunitas daring mungkin menganggap interaksi dan diskusi pengguna di lihkg.com sebagai sumber data yang kaya untuk kumpulan data mereka yang terstruktur dengan baik.
Tantangan dalam Scraping
Melakukan scraping pada situs web seperti lihkg.com bukan sekadar upaya teknis; hal ini juga merupakan labirin hukum dan etika.
Aspek Hukum
Pengambilan data web berada di wilayah abu-abu dalam hukum.
Meskipun pengambilan data dari postingan yang dapat diakses publik umumnya dianggap legal, banyak situs web memiliki ketentuan layanan yang melarang pengambilan data.
Melanggar ketentuan tersebut dapat menimbulkan konsekuensi hukum, termasuk tuntutan hukum dan denda.
Bagaimana Hal Ini Berlaku untuk lihkg.com
lihkg.com memiliki ketentuan dan syarat tersendiri yang harus disetujui pengguna saat menggunakan situs tersebut.
Ketentuan ini sering kali mencakup klausul yang melarang pengambilan data (scraping) konten situs web tanpa izin.
Oleh karena itu, melakukan pengambilan data (scraping) pada lihkg.com tanpa izin eksplisit berpotensi menimbulkan konsekuensi hukum.
Implikasi Etis
Di luar aspek hukum, pengambilan data (scraping) pada lihkg.com juga menimbulkan pertanyaan etis.
Platform ini merupakan komunitas tempat orang-orang berbagi pemikiran dan pendapat, yang sering kali mengharapkan tingkat privasi tertentu.
Mengambil data ini tanpa persetujuan dapat dianggap sebagai pelanggaran privasi, meskipun data tersebut dapat diakses secara publik.
Hambatan Teknis
CAPTCHA
Salah satu langkah anti-scraping yang paling umum digunakan oleh situs web adalah CAPTCHA (Completely Automated Public Turing test to tell Computers and Humans Apart).
lihkg.com menggunakan CAPTCHA untuk memastikan bahwa pengguna yang berinteraksi dengan situs web tersebut adalah manusia, bukan bot. Hal ini menjadi hambatan yang signifikan bagi upaya pengikisan data apa pun.
Permintaan AJAX
Seperti yang telah disebutkan sebelumnya, lihkg.com menggunakan AJAX (Asynchronous JavaScript and XML) untuk memuat konten secara dinamis.
Artinya, data yang Anda lihat di situs web tersebut tidak terdapat dalam kode HTML awal, melainkan dimuat secara asinkron melalui JavaScript.
Metode pengikisan tradisional yang hanya mengambil kode HTML tidak akan mampu menangkap data yang dimuat secara dinamis ini.
Pembatasan Berbasis IP
Situs web sering kali menerapkan pembatasan berbasis IP untuk memblokir atau membatasi akses dari lokasi geografis tertentu atau untuk mencegah aktivitas pengikisan data.
Beberapa permintaan dari alamat IP yang sama dalam waktu singkat dapat memicu pembatasan ini.
Alat-alat Hipotetis untuk Tugas Ini
Proksi Geonode sebagai Solusi Hipotetis
Dalam skenario hipotetis di mana seseorang mencoba melakukan web scraping pada lihkg.com, proxy Geonode dapat berfungsi sebagai solusi untuk mengatasi pembatasan berbasis IP.
Dengan mengalihkan permintaan Anda melalui beberapa alamat IP, Anda dapat menghindari pemicu tindakan anti-scraping, sehingga memungkinkan pengumpulan data yang lebih luas.
Peran Proksi
Dalam pengambilan data web, proksi bertindak sebagai perantara antara komputer Anda dan situs web yang ingin Anda ambil datanya.
Proksi meneruskan permintaan Anda ke situs web tersebut dan mengembalikan respons situs web tersebut kepada Anda, sehingga secara efektif menyembunyikan alamat IP Anda dalam proses tersebut.
Proksi Geonode untuk Pembatasan Geografis
Geonode menawarkan berbagai proksi residensial yang dapat digunakan untuk melewati pembatasan geografis.
Misalnya, jika lihkg.com membatasi akses bagi pengguna dari negara-negara tertentu, proxy Geonode dapat mengalihkan permintaan Anda melalui alamat IP yang berlokasi di wilayah yang tidak dibatasi, sehingga memungkinkan Anda mengakses situs tersebut.
Mengatasi Batasan Kecepatan dengan Proxy Geonode
Pembatasan laju (rate limiting) adalah langkah anti-scraping umum lainnya yang membatasi jumlah permintaan yang dapat dilakukan oleh satu alamat IP dalam jangka waktu tertentu.
Proksi Geonode dapat membantu Anda mengatasi hal ini dengan mendistribusikan permintaan Anda ke beberapa alamat IP, sehingga mengurangi kemungkinan Anda terkena batasan laju.
Scraper API
scraper API adalah alat yang menyederhanakan proses web scraping dengan menangani berbagai tantangan yang terkait dengannya, seperti CAPTCHA, permintaan AJAX, dan batasan laju.
Pada dasarnya, alat ini bertindak sebagai perantara yang menangani detail-detail teknis, sehingga Anda dapat fokus pada apa yang akan Anda lakukan dengan data setelah berhasil di-scrape.
Bagaimana Scraper API dari Geonode Dapat Mempermudah Proses Ini
scraper API dari Geonode dirancang untuk mengatasi berbagai tantangan yang akan Anda hadapi saat melakukan web scraping pada situs web kompleks seperti lihkg.com. Alat ini dapat menangani upaya ulang (retry) jika terjadi kegagalan, sehingga membuat seluruh proses menjadi lebih efisien dan lebih sedikit rentan terhadap kesalahan.
Mempertimbangkan Kembali Pendekatan
scraper API dari Geonode membuat Anda mempertimbangkan kembali cara melakukan scraping pada lihkg.com.
Alih-alih menghabiskan waktu berjam-jam untuk mencari cara melewati CAPTCHA atau menangani permintaan AJAX, Anda dapat memanfaatkan API untuk mengatasi tantangan-tantangan tersebut, sehingga Anda dapat fokus pada analisis data dan memperoleh wawasan darinya.
Pertanyaan Lainnya
Apa itu lihkg.com?
lihkg.com adalah forum populer di Hong Kong dan di kalangan penutur bahasa Kanton di seluruh dunia, yang membahas topik mulai dari politik hingga budaya pop.
Sering disamakan dengan Reddit, situs ini merupakan sumber utama untuk memantau sentimen publik dan tren, termasuk berita yang sedang hangat dan berita alternatif.
Apakah Mengambil Data dari Situs Web Secara Otomatis (Scraping) Legal?
Legalitas pengambilan data secara otomatis (web scraping) bervariasi tergantung pada yurisdiksi dan keadaan spesifiknya.
Secara umum, pengambilan data informasi yang dapat diakses publik dianggap legal. Namun, banyak situs web, termasuk lihkg.com, memiliki ketentuan layanan yang melarang pengambilan data tanpa izin.
Melanggar ketentuan tersebut dapat menimbulkan konsekuensi hukum.
Bagaimana Cara Kerja Proxy dalam Pengambilan Data Web?
Dalam web scraping, proxy berfungsi sebagai perantara antara komputer Anda dan situs web target. Proxy meneruskan permintaan Anda ke situs web tersebut dan mengembalikan respons situs web tersebut kepada Anda.
Proses ini secara efektif menyembunyikan alamat IP Anda, sehingga situs web lebih sulit mengidentifikasi dan memblokir Anda.
Apa Itu Layanan Pengumpulan Data (Scraper API)?
Layanan pengumpulan data (scraper API) adalah layanan yang menyederhanakan proses pengumpulan data web dengan menangani berbagai tantangan yang terkait dengannya.
Layanan Geonode di scraper API secara hipotetis dapat mengelola aspek-aspek ini untuk Anda, sehingga Anda dapat fokus pada data dan cara Anda ingin menggunakannya.
Kesimpulan
Seiring kita mendekati akhir eksperimen pemikiran ini, jelaslah bahwa melakukan scraping pada lihkg.com—atau situs web mana pun, dalam hal ini—bukanlah tugas yang mudah.
Proses ini penuh dengan kompleksitas, mulai dari memahami struktur situs web hingga menavigasi labirin hukum dan etika.
Mengikis lihkg.com menghadirkan serangkaian tantangan unik:
-
Hambatan Teknis. Penggunaan AJAX oleh situs web tersebut untuk memuat konten dinamis dan CAPTCHA untuk mencegah bot membuat pengikisan menjadi lebih rumit daripada sekadar mengambil konten HTML.
-
Masalah Hukum dan Etika. Ketentuan layanan lihkg.com secara eksplisit melarang pengambilan data tanpa izin, dan terdapat pertimbangan etika seputar privasi pengguna serta penggunaan data.
-
Jenis Data. Memahami jenis data yang tersedia di lihkg.com, seperti posting pengguna, komentar, dan upvote, menambah lapisan kompleksitas lain pada proses pengikisan data.
Kesimpulan
Memahami kompleksitas yang terlibat dalam pengambilan data dari situs web seperti lihkg.com sangat penting bagi siapa pun yang mempertimbangkan upaya semacam ini.
Meskipun ada alat yang secara hipotetis dapat mempermudah tugas ini, alat-alat tersebut tidak dapat menghilangkan tanggung jawab hukum dan etika yang menyertai pengambilan data web.
Oleh karena itu, sangat penting untuk melakukan tugas ini dengan pemahaman yang komprehensif mengenai kompleksitas dan tantangan tersebut.
Dengan mengeksplorasi aspek-aspek ini secara mendetail, kami berharap eksperimen pemikiran ini telah memberikan wawasan berharga mengenai dunia pengikisan web.
Kesadaran akan tantangan-tantangan ini akan membekali Anda dengan lebih baik untuk menavigasi lanskap rumit pengikisan web secara bertanggung jawab dan efektif.

