Introdução
O CloudFront.net, uma rede de distribuição de conteúdos (CDN) líder de mercado, oferece oportunidades inigualáveis quando combinado com o poder do web scraping. Este guia aprofunda esta sinergia e apresenta dicas para maximizar a eficiência, garantir a precisão dos dados e utilizar o domínio de forma responsável.
CloudFront.net: Um gigante da distribuição de conteúdos
O Amazon CloudFront, frequentemente referido pelo seu domínio «CloudFront.net», é um serviço de rede de distribuição de conteúdos (CDN) oferecido pela Amazon Web Services (AWS).
Uma CDN é um sistema de servidores distribuídos que distribui conteúdos web e aplicações aos utilizadores com base na sua localização geográfica. Tem como objetivo proporcionar elevada disponibilidade e desempenho, distribuindo o serviço espacialmente em relação aos utilizadores finais.
O CloudFront integra-se com outros serviços da AWS para oferecer aos programadores e às empresas uma forma otimizada de distribuir conteúdos aos utilizadores finais com baixa latência e elevadas velocidades de transferência de dados.
Funciona armazenando cópias do seu conteúdo em vários locais em todo o mundo, conhecidos como locais de borda. Quando um utilizador solicita conteúdo, o CloudFront entrega-o a partir do local de borda mais próximo, garantindo o tempo de carregamento mais rápido possível.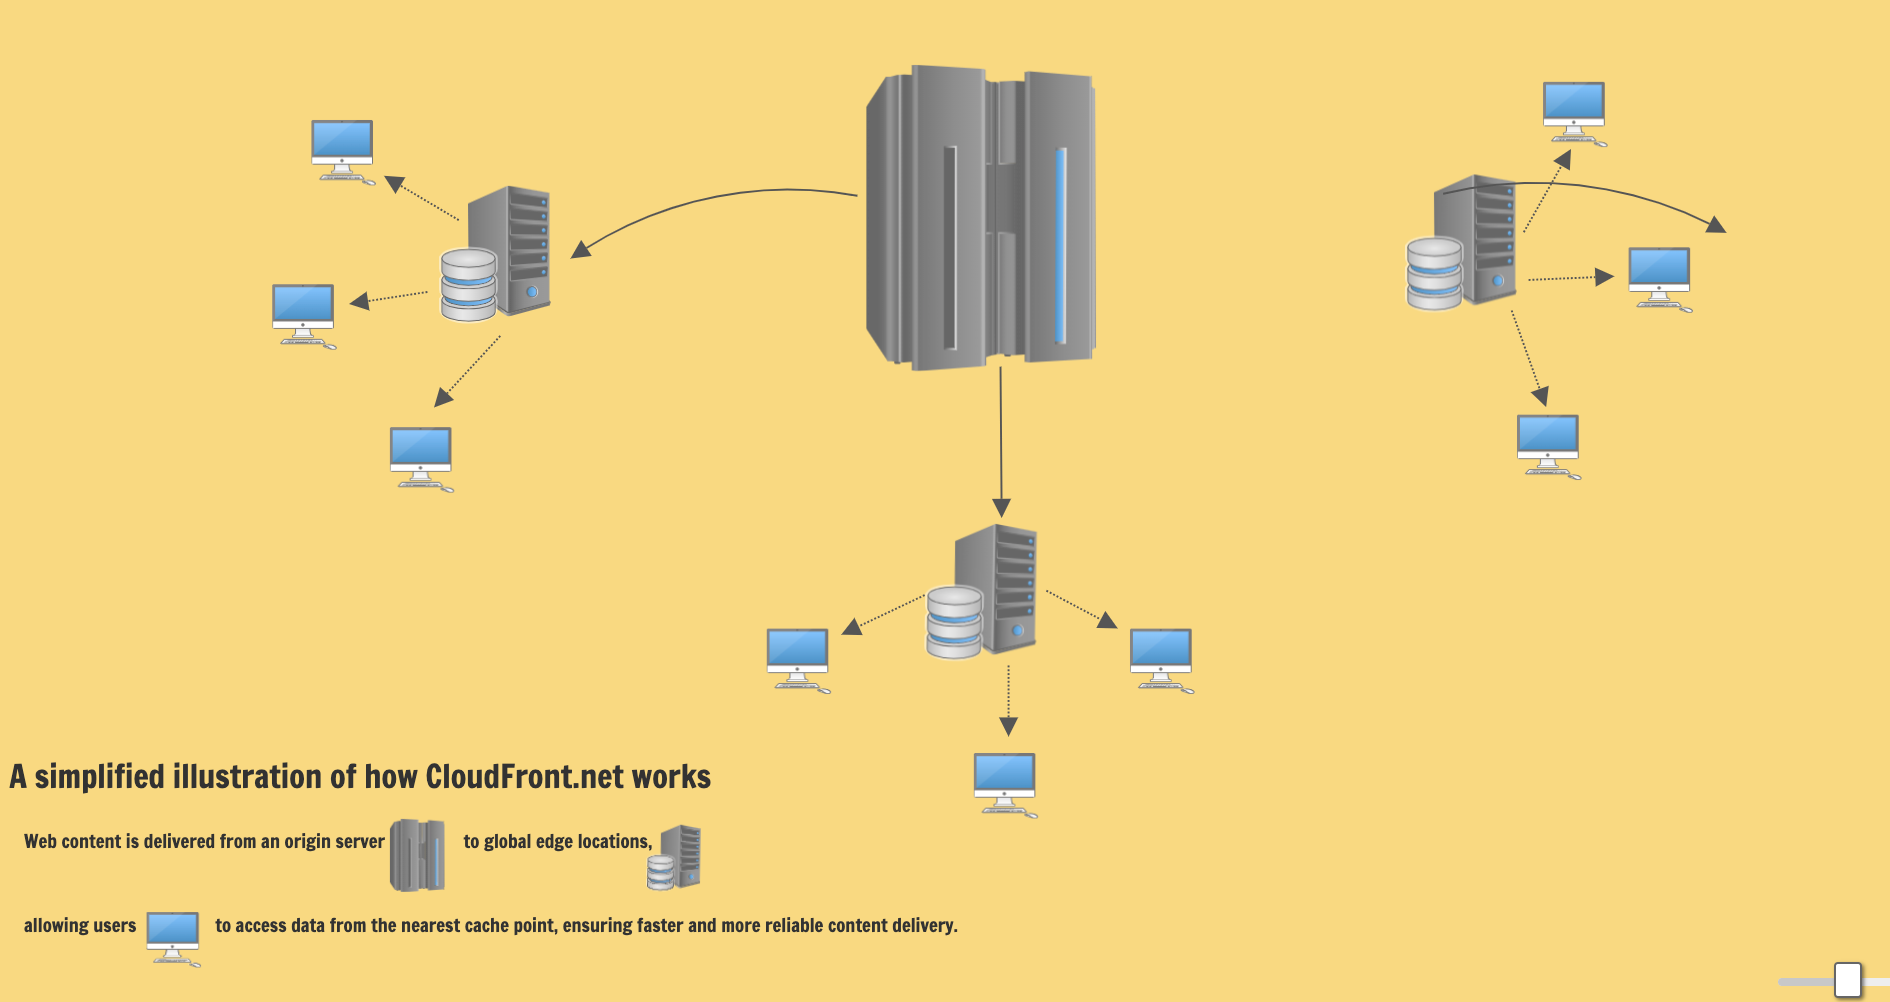
Principais funcionalidades e vantagens do CloudFront
-
Alcance global. O CloudFront dispõe de uma vasta rede de locais de borda em todo o mundo para reduzir a latência e garantir que o conteúdo é entregue a partir do ponto mais próximo do utilizador final.
-
Integração profunda com a AWS. O CloudFront está integrado com serviços da AWS como o Amazon S3, o Amazon EC2, o Elastic Load Balancing e o Route 53, facilitando a utilização conjunta destes serviços.
-
Segurança. O CloudFront oferece várias camadas de segurança, incluindo suporte a HTTPS, o AWS Shield para mitigação de ataques DDoS e integração com o AWS WAF (Web Application Firewall).
Foto da Vecteezy
-
Opções de personalização. Os programadores podem personalizar a entrega de conteúdos e adaptar a CDN aos requisitos específicos das aplicações.
-
Custo-eficaz. O CloudFront utiliza um modelo «pay-as-you-go», garantindo que só paga pelos dados que transfere, sem quaisquer custos iniciais.
-
Entrega de conteúdo dinâmico e estático. Embora muitas CDNs se especializem na entrega de conteúdo estático, o CloudFront suporta tanto conteúdo estático como dinâmico.
-
Fácil de utilizar para programadores. Com SDKs e uma API bem documentada, os programadores podem integrar e gerir facilmente as distribuições do CloudFront.
-
Métricas e registos em tempo real. O CloudFront fornece métricas e registos detalhados, permitindo uma análise e monitorização aprofundadas da entrega de conteúdos.
Compreender o Web Scraping e a Extração de Dados
O web scraping é o processo de recolha de dados de um site.
Envolve a realização de pedidos HTTP a páginas web, a recuperação do conteúdo HTML e, em seguida, a análise e extração da informação pretendida.
Foto da Vecteezy
Ao contrário da cópia manual de dados de um site, o web scraping automatiza este processo, permitindo a extração de grandes quantidades de dados num período de tempo relativamente curto.
O processo envolve normalmente:
- Envio de uma solicitação. Um scraper envia uma solicitação HTTP para o site de destino.
- Receber a resposta. O site responde com conteúdo HTML.
- Analisar o conteúdo. O scraper processa o HTML utilizando técnicas de análise para identificar estruturas de dados específicas.
- Extração de dados. Uma vez identificados, os dados pretendidos são extraídos do conteúdo analisado.
- Armazenamento de dados. Os dados extraídos são, em seguida, armazenados num formato estruturado, frequentemente em bases de dados ou folhas de cálculo.
O impacto do web scraping em diversos setores
O web scraping tem inúmeras aplicações em vários setores:
-
Comércio eletrónico. Os retalhistas fazem web scraping em sites da concorrência para monitorizar preços e ofertas de produtos.
-
Imobiliário. Os sites imobiliários são alvo de web scraping para recolher dados sobre anúncios de imóveis, preços e tendências de mercado.
-
Recrutamento. Os portais de emprego são alvo de web scraping para encontrar anúncios de emprego e analisar as exigências do mercado em termos de competências específicas.
Fotografia da Vecteezy
-
Finanças. As instituições financeiras fazem web scraping em sites do mercado bolsista para acompanhar cotações, notícias e o sentimento do mercado.
-
Investigação. Académicos e investigadores utilizam o web scraping para recolher dados em vários campos.
-
Notícias e meios de comunicação. Agregadores utilizam o web scraping em sites de notícias para selecionar conteúdos de diferentes fontes.
-
Viagens. Agências de viagens utilizam o web scraping em sites de companhias aéreas e hotéis para comparar preços e criar ofertas.
Ferramentas e técnicas de web scraping
Existem inúmeras ferramentas e técnicas disponíveis para o web scraping, que vão desde simples extensões de navegador até software complexo.
1. Navegadores headless
Foto da Vecteezy
Os navegadores sem interface desempenham um papel significativo na extração de dados da Web moderna, especialmente quando se lida com plataformas como o CloudFront.net. Eis porque são frequentemente essenciais para a extração de dados do CloudFront.net:
-
Carregamento dinâmico de conteúdo. Muitos sites, incluindo aqueles alojados no CloudFront.net, utilizam JavaScript para carregar conteúdo dinamicamente.
As ferramentas tradicionais de scraping obtêm o HTML inicial de uma página, o que pode não conter todos os dados se o conteúdo for carregado de forma assíncrona através de JavaScript.
Os navegadores headless podem executar JavaScript, permitindo que os scrapers acedam a conteúdo carregado dinamicamente.
-
Simulação do comportamento real do utilizador. Os navegadores headless podem imitar interações reais do utilizador, tais como percorrer a página, clicar em botões ou preencher formulários.
Esta capacidade é crucial quando os dados que pretende extrair dependem de alguma interação do utilizador.
-
Renderização de páginas web. Alguns conteúdos no CloudFront.net podem ser renderizados utilizando frameworks web como o React, o Angular ou o Vue.js. Estes frameworks requerem frequentemente um ambiente de navegador para renderizar corretamente o conteúdo da página.
Os navegadores headless conseguem renderizar estas páginas, garantindo que o scraper veja a página da mesma forma que um utilizador humano a veria.
-
Cookies e sessões. Os navegadores headless conseguem gerir cookies e sessões, o que pode ser necessário para aceder a determinados conteúdos no CloudFront.net, especialmente se for necessária a autenticação do utilizador ou o acompanhamento da sessão.
-
Depuração e desenvolvimento. Os navegadores headless vêm frequentemente com ferramentas de desenvolvimento que permitem depurar e testar os scripts de scraping.
Esta funcionalidade é inestimável ao desenvolver e aperfeiçoar estratégias de scraping para sites complexos.
2. Python e BeautifulSoup
O Python é uma linguagem de programação versátil amplamente utilizada para a extração de dados da Web, permitindo-lhe escrever linhas de código de acordo com as suas necessidades. Possui bibliotecas simples, mas abrangentes, sendo uma delas o BeautifulSoup.
Foto da Pexels
BeautifulSoup é uma biblioteca Python que permite recolher informações de páginas web. Cria uma árvore de análise a partir do código-fonte da página, que pode ser utilizada para extrair dados de forma hierárquica e mais legível.
Em combinação com a biblioteca `requests` do Python para obter páginas web, o BeautifulSoup torna o processo de web scraping simples e eficiente.
Principais funcionalidades do BeautifulSoup
- Análise simples. Consegue analisar ficheiros HTML ou XML, quer estejam bem formados, quer estejam malformados.
- Métodos de pesquisa. Fornece métodos como `find()`, `find_all()` e `select()` para navegar e pesquisar na árvore de análise.
- Manipulação de etiquetas. Permite a fácil manipulação de etiquetas e atributos.
- Codificação. Converte automaticamente os documentos recebidos para Unicode e os documentos enviados para a codificação UTF-8.
3. Proxies para um web scraping otimizado
Os proxies atuam como intermediários entre um utilizador e a Internet. Desempenham um papel fundamental no web scraping por várias razões:
-
Anonimato. A extração de dados da Web pode levar a bloqueios de IP se os sites detetarem tráfego invulgar proveniente de um único endereço IP.
Os proxies ocultam o IP real do extrator, garantindo o anonimato e reduzindo o risco de deteção e bloqueios.
-
Segmentação geográfica. Alguns sites apresentam conteúdos diferentes consoante a localização geográfica do utilizador.
Os proxies permitem que os scrapers acedam a conteúdos de regiões específicas, utilizando endereços IP dessas áreas.
-
Limitação de taxa. Os sites têm frequentemente limites de taxa para evitar sobrecargas. Ao alternar entre vários endereços IP de proxy, os scrapers podem efetuar mais pedidos a um site sem atingir os limites de taxa.
Foto da Pexels
-
Scraping paralelo. A utilização de vários proxies permite efetuar pedidos simultâneos, acelerando o processo de extração de dados, especialmente em tarefas de scraping em grande escala.
-
Redução do bloqueio. Os sites utilizam várias medidas anti-scraping. Os proxies, especialmente quando alternados com frequência, podem ajudar a contornar essas medidas, garantindo um scraping ininterrupto.
Porquê recolher dados do CloudFront.net?
Eis algumas aplicações práticas para os dados que podem ser recolhidos do CloudFront.net (ou de sites disponibilizados através do CloudFront):
-
Análise da concorrência. As empresas podem querer compreender o conteúdo, a estrutura ou os recursos do site de um concorrente disponibilizado através do CloudFront para avaliar as suas estratégias online, ofertas ou presença digital.
-
Agregação de conteúdos. Agregadores, como plataformas de notícias ou de comparação de preços, podem extrair dados de sites disponibilizados através do CloudFront para recolher e apresentar informações consolidadas aos seus utilizadores, oferecendo valor através de dados abrangentes.
-
Fins de investigação e académicos. Investigadores ou estudantes podem extrair dados de sites no CloudFront para recolher dados para projetos académicos, estudos ou artigos, com o objetivo de analisar tendências, padrões ou fenómenos.
[Foto](https://Photo por Vlada Karpovich https) da Pexels
-
Análise de SEO. Os profissionais de SEO podem extrair dados de sites disponibilizados através do CloudFront para compreender as suas estratégias de SEO on-page, perfis de backlinks ou estruturas de conteúdo, o que ajuda a aperfeiçoar as suas próprias táticas de SEO ou as dos seus clientes.
-
Monitorização de Conteúdo. Marcas ou particulares podem querer monitorizar sites específicos no CloudFront para detetar menções, críticas ou atualizações, permitindo-lhes manter-se informados e reagir prontamente a novos conteúdos.
-
Cópias de segurança e arquivo. Algumas entidades podem querer criar cópias de segurança do seu próprio conteúdo web disponibilizado através do CloudFront, garantindo que dispõem de versões históricas ou arquivos para referência futura.
-
Análise de mercado. Empresas de comércio eletrónico ou analistas de mercado podem extrair listas de produtos, avaliações ou dados de preços de sites no CloudFront para compreender as tendências de mercado, as preferências dos consumidores ou as estratégias de preços.
É essencial ter em conta que, embora estes casos de utilização apresentem razões legítimas para a extração de dados da Web, deve garantir sempre que a extração é realizada de forma ética, especialmente quando se trata de sites disponibilizados através de CDNs robustas como o CloudFront.
Como extrair dados do CloudFront.net
- Identifique o URL de destino. Determine o URL específico do CloudFront.net que pretende extrair.

- Inspecione a página web. Utilize as ferramentas de desenvolvimento do navegador para inspecionar a estrutura da página e identificar os dados que pretende extrair.

- Escreva o script de extração. Utilize bibliotecas Python para escrever um script que recupere e analise a página web.
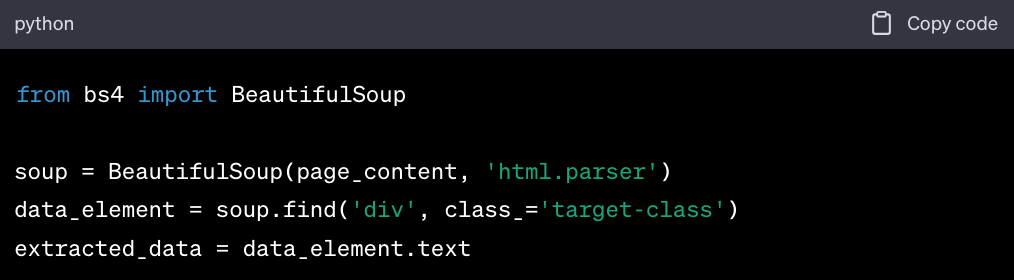
- Lide com a paginação. Se o conteúdo se estender por várias páginas, certifique-se de que o seu script consegue navegar e extrair dados de todas as páginas. (Partindo do princípio de que cada página tem um botão «Seguinte» que remete para a página seguinte.)
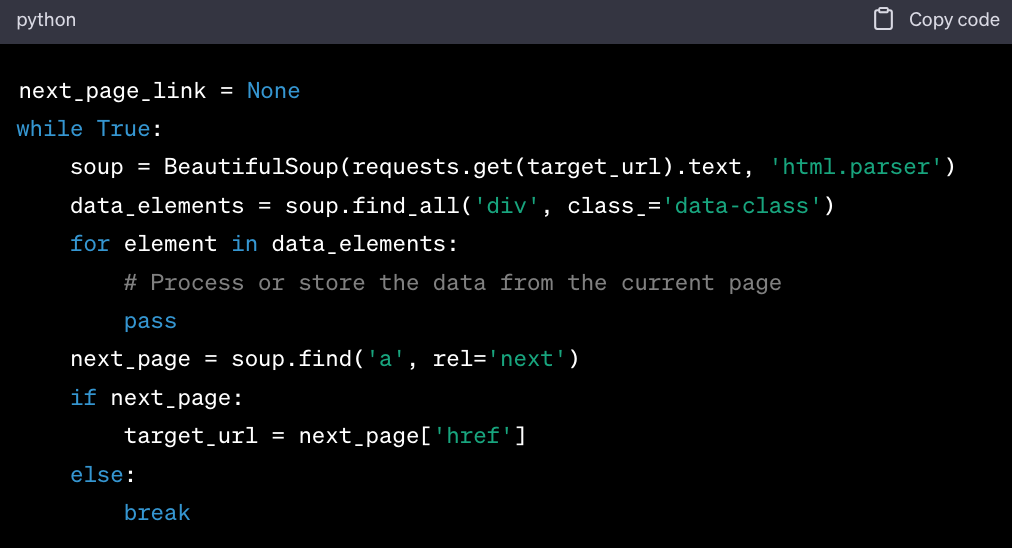
- Armazene os dados. Guarde os dados extraídos num formato estruturado, como um ficheiro CSV, JSON ou uma base de dados.

- Respeite o ficheiro
robots.txt: Verifique sempre e respeite o ficheiro robots.txt do CloudFront.net para garantir que não está a violar quaisquer regras de extração de dados. 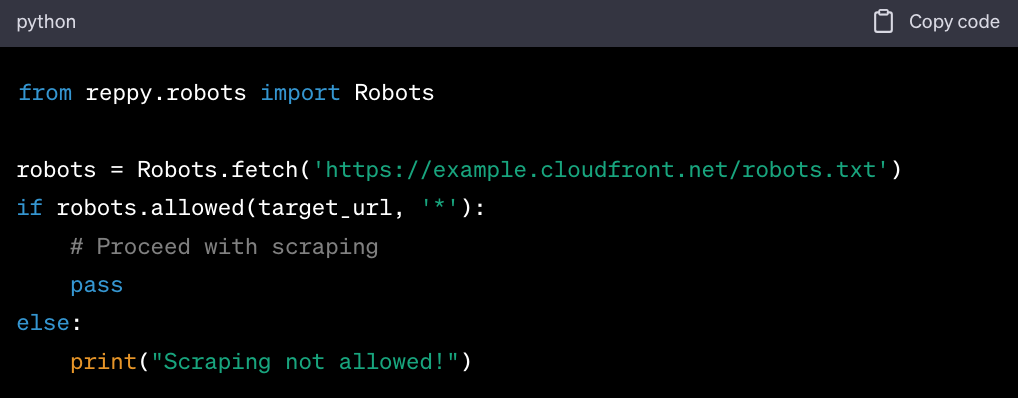
Navegar pelo panorama jurídico da extração de dados do CloudFront.net
A extração de dados da Web, especialmente em plataformas como o CloudFront.net, requer uma compreensão profunda das complexidades jurídicas envolvidas, tais como
-
Termos de Serviço (ToS). Antes de extrair dados do CloudFront.net ou de qualquer outro site, consulte sempre os seus Termos de Serviço.
Consulte sempre os Termos de Serviço da AWS antes de iniciar qualquer atividade de scraping no CloudFront.net ou noutros serviços da AWS. Ignorar estes termos pode acarretar repercussões legais.
-
Leis de direitos de autor. Os dados no CloudFront.net, mesmo que sejam de acesso público, podem estar protegidos por direitos de autor.
Certifique-se de que os dados extraídos são utilizados de forma a não infringir estas leis.
Foto da Pexels
-
Regulamentos de Proteção de Dados. Regulamentos como o RGPD e a CCPA dão ênfase à privacidade do utilizador.
Ao extrair dados pessoais do CloudFront.net, certifique-se de que cumpre estas leis, incluindo o armazenamento seguro e as autorizações necessárias.
-
Lei contra a Fraude e o Abuso Informático (CFAA). Esta lei dos EUA criminaliza o acesso não autorizado a sistemas informáticos.
Certifique-se de que as suas atividades de scraping no CloudFront.net não violam os seus Termos de Serviço (ToS) para evitar conflitos com a CFAA.
Respeitar os limites digitais no CloudFront.net
O web scraping ético consiste em respeitar o espaço digital de plataformas como o CloudFront.net:
-
Limitação de taxa. Evite sobrecarregar o CloudFront.net enviando demasiados pedidos num curto espaço de tempo.
Cumpra quaisquer limites de taxa e espalhe as suas atividades de scraping ao longo do tempo.
-
Informações sensíveis. O CloudFront.net pode alojar dados pessoais ou sensíveis. Dê prioridade à privacidade do utilizador e evite o web scraping malicioso.
-
Indique a fonte. Se utilizar dados do CloudFront.net para investigação ou outros fins, indique sempre a plataforma como fonte.
-
Solicite autorização. Se tiver dúvidas sobre a extração de dados do CloudFront.net, é melhor solicitar autorização aos administradores da plataforma.
Contornar as medidas anti-scraping no CloudFront.net
O CloudFront.net, tal como muitas plataformas, pode dispor de medidas para dissuadir os scrapers:
- User-Agents. O CloudFront.net pode bloquear user-agents conhecidos de scrapers. Alterne os user-agents ou simule um navegador genuíno para contornar esta restrição.
- CAPTCHAs. O CloudFront.net pode utilizar CAPTCHAs para verificar se os utilizadores são humanos. Embora existam ferramentas para os contornar, desafios frequentes podem levar ao bloqueio de IPs.
- Bloqueios de IP. Se o CloudFront.net detetar atividade invulgar, poderá bloquear o IP. Utilize proxies de forma responsável para alternar entre endereços IP e continuar a extrair dados.
- Honeypots. Tenha cuidado com as armadilhas «honeypot» no CloudFront.net — pontos de dados falsos criados para detetar scrapers.
Otimização das tarefas de scraping no CloudFront.net com proxies residenciais dGeonode
A integração de Geonode proxies com ferramentas e scripts de scraping pode melhorar significativamente o processo de scraping, especialmente quando se trata de plataformas robustas como o CloudFront.net.
 A
Geonode tem-se destacado como prestadora de serviços de proxy graças ao seu vasto leque de funcionalidades de destaque.
Aclamada pela sua rede de proxies fiável, que garante um tempo de inatividade mínimo e um desempenho consistente, a Geonode orgulha-se de uma ampla cobertura, apoiada por um vasto número de endereços IP que abrangem vários países.
Além disso, o Geonode oferece tempos de resposta rápidos devido à sua infraestrutura robusta, um fator crucial para um web scraping eficiente. Proporciona ligações seguras e satisfaz as mais variadas necessidades de web scraping, garantindo a privacidade dos dados e a proteção contra potenciais ameaças.
Perguntas frequentes
De que forma o CloudFront.net melhora a entrega de conteúdos?
O CloudFront.net é um serviço de rede de distribuição de conteúdos (CDN) fornecido pela Amazon Web Services (AWS).
Em termos simples, uma CDN é como uma rede de serviços de entrega rápida espalhados por todo o mundo, garantindo que os conteúdos online cheguem aos utilizadores de forma rápida e eficiente. Eis como funciona:
-
Distribuição global. O CloudFront dispõe de inúmeros centros de dados, conhecidos como «edge locations», espalhados por todo o mundo.
Quando um utilizador solicita conteúdo, este é entregue a partir do «edge location» mais próximo, garantindo um atraso ou latência mínimos.
-
Integração com a AWS. Como parte do ecossistema da AWS, o CloudFront integra-se perfeitamente com outros serviços da AWS.
Se o seu site ou aplicação estiver alojado na AWS, a utilização do CloudFront pode tornar a entrega de conteúdos ainda mais eficiente.
-
Conteúdo dinâmico e estático. Enquanto algumas CDNs são mais adequadas para a entrega de conteúdo estático (como imagens ou folhas de estilo), o CloudFront é especialista na entrega tanto de conteúdo estático como dinâmico (como páginas web específicas para cada utilizador).
-
Segurança. O CloudFront oferece funcionalidades de segurança robustas, incluindo HTTPS para a transferência segura de dados, proteção contra ataques DDoS e integração com o Web Application Firewall da AWS.
-
Custo-eficácia. Com o seu modelo «pay-as-you-go» (pague apenas pelo que utilizar), os utilizadores pagam apenas pelo conteúdo que distribuem, tornando-o uma solução económica para empresas de todas as dimensões.
Essencialmente, o CloudFront.net garante que o seu conteúdo online chega aos seus utilizadores de forma rápida, segura e eficiente, independentemente de onde se encontrem no mundo.
Por que razão os proxies como o Geonode são cruciais para o web scraping?
O web scraping envolve a recolha de diferentes tipos de dados a partir de sites. No entanto, este processo nem sempre é simples.
Os sites podem ter medidas para bloquear ou limitar o acesso automatizado. É aqui que os proxies, especialmente os fiáveis como o Geonode, entram em ação:
-
Contornar restrições. O CloudFront.net, por fazer parte do conjunto de serviços da AWS, possui medidas de segurança robustas.
Os proxies do Geonode podem ajudar a contornar restrições baseadas em IP e aceder aos dados sem disparar alarmes.
-
Equilíbrio de carga. Ao extrair grandes conjuntos de dados do CloudFront.net, os proxies Geonode podem distribuir os pedidos, garantindo um equilíbrio de carga eficiente e uma recuperação de dados mais rápida.
-
Acesso a dados atualizados. O CloudFront.net pode servir conteúdo em cache com base na localização geográfica do pedido.
A vasta gama de endereços IP daGeonode garante o acesso a dados atualizados e em tempo real.
-
Tratamento de erros. Em caso de bloqueios ou captchas, os scripts integrados com Geonode podem mudar automaticamente para outro proxy, garantindo uma extração ininterrupta.
-
Contornar limites de taxa. O CloudFront impõe limites ao número de pedidos provenientes de um único IP num determinado período de tempo.
Ao alternar entre os proxies do Geonode, os scrapers podem efetuar pedidos mais frequentes sem serem bloqueados.
-
Fiabilidade. Nem todos os proxies são iguais. O Geonode é conhecido pelos seus proxies estáveis e de alta velocidade, garantindo um scraping eficiente e ininterrupto.
-
Segurança. A utilização dos proxies do Geonode garante uma ligação segura, protegendo o scraper de potenciais ameaças e olhares indiscretos.
Para quem leva a sério o web scraping, proxies fiáveis como os de Geonode não são apenas benéficos; são essenciais.
O web scraping é legal?
Nos EUA, a legalidade do web scraping tem sido tema de debate e foi abordada em vários processos judiciais.
Um dos casos mais citados é o hiQ Labs, Inc. v. LinkedIn Corp., em que o Tribunal de Recurso do Nono Circuito considerou que a extração de dados de sites acessíveis ao público provavelmente não viola a CFAA.
O tribunal decidiu a favor da hiQ, uma empresa que extraía dados publicamente disponíveis do LinkedIn.
A decisão do tribunal baseou-se na interpretação de que a CFAA visa as violações das restrições de acesso informático e não a utilização indevida de dados por parte de quem dispõe de acesso autorizado.
Embora a extração de dados da Web não seja, por si só, ilegal, é fundamental abordá-la de forma responsável.
Respeite sempre os Termos de Serviço de um site, tenha em conta as leis de direitos de autor e de proteção de dados e, em caso de dúvida, procure aconselhamento jurídico.
Conclusão
A interação entre o CloudFront.net, o web scraping e os proxies Geonode apresenta um panorama convincente de eficiência, inovação e aquisição responsável de dados.
Com o seu alcance global, o CloudFront.net facilita a entrega rápida de conteúdos e promove uma experiência de utilizador sem interrupções.
O web scraping, por sua vez, revela informações significativas, impulsionando a investigação e a inovação quando utilizado de forma ética.
Os proxies Geonode complementam este processo, permitindo a navegação anónima na Web, contornando restrições geográficas e garantindo um fluxo constante de dados.
Mas, à medida que aproveitamos as capacidades combinadas do CloudFront.net, do web scraping e dos proxies Geonode, é imperativo dar prioridade às práticas éticas.
Foto da Vecteezy
Respeitar os limites digitais, cumprir as diretrizes legais e garantir a privacidade e os direitos das entidades online devem estar na vanguarda de todos os nossos esforços.
Comprometamo-nos todos com práticas éticas e com a busca contínua de conhecimento. O mundo digital está em constante evolução e, ao agirmos de forma responsável e mantendo-nos informados, podemos garantir que as nossas ações beneficiem não só a nós próprios, mas também a comunidade online em geral.
.

