Web scraping e a sua crescente relevância
O web scraping tornou-se um método cada vez mais popular para recolher dados de várias fontes online.
Seja para estudos de mercado, análises da concorrência ou fins académicos, a capacidade de recolher informações de sítios Web oferece inúmeras oportunidades.
No entanto, não é tão simples como parece. O web scraping traz consigo um conjunto próprio de desafios, complexidades e considerações éticas.
Foco no DoubleClick.net
Este artigo tem como objetivo explorar o caso específico do DoubleClick.net, uma plataforma amplamente utilizada para publicidade digital.
Embora o título possa sugerir o contrário, é importante esclarecer que este artigo não fornecerá instruções detalhadas nem passos a seguir sobre como fazer web scraping no DoubleClick.net.
Em vez disso, iremos analisar as questões essenciais que deve colocar antes mesmo de considerar tal empreendimento.
A importância de colocar as perguntas certas
Antes de iniciar qualquer projeto de web scraping, é crucial fazer as perguntas certas.
Estas perguntas irão ajudá-lo a compreender os riscos, as implicações legais e os desafios técnicos que poderá enfrentar.
Elas irão orientá-lo na tomada de decisões informadas, garantindo que não se aventura num campo minado sem estar preparado.
Ferramentas para decisões informadas: Geonode
Proxies e Scraper API
À medida que exploramos estas questões, iremos também discutir algumas das ferramentas que o podem ajudar a tomar decisões mais informadas.
Mais especificamente, iremos analisar como os proxies [Geonode
](https://geonode.com) e o scraper API
podem ser recursos valiosos no seu conjunto de ferramentas de recolha de dados.
Estas ferramentas podem oferecer-lhe uma forma mais segura e eficiente de recolher dados, caso decida avançar com um projeto de web scraping.
No final deste artigo, terá uma melhor compreensão das questões a colocar e das ferramentas a considerar para uma abordagem responsável ao web scraping do DoubleClick.net e, talvez, de outros sites populares.
Porquê o DoubleClick.net?
O que é o DoubleClick.net e por que razão é alvo de scraping?
Também conhecido como Google Marketing Platform, o DoubleClick.net é uma subsidiária da Google especializada no desenvolvimento e fornecimento de serviços de veiculação de publicidade na Internet.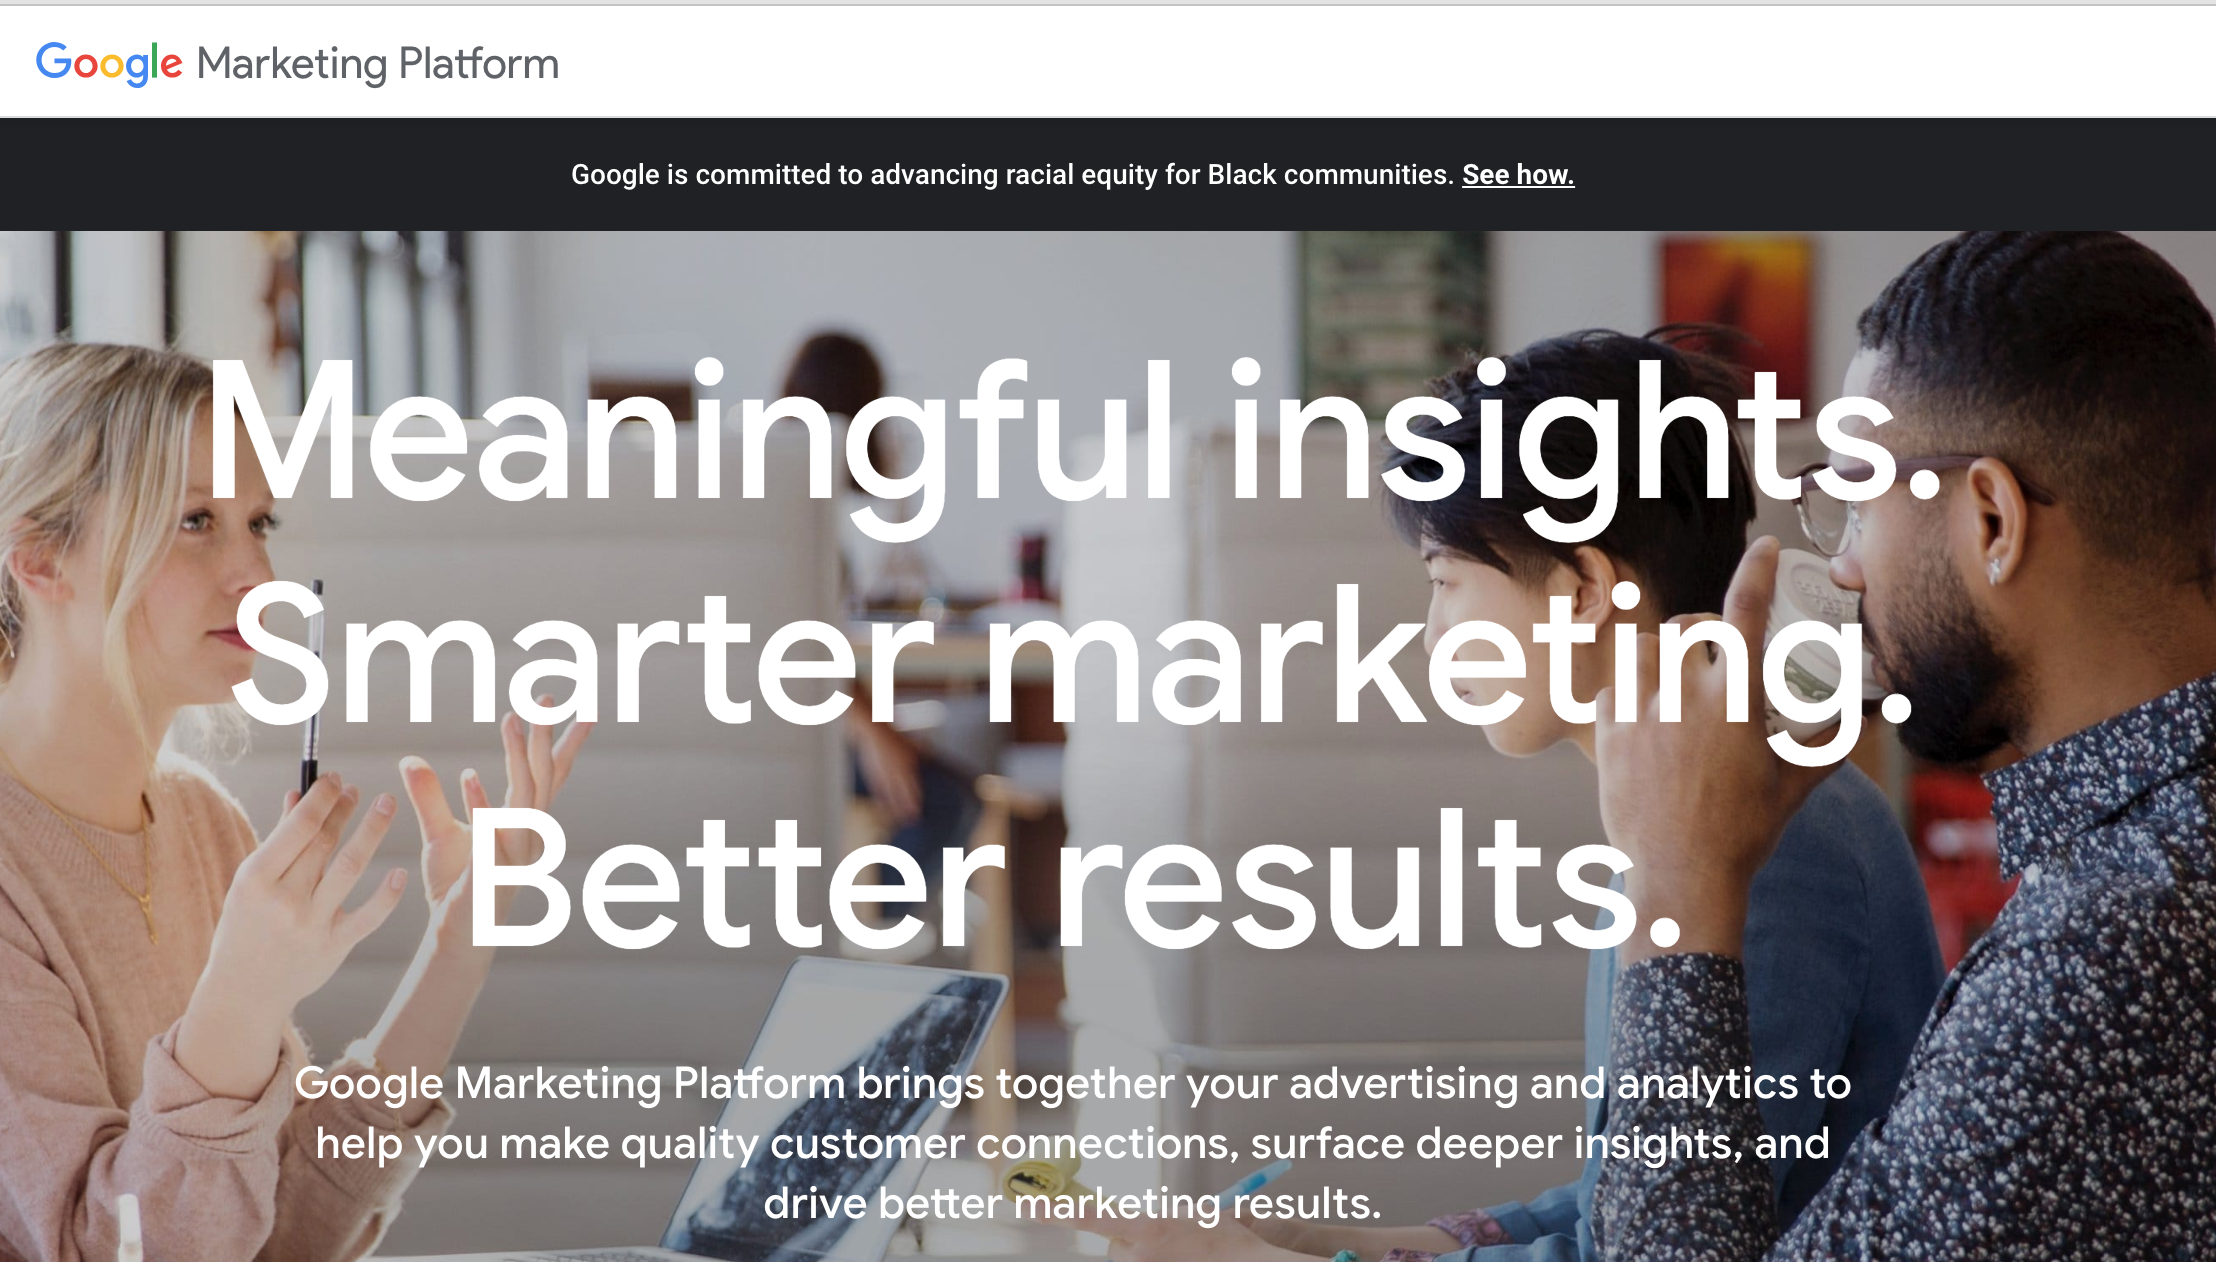
Trata-se de um serviço de publicidade legítimo, onde anunciantes e editores se reúnem para comprar e vender espaço publicitário.
Dado o seu vasto alcance e a riqueza dos dados que detém, o DoubleClick.net torna-se um alvo atraente para o scraping na Web.
Então, por que razão considerar o scraping do DoubleClick.net?
A plataforma contém uma grande quantidade de dados que podem ser inestimáveis para estudos de mercado, análises da concorrência e estratégias publicitárias.
Desde métricas de envolvimento dos utilizadores até estatísticas de desempenho dos anúncios, os dados disponíveis podem fornecer informações que não são facilmente acessíveis noutros locais.
No entanto, é essencial abordar isto com cautela, compreendendo as complexidades e as questões legais envolvidas, que iremos discutir em secções posteriores.
O Fascínio do Conteúdo Publicitário e de Outros Dados do DoubleClick.net
No que diz respeito aos tipos de dados disponíveis, o DoubleClick.net é uma mina de ouro.
A plataforma oferece várias métricas e análises que podem ser cruciais para empresas e anunciantes.
Estas podem variar desde taxas de cliques, impressões e dados demográficos dos utilizadores até dados mais complexos, como o comportamento dos utilizadores e a interação com os anúncios.
Tipos de dados do DoubleClick.net
-
Métricas de envolvimento dos utilizadores. Compreenda como os utilizadores estão a interagir com os anúncios, incluindo o tempo gasto a visualizar, cliques e outras métricas de envolvimento.
-
Métricas de desempenho dos anúncios. Obtenha informações sobre o desempenho de diferentes anúncios em termos de alcance, cliques e conversões.
-
Dados demográficos. Aceda a informações sobre o público que está a interagir com os anúncios, incluindo idade, localização e interesses.
-
Dados comportamentais. Conheça o comportamento dos utilizadores, tais como os tipos de anúncios em que clicam, os dispositivos que utilizam e os seus hábitos de navegação.
-
Métricas financeiras. Obtenha dados sobre o custo por clique, o custo por impressão e o ROI global das campanhas publicitárias.
O fascínio dos dados do DoubleClick.net reside na sua abrangência e profundidade.
Estes tipos de dados podem proporcionar uma visão de 360 graus do desempenho publicitário e do envolvimento dos utilizadores, tornando tentador para analistas de dados e profissionais de marketing considerar a extração de dados da plataforma.
No entanto, como iremos discutir nas secções seguintes, a extração de dados do DoubleClick.net não é simples e acarreta um conjunto próprio de desafios e considerações éticas.
Considerações legais
É legal fazer scraping do DoubleClick.net?
A questão da legalidade é uma das primeiras que deve vir à mente ao considerar fazer scraping de qualquer site, e o DoubleClick.net não é exceção.
Então, quais são as implicações legais de extrair dados do DoubleClick.net?
Em primeiro lugar, é fundamental compreender que a extração de dados da Web, em geral, ocupa uma zona cinzenta no panorama jurídico.
As leis relativas ao web scraping variam consoante a jurisdição e estão frequentemente sujeitas a interpretação.
No entanto, o DoubleClick.net, sendo uma subsidiária da Google, possui termos de serviço que proíbem explicitamente a extração do seu conteúdo sem autorização.
A violação destes termos, seja através de um método explorável ou de uma infiltração dissimulada, pode levar a ações legais, incluindo, entre outras, a proibição de utilizar os seus serviços.
Por conseguinte, antes de prosseguir com quaisquer atividades de scraping, é aconselhável consultar profissionais da área jurídica para compreender as leis e regulamentos específicos que se podem aplicar ao seu caso.
Além disso, leia e compreenda sempre os termos de serviço dos sites — sejam eles de publicidade, redes sociais, financeiros, etc. — que pretende extrair.
Consequências do scraping ilegal
Se avançar com o scraping do DoubleClick.net sem respeitar as diretrizes legais, estará a expor-se a vários riscos.
Pode meter-se em apuros e sair dessa situação exigirá mais do que apenas reiniciar o navegador ou premir o botão de reinício
Eis alguns riscos associados ao scraping do DoubleClick.net:
-
Suspensão da conta. O DoubleClick.net consegue detetar aplicações maliciosas capazes de automatizar atividades de scraping, e uma das medidas imediatas que pode tomar é suspender ou banir a sua conta, impedindo o acesso aos seus serviços.
-
Ação judicial. Conforme mencionado anteriormente, extrair dados do DoubleClick.net sem autorização viola os seus termos de serviço, e eles podem intentar uma ação judicial contra si.
Isto pode resultar em multas avultadas e, em casos extremos, em acusações criminais.
-
Prejuízo à reputação. Ser apanhado a fazer scraping ilegalmente pode prejudicar gravemente a sua reputação, afetando tanto a sua vida pessoal como profissional.
-
Imprecisão dos dados. Mesmo que consiga extrair alguns dados, não há garantia da sua precisão ou integridade, uma vez que o DoubleClick.net pode implementar medidas anti-scraping que fornecem dados incorretos a aplicações e scrapers suspeitos.
-
Desgaste de recursos. As atividades de scraping podem consumir recursos computacionais e tempo significativos, especialmente se for apanhado e tiver de lidar com consequências legais.
-
Questões éticas. Para além das ramificações legais, o scraping sem autorização levanta questões éticas que podem afetar a sua reputação na comunidade profissional.
Compreender estes riscos é crucial para quem estiver a considerar fazer scraping do DoubleClick.net.
Não se trata apenas da capacidade técnica de extrair dados, mas também de compreender o panorama jurídico e as potenciais consequências de o infringir.
Por isso, é essencial ponderar cuidadosamente estes riscos e consultar profissionais da área jurídica antes de se envolver em quaisquer atividades de scraping.
Questões éticas
A ética do scraping na Web
Embora os aspetos legais do scraping na Web sejam inegavelmente importantes, as considerações éticas são igualmente cruciais.
Então, quais são as considerações éticas relacionadas com a extração de dados do DoubleClick.net?
-
Privacidade dos dados. O DoubleClick.net recolhe dados dos utilizadores que interagem com a plataforma.
A extração destes dados sem consentimento pode ser considerada uma invasão de privacidade.
-
Utilização justa. Sites como o DoubleClick.net investem recursos na recolha e apresentação de dados.
A extração em massa destes dados pode ser vista como uma utilização injusta desses recursos.
-
Transparência. Se estiver a extrair dados para fins de investigação ou académicos, é considerado ético ser transparente quanto aos seus métodos e intenções.
-
Integridade. Manipular ou utilizar dados extraídos de forma a deturpar os factos é considerado altamente antiético.
-
Utilização comercial. Utilizar dados extraídos para fins lucrativos sem a autorização da DoubleClick.net pode ser considerado ilegal e antiético.
-
Acordo de utilizador. Ignorar ou violar intencionalmente os termos de serviço de um site é geralmente considerado antiético.
Compreender o panorama ético é crucial antes de iniciar qualquer projeto de web scraping. Não se trata apenas de saber se pode extrair dados, mas se deve fazê-lo.
Estudos de caso sobre web scraping ético
Para ilustrar melhor as dimensões éticas do web scraping, vejamos alguns exemplos de práticas éticas de web scraping.
-
Investigação académica. Os investigadores recorrem frequentemente ao web scraping para fins académicos e, normalmente, fazem-no de acordo com diretrizes éticas rigorosas, incluindo a obtenção de autorização do site e a garantia do anonimato dos dados.
-
Dados públicos. Alguns sites disponibilizam dados que são, por natureza, públicos, como as estatísticas governamentais.
A recolha destes dados através de passos manuais é geralmente considerada ética se for utilizada para o bem público e não para ganho pessoal.
-
Transparência. Empresas como a Geonode oferecem serviços de «scraper API» concebidos para respeitar os termos de utilização dos sites e os ficheiros robots.txt, cumprindo assim as normas éticas.
-
Avaliações de utilizadores. Os sites que agregam avaliações de utilizadores costumam extrair dados de várias fontes, mas fazem-no de forma transparente e oferecem um serviço que beneficia o público.
-
Jornalismo. Os jornalistas de investigação recorrem, por vezes, ao web scraping para recolher dados para reportagens que servem o interesse público.
No entanto, costumam seguir diretrizes éticas rigorosas, incluindo a verificação dos dados e a transparência quanto aos seus métodos.
Ao analisar estes estudos de caso, podemos obter insights sobre como o web scraping pode ser realizado de forma ética.
A principal conclusão é que o web scraping ético não se resume apenas ao ato de recolher dados, mas também à forma como esses dados são utilizados e para que fins.
Em resumo, as considerações éticas devem estar na vanguarda de qualquer discussão sobre o web scraping, especialmente quando se trata de uma plataforma tão significativa como a DoubleClick.net.
Pondere sempre as implicações éticas a par dos desafios legais e técnicos.
Desafios técnicos
Que desafios técnicos irá enfrentar?
Ao considerar a extração de dados do DoubleClick.net, é essencial estar ciente dos obstáculos técnicos que isso acarreta. Então, quais são as dificuldades técnicas na extração de dados do DoubleClick.net?
-
Medidas anti-scraping. O DoubleClick.net utiliza vários softwares adicionais e técnicas anti-scraping, tais como CAPTCHAs, limitação da taxa de IP e verificações da string do agente do utilizador, o que torna difícil extrair dados do site de forma eficaz.
-
Conteúdo dinâmico. A plataforma utiliza frequentemente JavaScript para carregar conteúdo de forma dinâmica, o que requer técnicas de scraping mais avançadas do que a simples análise de HTML.
-
Complexidade dos dados. O DoubleClick.net oferece uma vasta gama de tipos e estruturas de dados, que podem ser difíceis de navegar e extrair de forma significativa. 
-
Limitação de taxa. Mesmo que consiga contornar as medidas anti-scraping iniciais, poderá ainda deparar-se com limites de taxa que restringem a quantidade de dados que pode recolher num determinado período de tempo.
-
Carga do servidor. Atividades de scraping mal executadas podem sobrecarregar os servidores do DoubleClick.net, afetando o desempenho do site e podendo levar ao bloqueio do seu IP.
-
Integridade dos dados. Tal como mencionado na secção jurídica, alguns sites fornecem dados incorretos ou enganosos a utilizadores suspeitos de scraping, tornando os dados recolhidos pouco fiáveis.
Compreender estes desafios técnicos é crucial para quem estiver a considerar fazer scraping do DoubleClick.net.
Não se trata apenas de instalar programas, enviar pedidos aos navegadores da Internet e recolher dados; será necessária uma estratégia bem planeada para superar estes desafios de forma eficaz.
Importância da utilização de proxies e APIs
Dadas as complexidades técnicas da extração de dados do DoubleClick.net, a utilização de ferramentas especializadas, como proxies e APIs, torna-se não só benéfica, mas muitas vezes necessária. Neste contexto, os proxies Geonode e scraper API oferecem soluções valiosas.
-
Geonode Proxies. Estes proxies permitem-lhe encaminhar os seus pedidos de scraping através de diferentes endereços IP, reduzindo o risco de ser detetado e banido pelo DoubleClick.net.
Oferecem também proxies residenciais, que são menos suscetíveis de serem sinalizados por atividades de scraping.
-
Scraper API da Geonode. Esta API lida com muitos dos desafios associados ao web scraping, tais como CAPTCHAs e novas tentativas, tornando o processo mais eficiente.
Respeita igualmente o ficheiro robots.txt do site, em conformidade com as práticas éticas de scraping.
-
Equilíbrio de carga. Geonode oferece funcionalidades de equilíbrio de carga, garantindo que não sobrecarregue os servidores do DoubleClick.net, minimizando assim o risco de ser banido.
-
Precisão dos dados. A utilização de uma API fiável como a scraper API pode aumentar a probabilidade de obter dados precisos e fiáveis, uma vez que foi concebida para contornar eficazmente as medidas anti-scraping.
-
Conformidade legal e ética: os serviços da Geonode foram concebidos para respeitar os termos de utilização dos sites e os ficheiros robots.txt, tornando-os uma escolha mais ética para atividades de web scraping.
Ao utilizar ferramentas como os proxies de Geonode e scraper API, é possível mitigar muitos dos desafios técnicos associados ao scraping do DoubleClick.net.
Estas ferramentas oferecem uma forma mais segura, eficiente e ética de recolher dados, caso decida avançar com um projeto de web scraping.
Perguntas a fazer
Antes de avançar com qualquer projeto de web scraping, especialmente um tão complexo e repleto de desafios como o DoubleClick.net, é fundamental colocar a si próprio algumas perguntas fundamentais.
Estas perguntas irão orientá-lo na tomada de decisões informadas e ajudá-lo a compreender se o scraping é a abordagem certa para as suas necessidades.
Qual é o seu objetivo final?
A primeira pergunta a fazer é simples, mas muitas vezes ignorada: Qual é o seu objetivo final? Ou, por outras palavras, quais são os seus objetivos ao fazer scraping do DoubleClick.net?
- Estudo de mercado: Pretende recolher dados para análise de mercado?
- Análise da concorrência: Pretende compreender como é que os seus concorrentes estão a fazer publicidade?
- Investigação académica: Trata-se de um projeto académico que requer dados aprofundados?
- Utilização pessoal: Pretende recolher dados para análise pessoal ou aprendizagem?
Compreender o seu objetivo final não só orientará a sua estratégia de scraping, como também o ajudará a avaliar se vale a pena correr os riscos e enfrentar os desafios.
Dispõe dos recursos necessários?
O web scraping, especialmente a partir de uma plataforma complexa como a DoubleClick.net, requer vários recursos, tanto humanos como técnicos.
-
Competências técnicas. Você ou a sua equipa têm os conhecimentos técnicos necessários para enfrentar os desafios do scraping da DoubleClick.net?
-
Hardware e software. Dispõe dos recursos computacionais necessários para realizar o scraping?
-
Tempo. O scraping na Web pode ser demorado, especialmente se se deparar com desafios que exijam resolução de problemas.
-
Recursos financeiros. Algumas ferramentas e serviços podem ajudar na extração de dados da Web, mas têm um custo.
Neste contexto, os proxies Geonode e scraper API podem ser recursos inestimáveis. Podem ajudá-lo a superar muitos dos desafios técnicos associados à extração de dados do DoubleClick.net, tornando o processo mais eficiente e seguro.
Quais são as alternativas?
Antes de mergulhar num projeto de web scraping, é aconselhável considerar outras vias para obter os dados de que necessita. Então, quais são as alternativas ao scraping do DoubleClick.net?
-
Dados disponíveis publicamente. Algumas das informações que procura podem já estar disponíveis em conjuntos de dados ou relatórios públicos, mas podem estar repletas de programas suspeitos, como software indesejado e sequestradores de navegador.
-
APIs. Algumas plataformas oferecem APIs que fornecem dados de forma mais estruturada e ética.
-
Recolha manual de dados. Dependendo das suas necessidades, a recolha manual de dados pode ser viável, embora seja geralmente mais demorada do que as alternativas e muito mais difícil do que utilizar a caixa de pesquisa ou o seu motor de busca preferido.
-
Serviços de terceiros. Algumas empresas especializam-se na recolha de dados e podem já dispor dos dados de que necessita.
-
Parcerias. Estabelecer uma parceria com a DoubleClick.net ou plataformas semelhantes pode ser uma forma de aceder aos dados de forma legal e ética.
Ao considerar estas alternativas, poderá tomar uma decisão mais informada sobre se o web scraping é o método mais eficaz e adequado para atingir os seus objetivos.
Em resumo, antes de avançar com o scraping do DoubleClick.net, é fundamental colocar a si próprio estas questões para avaliar a viabilidade, os riscos e as implicações do seu projeto.
Perguntas frequentes
É ilegal fazer scraping do DoubleClick.net?
A legalidade do scraping do DoubleClick.net é uma questão complexa e varia consoante a jurisdição e as ações específicas realizadas.
Os termos de serviço do DoubleClick.net proíbem explicitamente a extração de dados sem autorização. A violação destes termos pode acarretar consequências legais, incluindo a suspensão da conta e possíveis ações judiciais.
Por isso, é fundamental consultar profissionais da área jurídica para compreender as leis e regulamentos específicos que se podem aplicar ao seu caso.
Como posso fazer scraping num site sem ser apanhado?
Embora não possamos endossar a prática de fazer scraping num site em violação dos seus termos de serviço, existem práticas gerais que podem minimizar o risco de deteção.
Estas incluem limitar a frequência das suas solicitações, alternar endereços IP e respeitar o ficheiro robots.txt do site.
Ferramentas especializadas, como os proxies do Geonode e o scraper API, foram concebidas para contornar muitos dos desafios associados ao web scraping, tornando o processo mais eficiente e menos suscetível de resultar em deteção.
No entanto, é essencial compreender que estas práticas não tornam o web scraping legal se este for contrário aos termos de serviço do site.
Quais são as melhores ferramentas para o web scraping?
Existem várias ferramentas que podem ajudar no web scraping, cada uma com o seu próprio conjunto de funcionalidades e capacidades.
No entanto, quando se trata de extrair dados de uma plataforma complexa como o DoubleClick.net, ferramentas especializadas como os proxies Geonode e scraper API são altamente recomendadas.
-
** Proxies doGeonode.** Estes proxies permitem-lhe encaminhar os seus pedidos através de vários endereços IP, reduzindo o risco de deteção.
Geonode oferece proxies residenciais, que são menos suscetíveis de serem sinalizados por medidas anti-scraping.
-
Scraper API da Geonode: Esta API foi concebida para lidar com muitos dos desafios associados ao web scraping, tais como CAPTCHAs e novas tentativas.
Respeita também o ficheiro robots.txt do site, tornando-a uma escolha mais ética para atividades de web scraping.
Ao utilizar estas ferramentas, poderá contornar muitos dos desafios técnicos associados ao web scraping, tornando os seus esforços de recolha de dados mais eficientes e seguros.
Em resumo, as questões apresentadas nesta secção refletem as preocupações comuns que as pessoas têm relativamente ao scraping do DoubleClick.net.
Embora existam ferramentas e métodos para mitigar riscos e desafios, é crucial abordar a tarefa com uma compreensão completa das implicações legais e éticas.
Conclusão
Neste artigo, explorámos as considerações multifacetadas envolvidas na extração de dados do DoubleClick.net.
Desde a compreensão do panorama jurídico até à superação de desafios técnicos e dilemas éticos, é evidente que o web scraping não é uma tarefa simples.
A principal lição a reter é a importância de fazer as perguntas certas antes de se lançar em qualquer projeto de scraping.
Conhecer o objetivo final, avaliar os recursos disponíveis e considerar alternativas são passos cruciais para tomar uma decisão informada.
Ferramentas especializadas, como os proxies do Geonode e o scraper API, podem ajudar significativamente a lidar com as complexidades técnicas e as considerações éticas da extração de dados da Web.
Apelo à ação
Antes de tentar extrair dados do DoubleClick.net ou de qualquer outra plataforma, recomendamos que reflita criticamente sobre as implicações.
Avalie os riscos em relação aos benefícios e consulte profissionais da área jurídica para garantir que está a agir em segurança.
Se decidir que o web scraping é a abordagem adequada às suas necessidades, considere subscrever os serviços dGeonode, para um processo de recolha de dados mais seguro e ético.
Ao seguir estas orientações, não só tomará decisões mais informadas, como também contribuirá para práticas de web scraping mais responsáveis e éticas.

