O LIHKG é um fórum de discussão online popular que tem vindo a ganhar bastante popularidade em Hong Kong e entre as comunidades de língua cantonesa em todo o mundo.
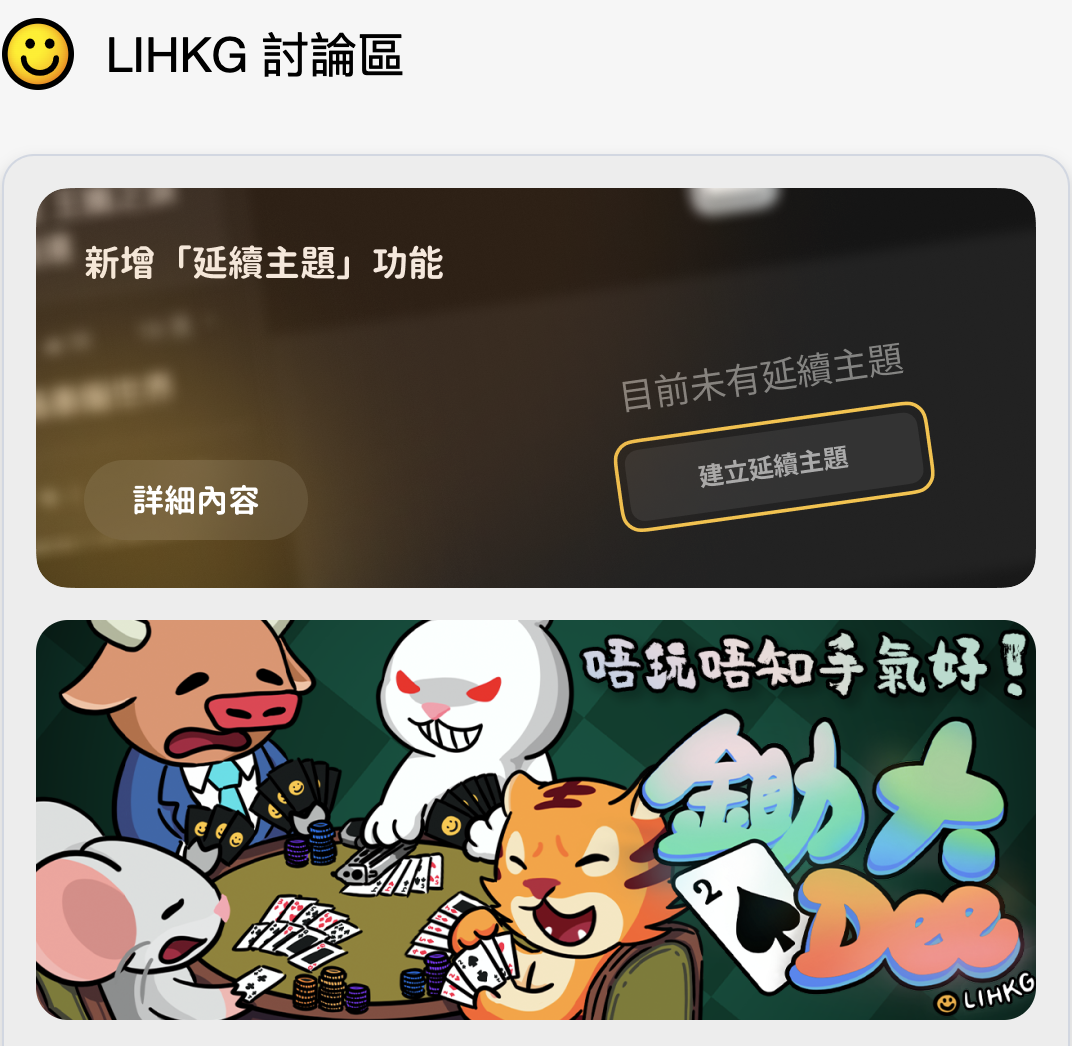
É um dos maiores fóruns para a discussão de protestos, eventos de agitação social e muito mais.
Frequentemente comparada ao Reddit em análises da concorrência, esta plataforma de redes sociais permite que os utilizadores do fórum discutam uma vasta gama de temas, desde política e atualidade até entretenimento e estilo de vida.
A história do fórum revela um forte enfoque na ação coletiva e em protestos em grande escala.
Com o seu conteúdo de redes sociais gerado pelos utilizadores e discussões online em tempo real, o lihkg.com constitui um recurso valioso para investigadores, profissionais de marketing e analistas de dados interessados em compreender a opinião pública, as redes sociais e as tendências sociais.
As complexidades da extração de dados do lihkg.com
Embora a ideia de extrair dados do lihkg.com possa parecer simples, a realidade está longe disso.
O site utiliza uma variedade de mecanismos para proteger o seu conjunto de dados bem estruturado, que vão desde CAPTCHAs a pedidos AJAX, tornando-o um alvo desafiante para o scraping na Web e para redes de deteção de eventos de agitação.
Além disso, considerações éticas e legais, incluindo a ética da solidariedade, acrescentam mais uma camada de complexidade ao processo.
Compreender estas complexidades é crucial para quem estiver a pensar em fazer scraping desta ou de plataformas online semelhantes.
Não se trata apenas de recolher dados das redes sociais; trata-se de o fazer de forma responsável e eficaz.
Ferramentas hipotéticas: proxies Geonode
e Scraper API
Num cenário hipotético em que se pretendesse fazer scraping do lihkg.com, certas ferramentas poderiam potencialmente tornar o processo mais fácil.
Os proxies [Geonode
](https://geonode.com) poderiam ser utilizados para contornar restrições baseadas no IP, permitindo uma recolha de dados mais abrangente sem ativar medidas anti-scraping. Isto é particularmente útil para lidar com cascatas de atividade.
Além disso, o [scraper API
](https://geonode.com/the-pay-as-you-go-scraper) de [Geonode
] poderia automatizar e simplificar o processo de scraping, lidando com desafios como CAPTCHAs e pedidos AJAX de forma mais eficiente.
Isto seria benéfico em tempo real, especialmente quando se lida com um elevado grau de solidariedade entre os utilizadores do fórum.
Quem deve ler este artigo?
Se alguma vez se questionou sobre como fazer scraping no lihkg.com, esta reflexão é para si.
Este artigo tem como objetivo esclarecer as complexidades e os desafios que enfrentaria ao extrair dados do lihkg.com — sem, no entanto, lhe ensinar concretamente como o fazer.
Vamos, então, aprofundar este tema fascinante e explorar o que o torna tão desafiante e, ao mesmo tempo, tão intrigante.
As complexidades do lihkg.com
A estrutura do lihkg.com
O lihkg.com foi desenvolvido principalmente através de uma combinação de HTML, CSS e JavaScript.
Enquanto o HTML e o CSS tratam do layout e do estilo, o JavaScript é responsável pelos aspetos dinâmicos do site, tais como atualizações em tempo real e pedidos AJAX.
Por que razão a estrutura é importante para a extração de dados
Compreender a estrutura é o primeiro passo para descobrir como extrair dados do lihkg.com.
Por exemplo, se o site depender fortemente do JavaScript para carregar conteúdo, os métodos tradicionais de scraping que apenas obtêm o HTML podem não funcionar.
Seria necessário utilizar técnicas mais avançadas, como navegadores headless, para executar o código JavaScript e recuperar os dados.
Desafios no scraping de conteúdo dinâmico
O lihkg.com utiliza AJAX (Asynchronous JavaScript and XML) para carregar novos dados sem atualizar a página na totalidade.
Isto torna difícil extrair dados do site utilizando pedidos HTTP básicos.
Num cenário hipotético, seria possível utilizar o scraper API do Geonode para lidar com esse conteúdo dinâmico de forma mais eficiente.
Tipos de dados no lihkg.com
O que pode encontrar?
O lihkg.com oferece uma variedade de tipos de conteúdo que podem ser do interesse de diferentes partes. Aqui estão alguns dos principais tipos de dados que poderá considerar extrair:
-
Publicações dos utilizadores. Publicações originais feitas pelos utilizadores sobre vários tópicos; servem como ponto de partida para discussões e podem conter texto, imagens e links.
-
Comentários: Os comentários são as respostas às publicações dos utilizadores e podem ter respostas aninhadas, formando uma estrutura semelhante a um fio de discussão.
-
Votos positivos e negativos. Cada publicação e comentário pode receber votos positivos ou negativos, o que dá uma indicação do sentimento da comunidade em relação ao conteúdo.
-
Perfis de utilizador. Estes podem conter informações como a data de registo do utilizador, o nível de atividade e outras estatísticas, embora grande parte destes dados seja frequentemente anonimizada ou pseudonimizada.
Por que razão estes dados são importantes
Estudos de mercado
Compreender o que os utilizadores estão a discutir pode fornecer informações valiosas sobre o comportamento e as tendências dos consumidores. Isto é particularmente útil para a análise da concorrência e a análise de visualização.
Análise de sentimento
Os votos positivos e negativos podem ser utilizados para avaliar a opinião pública sobre temas ou eventos específicos, incluindo campanhas de protesto e eventos de agitação social.
Investigação académica
Os académicos que estudam comunidades online podem considerar as interações e discussões dos utilizadores no lihkg.com uma fonte rica de dados para os seus conjuntos de dados bem estruturados.
Desafios na extração de dados
A extração de dados de um site como o lihkg.com não é apenas um desafio técnico; é também um labirinto jurídico e ético.
O panorama jurídico
A extração de dados da Web opera numa zona um tanto ou quanto cinzenta da lei.
Embora a extração de publicações acessíveis ao público seja geralmente considerada legal, muitos sites têm termos de serviço que proíbem essa prática.
A violação destes termos pode acarretar consequências legais, incluindo processos judiciais e multas.
Como isto se aplica ao lihkg.com
O lihkg.com tem o seu próprio conjunto de termos e condições que os utilizadores têm de aceitar ao utilizar o site.
Estes termos incluem frequentemente cláusulas que proíbem a extração não autorizada do conteúdo do site.
Por conseguinte, a extração de dados do lihkg.com sem autorização explícita pode potencialmente levar a repercussões legais.
Implicações éticas
Para além dos aspetos legais, a extração de dados do lihkg.com também levanta questões éticas.
A plataforma é uma comunidade onde as pessoas partilham os seus pensamentos e opiniões, muitas vezes esperando um certo nível de privacidade.
A extração destes dados sem consentimento pode ser considerada uma invasão de privacidade, mesmo que os dados sejam de acesso público.
Barreiras técnicas
CAPTCHAs
Uma das medidas anti-scraping mais comuns utilizadas pelos sites é o CAPTCHA (Teste de Turing Público Completamente Automatizado para Distinguir Computadores de Humanos).
O lihkg.com utiliza CAPTCHAs para garantir que o utilizador que interage com o site é humano e não um bot. Isto representa um obstáculo significativo para qualquer tentativa de scraping.
Pedidos AJAX
Conforme mencionado anteriormente, o lihkg.com utiliza AJAX (JavaScript Assíncrono e XML) para carregar conteúdo dinamicamente.
Isto significa que os dados que vê no site não estão presentes no HTML inicial, mas são carregados de forma assíncrona através de JavaScript.
Os métodos tradicionais de scraping que apenas recuperam o HTML não serão capazes de capturar estes dados carregados dinamicamente.
Restrições baseadas no IP
Os sites recorrem frequentemente a restrições baseadas no IP para bloquear ou limitar o acesso a partir de localizações geográficas específicas ou para impedir atividades de scraping.
Várias solicitações a partir do mesmo endereço IP num curto período de tempo podem ativar estas restrições.
Ferramentas hipotéticas para o trabalho
Proxies do Geonode como solução hipotética
Num cenário hipotético em que se tentasse fazer scraping do site lihkg.com, os proxies Geonode poderiam servir como solução para contornar restrições baseadas em IP.
Ao encaminhar os seus pedidos através de vários endereços IP, poderia evitar ativar medidas anti-scraping, permitindo assim uma recolha de dados mais abrangente.
O papel dos proxies
No web scraping, um proxy atua como intermediário entre o seu computador e o site que está a tentar extrair.
Ele reencaminha as suas solicitações para o site e devolve-lhe as respostas do site, mascarando eficazmente o seu endereço IP nesse processo.
Proxies Geonode para restrições geográficas
O Geonode oferece uma variedade de proxies residenciais que podem ser utilizados para contornar restrições geográficas.
Por exemplo, se o site lihkg.com restringisse o acesso a utilizadores de determinados países, os proxies Geonode poderiam encaminhar os seus pedidos através de endereços IP localizados em regiões que não estão sujeitas a restrições, permitindo-lhe assim aceder ao site.
Contornar limites de taxa com os proxies Geonode
A limitação de taxa é outra medida comum contra o scraping que restringe o número de pedidos que um único endereço IP pode efetuar num determinado período de tempo.
Os proxies Geonode podem ajudá-lo a ultrapassar esta limitação, distribuindo os seus pedidos por vários endereços IP, tornando menos provável que atinja os limites de taxa.
O Scraper API
Um scraper API é uma ferramenta que simplifica o processo de web scraping, lidando com muitos dos desafios a ele associados, tais como CAPTCHAs, pedidos AJAX e limites de taxa.
Essencialmente, funciona como um intermediário que trata dos pormenores mais complexos, permitindo-lhe concentrar-se no que fazer com os dados depois de estes terem sido extraídos.
Como o Scraper API de Geonode pode simplificar o processo
O scraper API de Geonode foi concebido para lidar com muitos dos desafios que enfrentaria ao extrair dados de um site complexo como o lihkg.com. É capaz de gerir novas tentativas em caso de falhas, tornando todo o processo mais eficiente e menos propenso a erros.
Repensar a abordagem
O scraper API, da Geonode, leva-o a repensar a forma de extrair dados do lihkg.com.
Em vez de passar horas incontáveis a tentar descobrir como contornar os CAPTCHAs ou lidar com pedidos AJAX, pode aproveitar a API para lidar com estes desafios, permitindo-lhe concentrar-se na análise dos dados e na obtenção de insights a partir deles.
As pessoas também perguntam
O que é o lihkg.com?
O lihkg.com é um fórum popular em Hong Kong e entre os falantes de cantonês de todo o mundo, que aborda temas que vão desde a política até à cultura pop.
Frequentemente comparado ao Reddit, é uma fonte fundamental para acompanhar a opinião pública e as tendências, incluindo notícias de interesse e notícias alternativas.
É legal fazer scraping de sites?
A legalidade do scraping varia consoante a jurisdição e as circunstâncias específicas.
Geralmente, a extração de informação acessível ao público é considerada legal. No entanto, muitos sites, incluindo o lihkg.com, têm termos de serviço que proíbem a extração não autorizada.
A violação destes termos pode acarretar consequências legais.
Como funcionam os proxies na extração de dados da Web?
No web scraping, um proxy funciona como um intermediário entre o seu computador e o site de destino. Ele encaminha os seus pedidos para o site e devolve-lhe as respostas do site.
Este processo oculta eficazmente o seu endereço IP, tornando mais difícil para os sites o identificarem e bloquearem.
O que é um «Scraper API»?
Um «scraper API» é um serviço que simplifica o processo de web scraping, ao lidar com muitos dos desafios que lhe estão associados.
O scraper API da Geonode poderia, hipoteticamente, gerir estes aspetos por si, permitindo-lhe concentrar-se nos dados e na forma como pretende utilizá-los.
Conclusão
À medida que chegamos ao fim deste exercício de reflexão, fica claro que extrair dados do lihkg.com — ou de qualquer outro site, aliás — não é uma tarefa simples.
O processo está repleto de complexidades que vão desde a compreensão da estrutura do site até à navegação por labirintos legais e éticos.
A extração de dados do lihkg.com apresenta um conjunto único de desafios:
-
Barreiras técnicas. A utilização de AJAX pelo site para o carregamento dinâmico de conteúdos e de CAPTCHAs para dissuadir os bots torna a extração de dados mais complicada do que a simples recuperação de conteúdo HTML.
-
Questões legais e éticas. Os termos de serviço do lihkg.com proíbem explicitamente a extração não autorizada, e há considerações éticas relacionadas com a privacidade dos utilizadores e a utilização dos dados.
-
Tipos de dados. Compreender os tipos de dados disponíveis no lihkg.com, tais como publicações dos utilizadores, comentários e votos positivos, acrescenta mais uma camada de complexidade ao processo de extração.
Considerações finais
Compreender as complexidades envolvidas na extração de dados de um site como o lihkg.com é crucial para quem estiver a considerar tal empreendimento.
Embora existam ferramentas que, hipoteticamente, poderiam facilitar a tarefa, estas não podem eliminar as responsabilidades legais e éticas associadas à extração de dados da Web.
Por isso, é essencial abordar a tarefa com uma compreensão abrangente destas complexidades e desafios.
Ao explorar estes aspetos em pormenor, esperamos que esta experiência mental tenha proporcionado perspetivas valiosas sobre o mundo do web scraping.
Estar ciente destes desafios irá prepará-lo melhor para navegar pelo panorama complexo do web scraping de forma responsável e eficaz.

