Frequentemente designado como a «primeira página da Internet», o Reddit é um enorme centro de conteúdos gerados pelos utilizadores.
Com 430 milhões de utilizadores ativos mensais a participar em milhares de discussões sobre temas específicos — desde as últimas tendências tecnológicas até passatempos de nicho —, o Reddit é uma ferramenta valiosa e uma mina de ouro de dados pronta a ser explorada.
Mas como é que se extrai esses dados de forma eficiente e ética?
Neste guia, aprofundamos a compreensão dos scrapers do Reddit, da API oficial, das ferramentas, das técnicas e das melhores práticas para recolher dados do Reddit de forma eficaz.
A Importância da Extração de Dados do Reddit
As perceções baseadas em dados são fundamentais para o sucesso.
A extração de dados do Reddit permite que empresas, investigadores e entusiastas de dados compreendam a opinião pública, acompanhem as tendências do mercado e recolham conteúdos gerados pelos utilizadores.
Estes dados ricos e não estruturados têm inúmeras aplicações, tais como:
-
Estudos de mercado. As diversas comunidades do Reddit, conhecidas como «subreddits», abrangem praticamente todos os interesses imagináveis. As empresas extraem publicações do Reddit para avaliar a opinião dos consumidores, as suas preferências e as tendências emergentes em tempo real.
-
Feedback sobre produtos. Os utilizadores discutem frequentemente produtos e serviços, oferecendo feedback sincero. Estes dados inestimáveis ajudam as empresas a aperfeiçoar as suas ofertas e a dar resposta às preocupações.
-
Análise da concorrência. Ao monitorizar discussões sobre concorrentes, as empresas podem identificar pontos fortes, pontos fracos e oportunidades no mercado.
-
Ideias de conteúdo. Criadores de conteúdo e profissionais de marketing utilizam o Reddit para descobrir publicações populares e temas em voga, garantindo que o seu conteúdo se mantenha relevante e envolvente.
-
Investigação académica. Os investigadores recorrem ao vasto conjunto de dados do Reddit para estudar comportamentos online, tendências culturais e dinâmicas sociais.
-
Gestão de crises. As marcas podem detetar precocemente potenciais crises de relações públicas, monitorizando sentimentos negativos ou controvérsias no Reddit.
-
Conjuntos de dados para treino. Para quem trabalha com IA e aprendizagem automática, o Reddit fornece vastos conjuntos de dados para treinar modelos, especialmente no processamento de linguagem natural.
Compreender a estrutura do Reddit para uma extração de dados eficaz
O Reddit é uma plataforma complexa com uma estrutura única que o distingue de outras plataformas de redes sociais.
Compreender esta estrutura é fundamental para quem pretende extrair dados do Reddit, uma vez que garante a obtenção de informação relevante e abrangente.
Eis uma análise aprofundada:
-
Subreddits. Trata-se de secções centradas na comunidade, dedicadas a tópicos ou interesses específicos.
Cada subreddit tem o seu URL único, frequentemente indicado como «r/[nome_do_subreddit]».
Por exemplo, existem «subreddits de promoções» que se centram em promoções e descontos.
Conhecer a estrutura dos URLs dos subreddits é essencial para atingir comunidades específicas.
-
Publicações. Os utilizadores podem publicar publicações nos subreddits. As publicações podem variar desde artigos de blogue aprofundados até imagens, vídeos ou links para sites externos.
Cada publicação tem a sua estrutura única, frequentemente designada por «dicionário da publicação», que inclui detalhes como o autor da publicação, os títulos das publicações e o conteúdo atual da publicação.
-
Comentários. Cada publicação individual pode ter comentários, o que dá origem a discussões aninhadas.
Compreender a média de comentários por publicação ou direcionar a análise para publicações com muitos comentários pode fornecer dados mais ricos para análise.
-
Perfis de utilizador e utilizadores da aplicação. Todos os utilizadores do Reddit, quer utilizem a aplicação do Reddit ou o navegador, têm um perfil que apresenta a sua atividade, incluindo publicações e comentários.
Esta é uma mina de ouro de dados, especialmente para analisar o comportamento dos utilizadores.
-
Produtos digitais e compras na aplicação. O Reddit oferece várias opções de distribuição de produtos digitais, incluindo prémios e o Reddit Premium.
Compreender como os utilizadores interagem com estes, especialmente através de compras na aplicação, pode oferecer informações sobre o comportamento de consumo dos utilizadores.
-
Publicidade na aplicação. O Reddit oferece oportunidades de publicidade que permitem às marcas alcançar grupos demográficos específicos ou comunidades de subreddits.
Esta é uma ferramenta essencial para as empresas que pretendem anunciar na plataforma.
-
Interações no navegador. Quer os utilizadores acedam ao Reddit através de uma sessão no navegador ou utilizem extensões do navegador, cada interação deixa dados para trás.
Saber como extrair dados das interações e dos perfis do navegador pode proporcionar uma compreensão mais profunda do comportamento dos utilizadores.
-
Nuvem e implementação. O Reddit utiliza soluções de serviços na nuvem, e compreender isto pode ser crucial, especialmente quando se considera a nuvem durante a implementação.
-
Análise e ferramentas. Com as ferramentas de análise adequadas, as empresas podem decifrar como um tópico é abordado em dezenas de comunidades ou como os utilizadores interagem com o botão «upvote» ou com o elemento «upvote».
-
Automatização e IA. Os modernos scrapers de redes sociais vêm equipados com funcionalidades de automatização. Alguns chegam mesmo a utilizar ferramentas de IA generativa para prever o comportamento dos utilizadores ou para gerar conteúdo.
-
Considerações éticas. Ao realizar o scraping, é essencial respeitar os respetivos proprietários do conteúdo e garantir que são utilizados agentes de utilizador descritivos para evitar deturpações.
Procure sempre a URL de destino correta para extrair as informações de que necessita sem infringir os direitos dos utilizadores.
- Elementos adicionais. O Reddit é vasto e existem outros elementos, como o dicionário de subreddits, campos de descrição e muito mais, que podem ser alvo de análise para obter dados mais detalhados.
A estrutura multifacetada do Reddit é um verdadeiro paraíso para os scrapers da Web. Para extrair dados significativos, é necessário compreender as suas complexidades.
Quer esteja a analisar comentários de subreddits, a estudar linhas de código em busca de padrões ou a explorar a forma como os produtos são comercializados, conhecer a estrutura do Reddit garante que os seus esforços de scraping sejam eficientes e éticos.
Ferramenta de extração 1: A API oficial do Reddit
Algumas pessoas encaram o Reddit como apenas mais uma plataforma de redes sociais. No entanto, a sua estrutura única e o seu sistema de votação democrático tornam-no muito mais do que isso.
O Reddit prospera graças ao conteúdo gerado pelos utilizadores, organizado em comunidades de nicho conhecidas como «subreddits».
Cada subreddit aborda um tema específico, permitindo que os utilizadores participem em discussões, partilhem recursos e procurem conselhos.
O conteúdo com mais votos positivos — as publicações mais populares — sobe ao topo, transformando o Reddit num reflexo em tempo real do interesse e da opinião pública.
Visão geral e termos da API do Reddit
A API DATA oficial do Reddit é uma ferramenta poderosa que proporciona acesso estruturado ao vasto conteúdo da plataforma.
É uma ferramenta essencial para programadores, investigadores e empresas que pretendem explorar as valiosas informações disponíveis na plataforma.
A API permite que programadores de terceiros leiam comentários, obtenham informações sobre os utilizadores, acedam a detalhes dos subreddits e muito mais, de uma forma que é simultaneamente eficiente e em conformidade com as diretrizes do Reddit.
Diretrizes de utilização, limitações e restrições
- Registo e elegibilidade. Antes de aceder à API de Dados, os utilizadores devem registar-se e garantir que cumprem os critérios de elegibilidade. Isto inclui ter idade legal e não estar impedido de utilizar a API ao abrigo de quaisquer leis aplicáveis.
- Licença. O Reddit concede uma licença não exclusiva, intransferível e revogável para aceder e utilizar a API de Dados. Isto significa que os utilizadores não podem sublicenciar ou transferir os seus direitos de acesso à API para terceiros.
- Conteúdo do utilizador. Embora o conteúdo no Reddit seja gerado pelos utilizadores, a API proporciona uma forma de aceder a esse conteúdo sem o modificar. Qualquer utilização do conteúdo do utilizador deve respeitar os direitos dos criadores do conteúdo original.
- Privacidade e tratamento de dados. Os programadores devem divulgar a forma como tratam os dados recolhidos através da API, garantindo transparência e conformidade com as leis de privacidade.
- Limitações da API. O Reddit pode impor limites à utilização da API, tais como o número de pedidos por hora. É fundamental estar ciente destes limites e respeitá-los para evitar interrupções.
- Taxas e utilização comercial. Embora a API seja geralmente gratuita para utilização básica, o Reddit reserva-se o direito de cobrar por níveis de utilização mais elevados ou para fins comerciais.
- Conformidade. Os utilizadores da API devem cumprir o Acordo de Utilizador do Reddit, a Política de Privacidade e quaisquer outros termos relevantes. Isto garante que o acesso aos dados se mantenha ético e em conformidade com os padrões da comunidade do Reddit.
Compreender e cumprir estes termos é fundamental para quem pretenda utilizar os dados do Reddit nas suas aplicações ou investigação. Garante uma experiência de acesso aos dados fluida e ininterrupta, mantendo simultaneamente a integridade e os valores da comunidade do Reddit.
Ferramenta de scraping 2: Python e Selenium
O Python é uma linguagem de programação amplamente utilizada, conhecida pela sua simplicidade e versatilidade.
O Python oferece uma grande variedade de bibliotecas e frameworks que tornam o scraping mais fácil de gerir. Uma dessas ferramentas é o Selenium, originalmente concebido para testes na Web, mas que se tornou, desde então, uma escolha obrigatória para tarefas de scraping na Web.
O Selenium funciona através da automatização de navegadores da Web. Consegue simular um comportamento de navegação semelhante ao de um utilizador humano, tornando possível extrair dados de páginas web como se um utilizador real estivesse a navegar nelas.
Quando combinado com o Python, o Selenium permite aos programadores escrever scripts capazes de realizar tarefas como iniciar sessão em contas, navegar para páginas específicas, clicar em botões e, mais importante ainda, extrair dados.
Para plataformas como o Reddit, que são ricas em conteúdo dinâmico (conteúdo que é carregado ou alterado sem que a página seja atualizada), o Selenium revela-se inestimável.
As ferramentas tradicionais de scraping podem ter dificuldades com esse tipo de conteúdo, mas o Selenium, sendo uma ferramenta de automatização de navegadores, consegue aceder-lhe facilmente.
Vantagens de utilizar Python e Selenium para a extração de dados do Reddit
- Acesso a conteúdo dinâmico. Conforme mencionado, o Selenium consegue interagir com conteúdo dinâmico, garantindo que nenhum dado seja perdido durante o processo de extração.
- Interações semelhantes às humanas. A capacidade do Selenium de imitar interações humanas, como percorrer a página ou clicar, pode ajudar a contornar algumas medidas anti-scraping.
- Flexibilidade. As extensas bibliotecas do Python e as capacidades de automatização do navegador do Selenium constituem uma combinação flexível. Quer se trate de lidar com cookies, gerir sessões ou lidar com pop-ups, o Python e o Selenium conseguem dar conta de tudo.
- Amplo suporte a navegadores. O Selenium suporta vários navegadores, incluindo o Chrome, o Firefox e o Safari, permitindo a extração de dados em vários navegadores, se necessário.
Potenciais desafios
- Desempenho. Uma vez que o Selenium automatiza um navegador real, pode ser mais lento do que outras ferramentas de scraping leves que obtêm diretamente o código-fonte da página.
- Complexidade. Configurar um scraper baseado no Selenium pode ser mais complexo do que utilizar ferramentas simples baseadas em pedidos HTTP, especialmente para principiantes.
- Medidas anti-scraping. Embora o Selenium consiga contornar algumas técnicas anti-scraping, plataformas como o Reddit estão continuamente a aperfeiçoar as suas defesas. Isto significa que os scrapers podem enfrentar desafios como CAPTCHAs, limites de taxa ou bloqueios temporários de IP.
- Manutenção. As páginas web mudam com o tempo. Se o Reddit sofrer uma reformulação do design ou alterar a sua estrutura, o scraper poderá deixar de funcionar e necessitar de atualizações.
Ferramenta de extração 3: PRAW (Python Reddit API Wrapper)
O PRAW, sigla para Python Reddit API Wrapper, é essencialmente uma ponte entre as aplicações Python e a API do Reddit.
Em vez de lidarem com pedidos HTTP em bruto e analisarem respostas JSON complexas, os programadores podem utilizar os métodos intuitivos do PRAW para obter e interagir com os dados do Reddit.
Vantagens de utilizar o PRAW
-
Simplicidade. O PRAW abstraí as complexidades da API do Reddit, oferecendo aos programadores métodos simples para aceder aos dados.
Por exemplo, obter as publicações mais populares de um subreddit ou recuperar comentários de um tópico específico torna-se uma tarefa que requer apenas algumas linhas de código.
-
Gestão de limites de taxa. O Reddit impõe restrições à frequência com que a sua API pode ser acedida.
O PRAW gere automaticamente estes limites de taxa, garantindo que a sua aplicação não os exceda e não corra o risco de bloqueios temporários.
-
Conformidade. Ao utilizar o PRAW, os programadores cumprem, por natureza, os termos de serviço da API do Reddit, minimizando o risco de problemas de acesso aos dados.
-
Documentação abrangente. O PRAW inclui documentação abrangente, facilitando tanto aos principiantes como aos programadores experientes dar os primeiros passos e resolver problemas.
-
Comunidade ativa. O PRAW conta com uma comunidade ativa. Isto significa atualizações regulares, uma grande variedade de recursos online e apoio da comunidade para quaisquer desafios enfrentados.
Configuração básica e exemplos de utilização
Configuração
-
Antes de utilizar o PRAW, registe uma aplicação de script no portal de programadores do Reddit para obter as credenciais de API necessárias.
-
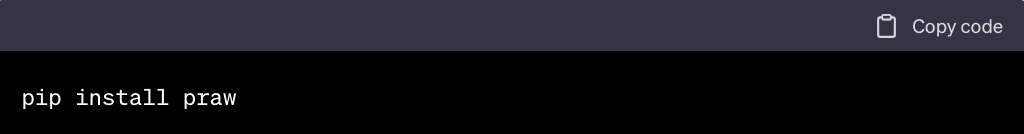
Instale o PRAW através do pip.
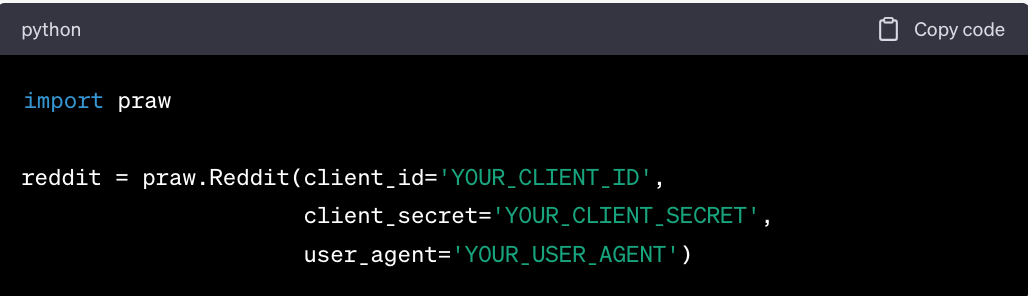
- Inicialize a instância do Reddit com as suas credenciais de API.
Exemplos de utilização
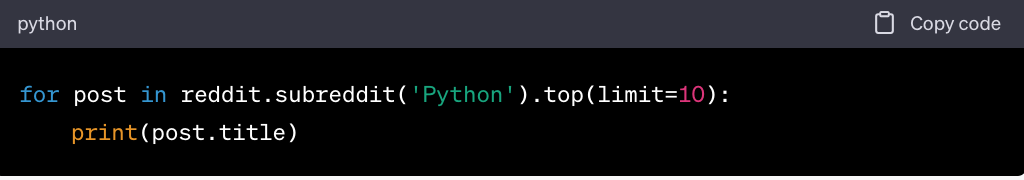
- Extrair as 10 publicações mais populares de um subreddit
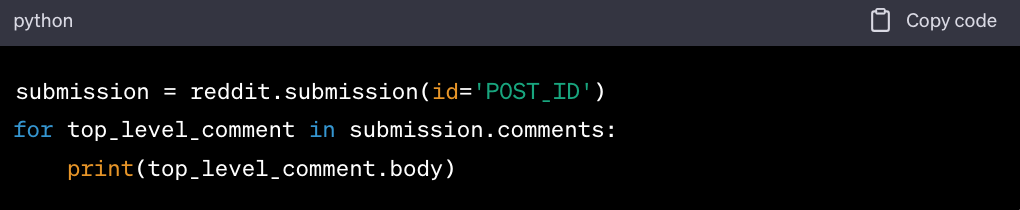
- Recuperar comentários de um tópico específico
- Pesquisar publicações que contenham uma palavra-chave
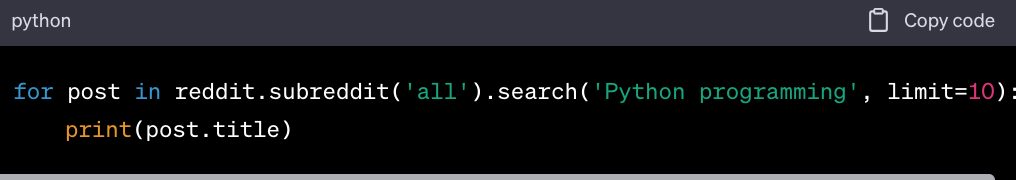
O PRAW é uma ferramenta indispensável para quem pretende explorar os dados do Reddit utilizando Python. A sua simplicidade, combinada com o seu poder, torna-o a escolha ideal para projetos que vão desde tarefas simples de extração de dados até esforços complexos de análise de dados.
Ferramenta de scraping 4: O framework Scrapy
O Scrapy é um framework de código aberto de alto nível para rastreamento e extração de dados da Web, escrito em Python. Foi concebido para lidar com uma vasta gama de tarefas de extração de dados, desde simples extrações pontuais até projetos complexos de rastreamento da Web em grande escala. O Scrapy não se limita apenas ao Reddit, podendo ser utilizado para extrair dados de qualquer site.
Principais Características
-
Versatilidade. O Scrapy consegue extrair dados de sites utilizando seletores CSS, XPath ou até expressões regulares, adaptando-se a várias estruturas de sites.
-
Middleware e extensões. O Scrapy suporta middleware e extensões, permitindo aos programadores personalizar o processo de extração, gerir novas tentativas, agentes de utilizador e até integrar conjuntos de proxies.
-
Pipeline. Depois de os dados serem extraídos, o Scrapy oferece pipelines de itens para processar, validar e armazenar os dados. Isto pode ser feito em bases de dados, ficheiros ou até mesmo em armazenamento na nuvem.
-
Rastreamento simultâneo. O Scrapy assenta na biblioteca de rede assíncrona Twisted, o que lhe permite lidar com múltiplas solicitações em simultâneo, acelerando o processo de extração de dados.
-
Gestão robusta de erros. O Scrapy consegue lidar com erros de forma elegante, garantindo que um pequeno contratempo não interrompa todo o processo de extração.
-
Exportadores integrados. O Scrapy pode exportar resultados em vários formatos, como JSON, CSV e XML, sem necessidade de plugins ou ferramentas adicionais.
Como configurar e utilizar o Scrapy para a extração de dados do Reddit
Configurar o Scrapy: Tutorial passo a passo
-
Instale o Scrapy utilizando o pip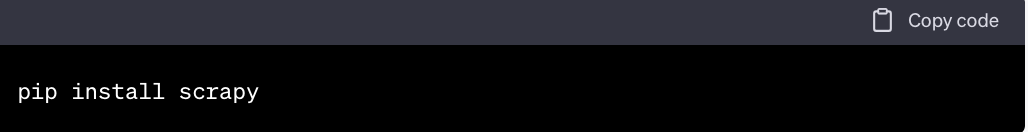
-
Inicie um novo projeto Scrapy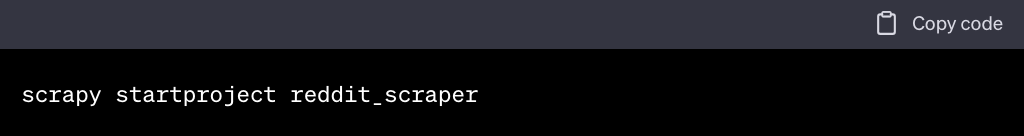
Utilizar o Scrapy para a extração de dados do Reddit
-
Crie um «spider». No seu projeto do Scrapy, irá criar «spiders», que são classes que definem como seguir links e extrair dados. Para o Reddit, pode criar um «spider» como este: 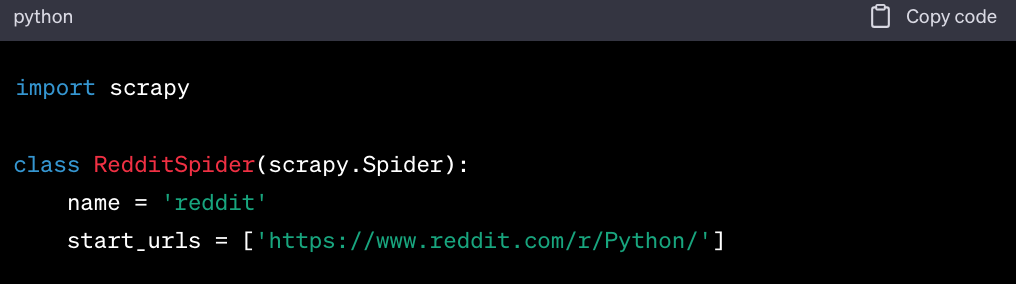
-
Defina a lógica de extração. Utilize seletores CSS ou XPath para extrair dados da página do Reddit. 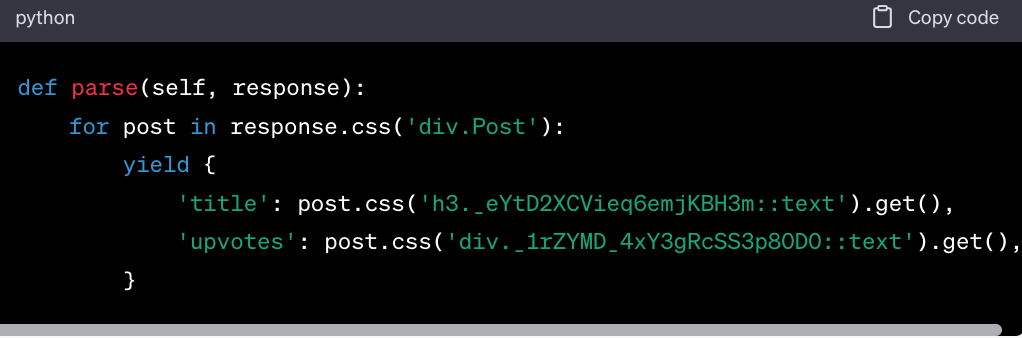
-
Siga a paginação. O Reddit tem várias páginas de conteúdo. O Scrapy pode ser configurado para seguir links e extrair dados em diferentes páginas.
-
Executar o spider: Assim que o spider estiver configurado, aceda ao diretório do projeto e execute: 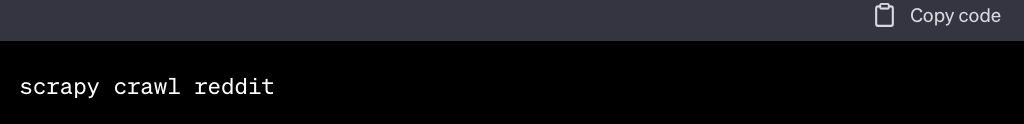
-
Armazenar dados: O Scrapy pode armazenar os dados extraídos em vários formatos. Por exemplo, para armazenar os dados num ficheiro JSON: 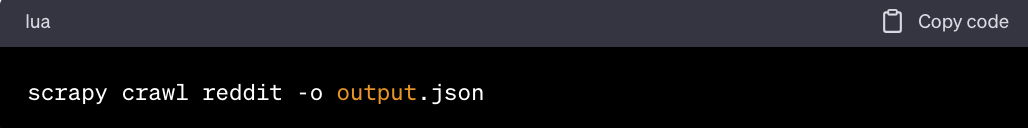
Ferramenta de extração 5: Repositórios do GitHub
O GitHub, a plataforma líder mundial em desenvolvimento de software, hospeda uma infinidade de repositórios dedicados a várias tarefas, incluindo a extração de dados da Web.
Entre estes, vários repositórios centram-se especificamente na extração de dados do Reddit.
Estes repositórios disponibilizam frequentemente ferramentas, scripts ou bibliotecas pré-construídas que podem simplificar o processo de extração de dados do Reddit e torná-lo acessível mesmo para quem tem pouca experiência em programação.
Vantagens de utilizar repositórios do GitHub para a extração de dados do Reddit
-
Soluções prontas a utilizar. Muitos repositórios do GitHub oferecem soluções completas que requerem uma configuração mínima. Os utilizadores podem clonar o repositório, seguir as instruções fornecidas e começar a extrair dados sem terem de criar uma ferramenta do zero.
-
Apoio da comunidade. Os repositórios populares têm frequentemente comunidades ativas. Os utilizadores podem levantar questões, procurar ajuda ou até contribuir para o projeto, melhorando as capacidades da ferramenta.
-
Atualizações contínuas. Dada a natureza dinâmica dos sites, as ferramentas de scraping necessitam de atualizações regulares. Os repositórios ativos do GitHub são frequentemente atualizados para dar resposta a alterações na estrutura do site de destino ou para melhorar a funcionalidade.
-
Abordagens Diversificadas. Diferentes repositórios podem empregar várias técnicas ou ferramentas para a extração de dados, desde soluções baseadas em Python, como o PRAW ou o Scrapy, até ao Node.js ou mesmo aplicações em Docker. Esta diversidade permite aos utilizadores escolher uma ferramenta que se adapte aos seus conhecimentos técnicos e aos requisitos do projeto.
-
Documentação e exemplos. A maioria dos repositórios de renome fornece documentação abrangente, guias de configuração e exemplos de utilização, garantindo que os utilizadores possam começar a trabalhar sem dificuldades.
Explorar o GitHub à procura de scrapers para o Reddit
Uma simples pesquisa no GitHub com o termo «reddit-scraper» revela uma variedade de repositórios concebidos especificamente para a extração de dados do Reddit.
Alguns repositórios potenciais que poderá encontrar incluem:
-
Bots de extração do Reddit. Trata-se de scripts automatizados que podem recolher publicações, comentários e muito mais a partir de subreddits ou tópicos específicos.
-
Wrappers da API do Reddit. Embora o PRAW seja o mais popular, outros wrappers podem oferecer funcionalidades únicas ou ser compatíveis com diferentes linguagens de programação.
-
Scrapers do Reddit em Docker. Para quem procura soluções em contentores, alguns repositórios fornecem configurações Docker para garantir operações de scraping consistentes e escaláveis.
-
Ferramentas especializadas. Algumas ferramentas de rastreamento do Reddit podem concentrar-se em tarefas específicas, como descarregar todas as imagens de um subreddit, extrair tópicos em destaque ou monitorizar palavras-chave específicas.
Passos para utilizar um repositório do GitHub para a extração de dados do Reddit
-
Escolher um repositório. Aceda ao tópico reddit-scraper no GitHub e selecione um repositório que se adapte às suas necessidades.
-
Clone e configure. Siga as instruções do repositório, que normalmente envolvem clonar o repositório e configurar quaisquer dependências necessárias.
-
Configure. Muitas ferramentas requerem alguma configuração, como especificar o subreddit de destino, configurar chaves de API ou definir formatos de saída.
-
Executar e extrair dados. Execute os scripts ou comandos fornecidos para iniciar o processo de extração.
-
Pós-processamento. Dependendo da ferramenta, poderá ser necessário processar os dados extraídos posteriormente, por exemplo, filtrando-os, limpando-os ou convertendo-os para o formato pretendido.
Ferramenta de extração n.º 6: Ferramentas de extração de dados do Reddit de terceiros
A vastidão e a riqueza dos dados no Reddit levaram ao surgimento de várias ferramentas de extração de terceiros. Estas ferramentas têm como objetivo simplificar o processo de extração, tornando-o acessível a um público mais vasto, desde empresas a investigadores. Vamos explorar algumas das ferramentas de extração do Reddit de terceiros mais populares:
- Modelo de preços: Oferece um modelo flexível de «pay-as-you-go».
- Experiência do utilizador: Interface intuitiva, adequada tanto para principiantes como para especialistas.
- Desempenho: Extração de dados rápida e fiável.
- Privacidade: Dá ênfase à privacidade do utilizador, garantindo a integridade e a segurança dos dados.
- Automação: Inclui automação baseada em IA para a extração adaptativa de dados.
- Transformação de dados: Ferramentas integradas para refinar e analisar os dados extraídos.
- Versatilidade: Solução abrangente de scraping direcionada a vários sites.
- Interface: Interface visual para facilitar a conceção de projetos.
- Funcionalidades avançadas: Suporta AJAX e JavaScript para uma extração de dados completa.
- Agendamento: Oferece funcionalidades para configurar tarefas de scraping recorrentes.
- Implementação: Oferece opções de extração tanto na nuvem como localmente.
- Fácil de utilizar: Configuração simples com funcionalidades para lidar com CAPTCHAs e bloqueios de IP.
- Integração: Inclui integração via API para uma transferência de dados sem interrupções.
- Simplicidade: Concentra-se no fornecimento de módulos pré-construídos para facilitar o scraping.
- Acessibilidade: Enfatiza soluções económicas adequadas a vários orçamentos.
- Serviço principal: Conhecido como um fornecedor de proxies com conhecimentos especializados em scraping.
- Anonimato: Oferece IPs rotativos e um vasto conjunto de proxies residenciais para a extração anónima de dados.
- Orientação: Fornece guias detalhados sobre a extração de dados da Web, incluindo o Reddit.
- Abordagem baseada em API: Oferece uma API simples para fácil integração em sistemas existentes.
- Escalabilidade: Concebido para lidar com tarefas de scraping em grande escala sem comprometer a velocidade.
- Anonimato: Utiliza um sistema de proxies rotativos para garantir um scraping anónimo e ininterrupto.
- Versatilidade: Suporta várias plataformas, sendo o Reddit uma das suas especialidades.
Embora cada ferramenta de scraping de terceiros apresente os seus pontos fortes únicos, a abordagem centrada no utilizador e a estrutura de preços flexível do Geonode tornam-no uma opção de destaque.
No entanto, a melhor ferramenta depende frequentemente dos requisitos individuais, dos conhecimentos técnicos e do orçamento.
Melhores práticas e considerações éticas
A recolha de dados do Reddit, embora seja uma ferramenta poderosa para a extração de dados, acarreta um conjunto específico de responsabilidades.
Garantir práticas éticas não só protege os direitos dos utilizadores, como também assegura a longevidade e a reputação dos seus esforços de scraping.
Aqui fica uma análise aprofundada das melhores práticas e considerações éticas ao fazer scraping no Reddit:
Respeitar a privacidade dos utilizadores
A era digital trouxe consigo preocupações crescentes relativamente à privacidade dos utilizadores. Ao fazer scraping no Reddit, é crucial dar prioridade à privacidade dos utilizadores da plataforma.
-
Scraping ético. Certifique-se sempre de que os dados que está a extrair estão disponíveis publicamente. Evite extrair informações pessoais ou conteúdos de subreddits privados. Lembre-se: só porque os dados estão acessíveis, não significa que seja ético extraí-los.
-
Anonimato. Embora os utilizadores do Reddit utilizem pseudónimos, é essencial tratar estes dados com cuidado. Evite ações que possam desanonimizar os utilizadores ou revelar as suas identidades no mundo real.
-
Proteção de dados. Se armazenar dados extraídos, certifique-se de que estão encriptados e armazenados de forma segura. Implemente medidas robustas de cibersegurança para impedir o acesso não autorizado.
-
Transparência. Se estiver a utilizar dados extraídos para fins de investigação ou comerciais, seja transparente quanto às suas fontes de dados e à forma como os dados serão utilizados.
Lidar com limites de taxa e restrições
O Reddit, tal como muitas plataformas, implementa limites de taxa para garantir a estabilidade do servidor e evitar utilizações indevidas.
-
Compreenda os limites da API. Se estiver a utilizar a API do Reddit, familiarize-se com os seus limites de taxa. Normalmente, estes são definidos para um determinado número de pedidos por minuto. Exceder estes limites pode resultar em bloqueios temporários ou permanentes.
-
Utilize intervalos. Introduza intervalos entre as solicitações de scraping. Isto não só respeita os servidores da plataforma, como também reduz as hipóteses de o seu scraper ser identificado e bloqueado.
-
Alterne IPs e user-agents com um fornecedor de serviços de proxy fiável. A utilização dos proxies residenciais dGeonode pode ajudar a contornar restrições, fornecendo um conjunto rotativo de endereços IP, o que faz com que as suas atividades de scraping pareçam mais orgânicas. Aliada à rotação de user-agents, esta estratégia pode reduzir significativamente as hipóteses de ser bloqueado. No entanto, utilize sempre esta estratégia de forma ética e evite um scraping agressivo que perturbe a plataforma.
-
Respeite o ficheiro robots.txt do Reddit. O ficheiro robots.txt fornece orientações sobre o que pode e o que não pode ser extraído. Verifique sempre e cumpra as regras do Reddit.
Armazenamento e utilização de dados
A responsabilidade não termina após a recolha dos dados. A forma como armazena e utiliza esses dados também é crucial.
-
Armazenamento seguro. Certifique-se de que todos os dados armazenados são mantidos em bases de dados encriptadas. Faça cópias de segurança regulares desses dados e implemente medidas de segurança para prevenir violações.
-
Minimização de dados. Armazene apenas os dados necessários para o seu objetivo. Evite acumular quantidades excessivas de informação, especialmente se for sensível ou pessoal.
-
Utilização ética. Se estiver a publicar ou a partilhar dados extraídos, certifique-se de que estes não prejudicam nem deturpam a comunidade do Reddit.
Procure sempre obter consentimento se utilizar os dados de formas que possam afetar os utilizadores ou a sua reputação.
-
Mantenha-se atualizado: os termos de serviço e as diretrizes da comunidade do Reddit podem sofrer alterações. Reveja-os regularmente para garantir que as suas práticas de scraping continuam a estar em conformidade.
Embora o scraping do Reddit ofereça vastas oportunidades para a extração de dados, é fundamental abordá-lo com respeito e responsabilidade.
A utilização de ferramentas como os proxies residenciais da Geonode pode melhorar as suas capacidades de extração de dados, mas as considerações éticas devem estar sempre na vanguarda de qualquer projeto de extração, garantindo que os direitos dos utilizadores e da plataforma sejam sempre respeitados.
As pessoas também perguntam
P: Qual é a diferença entre utilizar a API oficial do Reddit e os scrapers de terceiros?
R: A API oficial do Reddit é fornecida pelo próprio Reddit e tem limites de taxa e termos de utilização específicos. Os scrapers de terceiros podem oferecer mais flexibilidade, mas nem sempre cumprem as diretrizes do Reddit.
P: Como posso garantir que estou a fazer scraping no Reddit de forma ética e legal?
R: Respeite sempre a privacidade dos utilizadores, cumpra os termos de serviço do Reddit e evite extrair informações privadas ou sensíveis.
P: Existem custos associados à utilização da API do Reddit?
R: Embora o acesso básico seja gratuito, podem existir custos para volumes de pedidos mais elevados ou funcionalidades premium.
P: Como posso gerir os limites de taxa e evitar ser banido?
R: Introduza intervalos entre as solicitações, respeite o ficheiro robots.txt do Reddit e considere a utilização de proxies rotativos.
P: Quais são as melhores ferramentas para extrair comentários do Reddit e outros dados?
R: As ferramentas mais populares incluem Geonode, Parsehub e Octoparse, mas a melhor ferramenta depende das necessidades e dos conhecimentos de cada um.
Dar o primeiro passo para a extração de dados do Reddit
A extração de dados do Reddit pode parecer intimidante à primeira vista, especialmente com a infinidade de ferramentas e técnicas à sua disposição.
No entanto, lembre-se de que todos os especialistas já foram principiantes. O segredo é começar aos poucos e ir aumentando gradualmente à medida que ganha confiança e compreensão.
Quer sejas um investigador em busca de insights, um profissional de marketing a acompanhar tendências ou um entusiasta de dados curioso, o scraping do Reddit pode revelar uma riqueza de informação. É uma competência que encarna verdadeiramente o ditado: «No mundo da programação, as possibilidades são infinitas.»
Por isso, arregaça as mangas e embarca hoje mesmo na tua jornada de scraping do Reddit. Aceita os desafios e lembra-te de que cada obstáculo é um degrau no caminho para o domínio da técnica.

