Einleitung
Als führendes Content Delivery Network (CDN) bietet CloudFront.net in Kombination mit den Möglichkeiten des Web-Scrapings unvergleichliche Chancen. Dieser Leitfaden befasst sich eingehend mit dieser Synergie und gibt Einblicke in die Maximierung der Effizienz, die Gewährleistung der Datengenauigkeit und den verantwortungsvollen Umgang mit der Domain.
CloudFront.net: Ein Gigant im Bereich Content Delivery
Amazon CloudFront, oft unter seiner Domain „CloudFront.net“ bezeichnet, ist ein Content-Delivery-Network-Dienst (CDN), der von Amazon Web Services (AWS) angeboten wird.
Ein CDN ist ein System aus verteilten Servern, das Webinhalte und Anwendungen je nach geografischem Standort der Nutzer bereitstellt. Ziel ist es, durch die räumliche Verteilung des Dienstes im Verhältnis zu den Endnutzern eine hohe Verfügbarkeit und Leistung zu gewährleisten.
CloudFront lässt sich in andere AWS-Dienste integrieren und bietet Entwicklern und Unternehmen so eine optimierte Möglichkeit, Inhalte mit geringer Latenz und hohen Datenübertragungsgeschwindigkeiten an Endnutzer zu verteilen.
Dabei werden Kopien Ihrer Inhalte an mehreren Standorten weltweit gespeichert, die als Edge-Standorte bezeichnet werden. Wenn ein Nutzer Inhalte anfordert, liefert CloudFront diese vom nächstgelegenen Edge-Standort aus und gewährleistet so die schnellstmögliche Ladezeit.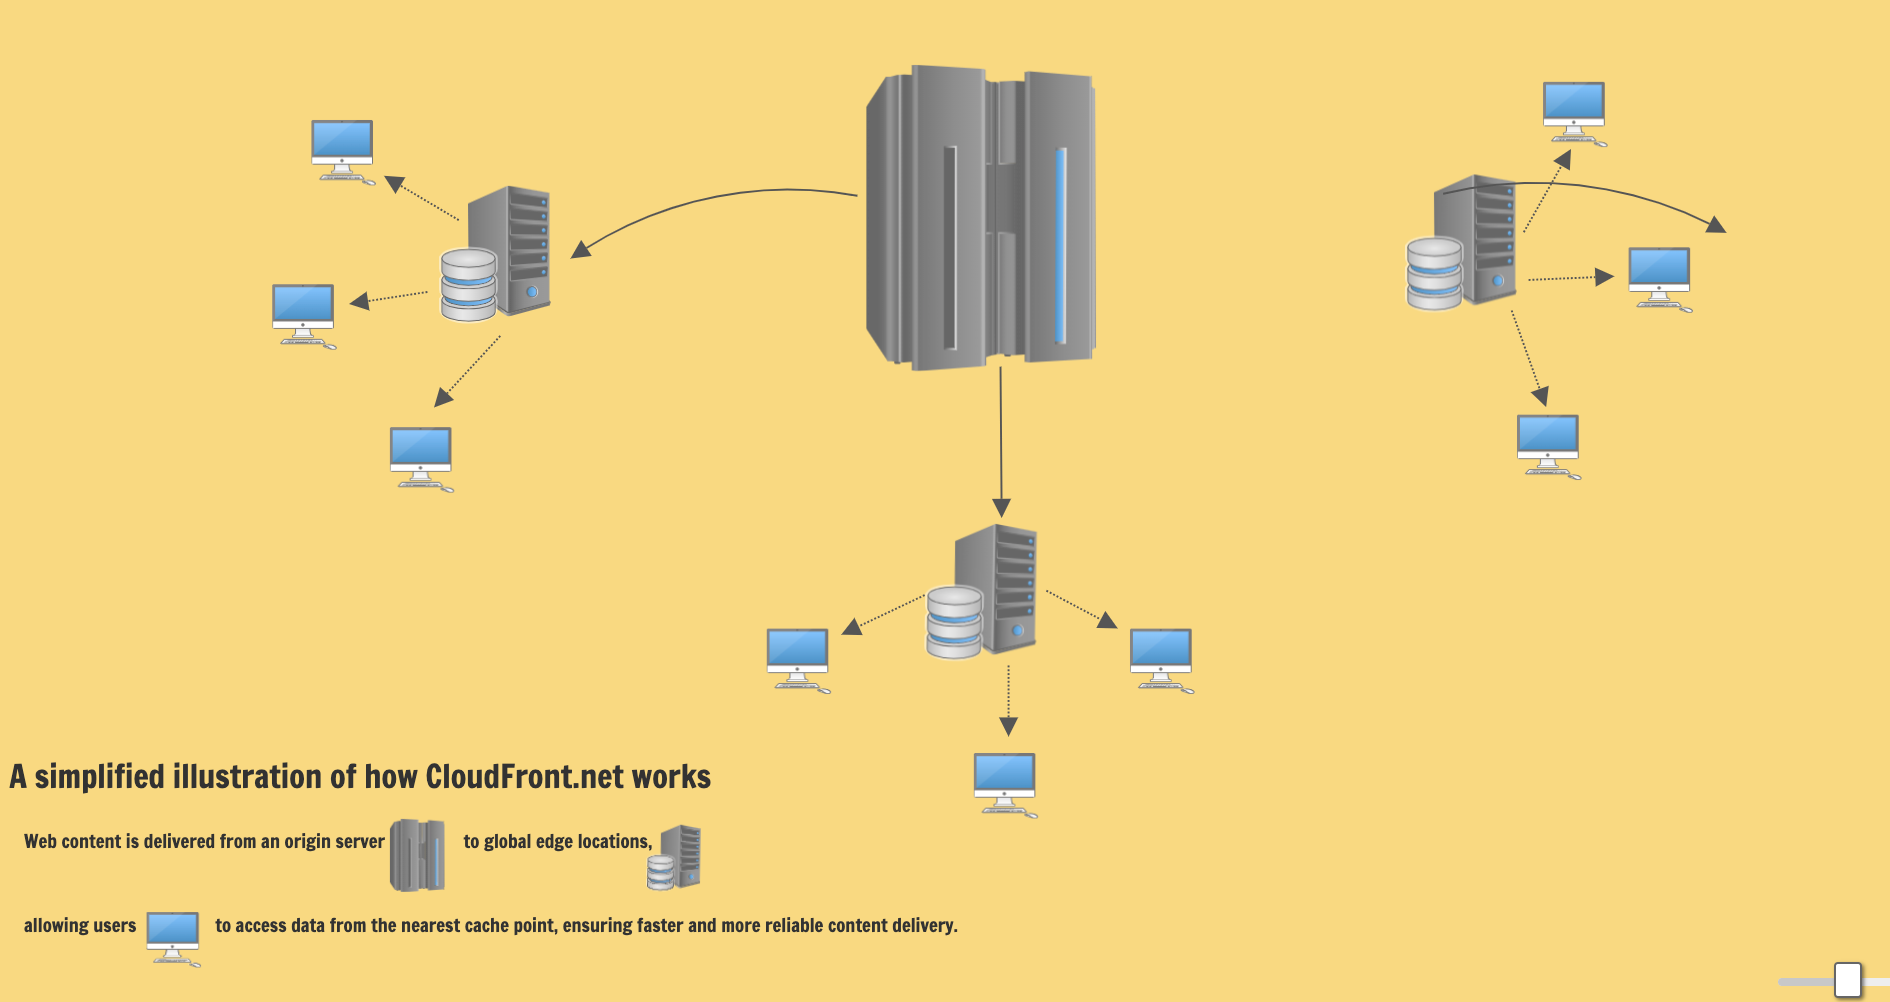
Die wichtigsten Funktionen und Vorteile von CloudFront
-
Globale Reichweite. CloudFront verfügt über ein umfangreiches Netzwerk von Edge-Standorten auf der ganzen Welt, um die Latenz zu reduzieren und sicherzustellen, dass Inhalte vom nächstgelegenen Punkt an den Endnutzer ausgeliefert werden.
-
Enge AWS-Integration. CloudFront ist in AWS-Dienste wie Amazon S3, Amazon EC2, Elastic Load Balancing und Route 53 integriert, was die gemeinsame Nutzung dieser Dienste vereinfacht.
-
Sicherheit. CloudFront bietet mehrere Sicherheitsebenen, darunter HTTPS-Unterstützung, AWS Shield zur Abwehr von DDoS-Angriffen und die Integration von AWS WAF (Web Application Firewall).
Foto von Vecteezy
-
Anpassungsmöglichkeiten. Entwickler können die Bereitstellung von Inhalten individuell anpassen und das CDN an spezifische Anwendungsanforderungen anpassen.
-
Kosteneffizient. CloudFront nutzt ein „pay-as-you-go“-Modell, das sicherstellt, dass Sie nur für die tatsächlich übertragenen Daten bezahlen, ohne dass Vorabkosten anfallen.
-
Bereitstellung dynamischer und statischer Inhalte. Während sich viele CDNs auf die Bereitstellung statischer Inhalte spezialisieren, unterstützt CloudFront sowohl statische als auch dynamische Inhalte.
-
Entwicklerfreundlich. Mit SDKs und einer gut dokumentierten API können Entwickler CloudFront-Distributionen problemlos integrieren und verwalten.
-
Echtzeit-Metriken und Protokollierung. CloudFront bietet detaillierte Metriken und Protokolle, die eine gründliche Analyse und Überwachung der Inhaltsbereitstellung ermöglichen.
Web-Scraping und Datenextraktion verstehen
Web-Scraping ist der Vorgang des Sammelns von Daten von einer Website.
Dabei werden HTTP-Anfragen an Webseiten gesendet, der HTML-Inhalt abgerufen und anschließend die gewünschten Informationen analysiert und extrahiert.
Foto von Vecteezy
Im Gegensatz zum manuellen Kopieren von Daten von einer Website automatisiert Web-Scraping diesen Vorgang und ermöglicht so die Extraktion riesiger Datenmengen in relativ kurzer Zeit.
Der Vorgang umfasst in der Regel:
- Senden einer Anfrage. Ein Scraper sendet eine HTTP-Anfrage an die Ziel-Website.
- Empfang der Antwort. Die Website antwortet mit HTML-Inhalten.
- Analyse der Inhalte. Der Scraper verarbeitet den HTML-Code mithilfe von Parsing-Techniken, um bestimmte Datenstrukturen zu identifizieren.
- Datenextraktion. Sobald die gewünschten Daten identifiziert sind, werden sie aus den analysierten Inhalten extrahiert.
- Datenspeicherung. Die extrahierten Daten werden anschließend in einem strukturierten Format gespeichert, häufig in Datenbanken oder Tabellenkalkulationen.
Die Auswirkungen von Web-Scraping in verschiedenen Branchen
Web-Scraping findet in zahlreichen Branchen vielfältige Anwendung:
-
E-Commerce. Einzelhändler scrapen die Websites von Mitbewerbern, um Preise und Produktangebote zu überwachen.
-
Immobilienbranche. Immobilienwebsites werden gescrapt, um Daten zu Immobilienangeboten, Preisen und Markttrends zu sammeln.
-
Personalbeschaffung. Jobportale werden gescrapt, um Stellenanzeigen zu finden und die Marktnachfrage nach bestimmten Qualifikationen zu analysieren.
Foto von Vecteezy
-
Finanzwesen. Finanzinstitute scrapen Börsen-Websites, um Aktienkurse, Nachrichten und die Marktstimmung zu verfolgen.
-
Forschung. Wissenschaftler und Forscher nutzen Web-Scraping zur Datenerhebung in verschiedenen Fachbereichen.
-
Nachrichten & Medien. Aggregatoren durchsuchen Nachrichtenseiten, um Inhalte aus verschiedenen Quellen zusammenzustellen.
-
Reisen. Reisebüros durchsuchen die Websites von Fluggesellschaften und Hotels, um Preisvergleiche durchzuführen und Angebote zu erstellen.
Web-Scraping-Tools und -Techniken
Für das Web-Scraping stehen zahlreiche Tools und Techniken zur Verfügung, die von einfachen Browser-Erweiterungen bis hin zu komplexer Software reichen.
1. Headless-Browser
Foto von Vecteezy
Headless-Browser spielen beim modernen Web-Scraping eine wichtige Rolle, insbesondere im Umgang mit Plattformen wie CloudFront.net. Hier sind die Gründe, warum sie für das Scraping von CloudFront.net oft unverzichtbar sind:
-
Dynamisches Laden von Inhalten. Viele Websites, darunter auch solche, die auf CloudFront.net gehostet werden, nutzen JavaScript, um Inhalte dynamisch zu laden.
Herkömmliche Scraping-Tools rufen den ursprünglichen HTML-Code einer Seite ab, der möglicherweise nicht alle Daten enthält, wenn der Inhalt asynchron über JavaScript geladen wird.
Headless-Browser können JavaScript ausführen, sodass Scraper auf dynamisch geladene Inhalte zugreifen können.
-
Simulation des tatsächlichen Nutzerverhaltens. Headless-Browser können tatsächliche Nutzerinteraktionen nachahmen, wie z. B. Scrollen, das Klicken auf Schaltflächen oder das Ausfüllen von Formularen.
Diese Fähigkeit ist entscheidend, wenn die Daten, die Sie scrapen möchten, erst nach einer Nutzerinteraktion verfügbar sind.
-
Rendering von Webseiten. Einige Inhalte auf CloudFront.net werden möglicherweise mit Web-Frameworks wie React, Angular oder Vue.js gerendert. Diese Frameworks erfordern oft eine Browserumgebung, um den Inhalt der Seite korrekt darzustellen.
Headless-Browser können diese Seiten rendern und so sicherstellen, dass der Scraper die Seite genauso sieht wie ein menschlicher Nutzer.
-
Cookies und Sitzungen. Headless-Browser können Cookies und Sitzungen verwalten, was für den Zugriff auf bestimmte Inhalte auf CloudFront.net erforderlich sein kann, insbesondere wenn eine Benutzerauthentifizierung oder Sitzungsverfolgung erforderlich ist.
-
Debugging und Entwicklung. Headless-Browser verfügen oft über Entwicklertools, die das Debuggen und Testen der Scraping-Skripte ermöglichen.
Diese Funktion ist bei der Entwicklung und Verfeinerung von Scraping-Strategien für komplexe Websites von unschätzbarem Wert.
2. Python & BeautifulSoup
Python ist eine vielseitige Programmiersprache, die häufig für das Web-Scraping verwendet wird und es Ihnen ermöglicht, Codezeilen ganz nach Ihren Bedürfnissen zu schreiben. Sie verfügt über einfache, aber umfangreiche Bibliotheken, darunter BeautifulSoup.
Foto von Pexels
BeautifulSoup ist eine Python-Bibliothek, mit der Sie Informationen von Webseiten erfassen können. Sie erstellt aus dem Quellcode der Seite einen Parse-Baum, der dazu dient, Daten hierarchisch und übersichtlicher zu extrahieren.
In Kombination mit der Python-Bibliothek `requests` zum Abrufen von Webseiten macht BeautifulSoup den Prozess des Web-Scrapings unkompliziert und effizient.
Wichtigste Funktionen von BeautifulSoup
- Einfaches Parsen. Kann sowohl wohlgeformte als auch fehlerhafte HTML- oder XML-Dateien parsen.
- Suchmethoden. Bietet Methoden wie `find()`, `find_all()` und `select()` zur Navigation und Suche im Parse-Baum.
- Tag-Manipulation. Ermöglicht die einfache Bearbeitung von Tags und Attributen.
- Kodierung. Konvertiert eingehende Dokumente automatisch in Unicode und ausgehende Dokumente in die UTF-8-Kodierung.
3. Proxys für verbessertes Web-Scraping
Proxys fungieren als Vermittler zwischen einem Nutzer und dem Internet. Sie spielen aus mehreren Gründen eine entscheidende Rolle beim Web-Scraping:
-
Anonymität. Web-Scraping kann zu IP-Sperren führen, wenn Websites ungewöhnlichen Datenverkehr von einer einzelnen IP-Adresse feststellen.
Proxys verbergen die echte IP-Adresse des Scrapers, gewährleisten so Anonymität und verringern das Risiko, entdeckt zu werden und gesperrt zu werden.
-
Geo-Targeting. Manche Websites zeigen je nach geografischem Standort des Nutzers unterschiedliche Inhalte an.
Proxys ermöglichen es Scrapern, auf Inhalte aus bestimmten Regionen zuzugreifen, indem sie IP-Adressen aus diesen Gebieten verwenden.
-
Ratenbegrenzung. Websites verfügen oft über Ratenbegrenzungen, um eine Überlastung zu verhindern. Durch den Wechsel zwischen mehreren Proxy-IP-Adressen können Scraper mehr Anfragen an eine Website stellen, ohne an die Ratenbegrenzungen zu stoßen.
Foto von Pexels
-
Paralleles Scraping. Die Verwendung mehrerer Proxys ermöglicht gleichzeitige Anfragen und beschleunigt so den Datenextraktionsprozess, insbesondere bei umfangreichen Scraping-Aufgaben.
-
Weniger Blockierungen. Websites setzen verschiedene Maßnahmen gegen Scraping ein. Proxys können – insbesondere bei häufiger Rotation – dabei helfen, diese Maßnahmen zu umgehen und so ein unterbrechungsfreies Scraping zu gewährleisten.
Warum CloudFront.net scrapen?
Hier sind einige praktische Anwendungsbeispiele für Daten, die von CloudFront.net (oder über CloudFront bereitgestellten Websites) gesammelt werden können:
-
Wettbewerbsanalyse. Unternehmen möchten möglicherweise die Inhalte, die Struktur oder die Elemente der über CloudFront bereitgestellten Website eines Mitbewerbers verstehen, um dessen Online-Strategien, Angebote oder digitale Präsenz einzuschätzen.
-
Inhaltsaggregation. Aggregatoren, wie Nachrichten- oder Preisvergleichsplattformen, könnten über CloudFront bereitgestellte Websites scrapen, um konsolidierte Informationen zu sammeln und ihren Nutzern zu präsentieren und so durch umfassende Daten einen Mehrwert zu bieten.
-
Forschungs- und akademische Zwecke. Forscher oder Studierende könnten Websites auf CloudFront auswerten, um Daten für akademische Projekte, Studien oder Arbeiten zu sammeln, mit dem Ziel, Trends, Muster oder Phänomene zu analysieren.
[Foto](https://Photo von Vlada Karpovich https) von Pexels
-
SEO-Analyse. SEO-Experten könnten Websites, die über CloudFront bereitgestellt werden, scrapen, um deren On-Page-SEO-Strategien, Backlink-Profile oder Inhaltsstrukturen zu verstehen und so ihre eigenen SEO-Maßnahmen oder die ihrer Kunden zu optimieren.
-
Inhaltsüberwachung. Marken oder Einzelpersonen möchten möglicherweise bestimmte Websites auf CloudFront auf Erwähnungen, Bewertungen oder Aktualisierungen überwachen, um auf dem Laufenden zu bleiben und umgehend auf neue Inhalte reagieren zu können.
-
Sicherung und Archivierung. Manche Unternehmen möchten möglicherweise Backups ihrer eigenen, über CloudFront bereitgestellten Webinhalte erstellen, um sicherzustellen, dass sie über historische Versionen oder Archive für spätere Referenzzwecke verfügen.
-
Marktanalyse. E-Commerce-Unternehmen oder Marktanalysten könnten Produktlisten, Bewertungen oder Preisdaten von Websites auf CloudFront auswerten, um Markttrends, Verbraucherpräferenzen oder Preisstrategien zu verstehen.
Es ist wichtig zu beachten, dass diese Anwendungsfälle zwar legitime Gründe für das Web-Scraping darstellen, Sie jedoch stets darauf achten sollten, ethisch einwandfrei vorzugehen – insbesondere im Umgang mit Websites, die über robuste CDNs wie CloudFront bereitgestellt werden.
So führen Sie ein Scraping von CloudFront.net durch
- Ermitteln Sie die Ziel-URL. Bestimmen Sie die konkrete CloudFront.net-URL, die Sie scrapen möchten.

- Untersuchen Sie die Webseite. Verwenden Sie die Entwicklertools Ihres Browsers, um die Seitenstruktur zu untersuchen und die Daten zu identifizieren, die Sie extrahieren möchten.

- Schreiben Sie das Scraping-Skript. Nutzen Sie Python-Bibliotheken, um ein Skript zu schreiben, das die Webseite abruft und analysiert.
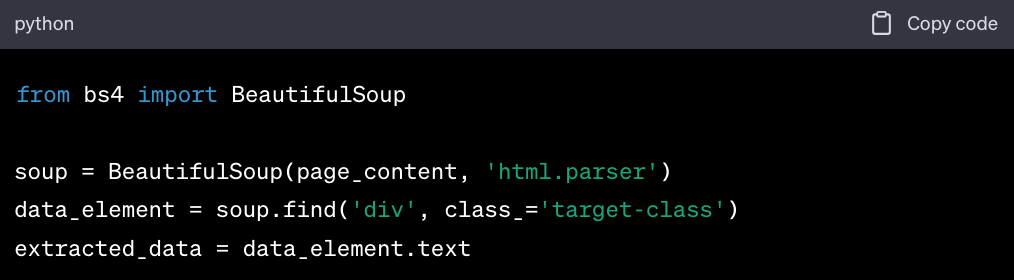
- Paginierung berücksichtigen. Wenn sich der Inhalt über mehrere Seiten erstreckt, stelle sicher, dass dein Skript durch alle Seiten navigieren und Daten von allen Seiten scrapen kann. (Vorausgesetzt, jede Seite verfügt über eine „Weiter“-Schaltfläche, die zur nächsten Seite führt.)
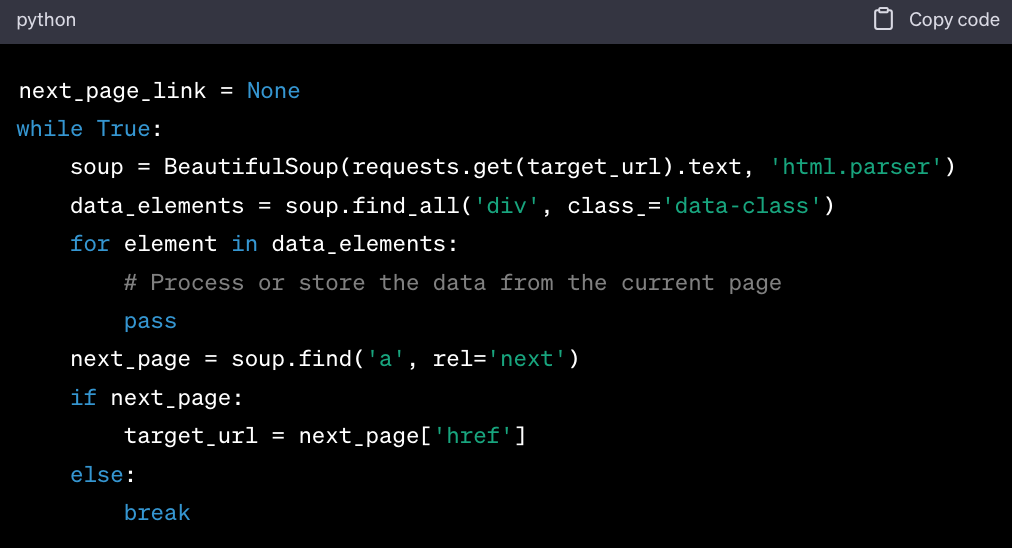
- Speichere die Daten. Speichern Sie die gescrapten Daten in einem strukturierten Format wie einer CSV-Datei, JSON oder einer Datenbank.

- Beachten Sie die Datei „
robots.txt“: Überprüfen und beachten Sie stets die robots.txt-Datei von CloudFront.net, um sicherzustellen, dass Sie keine Scraping-Regeln verletzen. 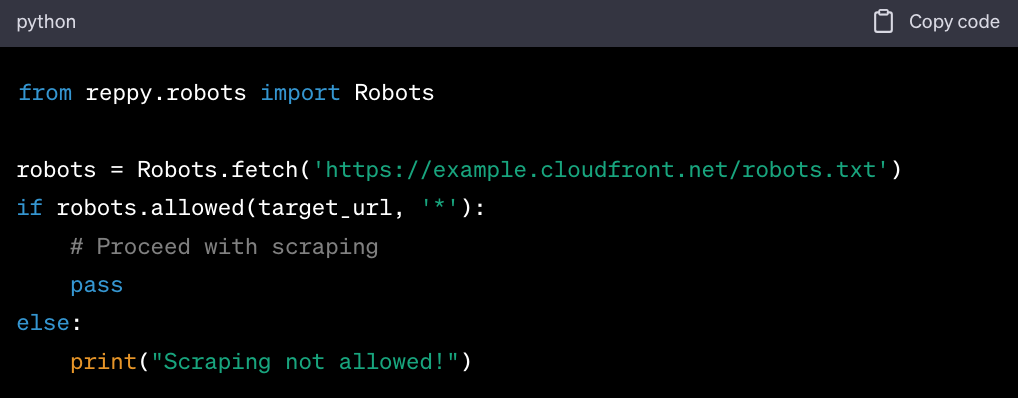
Ein Überblick über die rechtlichen Rahmenbedingungen beim Scraping von CloudFront.net
Web-Scraping, insbesondere auf Plattformen wie CloudFront.net, erfordert ein tiefgreifendes Verständnis der damit verbundenen rechtlichen Feinheiten, wie zum Beispiel
-
Nutzungsbedingungen (ToS). Bevor Sie CloudFront.net oder eine andere Website scrapen, sollten Sie stets die jeweiligen Nutzungsbedingungen prüfen.
Lesen Sie stets die AWS-Nutzungsbedingungen durch, bevor Sie Scraping-Aktivitäten auf CloudFront.net oder anderen AWS-Diensten starten. Das Ignorieren dieser Bedingungen kann rechtliche Konsequenzen nach sich ziehen.
-
Urheberrechtsgesetze. Daten auf CloudFront.net können, selbst wenn sie öffentlich zugänglich sind, urheberrechtlich geschützt sein.
Stellen Sie sicher, dass die extrahierten Daten so verwendet werden, dass diese Gesetze nicht verletzt werden.
Foto von Pexels
-
Datenschutzbestimmungen. Vorschriften wie die DSGVO und der CCPA legen großen Wert auf den Datenschutz der Nutzer.
Achten Sie beim Scraping personenbezogener Daten von CloudFront.net auf die Einhaltung dieser Gesetze, einschließlich sicherer Speicherung und erforderlicher Einwilligungen.
-
Computer Fraud and Abuse Act (CFAA). Dieses US-Gesetz stellt den unbefugten Zugriff auf Computersysteme unter Strafe.
Stellen Sie sicher, dass Ihre Scraping-Aktivitäten auf CloudFront.net nicht gegen die Nutzungsbedingungen verstoßen, um Konflikte mit dem CFAA zu vermeiden.
Digitale Grenzen auf CloudFront.net respektieren
Beim ethischen Web-Scraping geht es darum, den digitalen Raum von Plattformen wie CloudFront.net zu respektieren:
-
Ratenbegrenzung. Vermeiden Sie es, CloudFront.net durch das Senden zu vieler Anfragen in kurzer Zeit zu überlasten.
Halten Sie sich an etwaige Ratenbegrenzungen und verteilen Sie Ihre Scraping-Aktivitäten zeitlich.
-
Sensible Informationen. CloudFront.net kann personenbezogene oder sensible Daten hosten. Geben Sie der Privatsphäre der Nutzer Vorrang und vermeiden Sie böswilliges Web-Scraping.
-
Quelle angeben. Wenn Sie Daten von CloudFront.net für Forschungszwecke oder andere Zwecke verwenden, geben Sie die Plattform stets als Quelle an.
-
Einholung der Genehmigung. Wenn Sie sich bezüglich des Web-Scrapings von CloudFront.net unsicher sind, sollten Sie am besten die Genehmigung der Administratoren der Plattform einholen.
Umgehung von Anti-Scraping-Maßnahmen auf CloudFront.net
CloudFront.net verfügt, wie viele andere Plattformen auch, möglicherweise über Maßnahmen zur Abwehr von Scrapern:
- User-Agents. CloudFront.net blockiert möglicherweise bekannte User-Agents von Scrapern. Wechseln Sie die User-Agents regelmäßig oder ahmen Sie einen echten Browser nach, um diese Blockade zu umgehen.
- CAPTCHAs. CloudFront.net verwendet möglicherweise CAPTCHAs, um menschliche Nutzer zu verifizieren. Zwar gibt es Tools, um diese zu umgehen, doch häufige Aufforderungen können zu IP-Sperren führen.
- IP-Sperren. Wenn CloudFront.net ungewöhnliche Aktivitäten feststellt, kann es die IP-Adresse sperren. Nutzen Sie Proxys verantwortungsbewusst, um IP-Adressen zu wechseln und das Scraping fortzusetzen.
- Honeypots. Seien Sie vorsichtig bei Honeypot-Fallen auf CloudFront.net – gefälschte Datenpunkte, die eingerichtet wurden, um Scraper zu erkennen.
Optimierung von CloudFront.net-Scraping-Aufgaben mit Residential-Proxys von Geonode
Die Integration von Geonode-Proxys in Web-Scraping-Tools und -Skripte kann den Scraping-Prozess erheblich verbessern, insbesondere bei der Bearbeitung robuster Plattformen wie CloudFront.net.

Geonode hat sich dank seiner Vielzahl herausragender Funktionen als Proxy-Dienstleister einen Namen gemacht.
Geonode ist bekannt für sein zuverlässiges Proxy-Netzwerk, das minimale Ausfallzeiten und konstante Leistung gewährleistet, und verfügt über eine breite Abdeckung, gestützt durch eine große Anzahl von IP-Adressen in zahlreichen Ländern.
Darüber hinaus bietet Geonode dank seiner robusten Infrastruktur schnelle Reaktionszeiten – ein entscheidender Faktor für effizientes Web-Scraping. Der Dienst stellt sichere Verbindungen bereit und erfüllt vielfältige Anforderungen im Bereich Web-Scraping, wobei er den Datenschutz sowie den Schutz vor potenziellen Bedrohungen gewährleistet.
Häufig gestellte Fragen
Wie verbessert CloudFront.net die Bereitstellung von Inhalten?
CloudFront.net ist ein Content-Delivery-Network-Dienst (CDN), der von Amazon Web Services (AWS) bereitgestellt wird.
Einfach ausgedrückt ist ein CDN wie ein Netzwerk aus schnellen Kurierdiensten, die über den ganzen Globus verteilt sind und dafür sorgen, dass Online-Inhalte die Nutzer schnell und effizient erreichen. So funktioniert es:
-
Globale Verteilung. CloudFront verfügt über zahlreiche Rechenzentren, sogenannte Edge-Standorte, die weltweit verteilt sind.
Wenn ein Nutzer Inhalte anfordert, werden diese vom nächstgelegenen Edge-Standort bereitgestellt, wodurch Verzögerungen oder Latenzzeiten auf ein Minimum reduziert werden.
-
Integration in AWS. Als Teil des AWS-Ökosystems lässt sich CloudFront nahtlos in andere AWS-Dienste integrieren.
Wenn Ihre Website oder Anwendung auf AWS gehostet wird, können Sie durch den Einsatz von CloudFront die Bereitstellung von Inhalten noch effizienter gestalten.
-
Dynamische und statische Inhalte. Während einige CDNs am besten für die Bereitstellung statischer Inhalte (wie Bilder oder Stylesheets) geeignet sind, eignet sich CloudFront sowohl für die Bereitstellung statischer als auch dynamischer Inhalte (wie benutzerspezifische Webseiten).
-
Sicherheit. CloudFront bietet robuste Sicherheitsfunktionen, darunter HTTPS für die sichere Datenübertragung, Schutz vor DDoS-Angriffen und die Integration mit der Web Application Firewall von AWS.
-
Kosteneffizient. Dank des „pay-as-you-go“-Modells zahlen Nutzer nur für die Inhalte, die sie bereitstellen, was CloudFront zu einer kosteneffizienten Lösung für Unternehmen jeder Größe macht.
Im Wesentlichen sorgt CloudFront.net dafür, dass Ihre Online-Inhalte Ihre Nutzer schnell, sicher und effizient erreichen – ganz gleich, wo auf der Welt sie sich befinden.
Warum sind Proxys wie Geonode für das Web-Scraping so wichtig?
Beim Web-Scraping werden verschiedene Arten von Daten von Websites gesammelt. Dieser Vorgang ist jedoch nicht immer unkompliziert.
Websites verfügen möglicherweise über Maßnahmen, um automatisierten Zugriff zu blockieren oder einzuschränken. Hier kommen Proxys ins Spiel, insbesondere zuverlässige wie Geonode:
-
Umgehung von Einschränkungen. CloudFront.net ist Teil der AWS-Suite und verfügt über robuste Sicherheitsmaßnahmen.
Proxys von Geonode können dabei helfen, IP-basierte Einschränkungen zu umgehen und auf Daten zuzugreifen, ohne Alarm auszulösen.
-
Lastenausgleich. Beim Scraping großer Datensätze aus CloudFront.net können Geonode-Proxys die Anfragen verteilen und so für einen effizienten Lastenausgleich und einen schnelleren Datenabruf sorgen.
-
Zugriff auf aktuelle Daten. CloudFront.net liefert möglicherweise zwischengespeicherte Inhalte, je nach geografischem Standort der Anfrage.
Die große Auswahl an IP-Adressen vonGeonode gewährleistet den Zugriff auf aktuelle Echtzeitdaten.
-
Fehlerbehandlung. Im Falle von Sperren oder Captchas können in Geonode integrierte Skripte automatisch auf einen anderen Proxy umschalten und so ein unterbrechungsfreies Scraping gewährleisten.
-
Umgehung von Ratenbeschränkungen. CloudFront begrenzt die Anzahl der Anfragen von einer einzelnen IP-Adresse innerhalb eines bestimmten Zeitraums.
Durch den Wechsel zwischen den Proxys von Geonode können Scraper häufiger Anfragen stellen, ohne blockiert zu werden.
-
Zuverlässigkeit. Nicht alle Proxys sind gleich. Geonode ist bekannt für seine stabilen und schnellen Proxys, die ein effizientes und unterbrechungsfreies Scraping gewährleisten.
-
Sicherheit. Die Verwendung von Proxys von Geonode gewährleistet eine sichere Verbindung und schützt den Scraper vor potenziellen Bedrohungen und neugierigen Blicken.
Für jeden, der es mit dem Web-Scraping ernst meint, sind zuverlässige Proxys wie Geonode nicht nur von Vorteil, sondern unverzichtbar.
Ist Web-Scraping legal?
In den USA ist die Rechtmäßigkeit des Web-Scrapings seit langem umstritten und wurde bereits in verschiedenen Gerichtsverfahren behandelt.
Einer der am häufigsten zitierten Fälle ist hiQ Labs, Inc. gegen LinkedIn Corp., in dem das Berufungsgericht des Neunten Bezirks entschied, dass das Scraping öffentlich zugänglicher Websites wahrscheinlich nicht gegen den CFAA verstößt.
Das Gericht entschied zugunsten von hiQ, einem Unternehmen, das öffentlich zugängliche Daten von LinkedIn gescrapt hatte.
Die Entscheidung des Gerichts basierte auf der Auslegung, dass der CFAA auf Verstöße gegen Zugangsbeschränkungen zu Computern abzielt und nicht auf den Missbrauch von Daten durch Parteien, die über einen autorisierten Zugang verfügten.
Web-Scraping ist zwar an sich nicht illegal, doch ist es entscheidend, verantwortungsbewusst damit umzugehen.
Halten Sie sich stets an die Nutzungsbedingungen einer Website, beachten Sie Urheberrechts- und Datenschutzgesetze und ziehen Sie im Zweifelsfall einen Rechtsbeistand hinzu.
Fazit
Das Zusammenspiel von CloudFront.net, Web-Scraping und Geonode-Proxys zeichnet ein überzeugendes Bild von Effizienz, Innovation und verantwortungsvoller Datenerfassung.
Mit seiner globalen Reichweite ermöglicht CloudFront.net eine schnelle Bereitstellung von Inhalten und sorgt für ein nahtloses Nutzererlebnis.
Web-Scraping hingegen erschließt wichtige Erkenntnisse und treibt Forschung und Innovation voran, wenn es ethisch einwandfrei eingesetzt wird.
Geonode-Proxys ergänzen diesen Prozess, indem sie anonymes Surfen im Internet ermöglichen, geografische Beschränkungen umgehen und einen stetigen Datenfluss gewährleisten.
Doch während wir die kombinierten Möglichkeiten von CloudFront.net, Web-Scraping und Geonode-Proxys nutzen, ist es unerlässlich, ethischen Praktiken Vorrang einzuräumen.
Foto von Vecteezy
Die Achtung digitaler Grenzen, die Einhaltung gesetzlicher Vorgaben sowie die Gewährleistung der Privatsphäre und der Rechte von Online-Akteuren sollten bei allen Unternehmungen im Vordergrund stehen.
Lasst uns alle ethische Praktiken und das kontinuierliche Streben nach Wissen verpflichten. Die digitale Welt entwickelt sich ständig weiter, und indem wir verantwortungsbewusst handeln und auf dem Laufenden bleiben, können wir sicherstellen, dass unsere Handlungen nicht nur uns selbst, sondern der gesamten Online-Community zugutekommen.
.

